Wichtigste Erkenntnisse
- ✅ Bandbreite je Chip: M5 153,6 GB/s · M5 Pro 307 GB/s · M5 Max 460 GB/s (32-Kern-GPU) bzw. 614 GB/s (40-Kern-GPU) · M5 Ultra bis zu 1,2 TB/s. Das Generierungstempo entspricht grob Bandbreite ÷ Modellgröße × 60–80 % — siehe die Bandbreiten-Abschnitte unten.
- ✅ SEIT 22. SEPTEMBER 2026 LIEFERBAR: Mac mini M5 Pro ab 1.699 $ (bis 64 GB, 307 GB/s) — der günstigste M5-Pro-Mac aller Zeiten, günstiger als das MacBook Pro.
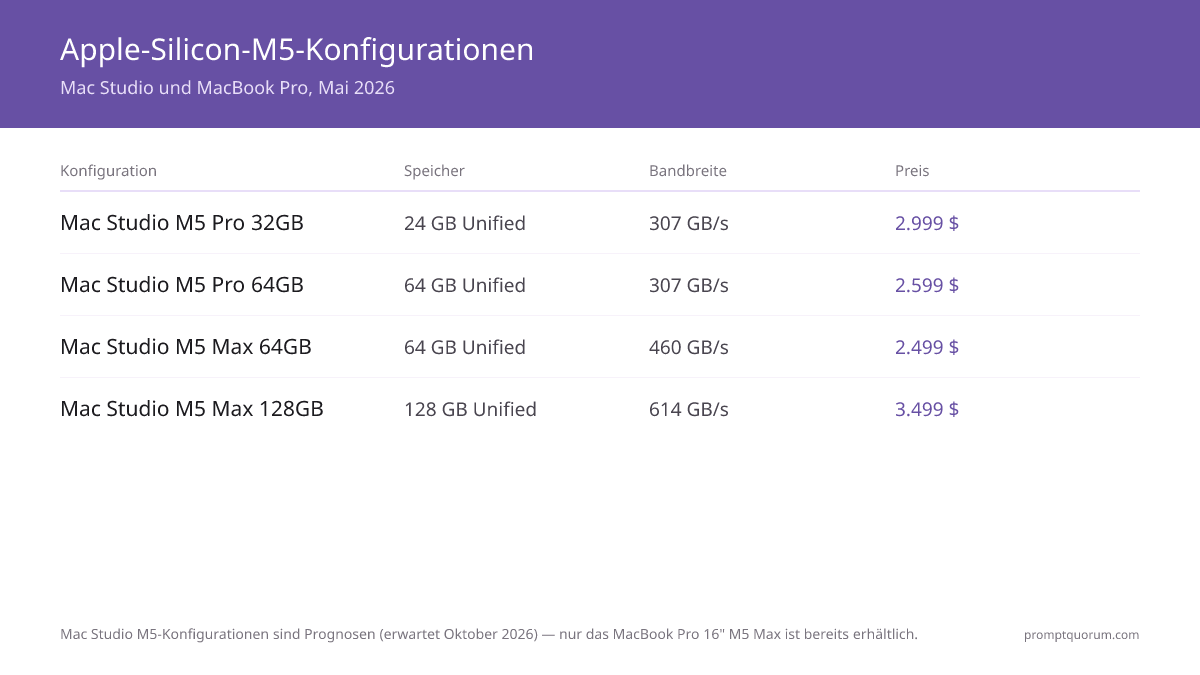
- ✅ Mac Studio M5 Max ab 2.499 $ (bis 128 GB, 614 GB/s) und Mac Studio M5 Ultra ab 5.499 $ (bis 512 GB, bis 1,2 TB/s) werden ausgeliefert. Die M5-Ultra-Konfiguration mit 512 GB folgt Ende Oktober 2026 und wird deutlich über 10.000 $ erwartet.
- Der Mac Studio bietet keine M5-Pro-Stufe mehr — er startet beim M5 Max. Der Mac mini ist jetzt der Einstieg in den M5-Pro-Chip.
- Das MacBook Pro 16" M5 Max (seit März 2026 erhältlich) hat bei gleicher GPU-Stufe dieselbe Speicherbandbreite wie der Mac Studio M5 Max: 460 GB/s (32-Kern-GPU) und 614 GB/s (40-Kern-GPU) — kein Bandbreitennachteil durch die Bauform.
- Alle M5-Pro/Max-Konfigurationen: 307–614 GB/s Speicherbandbreite (RTX 4090 mit 1.008 GB/s, aber nur 24 GB VRAM). Der M5 Ultra erreicht bis zu 1,2 TB/s.
- Leiser Betrieb: Beim MacBook Pro sind die Lüfter unter Dauerlast hörbar; Mac Studio und Mac mini laufen bei typischen lokalen LLM-Lasten selten hörbar hoch.
- MLX ist auf Apple Silicon in der Regel die schnellste Laufzeit. Ollama hat im März 2026 ein MLX-Backend ergänzt (Vorschau, Ollama 0.19, zunächst für ausgewählte Modelle auf Macs mit mehr als 32 GB); andere Modelle laufen weiter über das Metal-Backend von llama.cpp.
- Unified Memory: von 24 GB (Mac mini M5 Pro, Basis) bis 512 GB (Mac Studio M5 Ultra) für jedes Modell nutzbar. Kein separates VRAM-Limit wie bei dedizierten GPUs.
📍 In einem Satz
M5 Pro bietet 307 GB/s, M5 Max 460–614 GB/s und M5 Ultra bis zu 1,2 TB/s Speicherbandbreite — und diese Zahl, nicht die Kernzahl, bestimmt, wie viele Tokens pro Sekunde ein Mac erzeugt; der Mac mini M5 Pro startet bei 1.699 $, der Mac Studio M5 Max bei 2.499 $ und der Mac Studio M5 Ultra bei 5.499 $.
💬 In einfachen Worten
Apple-Silicon-Macs nutzen Unified Memory — CPU, GPU und KI-Engine teilen sich denselben schnellen Speicherpool. So kann ein M5 Max mit 128 GB ein komplettes 70B-Modell laden, das keine einzelne Consumer-NVIDIA-GPU (24–32 GB VRAM) fasst, und die Option mit 512 GB beim M5 Ultra geht noch weiter.
🔄 Update vom 11. Oktober 2026: Der Liefertermin 22. September 2026 ist verstrichen — Mac mini M5 Pro, Mac Studio M5 Max und Mac Studio M5 Ultra (96–256 GB) sind erhältlich; nur die M5-Ultra-Konfiguration mit 512 GB steht noch aus (Ende Oktober 2026). Das Update ergänzt Abschnitte zur Speicherbandbreite, ersetzt Tokens-pro-Sekunde-Bereiche, die über der Bandbreitengrenze des jeweiligen Chips lagen, und fügt die ersten unabhängigen M5-Ultra-Messungen aus dem MacStories-Test hinzu. Die Tokens/s-Werte für Mac mini M5 Pro und Mac Studio M5 Max bleiben Schätzungen, die aus der Bandbreite und MacBook-Pro-Ergebnissen abgeleitet sind — keine Messungen an diesen Gehäusen.
Warum Apple Silicon M5 für lokale LLMs wichtig ist
Apple Silicon ist eine grundlegend andere Architektur für KI-Workloads. Darum ist sie für Nutzer lokaler LLMs relevant.
- Unified-Memory-Architektur: M5 Pro und M5 Max teilen sich einen einzigen schnellen Speicherpool (24 bis 128 GB), auf den CPU, GPU und Neural Engine gleichzeitig zugreifen. Kein VRAM/RAM-Flaschenhals. Modelle bleiben im schnellen Speicher, die Inferenz bleibt reaktionsschnell.
- Speicherbandbreite als eigentlicher Flaschenhals: Die LLM-Generierung ist speichergebunden, nicht rechengebunden — jedes erzeugte Token liest die Modellgewichte einmal. Der M5 Max mit 460–614 GB/s liegt bei kleinen Modellen hinter den 1.008 GB/s der RTX 4090, fasst aber bis zu 128 GB statt 24 GB und führt damit Modelle aus, die in eine 4090 nicht passen. Der M5 Ultra übertrifft mit bis zu 1,2 TB/s die 4090 und fasst bis zu 512 GB.
- „VRAM“ am Mac ist Unified Memory: Es gibt keinen separaten VRAM-Pool. Die GPU nutzt denselben Speicher wie macOS; standardmäßig erlaubt macOS der GPU, grob zwei Drittel bis drei Viertel des gesamten RAM fest zu belegen (der Anteil hängt von der RAM-Größe ab). Bei einem Mac mit 64 GB sollten Sie mit etwa 48 GB für Modell plus Kontext planen; das Limit lässt sich mit `sudo sysctl iogpu.wired_limit_mb=<MB>` anheben (wird beim Neustart zurückgesetzt).
- Apple-Fusion-Architektur (neu im M5): M5 Pro und M5 Max trennen CPU und GPU auf zwei eigene 3-nm-Dies in einem Gehäuse. Das ermöglicht unabhängige Skalierung und thermische Optimierung und verbessert die Energieeffizienz gegenüber monolithischen Chips.
- Neural Accelerator in jedem GPU-Kern: Jeder GPU-Kern enthält einen eigenen Neural Accelerator für KI-Workloads, der die gemeinsame Neural Engine ergänzt. Laufzeiten, die sie nutzen — etwa MLX und das MLX-Backend von Ollama —, verarbeiten Prompts auf M5-Chips schneller.
- Generationssprung gegenüber M4: Apple nennt bis zu 30 % mehr Multithread-CPU-Leistung gegenüber M4 Pro und M4 Max. Für die LLM-Generierung zählt die Bandbreite: M5 Pro 307 GB/s vs. M4 Pro 273 GB/s (+12 %) sowie 614 GB/s vs. 546 GB/s beim jeweils größten M5 Max bzw. M4 Max (+12 %). Beim Prompt-Processing fallen die Gewinne dank der Neural Accelerators pro Kern größer aus.
- Thunderbolt 5 (M5 Pro/Max): M5 Pro und M5 Max bieten Thunderbolt 5 mit 80 Gbit/s Basisbandbreite (doppelt so viel wie Thunderbolt 4) — für schnellen externen Speicher und mehrere Displays.
- Wi-Fi 7 und Bluetooth 6 über den Apple-N1-Chip: M5-Systeme enthalten den neuen N1-Funkchip mit Wi-Fi 7 und Bluetooth 6.0 für geringe Latenz — nützlich bei Remote-Inferenz-Clients oder Cloud-Modell-APIs.
- MLX reift schnell: Apples MLX-Framework unterstützt Llama 3.3, Qwen, Mistral und Gemma mit optimierten Kernels. Ollama bietet seit März 2026 ein MLX-Backend für Apple Silicon (Vorschau), zunächst auf ausgewählte Modelle beschränkt.
- Energieeffizienz ist real: Der M5 Max wird unter dauerhafter Inferenz auf grob 65–100 W geschätzt (eine Schätzung, kein Apple-Wert; Apple gibt für das Mac-Studio-Gehäuse bis zu 480 W maximale Dauerleistung an). Ein Monat Dauerbetrieb (720 Stunden) bei 100 W entspricht rund 72 kWh, also etwa 8–12 $ US-Strom. Eine RTX 4090 mit 350 W kostet im selben Monat etwa 40–60 $.
- Leiser Betrieb: Die Lüfter des Mac Studio werden bei typischen LLM-Lasten selten hörbar; MacStories konnte den Lüfter des M5-Ultra-Mac-Studio im Alltag nicht hören. Die Lüfter des MacBook Pro werden unter Dauerlast hörbar.
Apple Silicon M5 im Vergleich
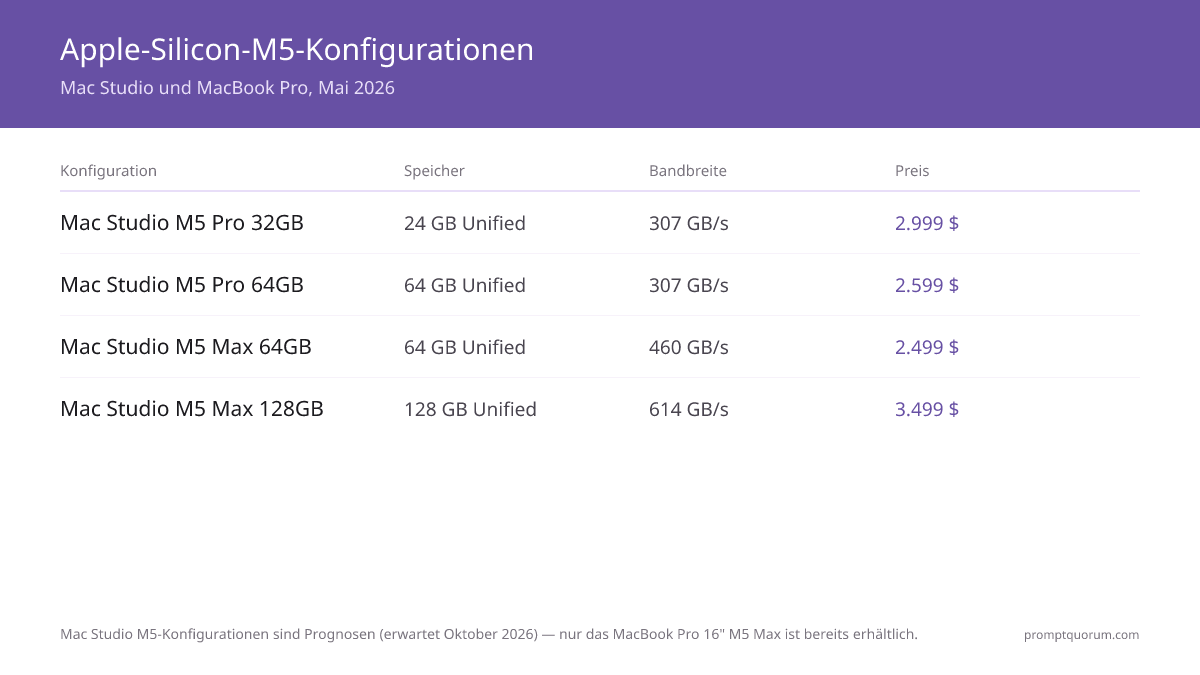
Die folgenden Konfigurationen verwenden die Apple-Preise der Ankündigung vom 25. August 2026. Mac mini, Mac Studio und MacBook Pro werden seit dem 22. September 2026 ausgeliefert, mit Ausnahme der Mac-Studio-M5-Ultra-Konfiguration mit 512 GB (Ende Oktober 2026, Preis deutlich über 10.000 $ erwartet). Preise: USD-Preise aus dem Apple Store. Bislang gibt es nur für den M5 Ultra unabhängige Tokens/s-Messungen — was gemessen und was geschätzt ist, steht im Abschnitt zur Leistung.
Konfiguration | Chip | GPU-Kerne | Speicher | Bandbreite | Preis | Ideal für |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24 GB | M5 Pro | 16 | 24GB Unified | 307 GB/s | 1.699 $ | Günstigster M5 Pro, 7B–14B |
| Mac mini M5 Pro 64 GB | M5 Pro | 20 | 64GB Unified | 307 GB/s | 2.699 $ | 30B-Modelle, günstigste 64 GB |
| Mac Studio M5 Max 36 GB | M5 Max | 32 | 36GB Unified | 460 GB/s | 2.499 $ | Günstiger Desktop-Einstieg |
| Mac Studio M5 Max 64 GB | M5 Max | 40 | 64GB Unified | 614 GB/s | 3.499 $ | 70B Q4, bester Wert |
| Mac Studio M5 Max 128 GB | M5 Max | 40 | 128GB Unified | 614 GB/s | 5.099 $ | 70B Q5, Power-User |
| Mac Studio M5 Ultra 96 GB | M5 Ultra | 64 | 96GB Unified | Bis 1,2 TB/s | 5.499 $ | Größte lokale Modelle |
| Mac Studio M5 Ultra 512 GB | M5 Ultra | 80 | 512GB Unified | Bis 1,2 TB/s | 10,000+ $ (gesch.) | Riesige Modelle, Ende Okt. |
| MacBook Pro 16" M5 Max 64 GB | M5 Max | 32 | 64GB Unified | 460 GB/s | 3.499 $ | Mobil, 70B Q4 |
| MacBook Pro 16" M5 Max 128 GB | M5 Max | 40 | 128GB Unified | 614 GB/s | 4.499 $ | Mobil, 70B Q5 |
Speicherbandbreite von M5, M5 Pro, M5 Max und M5 Ultra im Vergleich
Die Speicherbandbreite entscheidet auf Apple Silicon über das Generierungstempo lokaler LLMs und ist die Zahl, nach der die meisten Käufer suchen. Die Tabelle nennt den offiziellen Wert je Chip; der M5 Max hat zwei Bandbreitenstufen: 460 GB/s mit der 32-Kern-GPU und 614 GB/s mit der 40-Kern-GPU. Die Werte sind theoretische Maximalwerte.
📍 In einem Satz
Die Speicherbandbreite des Apple M5 beträgt 153,6 GB/s (M5), 307 GB/s (M5 Pro), 460 GB/s (M5 Max mit 32-Kern-GPU), 614 GB/s (M5 Max mit 40-Kern-GPU) und bis zu 1,2 TB/s (M5 Ultra).
💬 In einfachen Worten
Die Bandbreite gibt an, wie schnell der Chip das Modell aus dem Speicher lesen kann. Für ein Token wird (fast) das ganze Modell einmal gelesen — ein Mac kann also nie schneller generieren als Bandbreite geteilt durch Modellgröße.
- M5 Pro vs. M5 Max: Der M5 Max hat das 1,5-Fache (32-Kern-GPU, 460 GB/s) oder das 2-Fache (40-Kern-GPU, 614 GB/s) der Bandbreite des M5 Pro — entsprechend schneller ist die Generierung bei gleichem Modell.
- M5 Max vs. M5 Ultra: Der M5 Ultra verbindet zwei M5-Max-Chips und verdoppelt die 614 GB/s des M5 Max mit 40-Kern-GPU auf rund 1,2 TB/s — 50 % mehr als die 819 GB/s des M3 Ultra der Vorgängergeneration.
- Kapazität vs. Bandbreite: Mehr Speicher macht einen Chip nicht schneller. Ein M5 Max mit 40-Kern-GPU hat mit 64 GB wie mit 128 GB dieselben 614 GB/s; zusätzlicher Speicher erlaubt nur größere oder mehr Modelle.
Chip | GPU-Kerne | Max. Speicher | Bandbreite | Enthalten in |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153,6 GB/s | MacBook Air, 14" MacBook Pro |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro, Mac mini |
| M5 Max (32-Kern-GPU) | 32 | 36GB+ | 460 GB/s | MacBook Pro, Mac Studio |
| M5 Max (40-Kern-GPU) | 40 | 128GB | 614 GB/s | MacBook Pro, Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1,2 TB/s (1,228,8 GB/s) | Mac Studio |
| M4 Max (Referenz) | 40 | 128GB | 546 GB/s | Vorherige Generation |
| RTX 4090 (Referenz) | k. A. | 24GB VRAM | 1,008 GB/s | Dedizierte GPU |
Wie aus Bandbreite Tokens pro Sekunde werden
Die folgende Tabelle ist Arithmetik, kein Benchmark: Obergrenze Tokens/s = Bandbreite ÷ Modelldateigröße. Real liegt die Generierung niedriger — wegen KV-Cache-Zugriffen, Laufzeit-Overhead und Thermik. Mixture-of-Experts-Modelle lesen pro Token nur ihre aktiven Experten und können daher schneller laufen als ein dichtes Modell gleicher Dateigröße.
📍 In einem Satz
Die Obergrenze des Generierungstempos ist die Speicherbandbreite geteilt durch die Modellgröße — etwa 614 GB/s ÷ 42,5 GB (Llama 3.3 70B Q4) ≈ 14 Tokens/s — und gut optimierte Laufzeiten erreichen typischerweise rund 60–80 % davon.
💬 In einfachen Worten
Wählen Sie den Chip nach dem größten Modell, das Sie ausführen wollen, und prüfen Sie dann diese Obergrenzen-Tabelle: Liegt die Obergrenze unter 10 Tokens/s, fühlt sich das Modell langsam an, egal wie viele GPU-Kerne Sie kaufen.
- So lesen Sie die Tabelle: Die Werte sind theoretische Obergrenzen in Tokens/s. Multiplizieren Sie mit 0,6–0,8 für einen realistischen Bereich — für Llama 3.3 70B Q4 auf einem M5 Max mit 614 GB/s sind das grob 9–12 Tokens/s.
- Unabhängige Gegenprobe: MacStories maß 48 Tokens/s bei der Generierung mit Qwen3.8 27B auf einem M5-Ultra-Mac-Studio (Prompt mit 6.091 Tokens), gegenüber 59 Tokens/s auf einer RTX 5090 (1,79 TB/s Bandbreite). Das tatsächliche Tempo folgte der Bandbreite, nicht der Kernzahl.
- Faustregel zur Dimensionierung: Modelldatei plus KV-Cache müssen in etwa zwei Drittel bis drei Viertel des Unified Memory passen — ein 70B-Q4-Modell (~42,5 GB) braucht also einen Mac mit 64 GB; Q5 und Q8 brauchen 128 GB.
Modell (Q4_K_M) | Dateigröße | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1,2 TB/s |
|---|---|---|---|---|---|
| Llama 3,1 8B | ~4,9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3,3 70B | ~42,5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro: neuer günstiger Einstieg für lokale LLMs
Apple hat am 25. August 2026 erstmals einen M5-Pro-Chip in den Mac mini eingebaut — zuvor gab es den M5 Pro nur im MacBook Pro. Mit 1.699–2.699 $ bei 24–64 GB Unified Memory ist der Mac mini M5 Pro der günstigste Weg zur 64-GB-Obergrenze des M5 Pro und unterbietet das MacBook Pro M5 Pro. Der Mac Studio beginnt jetzt beim M5 Max. Seit dem 22. September 2026 erhältlich.
- CPU: 15-Kern- oder 18-Kern-M5-Pro
- GPU: 16-Kern- oder 20-Kern-M5-Pro-GPU
- Speicher: 24 GB Basis, konfigurierbar auf 48 oder 64 GB LPDDR5X Unified Memory
- Speicherbandbreite: 307 GB/s (identisch mit dem M5 Pro im MacBook Pro)
- Speicherplatz: 512 GB–2 TB SSD (konfigurierbar)
- Anschlüsse: Thunderbolt 5 (neu beim Mac mini)
- Konnektivität: Wi-Fi 7, Bluetooth 6
- Preis: 1.699 $ (15-Kern-CPU/16-Kern-GPU, 24 GB); 2.699 $ (18-Kern-CPU/20-Kern-GPU, 64 GB)
- Verfügbarkeit: lieferbar seit 22. September 2026
Mac Studio M5 Max 36 GB: Basiskonfiguration
Der Basis-Mac-Studio M5 Max startet bei 2.499 $ mit 32-Kern-GPU und 36 GB Unified Memory; größere Speicheroptionen gibt es mit der 40-Kern-GPU-Stufe weiter unten. Seit dem 22. September 2026 lieferbar. Der Mac Studio bietet überhaupt keine M5-Pro-Stufe mehr — dies ist jetzt der günstigste Mac Studio.
- CPU: 18-Kern-M5-Max
- GPU: 32-Kern-M5-Max-GPU
- Speicher: 36 GB LPDDR5X Unified Memory in dieser GPU-Stufe
- Speicherbandbreite: 460 GB/s (identisch mit dem M5 Max mit 32-Kern-GPU im MacBook Pro)
- Speicherplatz: 512 GB–8 TB SSD (konfigurierbar)
- Anschlüsse: Thunderbolt 5
- Leistungsaufnahme: geschätzt 65–100 W unter Dauerinferenz; Lüfter drehen selten hoch
- Preis: 2.499 $
- Verfügbarkeit: lieferbar seit 22. September 2026
Mac Studio M5 Max 48–128 GB: bestes Preis-Leistungs-Verhältnis für lokale 70B-LLMs
Der Mac Studio M5 Max mit 40-Kern-GPU startet bei 3.099 $ (48 GB) und lässt sich bis 128 GB für 5.099 $ konfigurieren. Diese Stufe liefert das Versprechen „bester Wert für 70B“: 64 GB gibt es hier für 3.499 $ mit den vollen 614 GB/s Bandbreite. Seit dem 22. September 2026 lieferbar.
- CPU: 18-Kern-M5-Max
- GPU: 40-Kern-M5-Max-GPU
- Speicher: 48 GB Basis, konfigurierbar auf 64 oder 128 GB LPDDR5X Unified Memory
- Speicherbandbreite: 614 GB/s (identisch mit dem M5 Max mit 40-Kern-GPU im MacBook Pro)
- Speicherplatz: 512 GB–8 TB SSD
- Anschlüsse: Thunderbolt 5
- Leistungsaufnahme: geschätzt 65–100 W unter Dauerinferenz; moderate Lüfteraktivität bei starker Multi-Modell-Nutzung
- Preis: 3.099 $ (48 GB); 3.499 $ (64 GB); 5.099 $ (128 GB)
- Verfügbarkeit: lieferbar seit 22. September 2026
Mac Studio M5 Ultra: neue Stufe für maximale Leistung
Der Mac Studio M5 Ultra ist eine neue Spitzenstufe über dem M5 Max, ab 5.499 $ mit 96 GB und skalierbar bis 512 GB. Die Konfigurationen mit 96–256 GB werden seit dem 22. September 2026 ausgeliefert; die 512-GB-Konfiguration folgt Ende Oktober 2026 und wird deutlich über 10.000 $ erwartet. Sie erreicht die 512-GB-Speichergrenze des M3 Ultra der Vorgängergeneration mit 50 % mehr Bandbreite.
- CPU: 30-Kern-M5-Ultra (36-Kern konfigurierbar)
- GPU: 64 Kerne in der Basis, 80 Kerne konfigurierbar
- Speicher: 96 GB Basis, konfigurierbar auf 256 GB jetzt, 512 GB ab Ende Oktober 2026
- Speicherbandbreite: bis zu 1,2 TB/s (1.228,8 GB/s; 50 % mehr als die 819 GB/s des M3 Ultra)
- Speicherplatz: 1–16 TB SSD
- Anschlüsse: Thunderbolt 5
- Preis: 5.499 $ (Basis mit 96 GB: 30-Kern-CPU/64-Kern-GPU); 512 GB deutlich über 10.000 $ erwartet
- Verfügbarkeit: lieferbar seit 22. September 2026 (96–256 GB); Ende Oktober 2026 (512 GB)
MacBook Pro 16" M5 Max: mobile lokale LLMs
Das MacBook Pro 16" M5 Max (3.499–4.499 $) nutzt dasselbe M5-Max-Silizium wie der Mac Studio in mobiler Bauform. Die Speicherbandbreite entspricht dem Mac Studio in jeder GPU-Stufe — 460 GB/s mit der 32-Kern-GPU und 614 GB/s mit der 40-Kern-GPU. Beachten Sie: Das MacBook Pro mit 64 GB nutzt die 32-Kern-GPU, der Mac Studio mit 64 GB die 40-Kern-GPU. Thermisches Drosseln bei Dauerinferenz ist der Preis für die Mobilität.
- CPU: 18-Kern-M5-Max (6 Super- + 12 Performance-Kerne)
- GPU: 32-Kern- oder 40-Kern-M5-Max-GPU
- Speicher: 64 GB oder 128 GB Unified Memory
- Display: 16,2 Zoll Liquid Retina XDR, 3456×2234
- Speicherbandbreite: 460 GB/s (64 GB, 32-Kern-GPU) oder 614 GB/s (128 GB, 40-Kern-GPU)
- Speicherplatz: 512 GB–8 TB SSD
- Akku: in Stunden Videowiedergabe angegeben; Dauerinferenz entlädt ihn deutlich schneller
- Gewicht: 2,14 kg
- Anschlüsse: 3× Thunderbolt 5, HDMI 2.1, SD-Kartenleser, Kopfhöreranschluss
- Preis: 3.499 $ (64 GB, 32-Kern-GPU) bis 4.499 $ (128 GB, 40-Kern-GPU)
🏆 Unsere Empfehlungen: Welcher Mac für lokale LLMs?
Klare Empfehlungen je nach Einsatzzweck.
- 🏆 💰 GÜNSTIGSTER M5 PRO: Mac mini M5 Pro (1.699 $, lieferbar) • Warum: erster Mac mini mit M5 Pro. Unterbietet jede bisherige Möglichkeit, einen M5 Pro zu bekommen, auch das MacBook Pro. 24 GB Basis reichen für 7B–14B; mit 64 GB konfiguriert für 30B. • Für wen: preisbewusste Einsteiger in Apple Silicon. • Im Apple Store kaufen →
- 🥇 BESTER WERT FÜR 70B: Mac Studio M5 Max 64 GB (3.499 $, lieferbar) • Warum: führt Llama 3.3 70B Q4 mit geschätzt 9–12 Tokens/s bei den vollen 614 GB/s aus. Die Desktop-Kühlung verhindert thermisches Drosseln. • Für wen: Entwickler, die einen 70B-Workflow ohne Mobilitätsbedarf standardisieren. • Im Apple Store kaufen →
- 🔥 MAXIMALE LEISTUNG: Mac Studio M5 Ultra 96 GB (5.499 $, lieferbar) • Warum: Spitzenstufe. Bis zu 1,2 TB/s Bandbreite — doppelt so viel wie der M5 Max. Die 512-GB-Konfiguration folgt Ende Oktober 2026 für die größten lokalen Modelle. • Status: erste unabhängige Messungen liegen vor (MacStories: 48 Tokens/s mit Qwen3.8 27B vs. 59 auf einer RTX 5090). • Im Apple Store kaufen →
- 💼 BESTE MOBILE OPTION: MacBook Pro 16" M5 Max (3.499 $ für 64 GB, 460 GB/s; 4.499 $ für 128 GB, 614 GB/s) • Warum: dasselbe M5-Max-Silizium wie im Mac Studio im Notebook mit Liquid-Retina-XDR-Display. Rechnen Sie mit 10–15 % weniger Dauertempo durch thermisches Drosseln. • Alternative: Der Mac Studio M5 Max mit 64 GB (3.499 $) kostet dasselbe, bietet 614 GB/s und bessere Dauerkühlung, wenn Sie keine Mobilität brauchen. • Im Apple Store kaufen →
Leistung lokaler LLMs: bandbreitenbasierte Schätzungen und unabhängige M5-Ultra-Ergebnisse
Bislang gibt es nur für den M5 Ultra unabhängige Messungen (MacStories, am Ende dieses Abschnitts aufgeführt). Für M5 Pro und M5 Max sind die folgenden Bereiche Schätzungen: Jeder entspricht 60–80 % der Bandbreitenobergrenze (Bandbreite ÷ Modelldateigröße) und wurde mit Community-Berichten und MacBook-Pro-Ergebnissen abgeglichen — keine Labormessungen am Mac-mini- oder Mac-Studio-Gehäuse. Die Bereiche sind nach Speicherbandbreite beschriftet, weil das MacBook Pro mit 64 GB (460 GB/s) und der Mac Studio mit 64 GB (614 GB/s) sich unterscheiden. Rechnen Sie mit ±10–15 % je nach macOS-Version, Laufzeitversion, Quantisierung und Kontextlänge. Die RTX-4090-Referenzwerte sind ungefähre Community-Zahlen.
- ## Llama 3.1 8B (Q4_K_M, ~4,9 GB) • M5 Pro (307 GB/s): 38–50 Tokens/s • M5 Max (460 GB/s): 56–75 Tokens/s • M5 Max (614 GB/s): 75–100 Tokens/s • Referenz (RTX 4090): 90–120 Tokens/s
- ## Mistral Small 24B (Q4_K_M, ~14 GB) • M5 Pro (307 GB/s): 13–17 Tokens/s • M5 Max (460 GB/s): 19–26 Tokens/s • M5 Max (614 GB/s): 26–34 Tokens/s
- ## Qwen3 32B (Q4_K_M, ~20 GB) • M5 Pro (307 GB/s): 9–12 Tokens/s • M5 Max (460 GB/s): 14–19 Tokens/s • M5 Max (614 GB/s): 19–25 Tokens/s
- ## Llama 3.3 70B (Q4_K_M, ~42,5 GB) • M5 Pro 64 GB (307 GB/s): 4–6 Tokens/s • M5 Max (460 GB/s): 6–9 Tokens/s • M5 Max (614 GB/s): 9–12 Tokens/s • M5 Ultra: Obergrenze etwa 29 Tokens/s (noch keine unabhängige 70B-Messung) • Referenz (RTX 4090): 6–10 Tokens/s mit teilweisem CPU-Offload
- ## Llama 3.3 70B (Q5_K_M, ~50 GB) • M5 Pro 64 GB: zu wenig Reserve • M5 Max 128 GB (614 GB/s): 7–10 Tokens/s • Referenz (RTX 4090): nicht möglich (VRAM-Limit)
- ## Llama 3.3 70B (Q8_0, ~75 GB) • M5 Max 128 GB (614 GB/s): 5–7 Tokens/s • RTX 4090: nicht möglich (erfordert Multi-GPU-Offload)
- ## Unabhängige M5-Ultra-Ergebnisse (MacStories, Gerät mit 256 GB, oMLX) • Qwen3.8 27B, Prompt mit 6.091 Tokens: M5 Ultra 48 Tokens/s Generierung, 1.701 Tokens/s Prompt-Verarbeitung, 4,0 s bis zum ersten Token — RTX 5090: 59 Tokens/s, 3.031 Tokens/s, 2,0 s • Qwen3.8 27B bei langem Kontext (Generierung): 38,9 Tokens/s bei 64K, 32,4 bei 128K, 24,3 bei 256K — RTX 5090: 49,6, 40,4, 30,0 • Flash-Next, kurzer Prompt: 108 Tokens/s auf dem M5 Ultra vs. 70 auf einem M3 Ultra (+54 %)
- ## Methodik Die Bereiche für M5 Pro und M5 Max sind als 60–80 % von Bandbreite ÷ Modelldateigröße abgeleitet und mit Community-Ergebnissen wie dem MLX-vs.-GGUF-Test verglichen, der auf unserer Benchmark-Seite M5 Pro vs. M5 Max zitiert wird. Die M5-Ultra-Werte sind eigene Messungen von MacStories mit oMLX 0.7.0.dev2 unter macOS 27.0; die Modellnamen stammen von dort. Behandeln Sie jeden Tokens/s-Wert für den M5 Ultra bei hier nicht aufgeführten Modellen als unbestätigt.
Apple Silicon M5 vs. PC-Workstation für lokale LLMs
Apple Silicon und NVIDIA verfolgen unterschiedliche Philosophien. Hier der ehrliche Vergleich.
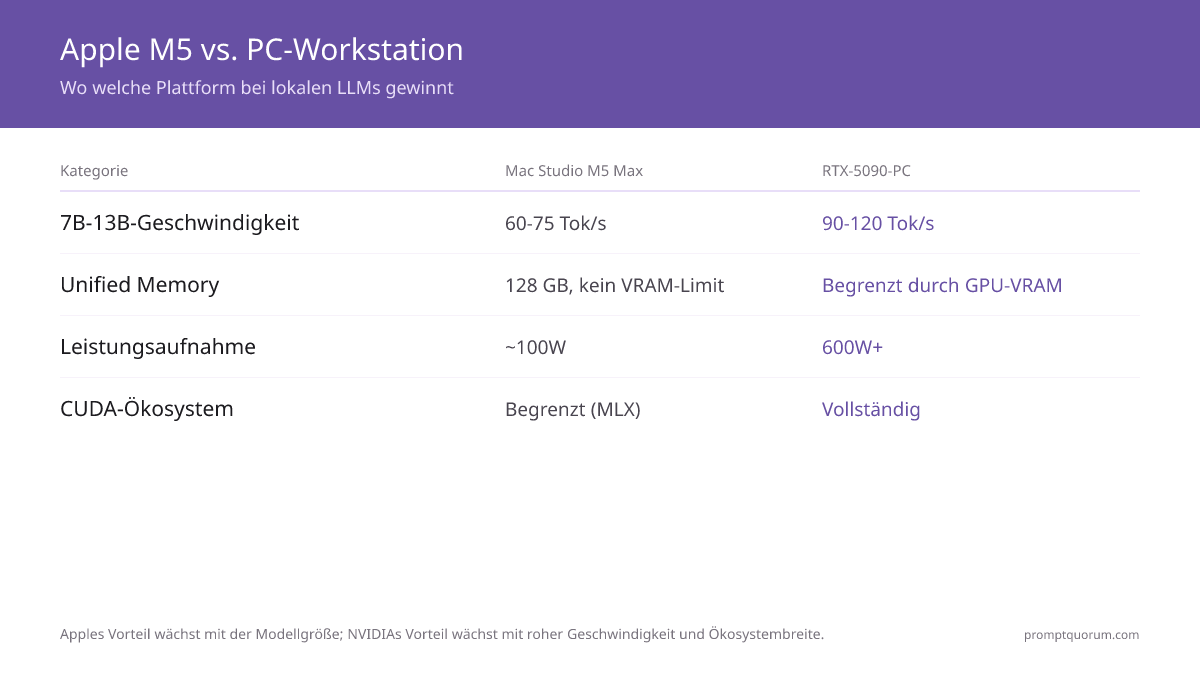
- ## Mac Studio M5 Max/Ultra gewinnt bei: • Unified Memory: bis 128 GB (M5 Max) oder 512 GB (M5 Ultra) für jedes Modell, kein VRAM-Limit • Energieeffizienz: grob 100 W vs. 600 W+ bei einem vergleichbaren PC • Leiser Betrieb: Lüfter bei typischen Lasten selten hörbar • macOS-Ökosystem: MLX, Metal, Core ML • Gesamtkosten: geringere Stromkosten über 3 Jahre • Modelle über 32 GB: Eine RTX 5090 endet bei 32 GB VRAM
- ## PC-Workstation (RTX 4090/5090) gewinnt bei: • Rohtempo bei Modellen, die in den VRAM passen: MacStories maß eine RTX 5090 mit 59 Tokens/s gegenüber 48 auf dem M5 Ultra bei Qwen3.8 27B und etwa 1,8-fach schnellere Prompt-Verarbeitung (3.031 vs. 1.701 Tokens/s) • Breite des CUDA-Ökosystems: mehr Modelle, Tools, Forschungscode • Fine-Tuning: PyTorch + CUDA dominiert gegenüber MLX • Upgrade-Flexibilität: GPUs tauschen, mehr VRAM ergänzen • Preis in niedrigeren Stufen: Eine günstige RTX 4070 Ti (800–1.200 $) schlägt den M5 Pro bei kleinen Modellen • KI jenseits von LLMs: Stable Diffusion, Training und Multimodal laufen auf NVIDIA in der Regel schneller
- ## Das ehrliche Fazit Bei reiner lokaler LLM-Inferenz mit 30B–70B-Modellen konkurriert der Mac Studio M5 Max mit 128 GB (5.099 $) direkt mit PC-Builds ab 4.500 $, und der Mac Studio M5 Ultra hebt die Obergrenze auf Modelle, die 256 GB oder 512 GB brauchen. Der Unified-Memory-Vorteil ist real und messbar. Bei Modellen, die in 24–32 GB VRAM passen, ist ein PC mit RTX 4090 oder 5090 schneller als jeder Mac. Der Vorteil von Apple schrumpft bei kleineren Modellen. Für Fine-Tuning, Training, Stable Diffusion in großem Maßstab oder produktives PyTorch gewinnt PC + NVIDIA. MLX wird besser, aber Lücken bleiben.
MLX vs. Ollama vs. llama.cpp auf Apple Silicon
Auf dem M5 laufen drei wichtige Inferenz-Engines. Welche passt zu Ihnen?
- ## MLX (Apple-nativ) • Leistung: in der Regel die höchsten Tokens/s auf dem M5; native Metal-Optimierung und Unterstützung der Neural Accelerators. • Modellunterstützung: wächst (Llama, Qwen, Mistral, Gemma verfügbar) • Einrichtung: Python-zentriert, Kommandozeilen-Kenntnisse nötig • Ideal für: Power-User, die maximale Leistung wollen • Nachteil: weniger benutzerfreundlich als Ollama
- ## Ollama (plattformübergreifend) • Leistung: GGUF-Modelle laufen über das Metal-Backend von llama.cpp; ein MLX-Backend (Vorschau seit Ollama 0.19, März 2026) beschleunigt ausgewählte Modelle, besonders auf M5-Chips • Modellunterstützung: größte Modellbibliothek. Wöchentlich neue Modelle. • Einrichtung: Installation mit einem Befehl, funktioniert sofort • Ideal für: Einsteiger und die meisten Entwickler. REST-API zur Integration. • Nachteil: kann langsamer sein als natives MLX, wo es einen MLX-Build des Modells gibt (der Abstand variiert je nach Modell und Version)
- ## llama.cpp (plattformübergreifend, feinste Kontrolle) • Leistung: bei Optimierung konkurrenzfähig zu Ollama (Ollama nutzt es für GGUF-Modelle) • Anpassung: größte Kontrolle über Quantisierung und Inferenzparameter • Einrichtung: erfordert Kompilierung und Kommandozeilen-Expertise • Ideal für: Forschende, eigene Quantisierungs-Workflows • Nachteil: steilere Lernkurve als Ollama
- ## Empfehlung nach Nutzertyp • Einsteiger: Ollama (funktioniert sofort, umfangreiche Dokumentation) • Entwickler: Ollama-REST-API (leicht in Anwendungen zu integrieren) • Power-User: MLX direkt (maximale Leistung) • Forschende: llama.cpp (maximale Anpassbarkeit)
macOS-Schnellstart (10 Schritte)
Der schnellste Weg zum ersten lokalen 70B-LLM auf Apple Silicon.
- 1Mac kaufen
Why it matters: Mac mini M5 Pro für Budget/Einstieg, Mac Studio M5 Max oder M5 Ultra für Desktop-Leistung oder MacBook Pro 16" M5 Max für Mobilität. - 2macOS einrichten
Why it matters: Nutzen Sie den Migrationsassistenten (Übertragung vom alten Mac) oder eine Neuinstallation. Halten Sie macOS aktuell — Apple liefert Metal-Leistungsverbesserungen in Punkt-Updates. - 3Homebrew installieren
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — Paketmanager für alles Weitere. - 4Ollama installieren
Why it matters: brew install ollama — einfache Installation mit einem Befehl. - 5Ollama-Dienst starten
Why it matters: ollama serve (läuft im Vordergrund) oder Ollama.app aus dem Programme-Ordner verwenden. - 6Erstes Testmodell laden
Why it matters: ollama pull llama3.1:8b — Installation mit einem kleinen Modell prüfen (Download ca. 4 GB). - 7Einfache Inferenz testen
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — die Zeile „eval rate“ zeigt Ihre Tokens/s. - 8Großes Zielmodell laden
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M (Download ca. 40 GB). Das dauert bei schneller Verbindung 20–40 Minuten und erfordert einen Mac mit mindestens 64 GB. - 9Leistung überwachen
Why it matters: asitop zeigt die Ressourcennutzung von Apple Silicon. In einem zweiten Terminal: brew install asitop && asitop. - 10Optional: LM Studio als GUI installieren
Why it matters: Download von lmstudio.ai. Einfacher als die Kommandozeile für Nicht-Entwickler; enthält eine MLX-Engine für Apple Silicon.
Ollama auf Apple Silicon M5 beschleunigen
Die meisten Ollama-Installationen auf Apple Silicon nutzen standardmäßig bereits den schnellen Pfad. Die Checkliste unten beseitigt daher Dinge, die unbemerkt bremsen, statt exotisches Tuning zu verlangen.
📍 In einem Satz
Prüfen Sie mit `ollama ps`, dass das Modell zu 100 % auf der GPU läuft, schaffen Sie Unified Memory frei, verkleinern Sie die Kontextlänge, nutzen Sie eine Q4-Quantisierung, aktivieren Sie Flash Attention und halten Sie ein MacBook Pro am Netz und erhöht — das Generierungstempo ist durch die Speicherbandbreite begrenzt, der größte Gewinn liegt daher in einem Modell, das dazu passt.
💬 In einfachen Worten
Ollama ist auf einem M5-Mac meist schon standardmäßig schnell — die meisten Tempoprobleme kommen von etwas, das Ihren Unified Memory belegt, von einem für Ihre Bandbreite zu großen Modell oder von einem überhitzten Notebook, nicht von einer vergessenen Einstellung.
- Passen Sie zuerst das Modell an Ihre Bandbreite an. Die Tokens/s sind nahe bei Bandbreite ÷ Modelldateigröße gedeckelt (siehe Bandbreiten-Abschnitt oben). Ein 70B-Modell mit 42 GB auf einem M5 Pro mit 307 GB/s kommt trotz jedes Tunings nicht über etwa 7 Tokens/s; ein 32B-Modell mit 20 GB erreicht etwa 15. Der Wechsel zu einem kleineren Modell oder einer kleineren Quantisierung bringt den größten Tempogewinn.
- Prüfen Sie, dass das Modell vollständig auf die GPU ausgelagert ist und nicht auf die CPU zurückfällt. Führen Sie `ollama ps` bei geladenem Modell aus — die Spalte PROCESSOR sollte 100% GPU zeigen. Eine teilweise CPU-Aufteilung bedeutet meist, dass das Modell nicht in den Speicher passt, den macOS der GPU erlaubt, nicht dass eine Einstellung fehlt.
- Schaffen Sie vor langen Sitzungen Unified Memory frei. Der Speicher wird zwischen macOS und Modell geteilt — ein Browser mit vielen Tabs, Docker Desktop oder Xcode im Hintergrund kann Ollama mehrere GB wegnehmen. Beenden Sie sie vor dem Laden eines großen Modells und prüfen Sie den freien Speicher mit der Aktivitätsanzeige oder `asitop`. Bei großen Modellen lässt sich das GPU-Speicherlimit mit `sudo sysctl iogpu.wired_limit_mb=<MB>` anheben (wird beim Neustart zurückgesetzt).
- Verkleinern Sie das Kontextfenster, wenn Sie es nicht brauchen. Setzen Sie in der Modelfile oder API-Anfrage ein kleineres `num_ctx` (z. B. 4096 statt 32K) für kurze Chats — das senkt den KV-Cache-Speicherdruck und beschleunigt die Generierung.
- Aktivieren Sie Flash Attention und einen quantisierten KV-Cache. `OLLAMA_FLASH_ATTENTION=1` und `OLLAMA_KV_CACHE_TYPE=q8_0` verringern den KV-Cache-Speicher und beschleunigen lange Kontexte bei geringem Qualitätsverlust.
- Passen Sie die Quantisierung an Ihre tatsächlichen Qualitätsanforderungen an. Q4_K_M ist spürbar schneller als Q8_0 oder Q5_K_M bei geringem, meist akzeptablem Qualitätsverlust (siehe Quantisierungs-Ratgeber). Läuft ein Modell langsamer als in den Benchmarks oben, laden Sie die Q4-Variante, bevor Sie die Hardware verdächtigen.
- Halten Sie das MacBook Pro am Netz und erhöht für anhaltende Inferenz. Das MacBook Pro kann nach 2–3 Stunden Dauerlast um 10–15 % drosseln, weil sich im flacheren Gehäuse Wärme aufstaut. Ein Notebook-Ständer für bessere Luftzirkulation und Netzbetrieb verzögern das Drosseln. Bei Sitzungen über einige Stunden hält die Kühlung des Mac Studio die volle Leistung.
- Aktualisieren Sie macOS und Ollama. Apple liefert Metal-Leistungsverbesserungen in Punkt-Updates, und Ollama veröffentlicht regelmäßig schnellere Backends — auch MLX-Unterstützung für mehr Modelle. Eine alte Version auf neuem M5-Silizium verschenkt Leistung.
- Vermeiden Sie mehrere gleichzeitig geladene Modelle, wenn Sie sie nicht brauchen. Jedes geladene Modell reserviert einen eigenen Anteil des Unified Memory. `OLLAMA_MAX_LOADED_MODELS` steuert, wie viele Modelle Ollama gleichzeitig im Speicher hält.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
Entscheidungsmatrix: Welche Mac-Konfiguration kaufen?
Finden Sie mit dieser Matrix die passende Konfiguration für Ihren Einsatzzweck. Bei gleichem Speicher wählen Sie die Variante mit höherer Bandbreite.
- 1. Budget hat Vorrang, kleinere Modelle (7–14B) genügen: Mac mini M5 Pro 24 GB (1.699 $) — günstigster M5 Pro aller Zeiten
- 2. 30B-Modelle auf einem günstigen Desktop: Mac mini M5 Pro 64 GB (2.699 $)
- 3. 70B-Modelle komfortabel ausführen: Mac Studio M5 Max 64 GB (3.499 $)
- 4. 70B Q5 mit Kontextfenstern ab 32K: Mac Studio M5 Max 128 GB (5.099 $)
- 5. 256–512 GB für die größten lokalen Modelle: Mac Studio M5 Ultra (5.499–10.000+ $)
- 6. Mobile lokale LLMs, thermisches Drosseln akzeptabel: MacBook Pro 16" M5 Max 64 GB (3.499 $)
- 7. Bereits im macOS-Ökosystem (Xcode, Final Cut Pro): jede M5-Mac-Studio-Variante
- 8. Forschung/Fine-Tuning mit MLX-Experimenten: Mac Studio M5 Max 128 GB oder M5 Ultra (Speicherreserve)
- 9. Maximale Ruhe und Leerlauf-Betrieb: Mac Studio (Lüfter drehen bei normaler Last selten)
- 10. Budget ab 4.000 $, mobil gewünscht: MacBook Pro 16" M5 Max 128 GB (4.499 $)
- 11. Alternativen im Blick: PC mit RTX 4090 (ab 3.000 $) oder AMD-Ryzen-AI-Max+-Mini-PC (1.600–2.000 $)
Wann Apple Silicon M5 für lokale LLMs die falsche Wahl ist
Apple Silicon ist hervorragend, aber nicht universell. In diesen Fällen sollten Sie auf einen Mac für lokale LLMs verzichten.
- Sie brauchen CUDA-exklusive Workflows: Die meiste LLM-Inferenz läuft auf Apple Silicon, aber Fine-Tuning mit torch.cuda, vLLM-CUDA-Kernels und proprietärer CUDA-Forschungscode laufen nicht auf MLX. Ist der Großteil Ihrer Arbeit CUDA-spezifisch, nehmen Sie eine RTX-GPU.
- Sie arbeiten viel mit Stable Diffusion: Diffusionsmodelle laufen auf dem M5 in der Regel langsamer als auf einer RTX 4090. Macht Bildgenerierung 30 % oder mehr Ihres Workflows aus, gewinnt PC + RTX.
- Das Budget ist absolute Priorität: Ein PC für 1.500 $ mit RTX 4070 Ti schlägt den Mac mini M5 Pro beim Tempo kleiner Modelle. Zählt nur das Budget, ist der PC günstiger.
- Sie brauchen Aufrüstbarkeit: RAM und Speicher des Mac Studio sind beim Kauf fest. PCs erlauben schrittweise Upgrades. Bei 5+ Jahren Nutzung kann der PC langfristig günstiger sein.
- Sie verlangen dreistellige Tokens/s bei kleinen Modellen: Die RTX 4090 erreicht 90–120 Tokens/s mit Llama 8B. Für den M5 Max sind 75–100 geschätzt. Bei hohem Durchsatz (mehrere Nutzer) gewinnt NVIDIA weiterhin.
- Sie nutzen macOS bisher nicht: Der Wechsel von Windows/Linux allein für lokale LLMs lohnt sich nicht, es sei denn, Sie wollen macOS auch aus anderen Gründen.
- Sie brauchen 24/7-Produktionsinferenz: Der Mac Studio ist ausgezeichnet, aber für Lastspitzen gedacht. Für kontinuierliche Inferenz mit SLA sind NVIDIA-Workstations in Unternehmensqualität die sicherere Wahl.
Häufig gestellte Fragen
Wie hoch ist die Speicherbandbreite von M5 Pro, M5 Max und M5 Ultra?
Der M5 hat 153,6 GB/s, der M5 Pro 307 GB/s, der M5 Max 460 GB/s (32-Kern-GPU) oder 614 GB/s (40-Kern-GPU) und der M5 Ultra bis zu 1,2 TB/s (1.228,8 GB/s). Für die LLM-Generierung zählt die Bandbreite mehr als die GPU-Kernzahl, weil jedes Token die Modellgewichte einmal aus dem Speicher liest.
Wie viel VRAM hat ein M5-Mac?
Keinen separaten — ein M5-Mac hat Unified Memory, das sich CPU und GPU teilen. Standardmäßig erlaubt macOS der GPU grob zwei Drittel bis drei Viertel des gesamten RAM, ein Mac mit 64 GB bietet einem Modell also etwa 48 GB. Der M5 Pro geht bis 64 GB, der M5 Max bis 128 GB und der M5 Ultra bis 512 GB.
Wie läuft Ollama auf einem MacBook Pro M5 schneller?
Wählen Sie ein zur Bandbreite passendes Modell, prüfen Sie mit `ollama ps`, dass es zu 100 % auf der GPU läuft, schließen Sie speicherhungrige Hintergrund-Apps, verkleinern Sie `num_ctx`, wenn Sie kein langes Kontextfenster brauchen, nutzen Sie Q4_K_M statt Q5/Q8, aktivieren Sie `OLLAMA_FLASH_ATTENTION=1` und halten Sie das MacBook Pro bei Sitzungen über 2–3 Stunden am Netz und erhöht. Die vollständige Checkliste steht im Abschnitt zur Beschleunigung oben.
Kann der Mac Studio M5 Max Llama 3.3 70B ausführen?
Ja, mit 64 GB oder 128 GB. 70B Q4 (~42,5 GB) braucht 64 GB und läuft mit geschätzt 6–9 Tokens/s auf dem Chip mit 460 GB/s und 9–12 Tokens/s auf dem Chip mit 614 GB/s. 70B Q5 (~50 GB) braucht die 128-GB-Konfiguration und läuft mit geschätzt 7–10 Tokens/s.
Wie schneidet der M5 Max im Vergleich zur RTX 4090 für lokale LLMs ab?
Der M5 Max ist bei kleinen Modellen, die in 24 GB passen, langsamer (geschätzt 75–100 vs. 90–120 Tokens/s bei Llama 8B). 70B-Modelle fasst die 4090 nicht und weicht auf CPU-Offload mit etwa 6–10 Tokens/s aus, während ein M5 Max mit 614 GB/s sie mit geschätzt 9–12 Tokens/s bei rund einem Drittel der Leistungsaufnahme ausführt.
Reichen 64 GB RAM oder brauche ich 128 GB?
Für ein einzelnes 70B-Q4-Modell genügen 64 GB. Für 70B Q5 oder Q8, mehrere parallele Modelle, lange Kontexte oder Fine-Tuning sind 128 GB empfehlenswert. Die Speichergröße ändert das Tempo nicht — ein Mac Studio M5 Max mit 64 GB und mit 128 GB hat jeweils 614 GB/s.
Was ist der Unterschied zwischen M5 Pro und M5 Max bei LLMs?
Der M5 Pro hat eine 16/20-Kern-GPU, 307 GB/s Bandbreite und bis zu 64 GB. Der M5 Max hat eine 32/40-Kern-GPU, 460/614 GB/s und bis zu 128 GB. Da das Generierungstempo mit der Bandbreite skaliert, ist der M5 Max bei gleichem Modell etwa 1,5-fach (460 GB/s) bis 2-fach (614 GB/s) schneller. Der M5 Ultra (nur Mac Studio) geht weiter: bis zu 80-Kern-GPU, bis zu 1,2 TB/s und bis zu 512 GB.
Wie schnell ist der Mac Studio M5 Ultra für lokale LLMs?
MacStories maß 48 Tokens/s bei der Generierung mit Qwen3.8 27B auf einem M5 Ultra mit 256 GB (RTX 5090: 59) und 108 Tokens/s mit einem kleineren Flash-Next-Modell, rund 54 % schneller als ein M3 Ultra. Die Bandbreitenobergrenze für ein 70B-Q4-Modell liegt bei etwa 29 Tokens/s; ein unabhängiges 70B-Ergebnis wurde bislang nicht veröffentlicht.
Drosselt das MacBook Pro bei dauerhafter LLM-Inferenz thermisch?
Ja, nach 2–3 Stunden Dauerinferenz kann das MacBook Pro 10–15 % Leistung verlieren (Schätzung). Der Mac Studio hält die volle Leistung rund um die Uhr.
Kann ich Stable Diffusion auf Apple Silicon ausführen?
Ja, Stable Diffusion XL läuft auf dem M5 mit etwa 8–12 Sek./Bild (langsamer als eine RTX 4070 mit etwa 3 Sek.). MLX unterstützt es nativ.
Ist MLX auf dem Mac schneller als Ollama?
Meist, bei Modellen mit MLX-Build: MLX ist typischerweise schneller als GGUF-Modelle auf llama.cpp, berichtet werden je nach Modell und Version Abstände von etwa 10 % bis 2×. Ollama hat im März 2026 ein MLX-Backend ergänzt, das den Abstand bei unterstützten Modellen verkleinert. Entscheiden Sie nach Workflow, nicht nach Rohtempo.
Wie viel Strom verbraucht der Mac Studio M5 Max bei LLM-Inferenz?
Geschätzt 65–100 W Dauerleistung des M5 Max unter LLM-Last; Apple gibt für das Mac-Studio-Gehäuse bis zu 480 W maximale Dauerleistung an, die Inferenz allein nicht erreicht. Ein Monat 24/7-Inferenz (720 Stunden) bei 100 W sind ~72 kWh, rund 8–12 $ US-Strom; ein RTX-4090-System kostet etwa 40–60 $.
Hat der Mac mini jetzt den M5 Pro?
Ja. Der Mac mini M5 Pro startet bei 1.699 $ (24 GB, bis 64 GB), 307 GB/s Bandbreite, Thunderbolt 5, und wird seit dem 22. September 2026 ausgeliefert — der günstigste M5-Pro-Mac aller Zeiten.
Bietet der Mac Studio noch eine M5-Pro-Konfiguration an?
Nein. Seit dem Update vom 25. August 2026 startet der Mac Studio beim M5 Max (2.499 $). Der Mac mini ist stattdessen der Einstieg in den M5-Pro-Chip.
Was ist der Mac Studio M5 Ultra und wie viel Speicher unterstützt er?
Der M5 Ultra ist ein Chip oberhalb des M5 Max, exklusiv im Mac Studio, ab 5.499 $ (96 GB). Er skaliert auf 256 GB jetzt und 512 GB Ende Oktober 2026 (deutlich über 10.000 $ erwartet) mit bis zu 1,2 TB/s Bandbreite.
Kann ich Modelle auf Apple Silicon feinabstimmen?
Ja, LoRA-Fine-Tuning funktioniert gut. Fine-Tuning mit allen Gewichten ist langsamer als auf einer Desktop-GPU (noch keine Unterstützung für verteiltes Training).
Ist Apple Silicon gut für Inferenz, aber schlecht für Training?
Teilweise. Inferenz ist ausgezeichnet. Training/Fine-Tuning funktioniert, ist aber langsamer als auf NVIDIA. Das MLX-Framework verbessert sich schnell.
Wie hilft die Neural Engine bei LLMs?
Die Token-Generierung ist durch die Speicherbandbreite begrenzt, nicht durch die Neural Engine. Auf M5-Chips beschleunigen die Neural Accelerators in jedem GPU-Kern die Prompt-Verarbeitung (Zeit bis zum ersten Token) in Laufzeiten, die sie nutzen, etwa MLX und das MLX-Backend von Ollama.
Kann ich auf einem M5 Max mit 128 GB mehrere Modelle gleichzeitig ausführen?
Ja. 128 GB erlauben zwei 32B-Modelle oder ein 70B plus ein 14B gleichzeitig bei ordentlichem Tempo.
Wie lange dauert die Einrichtung eines lokalen LLM auf dem Mac?
15–30 Minuten vom frischen Mac bis zum ersten 70B-Modell über Ollama (einschließlich 20–40 Minuten Modell-Download bei schnellem Internet).
Funktioniert Apple Silicon mit den neuesten Open-Weight-Modellen?
Die meisten Open-Weight-Familien — Llama, Qwen, Mistral, Gemma, DeepSeek — laufen wenige Tage nach Veröffentlichung über llama.cpp (GGUF) oder MLX. Die aktuelle Liste finden Sie in der MLX-Community auf Hugging Face und in der Ollama-Bibliothek.
Sollte ich für lokale LLMs den Mac mini M6 oder den Mac mini M5 Pro kaufen?
Der M6 ist der Einstiegs-Mac-mini (899 $, 16–32 GB, grob 153–170 GB/s) und eignet sich für kleine Modelle. Der M5 Pro (1.699 $, bis 64 GB, 307 GB/s) hat etwa die doppelte Bandbreite und Speichergröße und ist damit die Wahl für lokale LLMs.
Lohnt sich ein generalüberholter Mac Studio?
Ja. Apple verkauft generalüberholte Macs mit einem Jahr Garantie, meist mit einem Preisnachlass gegenüber dem Neupreis.
Ist der M5 Max mit 64 GB oder 128 GB die bessere Wahl?
Kaufen Sie 64 GB für ein einzelnes 70B-Q4-Modell und 32B-Modelle; 128 GB für 70B Q5/Q8, lange Kontexte oder mehrere Modelle gleichzeitig. Achten Sie auch auf die GPU-Stufe: Beim MacBook Pro kommen 64 GB mit dem Chip mit 460 GB/s und 128 GB mit dem Chip mit 614 GB/s.