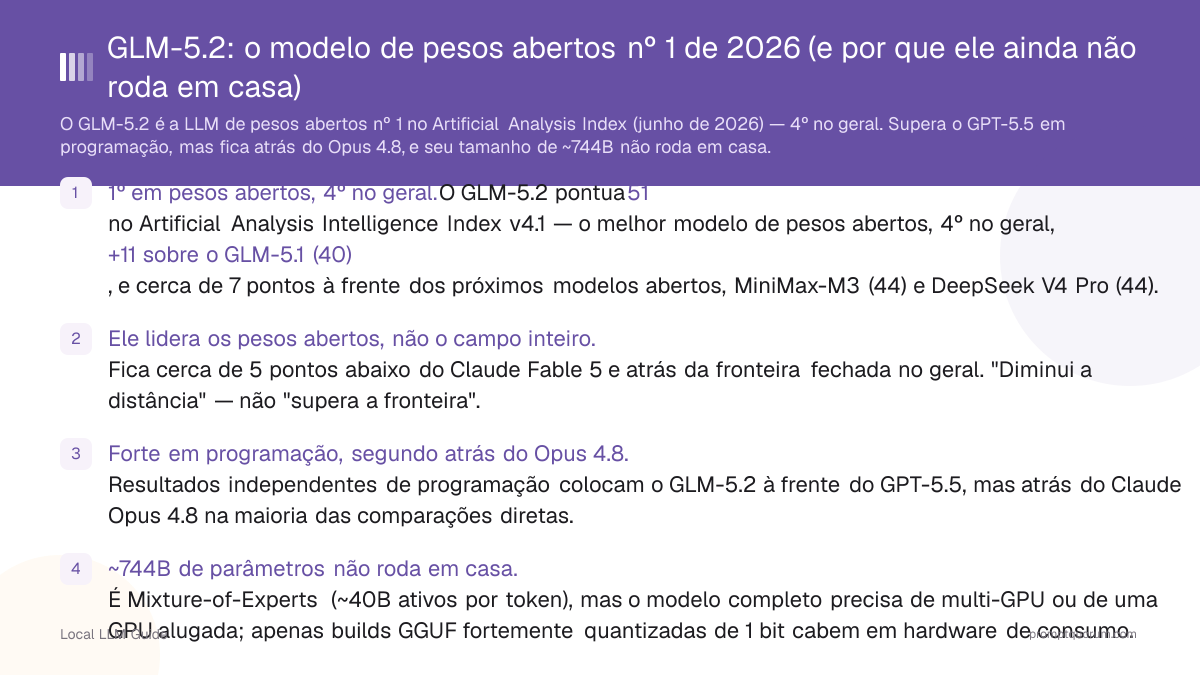
Key Takeaways
- Nº 2 em pesos abertos, era o 1º no lançamento. O GLM-5.2 pontuou 51 no Artificial Analysis Intelligence Index v4.1 no lançamento, em junho de 2026 — o melhor modelo de pesos abertos na época. Desde agosto de 2026, o Kimi K3 da Moonshot AI (57, lançado em 27 de julho de 2026) ocupa o 1º lugar em pesos abertos; o GLM-5.2 (agora com cerca de 52,6 no índice v4.1.1 atualizado) é o 2º, ainda à frente de MiniMax-M3 e DeepSeek V4 Pro (44 cada).
- A Z.ai já lançou uma sucessora, o GLM-5.3. Lançado em 14 de agosto de 2026 sobre o mesmo modelo-base do GLM-5.2, com pós-treinamento mais intenso, o GLM-5.3 apresenta resultados de programação bem melhores (o Terminal-Bench 3.0 subiu de 4,6 para 28,3). Está disponível, por enquanto, apenas via API e Coding Plan da Z.ai; os pesos públicos ainda não haviam sido lançados até esta atualização.
- Forte em programação, mas agora mais distante da fronteira fechada. O GLM-5.2 continua à frente do GPT-5.5 nos benchmarks de programação independentes, mas a Anthropic e a OpenAI lançaram modelos fechados mais novos desde então — Claude Opus 5 e GPT-5.6 Sol — que superam o GLM-5.2 em comparações diretas de programação com uma margem maior do que seus antecessores de junho de 2026.
- ~744B de parâmetros ainda não roda em casa. É Mixture-of-Experts (~40B ativos por token); o modelo completo precisa de multi-GPU ou de uma GPU alugada. O GLM-5.3-Flash, menor, da Z.ai (320B no total / 18B ativos, lançado em 26 de agosto de 2026, licença MIT) é mais fácil de auto-hospedar, embora ainda esteja longe de rodar em uma única GPU de consumo sem forte quantização.
- Os pesos auto-hospedados mantêm seus dados; a API da Z.ai não necessariamente. Os pesos licenciados sob MIT rodam dentro do seu perímetro; a API própria da Z.ai envolve considerações de residência de dados na China.
- Trate os próprios benchmarks da Z.ai como reportados pela empresa. A reprodutibilidade é contestada — priorize os números independentes da Artificial Analysis.
O que é o GLM-5.2?
O GLM-5.2 é um grande modelo de linguagem de pesos abertos lançado em 13 de junho de 2026 pela Z.ai (antiga Zhipu AI), sob a licença MIT e sem limites regionais de uso. Ele passou por benchmarks públicos a partir de 16 de junho de 2026.
- ~744B de parâmetros totais (as fontes citam de 743B a 753B), usando uma arquitetura Mixture-of-Experts com ~40B de parâmetros ativos por token.
- Janela de contexto de 1M de tokens com uma saída máxima de 131.072 tokens.
- ~43.000 tokens de saída por tarefa em média — acima dos ~26.000 do GLM-5.1 — o que aumenta o tempo e o custo da inferência local.
- Licença MIT: gratuito para baixar, auto-hospedar e modificar, sem restrições regionais.
- A Z.ai já lançou duas sucessoras desde então: o GLM-5.3 (14 de agosto de 2026, mesmo modelo-base, pós-treinamento mais intenso, disponível por enquanto só via API/Coding Plan) e o GLM-5.3-Flash (26 de agosto de 2026, um modelo menor com licença MIT, 320B no total / ~18B ativos). Veja as seções abaixo para a comparação com o GLM-5.2.
Quão bom é o GLM-5.2? Os benchmarks independentes primeiro
O GLM-5.2 foi o modelo de pesos abertos com a maior pontuação no Artificial Analysis Intelligence Index no lançamento, em junho de 2026 (51 pontos, 4º no geral). Desde agosto de 2026, o Kimi K3 da Moonshot AI ocupa o 1º lugar em pesos abertos; o GLM-5.2 é agora o 2º (Artificial Analysis, julho–agosto de 2026).
Modelo | Index v4.1.1 | Categoria |
|---|---|---|
| Claude Fable 5 | ~62 | Fronteira fechada |
| Kimi K3 (Moonshot AI) | 57 | 1º em pesos abertos |
| GLM-5.2 | ~52,6 | 2º em pesos abertos (era o 1º no lançamento, em junho de 2026) |
| MiniMax-M3 | 44 | Pesos abertos |
| DeepSeek V4 Pro | 44 | Pesos abertos |
Resultados independentes de programação no lançamento (junho de 2026): Terminal-Bench 2.1 — o GLM-5.2 pontuou 81.0 contra 85.0 do Claude Opus 4.8. SWE-bench Pro — o GLM-5.2 com 62.1 (valor reportado pela Z.ai) ficou à frente dos 58.6 do GPT-5.5; a cobertura independente corroborou essa ordenação. Tanto o Claude Opus 4.8 quanto o GPT-5.5 foram substituídos desde então pelo Claude Opus 5 e pelo GPT-5.6 Sol, e o GLM-5.2 fica atrás desses dois modelos fechados mais novos com uma margem maior do que a que tinha frente aos antecessores. Separadamente, o Kimi K3 da Moonshot AI (2,8T de parâmetros totais, ~104B ativos, lançado em 27 de julho de 2026 sob a licença modificada baseada em MIT Kimi K3 License) agora supera o GLM-5.2 no Intelligence Index e em benchmarks de programação como o FrontierSWE (81.2) e o Terminal-Bench 2.0 (88.3). Veredito em agosto de 2026: o GLM-5.2 continua um modelo de programação de primeira linha entre os pesos abertos, mas não é mais a opção de pesos abertos mais forte disponível — esse lugar agora é do Kimi K3 — e a distância para a fronteira fechada aumentou desde o lançamento (Artificial Analysis; VentureBeat; TechTimes, julho–agosto de 2026).

Os próprios números da Z.ai vs os resultados independentes: leia com cuidado
Várias cifras de destaque vêm das próprias avaliações da Z.ai e devem ser lidas como reportadas pela empresa, não verificadas de forma independente.
- Cifras de programação reportadas pela empresa — por exemplo, MCP-Atlas 77.0 (reportado pela Z.ai), contra 75.3 do GPT-5.5 e 77.8 do Opus 4.8 — são executadas pela própria Z.ai e devem ser tratadas como alegações pendentes de replicação independente.
- O artigo da Artificial Analysis observa que as avaliações internas da Z.ai foram reportadas como mais fracas do que seus benchmarks publicados, e a reprodutibilidade é contestada.
- A reprodutibilidade é uma questão em aberto. Pelo menos um comentarista de destaque caracteriza o modelo como "bench-maxxed", e o GLM-5.1 teria pontuado 0% em pelo menos um benchmark no qual o GLM-5.2 agora vai bem. O Artificial Analysis Index independente — e não a própria suíte da Z.ai — é o que atualmente sustenta a classificação de nº 2 em pesos abertos.
- O GLM-5.3 (agosto de 2026) reporta grandes saltos apenas com pós-treinamento, sobre o mesmo modelo-base do GLM-5.2 — por exemplo, o Terminal-Bench 3.0 subiu de 4,6 para 28,3 — sem retreinamento. Trate esses ganhos com a mesma cautela reservada às cifras reportadas pela empresa, até que avaliações independentes os confirmem.
Dá para rodar o GLM-5.2 em casa? O teste de realidade dos ~744B
Não — não o modelo completo. "Pesos abertos" e "auto-hospedável" não significam "roda num PC doméstico comum".
- O GLM-5.2 completo precisa de infraestrutura robusta: servidores multi-GPU ou uma GPU em nuvem alugada.
- Em hardware de consumo, apenas builds GGUF fortemente quantizadas de 1 bit são viáveis, com perdas de qualidade e velocidade.
- A alta saída de ~43.000 tokens por tarefa eleva ainda mais o tempo e o custo local.
- O GLM-5.3-Flash, menor, da Z.ai (320B no total / ~18B ativos, licença MIT, lançado em 26 de agosto de 2026) é mais fácil de auto-hospedar do que o GLM-5.2 completo, embora ainda esteja bem longe de uma única GPU de consumo sem forte quantização.
- Para a realidade de hardware dos grandes modelos locais, veja Rodando modelos 70B em hardware de consumo, GPUs usadas para LLMs locais, o Guia de hardware para LLM local 2026 e Apple Silicon M5 para LLMs locais.

Pesos auto-hospedados vs a API da Z.ai: para onde vão seus dados
A licença e a API são duas histórias diferentes de governança de dados. Os pesos MIT auto-hospedados mantêm seus dados dentro do seu perímetro; a API própria da Z.ai não.
- Auto-hospedado (pesos MIT): os dados ficam locais e são seus — sem transmissão a terceiros.
- API própria da Z.ai: a cobertura independente sinaliza explicitamente considerações de residência de dados na China ("risco de dados na China") no caminho da API (TechTimes, 17 de junho de 2026).
- Enquadramento da decisão: se a sensibilidade dos dados importa, auto-hospede os pesos; se você usar a API hospedada, trate-a como qualquer endpoint de nuvem de terceiros sujeito à sua jurisdição.
Preços e custo do GLM-5.2
Via a API hospedada, o GLM-5.2 custa cerca de um sexto do preço dos modelos de fronteira fechada (VentureBeat, junho de 2026). O preço reportado é de aproximadamente $1.4 por 1M de tokens de entrada e $4.4 por 1M de tokens de saída (em junho de 2026). Considere a alta saída por tarefa (~43.000 tokens) ao estimar o custo real de uma carga de trabalho.
Você deveria usar o GLM-5.2?
Guia de decisão do GLM-5.2
Use um LLM local se:
- •Você quer um modelo de pesos abertos maduro e verificado de forma independente, na posição nº 2, com histórico comprovado
- •Você precisa de auto-hospedagem e controle de dados dentro do seu próprio perímetro
- •Você executa tarefas de programação de longo horizonte
- •Você quer qualidade próxima da fronteira por cerca de um sexto do custo
Use um modelo em nuvem se:
- •Você precisa da maior pontuação em confrontos diretos de programação ou raciocínio — confira modelos fechados atuais como o Claude Opus 5 ou o GPT-5.6 Sol
- •Você quer o modelo de pesos abertos absolutamente mais forte e está disposto a avaliar o Kimi K3 em vez disso
- •Você não consegue provisionar infraestrutura multi-GPU ou de GPU alugada
Decisão rápida:
- →Uma opção de pesos abertos sólida hoje, mas não mais a melhor — o Kimi K3 agora lidera os pesos abertos, e o próprio GLM-5.3 da Z.ai pode substituir o GLM-5.2 assim que seus pesos forem lançados. Verifique os benchmarks contestados nas suas próprias tarefas antes de se comprometer.
GLM-5.2: contexto regional
Brasil / LGPD: Auto-hospedar o GLM-5.2 sob a licença MIT mantém todos os dados de inferência dentro da sua própria infraestrutura, o que atende às expectativas de residência de dados sob a LGPD (Lei Geral de Proteção de Dados). Quando a inferência roda localmente, a diferença de conformidade entre modelos está na documentação do fornecedor, não no tratamento de dados. A ANPD (Autoridade Nacional de Proteção de Dados) é o órgão regulador a considerar ao documentar o tratamento de dados.
Japão (METI): Para implantações em produção, documente a versão do modelo (GLM-5.2), a licença (MIT) e se a inferência roda em pesos auto-hospedados ou na API da Z.ai, em linha com as diretrizes de governança de IA do METI.
China / caminho dos dados: O GLM-5.2 é desenvolvido por um laboratório chinês. A principal alavanca de conformidade é o caminho de implantação, não o modelo: os pesos MIT auto-hospedados mantêm os dados no seu perímetro, enquanto a API própria da Z.ai está sujeita à sua jurisdição de origem. Escolha o caminho que corresponde aos seus requisitos de residência de dados.
Erros comuns ao avaliar o GLM-5.2
- Supor que "pesos abertos" significa "roda em casa". O tamanho de ~744B exige infraestrutura multi-GPU ou alugada; apenas builds GGUF de 1 bit cabem em hardware de consumo.
- Tratar os benchmarks próprios da Z.ai como verificados. Priorize o Artificial Analysis Index independente; trate os números de programação executados pela empresa como alegações.
- Confundir os pesos MIT com a API hospedada na governança de dados. A auto-hospedagem mantém os dados locais; a API está sujeita à sua jurisdição de origem.
- Supor que o GLM-5.2 ainda é o 1º em pesos abertos. O Kimi K3, da Moonshot AI, assumiu esse lugar em julho de 2026; o GLM-5.2 agora é o 2º, e o próprio GLM-5.3 da Z.ai (agosto de 2026) já melhora alguns resultados de programação do GLM-5.2, embora seus pesos públicos ainda não tenham sido lançados.
- Ignorar a saída de ~43.000 tokens por tarefa ao orçar tempo e custo de inferência.
Perguntas frequentes
O GLM-5.2 ainda é o melhor modelo de pesos abertos no momento?
Não — em agosto de 2026, o Kimi K3 da Moonshot AI (lançado em 27 de julho de 2026) ocupa o 1º lugar no Artificial Analysis Intelligence Index com 57 pontos, à frente dos cerca de 52,6 do GLM-5.2. O GLM-5.2 era o 1º em pesos abertos no lançamento, em junho de 2026 (51 pontos), mas agora é o 2º, ainda à frente de MiniMax-M3 e DeepSeek V4 Pro (ambos com 44).
Dá para rodar o GLM-5.2 em um PC ou Mac comum?
Não o modelo completo. Com ~744B de parâmetros, ele precisa de servidores multi-GPU ou de uma GPU em nuvem alugada. Em hardware de consumo, você fica limitado a builds GGUF fortemente quantizadas de 1 bit, que comprometem qualidade e velocidade. O GLM-5.3-Flash, menor, da Z.ai (320B / ~18B ativos, MIT), é um pouco mais fácil de auto-hospedar, mas ainda não é coisa de notebook comum. Veja nossos guias de hardware para saber o que os grandes modelos locais realmente exigem.
O GLM-5.2 supera o GPT-5.5, o Claude Opus 4.8 e seus sucessores?
No lançamento, resultados independentes colocavam o GLM-5.2 à frente do GPT-5.5 em programação, enquanto ficava atrás do Claude Opus 4.8 na maioria dos confrontos diretos — por exemplo, no Terminal-Bench 2.1 (81.0 contra 85.0). Ambos foram substituídos desde então pelo GPT-5.6 Sol e pelo Claude Opus 5, e o GLM-5.2 fica atrás desses modelos fechados mais novos com uma margem maior do que a que tinha frente aos antecessores. O resumo correto em agosto de 2026 é "um sólido modelo de pesos abertos nº 2, mais distante da fronteira fechada do que estava no lançamento".
O GLM-5.2 foi substituído pelo GLM-5.3 ou pelo Kimi K3?
O GLM-5.2 não foi substituído, mas foi ultrapassado em duas frentes. A Z.ai lançou o GLM-5.3 em 14 de agosto de 2026 — o mesmo modelo-base com pós-treinamento mais intenso e resultados de programação bem melhores —, mas os pesos públicos ainda não haviam sido lançados até esta atualização; ele está disponível apenas via API e Coding Plan da Z.ai. Separadamente, o Kimi K3 da Moonshot AI (27 de julho de 2026) tomou do GLM-5.2 o lugar de melhor modelo de pesos abertos no geral. O GLM-5.2 continua sendo uma opção totalmente auto-hospedável e verificada de forma independente na posição nº 2 em pesos abertos.
O GLM-5.2 é realmente gratuito? Qual é a licença?
O GLM-5.2 é lançado sob a licença MIT, sem limites regionais de uso, então você pode baixar, auto-hospedar e modificá-lo gratuitamente. Rodar o modelo completo ainda custa infraestrutura real (multi-GPU ou GPU alugada), e a API hospedada da Z.ai é um serviço pago.
Meus dados estão seguros com o GLM-5.2?
Depende do caminho de implantação. Os pesos MIT auto-hospedados mantêm todos os dados dentro do seu próprio perímetro. A API própria da Z.ai envolve considerações de residência de dados na China sinalizadas pela cobertura independente, então trate-a como qualquer endpoint de nuvem de terceiros sujeito à sua jurisdição.
Os números de benchmark do GLM-5.2 são confiáveis?
O Artificial Analysis Index independente corrobora a classificação de nº 2 em pesos abertos do GLM-5.2 em agosto de 2026 (isso também se aplica aos ganhos reportados pelo GLM-5.3). Os próprios números de programação da Z.ai são reportados pela empresa, e a reprodutibilidade é contestada. Priorize os números independentes e trate as cifras próprias como alegações.
Quanto custa rodar o GLM-5.2 via API?
Cerca de um sexto do custo dos modelos de fronteira fechada. O preço reportado é de aproximadamente $1.4 por 1M de tokens de entrada e $4.4 por 1M de tokens de saída (junho de 2026, sem alterações até esta atualização). Como o GLM-5.2 gera em média ~43.000 tokens de saída por tarefa, estime o custo real na sua própria carga de trabalho, em vez de apenas nas taxas por token.
De que hardware preciso para auto-hospedar o GLM-5.2 corretamente?
Para o modelo completo, servidores multi-GPU ou uma GPU em nuvem alugada. O hardware de consumo só consegue rodar builds GGUF fortemente quantizadas de 1 bit. Veja o Guia de hardware para LLM local 2026, GPUs usadas para LLMs locais e Rodando modelos 70B em hardware de consumo para dimensionar sua configuração.
Fontes
- Artificial Analysis. (2026). "GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index." artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index — Classificação independente do Intelligence Index no lançamento (51, 1º aberto / 4º no geral, junho de 2026).
- TechTimes. (2026, 17 de junho). "GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk." www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm — Considerações de residência de dados no caminho da API da Z.ai.
- VentureBeat. (2026). "Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost." venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost — Comparação independente de programação e enquadramento de custo.
- LetsDataScience. (2026). "GLM-5.2 open weights beats GPT-5.5 coding." letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding — Cobertura independente dos resultados de programação.
- TechTimes. (2026, 24 de julho). "Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk." www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm — Lançamento do Kimi K3, que tomou do GLM-5.2 o 1º lugar em pesos abertos.
- VentureBeat. (2026, 14 de agosto). "GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor." venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor — Lançamento do GLM-5.3, mesmo modelo-base do GLM-5.2, só via API no lançamento.
- MarkTechPost. (2026, 26 de agosto). "Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context." www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ — Especificações do GLM-5.3-Flash e seu lançamento imediato sob licença MIT.