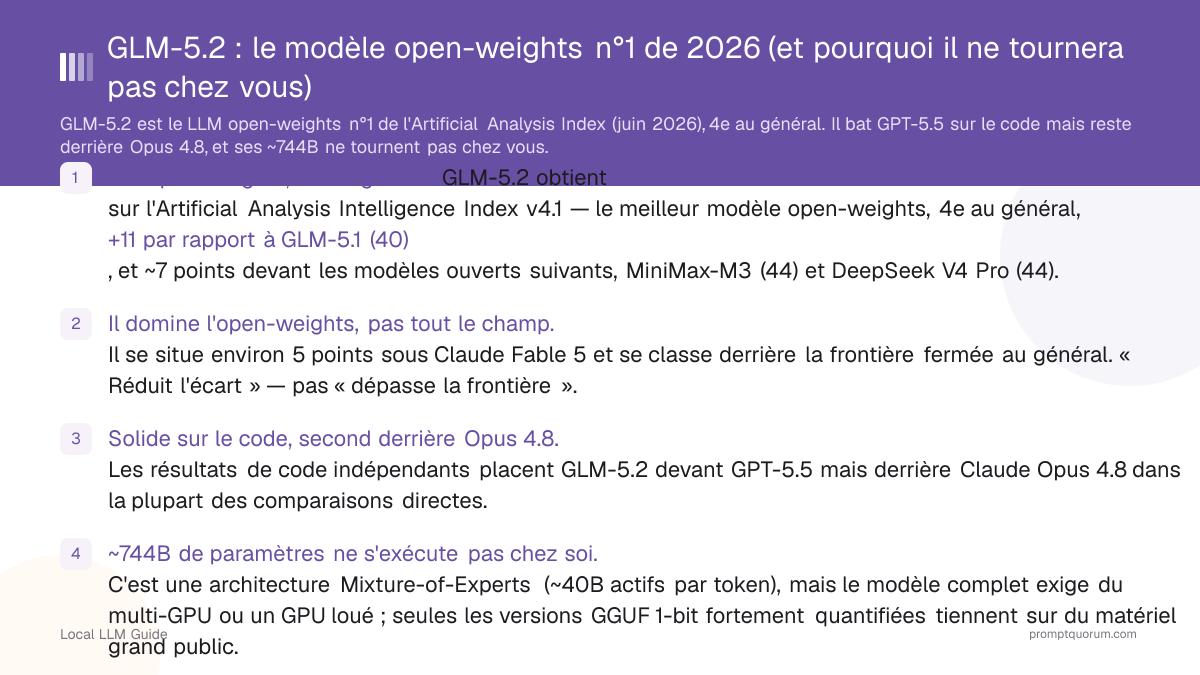
Points clés
- N°2 open-weights, était n°1 au lancement. GLM-5.2 a obtenu 51 sur l'Artificial Analysis Intelligence Index v4.1 à son lancement en juin 2026 — le meilleur modèle open-weights à l'époque. Depuis août 2026, Kimi K3 de Moonshot AI (57, publié le 27 juillet 2026) occupe la 1re place des poids ouverts ; GLM-5.2 (désormais ~52,6 sur l'index v4.1.1 mis à jour) se classe 2e, toujours devant MiniMax-M3 et DeepSeek V4 Pro (44 chacun).
- Z.ai a déjà publié une suite : GLM-5.3. Publié le 14 août 2026 sur le même modèle de base que GLM-5.2 avec un post-entraînement plus poussé, GLM-5.3 affiche des résultats de code nettement meilleurs (Terminal-Bench 3.0 est passé de 4,6 à 28,3). Il n'est pour l'instant disponible que via l'API et le Coding Plan de Z.ai ; les poids publics n'étaient pas encore sortis au moment de cette mise à jour.
- Solide sur le code, mais désormais plus loin de la frontière fermée. GLM-5.2 reste devant GPT-5.5 sur les benchmarks de code indépendants, mais Anthropic et OpenAI ont depuis publié des modèles fermés plus récents — Claude Opus 5 et GPT-5.6 Sol — qui devancent GLM-5.2 dans les comparaisons directes de code avec un écart plus large que leurs prédécesseurs de juin 2026.
- ~744B de paramètres ne s'exécute toujours pas chez soi. C'est une architecture Mixture-of-Experts (~40B actifs par token) ; le modèle complet exige du multi-GPU ou un GPU loué. Le GLM-5.3-Flash, plus petit, de Z.ai (320B au total / 18B actifs, publié le 26 août 2026, licence MIT) est plus facilement auto-hébergeable, mais reste loin d'un seul GPU grand public sans forte quantification.
- Les poids auto-hébergés gardent vos données ; pas nécessairement l'API Z.ai. Les poids sous licence MIT s'exécutent dans votre périmètre ; l'API Z.ai officielle soulève des considérations de résidence des données en Chine.
- Traitez les propres benchmarks de Z.ai comme déclarés par l'éditeur. La reproductibilité est contestée — privilégiez les chiffres indépendants d'Artificial Analysis.
Qu'est-ce que GLM-5.2 ?
GLM-5.2 est un grand modèle de langage open-weights publié le 13 juin 2026 par Z.ai (anciennement Zhipu AI), sous licence MIT sans limite d'usage régionale. Il est benchmarké publiquement depuis le 16 juin 2026.
- ~744B de paramètres au total (les sources citent 743B–753B), avec une architecture Mixture-of-Experts comptant ~40B de paramètres actifs par token.
- Fenêtre de contexte de 1M de tokens avec une sortie maximale de 131 072 tokens.
- ~43 000 tokens de sortie par tâche en moyenne — contre ~26 000 pour GLM-5.1 — ce qui augmente le temps et le coût d'inférence locale.
- Licence MIT : téléchargement, auto-hébergement et modification gratuits, sans restriction régionale.
- Z.ai a depuis publié deux suites : GLM-5.3 (14 août 2026, même modèle de base, post-entraînement plus poussé, disponible pour l'instant uniquement via API/Coding Plan) et GLM-5.3-Flash (26 août 2026, un modèle plus petit sous licence MIT de 320B au total / ~18B actifs). Voir les sections ci-dessous pour la comparaison avec GLM-5.2.
GLM-5.2 est-il bon ? D'abord les benchmarks indépendants
GLM-5.2 était le modèle open-weights le mieux classé sur l'Artificial Analysis Intelligence Index à son lancement en juin 2026 (51 points, 4e au général). Depuis août 2026, Kimi K3 de Moonshot AI occupe la 1re place des poids ouverts ; GLM-5.2 se classe désormais 2e (Artificial Analysis, juillet–août 2026).
Modèle | Index v4.1.1 | Niveau |
|---|---|---|
| Claude Fable 5 | ~62 | Frontière fermée |
| Kimi K3 (Moonshot AI) | 57 | N°1 open-weights |
| GLM-5.2 | ~52,6 | N°2 open-weights (n°1 au lancement en juin 2026) |
| MiniMax-M3 | 44 | Open-weights |
| DeepSeek V4 Pro | 44 | Open-weights |
Résultats de code indépendants au lancement (juin 2026) : Terminal-Bench 2.1 — GLM-5.2 obtenait 81.0 contre 85.0 pour Claude Opus 4.8. SWE-bench Pro — GLM-5.2 à 62.1 (valeur déclarée par Z.ai) devançait GPT-5.5 à 58.6 ; la couverture indépendante confirmait cet ordre. Claude Opus 4.8 et GPT-5.5 ont depuis été remplacés par Claude Opus 5 et GPT-5.6 Sol, et GLM-5.2 accuse un retard plus large sur ces deux modèles fermés récents que sur leurs prédécesseurs. Par ailleurs, Kimi K3 de Moonshot AI (2,8T de paramètres au total, ~104B actifs, publié le 27 juillet 2026 sous la licence modifiée de type MIT Kimi K3 License) devance désormais GLM-5.2 sur l'Intelligence Index et sur des benchmarks de code comme FrontierSWE (81.2) et Terminal-Bench 2.0 (88.3). Verdict à août 2026 : GLM-5.2 reste un modèle de code de premier plan parmi les poids ouverts, mais ce n'est plus l'option open-weights la plus solide disponible — c'est désormais Kimi K3 — et l'écart avec la frontière fermée s'est creusé depuis son lancement (Artificial Analysis ; VentureBeat ; TechTimes, juillet–août 2026).

Les chiffres de Z.ai vs les résultats indépendants : à lire avec prudence
Plusieurs chiffres phares proviennent des propres évaluations de Z.ai et doivent être lus comme déclarés par l'éditeur, non vérifiés de manière indépendante.
- Les chiffres de code déclarés par l'éditeur — par exemple MCP-Atlas 77.0 (déclaré par Z.ai), contre 75.3 pour GPT-5.5 et 77.8 pour Opus 4.8 — sont mesurés par Z.ai elle-même et doivent être traités comme des affirmations en attente de réplication indépendante.
- Le compte-rendu d'Artificial Analysis note que les évaluations internes de Z.ai étaient rapportées plus faibles que ses benchmarks publiés, et la reproductibilité est contestée.
- La reproductibilité reste une question ouverte. Au moins un commentateur reconnu qualifie le modèle de « bench-maxxed », et GLM-5.1 aurait obtenu 0 % sur au moins un benchmark où GLM-5.2 réussit désormais bien. C'est l'Artificial Analysis Index indépendant — pas la suite de Z.ai — qui soutient actuellement le classement n°2 open-weights.
- GLM-5.3 (août 2026) revendique de grands progrès uniquement grâce au post-entraînement sur le même modèle de base que GLM-5.2 — par exemple Terminal-Bench 3.0 est passé de 4,6 à 28,3 — sans réentraînement. Traitez ces progrès avec la même prudence, en tant que chiffres déclarés par l'éditeur, tant que des évaluations indépendantes ne les confirment pas.
Pouvez-vous exécuter GLM-5.2 chez vous ? La réalité des ~744B
Non — pas le modèle complet. « Open-weights » et « auto-hébergeable » ne veulent pas dire « tourne sur un PC domestique classique ».
- GLM-5.2 complet exige une infrastructure sérieuse : serveurs multi-GPU ou GPU cloud loué.
- Sur du matériel grand public, seules les versions GGUF 1-bit fortement quantifiées sont envisageables, avec des compromis de qualité et de vitesse.
- La sortie élevée de ~43 000 tokens par tâche augmente encore le temps et le coût en local.
- Le GLM-5.3-Flash, plus petit, de Z.ai (320B au total / ~18B actifs, licence MIT, publié le 26 août 2026) est plus facilement auto-hébergeable que GLM-5.2 complet, mais reste bien au-delà d'un seul GPU grand public sans forte quantification.
- Pour la réalité matérielle des grands modèles locaux, voir Exécuter des modèles 70B sur du matériel grand public, GPU d'occasion pour LLM locaux, le Guide du matériel pour LLM locaux 2026 et Apple Silicon M5 pour LLM locaux.

Poids auto-hébergés vs API Z.ai : où vont vos données
La licence et l'API racontent deux histoires de gouvernance des données différentes. Les poids MIT auto-hébergés gardent vos données dans votre périmètre ; l'API Z.ai officielle, non.
- Auto-hébergé (poids MIT) : les données restent locales et vous appartiennent — aucune transmission à des tiers.
- API Z.ai officielle : la couverture indépendante signale explicitement des considérations de résidence des données en Chine (« risque de données en Chine ») sur le chemin de l'API (TechTimes, 17 juin 2026).
- Cadre de décision : si la sensibilité des données compte, auto-hébergez les poids ; si vous utilisez l'API hébergée, traitez-la comme tout point de terminaison cloud tiers soumis à sa juridiction.
Tarification et coût de GLM-5.2
Via l'API hébergée, GLM-5.2 revient à environ un sixième du coût des modèles de frontière fermée (VentureBeat, juin 2026). Le tarif annoncé est d'environ $1.4 par 1M de tokens d'entrée et $4.4 par 1M de tokens de sortie (en juin 2026). Tenez compte de la sortie élevée par tâche (~43 000 tokens) pour estimer le coût réel de votre charge de travail.
Faut-il utiliser GLM-5.2 ?
Guide de décision GLM-5.2
Utilisez un LLM local si :
- •Vous voulez un modèle open-weights mature, vérifié de façon indépendante, classé n°2, avec un historique éprouvé
- •Vous avez besoin d'auto-hébergement et de contrôle des données dans votre propre périmètre
- •Vous exécutez des tâches de code à horizon long
- •Vous voulez une qualité proche de la frontière pour environ un sixième du coût
Utilisez un modèle cloud si :
- •Vous avez besoin du meilleur score en code ou en raisonnement en comparaison directe — examinez des modèles fermés actuels comme Claude Opus 5 ou GPT-5.6 Sol
- •Vous voulez le modèle open-weights absolument le plus solide et envisagez plutôt d'évaluer Kimi K3
- •Vous ne pouvez pas provisionner d'infrastructure multi-GPU ou GPU loué
Décision rapide :
- →Une option open-weights solide aujourd'hui, mais plus la meilleure — Kimi K3 domine désormais l'open-weights, et le propre GLM-5.3 de Z.ai pourrait supplanter GLM-5.2 dès la sortie de ses poids. Vérifiez les benchmarks contestés sur vos propres tâches avant de vous engager.
GLM-5.2 : contexte régional
UE / RGPD : Auto-héberger GLM-5.2 sous licence MIT maintient toutes les données d'inférence dans votre propre infrastructure, ce qui satisfait les attentes de résidence des données au titre du RGPD. La CNIL recommande l'inférence locale pour le traitement des données professionnelles sensibles (financières, médicales, juridiques). La différence de conformité entre modèles tient à la documentation fournisseur, pas au traitement des données, lorsque l'inférence s'exécute localement.
Japon (METI) : Pour les déploiements en production, documentez la version du modèle (GLM-5.2), la licence (MIT) et si l'inférence s'exécute sur des poids auto-hébergés ou via l'API Z.ai, conformément aux orientations de gouvernance de l'IA du METI.
Chine / chemin des données : GLM-5.2 est conçu par un laboratoire chinois. Le levier de conformité clé est le chemin de déploiement, pas le modèle : les poids MIT auto-hébergés gardent les données dans votre périmètre, tandis que l'API Z.ai officielle relève de sa juridiction d'origine. Choisissez le chemin qui correspond à vos exigences de résidence des données.
Erreurs courantes lors de l'évaluation de GLM-5.2
- Croire qu'« open-weights » signifie « tourne chez soi ». La taille de ~744B exige du multi-GPU ou une infrastructure louée ; seules les versions GGUF 1-bit tiennent sur du matériel grand public.
- Considérer les benchmarks officiels de Z.ai comme vérifiés. Privilégiez l'Artificial Analysis Index indépendant ; traitez les chiffres de code mesurés par l'éditeur comme des affirmations.
- Confondre les poids MIT et l'API hébergée pour la gouvernance des données. L'auto-hébergement garde les données en local ; l'API relève de sa juridiction d'origine.
- Croire que GLM-5.2 est toujours n°1 open-weights. Kimi K3 de Moonshot AI a pris cette place en juillet 2026 ; GLM-5.2 est désormais n°2, et le propre GLM-5.3 de Z.ai (août 2026) améliore déjà certains résultats de code de GLM-5.2, même si ses poids publics ne sont pas encore sortis.
- Ignorer la sortie de ~43 000 tokens par tâche lors de l'estimation du temps et du coût d'inférence.
Questions fréquemment posées
GLM-5.2 est-il toujours le meilleur modèle open-weights actuel ?
Non — en août 2026, Kimi K3 de Moonshot AI (publié le 27 juillet 2026) occupe la première place sur l'Artificial Analysis Intelligence Index avec 57 points, devant les ~52,6 de GLM-5.2. GLM-5.2 était n°1 open-weights à son lancement en juin 2026 (51 points), mais se classe désormais 2e, toujours devant MiniMax-M3 et DeepSeek V4 Pro (44 chacun).
Puis-je exécuter GLM-5.2 sur un PC ou un Mac classique ?
Pas le modèle complet. À ~744B de paramètres, il exige des serveurs multi-GPU ou un GPU cloud loué. Sur du matériel grand public, vous êtes limité aux versions GGUF 1-bit fortement quantifiées, au détriment de la qualité et de la vitesse. Le GLM-5.3-Flash, plus petit, de Z.ai (320B / ~18B actifs, MIT) est un peu plus facilement auto-hébergeable, mais reste hors de portée d'un ordinateur portable grand public. Consultez nos guides matériels pour ce que les grands modèles locaux exigent réellement.
GLM-5.2 dépasse-t-il GPT-5.5, Claude Opus 4.8 et leurs successeurs ?
À son lancement, les résultats indépendants plaçaient GLM-5.2 devant GPT-5.5 sur le code tout en le classant derrière Claude Opus 4.8 dans la plupart des comparaisons directes — par exemple Terminal-Bench 2.1 (81.0 contre 85.0). Ces deux modèles ont depuis été remplacés par GPT-5.6 Sol et Claude Opus 5, et GLM-5.2 accuse un retard plus large sur ces modèles fermés récents que sur leurs prédécesseurs. Le résumé exact à août 2026 est « un solide modèle open-weights n°2, plus éloigné de la frontière fermée qu'à son lancement ».
GLM-5.2 a-t-il été remplacé par GLM-5.3 ou Kimi K3 ?
GLM-5.2 n'a pas été remplacé, mais il a été dépassé sur deux fronts. Z.ai a publié GLM-5.3 le 14 août 2026 — même modèle de base avec un post-entraînement plus poussé et des résultats de code nettement meilleurs —, mais ses poids publics n'étaient pas encore sortis au moment de cette mise à jour ; il n'est disponible que via l'API et le Coding Plan de Z.ai. Par ailleurs, Kimi K3 de Moonshot AI (27 juillet 2026) a pris à GLM-5.2 la place de meilleur modèle open-weights au général. GLM-5.2 reste une option entièrement auto-hébergeable, vérifiée de manière indépendante, classée n°2 open-weights.
GLM-5.2 est-il vraiment gratuit ? Quelle est la licence ?
GLM-5.2 est publié sous licence MIT sans limite d'usage régionale : vous pouvez le télécharger, l'auto-héberger et le modifier gratuitement. Exécuter le modèle complet coûte tout de même une vraie infrastructure (multi-GPU ou GPU loué), et l'API Z.ai hébergée est un service payant.
Mes données sont-elles en sécurité avec GLM-5.2 ?
Cela dépend du chemin de déploiement. Les poids MIT auto-hébergés gardent toutes les données dans votre propre périmètre. L'API Z.ai officielle soulève des considérations de résidence des données en Chine, signalées par la couverture indépendante ; traitez-la donc comme tout point de terminaison cloud tiers soumis à sa juridiction.
Les chiffres de benchmark de GLM-5.2 sont-ils fiables ?
L'Artificial Analysis Index indépendant confirme le classement n°2 open-weights de GLM-5.2 à août 2026 (cela s'applique aussi aux progrès déclarés de GLM-5.3). Les chiffres de code de Z.ai sont déclarés par l'éditeur et la reproductibilité est contestée. Privilégiez les chiffres indépendants et traitez les chiffres officiels comme des affirmations.
Combien coûte l'exécution de GLM-5.2 via l'API ?
Environ un sixième du coût des modèles de frontière fermée. Le tarif annoncé est d'environ $1.4 par 1M de tokens d'entrée et $4.4 par 1M de tokens de sortie (juin 2026, inchangé à la date de cette mise à jour). Comme GLM-5.2 produit en moyenne ~43 000 tokens de sortie par tâche, estimez le coût réel sur votre propre charge de travail plutôt que sur les seuls tarifs au token.
Quel matériel faut-il pour auto-héberger correctement GLM-5.2 ?
Pour le modèle complet, des serveurs multi-GPU ou un GPU cloud loué. Le matériel grand public ne peut exécuter que des versions GGUF 1-bit fortement quantifiées. Consultez le Guide du matériel pour LLM locaux 2026, GPU d'occasion pour LLM locaux et Exécuter des modèles 70B sur du matériel grand public pour dimensionner votre configuration.
Sources
- Artificial Analysis. (2026). « GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index. » artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index — Classement indépendant Intelligence Index au lancement (51, n°1 ouvert / 4e au général, juin 2026).
- TechTimes. (2026, 17 juin). « GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk. » www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm — Considérations de résidence des données sur le chemin de l'API Z.ai.
- VentureBeat. (2026). « Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost. » venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost — Comparaison de code indépendante et cadrage des coûts.
- LetsDataScience. (2026). « GLM-5.2 open weights beats GPT-5.5 coding. » letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding — Couverture indépendante des résultats de code.
- TechTimes. (2026, 24 juillet). « Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk. » www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm — Publication de Kimi K3, qui a pris à GLM-5.2 la 1re place open-weights.
- VentureBeat. (2026, 14 août). « GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor. » venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor — Publication de GLM-5.3, même modèle de base que GLM-5.2, disponible uniquement via API au lancement.
- MarkTechPost. (2026, 26 août). « Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context. » www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ — Spécifications de GLM-5.3-Flash et sa publication immédiate sous licence MIT.