关键要点
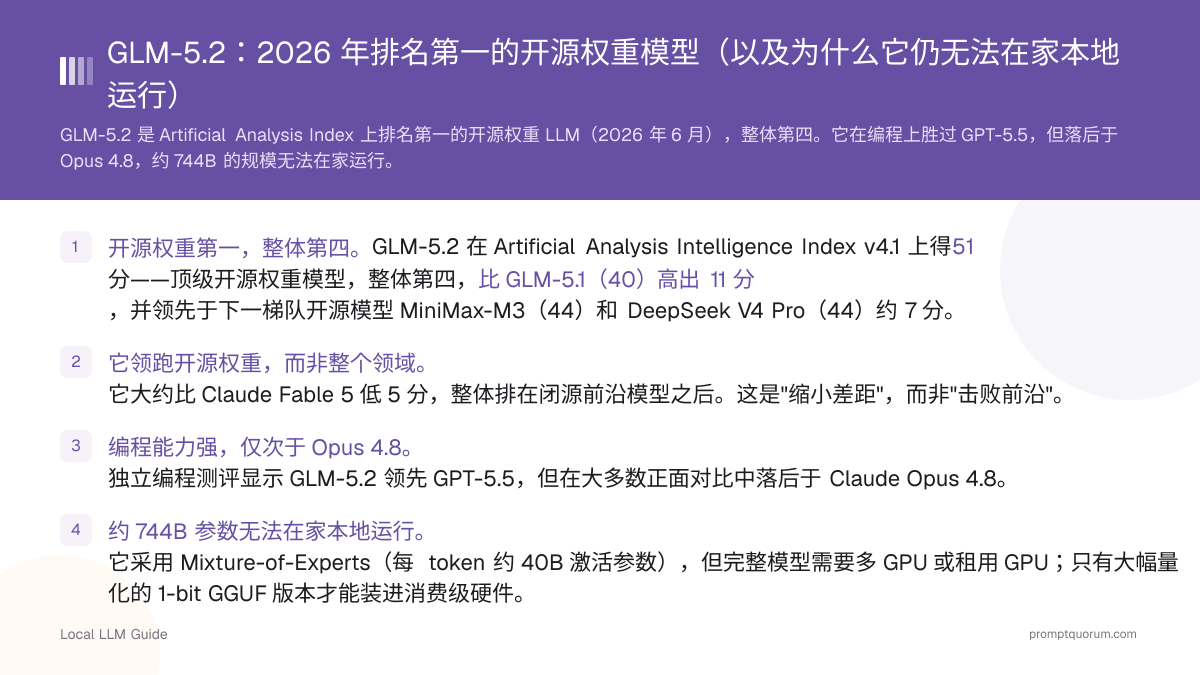
- 开源权重第二,发布时曾是第一。 GLM-5.2 在 2026 年 6 月发布时于 Artificial Analysis Intelligence Index v4.1 上得 51 分——当时的顶级开源权重模型。截至 2026 年 8 月,Moonshot AI 的 Kimi K3(57 分,2026 年 7 月 27 日发布)已占据开源权重第一的位置;GLM-5.2(在更新后的 v4.1.1 指数上现为约 52.6 分)排名第二,仍领先于 MiniMax-M3 和 DeepSeek V4 Pro(各 44 分)。
- Z.ai 已推出后续模型 GLM-5.3。 该模型于 2026 年 8 月 14 日发布,基于与 GLM-5.2 相同的基础模型,经过更强的后训练,编程分数大幅提升(Terminal-Bench 3.0 从 4.6 升至 28.3)。目前仅通过 Z.ai API 和 Coding Plan 提供;截至本次更新,公开权重尚未发布。
- 编程能力仍强,但与闭源前沿的差距进一步拉大。 GLM-5.2 在独立编程基准测试中仍领先 GPT-5.5,但 Anthropic 和 OpenAI 此后均发布了更新的闭源模型——Claude Opus 5 和 GPT-5.6 Sol——它们在正面编程对比中领先 GLM-5.2 的幅度超过其 2026 年 6 月时的前代模型。
- 约 744B 参数仍无法在家本地运行。 它采用 Mixture-of-Experts(每 token 约 40B 激活参数);完整模型需要多 GPU 或租用 GPU。Z.ai 更小的 GLM-5.3-Flash(总参数 320B / 激活参数 18B,2026 年 8 月 26 日发布,MIT 许可证)更易自托管,但若不经过大幅量化,仍远超单张消费级 GPU 的能力范围。
- 自托管权重让数据留在本地;Z.ai API 则不一定。 MIT 许可的权重在你的边界内运行;而第一方 Z.ai API 涉及中国数据驻留方面的考量。
- 应将 Z.ai 自报基准视为公司自测数据。 可复现性存在争议——应以独立的 Artificial Analysis 数据为准。
GLM-5.2 是什么?
GLM-5.2 是一款开源权重大语言模型,由 Z.ai(前身为 Zhipu AI)于 2026 年 6 月 13 日以 MIT 许可证发布,无地区使用限制。 它自 2026 年 6 月 16 日起被公开测评。
- 约 744B 总参数(各方来源引用 743B–753B),采用 Mixture-of-Experts 架构,每 token 约 40B 激活参数。
- 1M token 上下文窗口,最大输出 131,072 token。
- 平均每项任务约 43,000 输出 token——高于 GLM-5.1 的约 26,000——这会增加本地推理的时间与成本。
- MIT 许可证: 可免费下载、自托管和修改,无地区限制。
- Z.ai 此后推出了两款后续模型: GLM-5.3(2026 年 8 月 14 日,相同的基础模型,更强的后训练,目前仅限 API/Coding Plan)和 GLM-5.3-Flash(2026 年 8 月 26 日,一款更小的 MIT 许可模型,总参数 320B / 激活参数约 18B)。它们与 GLM-5.2 的对比见下文各节。
GLM-5.2 有多强?先看独立基准测试
GLM-5.2 在 2026 年 6 月发布时是 Artificial Analysis Intelligence Index 上得分最高的开源权重模型(51 分,整体第四)。截至 2026 年 8 月,Moonshot AI 的 Kimi K3 已占据开源权重第一的位置;GLM-5.2 现排名第二(Artificial Analysis,2026 年 7~8 月)。
模型 | Index v4.1.1 | 梯队 |
|---|---|---|
| Claude Fable 5 | ~62 | 闭源前沿 |
| Kimi K3(Moonshot AI) | 57 | 开源权重第一 |
| GLM-5.2 | ~52.6 | 开源权重第二(2026年6月发布时曾为第一) |
| MiniMax-M3 | 44 | 开源权重 |
| DeepSeek V4 Pro | 44 | 开源权重 |
发布时(2026 年 6 月)的独立编程测评结果:Terminal-Bench 2.1——GLM-5.2 得 81.0,Claude Opus 4.8 为 85.0。SWE-bench Pro——GLM-5.2 为 62.1(Z.ai 自报分值)领先于 GPT-5.5 的 58.6;独立报道印证了这一排序。Claude Opus 4.8 和 GPT-5.5 此后分别被 Claude Opus 5 和 GPT-5.6 Sol 取代,GLM-5.2 落后于这两款更新的闭源模型的幅度,超过其落后于前代模型的幅度。另一方面,Moonshot AI 的 Kimi K3(总参数 2.8T,激活参数约 104B,2026 年 7 月 27 日发布,采用基于 MIT 修改的 Kimi K3 License)目前在 Intelligence Index 及 FrontierSWE(81.2)、Terminal-Bench 2.0(88.3)等编程基准测试上均领先于 GLM-5.2。截至 2026 年 8 月的综合结论:GLM-5.2 在开源权重模型中仍属一流编程模型,但已不再是可获得的最强开源权重选项——该位置现属于 Kimi K3——且其与闭源前沿的差距自发布以来已进一步拉大(Artificial Analysis;VentureBeat;TechTimes,2026 年 7~8 月)。

Z.ai 自报数据 vs 独立结果:请谨慎解读
若干头条数字来自 Z.ai 自己的评测,应被视为公司自报、而非经过独立验证。
- 公司自报的编程数字——例如 MCP-Atlas 77.0(Z.ai 自报),对比 GPT-5.5 的 75.3 和 Opus 4.8 的 77.8——由 Z.ai 自行运行,应在独立复现之前作为厂商声明对待。
- Artificial Analysis 的评述指出,Z.ai 的内部评测所报告的结果弱于其公布的基准成绩,且可复现性存在争议。
- 可复现性仍是一个悬而未决的问题。 至少有一位知名评论者将该模型形容为"刷榜(bench-maxxed)",据称 GLM-5.1 在至少一项 GLM-5.2 如今表现良好的基准上曾得 0%。当前支撑"开源权重第二"这一排名的,是独立的 Artificial Analysis Index,而非 Z.ai 自家的测评套件。
- GLM-5.3(2026 年 8 月)报告称仅靠后训练便实现了大幅提升。 该模型基于与 GLM-5.2 相同的基础模型、未经重新训练——例如 Terminal-Bench 3.0 从 4.6 升至 28.3。在独立评测证实之前,应对这些提升保持与公司自报数据同等的谨慎态度。
你能在家本地运行 GLM-5.2 吗?约 744B 的现实考量
不能——至少完整模型不行。"开源权重"和"可自托管"并不意味着"能在普通家用 PC 上运行"。
- 完整的 GLM-5.2 需要强大的基础设施: 多 GPU 服务器或租用的云 GPU。
- 在消费级硬件上,只有大幅量化的 1-bit GGUF 版本可行,并伴随质量和速度上的取舍。
- 每项任务约 43,000 token 的高输出量进一步推高了本地的时间与成本。
- Z.ai 更小的 GLM-5.3-Flash(总参数 320B / 激活参数约 18B,MIT 许可证,2026 年 8 月 26 日发布) 比完整版 GLM-5.2 更易自托管,但若不经过大幅量化,仍远超单张消费级 GPU 的能力范围。
- 关于大型本地模型的硬件现实,参见 在消费级硬件上运行 70B 模型、本地 LLM 二手 GPU、本地 LLM 硬件指南 2026,以及 Apple Silicon M5 本地 LLM。

自托管权重 vs Z.ai API:你的数据去了哪里
许可证与 API 是两种不同的数据治理路径。自托管的 MIT 权重让数据留在你的边界之内;第一方 Z.ai API 则不然。
- 自托管(MIT 权重): 数据保留在本地、归你所有——不向第三方传输。
- Z.ai 第一方 API: 独立报道明确指出该 API 路径存在中国数据驻留方面的考量("中国数据风险")(TechTimes,2026 年 6 月 17 日)。
- 决策框架: 若数据敏感性重要,请自托管权重;若使用托管 API,则应将其视为受其管辖法域约束的任何第三方云端点来对待。
GLM-5.2 定价与成本
通过托管 API,GLM-5.2 的成本约为闭源前沿模型的六分之一(VentureBeat,2026 年 6 月)。 据报道,定价约为每 1M 输入 token $1.4、每 1M 输出 token $4.4(截至 2026 年 6 月)。在估算真实工作负载成本时,请将每项任务的高输出量(约 43,000 token)纳入考量。
你应该用 GLM-5.2 吗?
GLM-5.2 决策指南
以下情况使用本地LLM:
- •你想要一款成熟、经独立验证的开源权重第二名模型,具有可靠的往绩
- •你需要在自己的边界内自托管并掌控数据
- •你运行长时程的编程任务
- •你想以约六分之一的成本获得接近前沿的质量
以下情况使用云端模型:
- •你在正面编程或推理对比中需要最高分——可考虑 Claude Opus 5 或 GPT-5.6 Sol 等当前闭源模型
- •你想要绝对最强的开源权重模型,并愿意转而评估 Kimi K3
- •你无法配置多 GPU 或租用 GPU 基础设施
快速决策:
- →当下仍是一个强力的开源权重选项,但已不再是最佳选择——Kimi K3 目前领跑开源权重,而 Z.ai 自家的 GLM-5.3 一旦发布权重,也可能取代 GLM-5.2。在投入之前,请用你自己的任务验证那些存在争议的基准结果。
GLM-5.2:区域合规背景
中国(《数据安全法》): GLM-5.2 由中国实验室构建,核心合规杠杆在于部署路径、而非模型本身。在 MIT 许可下自托管 GLM-5.2,可使全部推理数据保留在你自有的基础设施之内,从而将数据保持在你的边界以内,契合《数据安全法》(2021)下的数据驻留要求;而第一方 Z.ai API 则受其所在法域管辖。请根据你的数据驻留要求选择相应路径。
亚太地区(数据跨境): 对于跨境数据流动,关键在于明确推理在何处运行。自托管权重让数据留在你选定的司法辖区内,便于符合各地的数据驻留与跨境传输框架;而托管 API 则会将数据带入供应商的本国法域。在多辖区部署时,应将部署路径与各市场的合规要求逐一对应。
企业部署: 对于金融、医疗、法律等受监管行业的大型企业(银行、医院、律师事务所),应记录模型版本(GLM-5.2)、许可证(MIT),以及推理是运行在自托管权重还是 Z.ai API 上。自托管的 MIT 权重将敏感数据保留在企业内部,是满足行业监管与审计要求最直接的路径。
评估 GLM-5.2 时的常见错误
- 误以为"开源权重"就意味着"能在家运行"。 约 744B 的规模需要多 GPU 或租用基础设施;只有 1-bit GGUF 版本才能装进消费级硬件。
- 把 Z.ai 第一方基准当作已验证数据。 应以独立的 Artificial Analysis Index 为准;将公司自行运行的编程数字视为厂商声明。
- 在数据治理上将 MIT 权重与托管 API 混为一谈。 自托管让数据保留在本地;API 则受其本国法域约束。
- 误以为 GLM-5.2 仍是"开源权重第一"。 Moonshot AI 的 Kimi K3 已于 2026 年 7 月夺得该位置;GLM-5.2 现排名第二,且 Z.ai 自家的 GLM-5.3(2026 年 8 月)已在部分编程分数上超越 GLM-5.2,尽管其公开权重尚未发布。
- 在估算推理时间与成本时忽视每项任务约 43,000 token 的输出量。
常见问题
GLM-5.2 仍是目前最好的开源权重模型吗?
不是——截至 2026 年 8 月,Moonshot AI 的 Kimi K3(2026 年 7 月 27 日发布)以 57 分在 Artificial Analysis Intelligence Index 上位居第一,领先于 GLM-5.2 的约 52.6 分。GLM-5.2 在 2026 年 6 月发布时曾是开源权重第一(51 分),但现在排名第二,仍领先于 MiniMax-M3 和 DeepSeek V4 Pro(均为 44 分)。
我能在普通 PC 或 Mac 上运行 GLM-5.2 吗?
完整模型不行。约 744B 参数需要多 GPU 服务器或租用的云 GPU。在消费级硬件上,你只能使用大幅量化的 1-bit GGUF 版本,并以质量和速度为代价。Z.ai 更小的 GLM-5.3-Flash(320B / 激活参数约 18B,MIT)稍微更易自托管,但仍非消费级笔记本能承受。关于大型本地模型的真实需求,请参阅我们的硬件指南。
GLM-5.2 击败了 GPT-5.5、Claude Opus 4.8 及其后续模型吗?
在发布时,独立结果显示 GLM-5.2 在编程上领先 GPT-5.5,但在大多数正面对比中落后于 Claude Opus 4.8——例如 Terminal-Bench 2.1(81.0 对 85.0)。此后二者均已被 GPT-5.6 Sol 和 Claude Opus 5 取代,GLM-5.2 落后于这两款更新闭源模型的幅度,超过了其落后于前代模型的幅度。截至 2026 年 8 月的准确概括是"一款出色的开源权重第二名模型,与闭源前沿的差距较发布时更远"。
GLM-5.2 是否已被 GLM-5.3 或 Kimi K3 取代?
GLM-5.2 尚未被取代,但已在两方面被超越。Z.ai 于 2026 年 8 月 14 日发布了 GLM-5.3——相同的基础模型、更强的后训练、显著更好的编程结果——但截至本次更新,其公开权重尚未发布,仅可通过 Z.ai API 和 Coding Plan 使用。另一方面,Moonshot AI 的 Kimi K3(2026 年 7 月 27 日)从 GLM-5.2 手中夺得了整体最强开源权重模型的位置。GLM-5.2 仍是一款完全可自托管、经独立验证的开源权重第二名选项。
GLM-5.2 真的免费吗?它的许可证是什么?
GLM-5.2 以 MIT 许可证发布,无地区使用限制,因此你可以免费下载、自托管和修改它。运行完整模型仍需真实的基础设施成本(多 GPU 或租用 GPU),而托管的 Z.ai API 是付费服务。
使用 GLM-5.2 我的数据安全吗?
这取决于部署路径。自托管的 MIT 权重将所有数据保留在你自有的边界之内。第一方 Z.ai API 涉及独立报道所指出的中国数据驻留考量,因此应将其视为受其管辖法域约束的任何第三方云端点来对待。
GLM-5.2 的基准测试数字可信吗?
独立的 Artificial Analysis Index 印证了 GLM-5.2 截至 2026 年 8 月的"开源权重第二"排名(GLM-5.3 所报告的提升也适用同样的谨慎态度)。Z.ai 自家的编程数字属于公司自报,且可复现性存在争议。应以独立数字为准,并将第一方数据视为厂商声明。
通过 API 运行 GLM-5.2 的成本是多少?
约为闭源前沿模型成本的六分之一。据报道,定价约为每 1M 输入 token $1.4、每 1M 输出 token $4.4(2026 年 6 月,截至本次更新未变)。由于 GLM-5.2 平均每项任务约 43,000 输出 token,请基于你自己的工作负载估算真实成本,而不要仅看每 token 单价。
正确自托管 GLM-5.2 需要什么硬件?
运行完整模型需要多 GPU 服务器或租用的云 GPU。消费级硬件只能运行大幅量化的 1-bit GGUF 版本。请参阅《本地 LLM 硬件指南 2026》《本地 LLM 二手 GPU》以及《在消费级硬件上运行 70B 模型》来确定你的配置规格。
来源
- Artificial Analysis. (2026). "GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index." artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index —— 发布时的独立 Intelligence Index 排名(51,开源第一 / 整体第四,2026 年 6 月)。
- TechTimes. (2026, June 17). "GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk." www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm —— Z.ai API 路径上的数据驻留考量。
- VentureBeat. (2026). "Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost." venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost —— 独立编程对比与成本测算。
- LetsDataScience. (2026). "GLM-5.2 open weights beats GPT-5.5 coding." letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding —— 编程结果的独立报道。
- TechTimes. (2026, July 24). "Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk." www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm —— Kimi K3 发布,从 GLM-5.2 手中夺得开源权重第一的位置。
- VentureBeat. (2026, August 14). "GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor." venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor —— GLM-5.3 发布,与 GLM-5.2 基础模型相同,发布时仅限 API。
- MarkTechPost. (2026, August 26). "Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context." www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ —— GLM-5.3-Flash 的规格及其以 MIT 许可证即时发布。