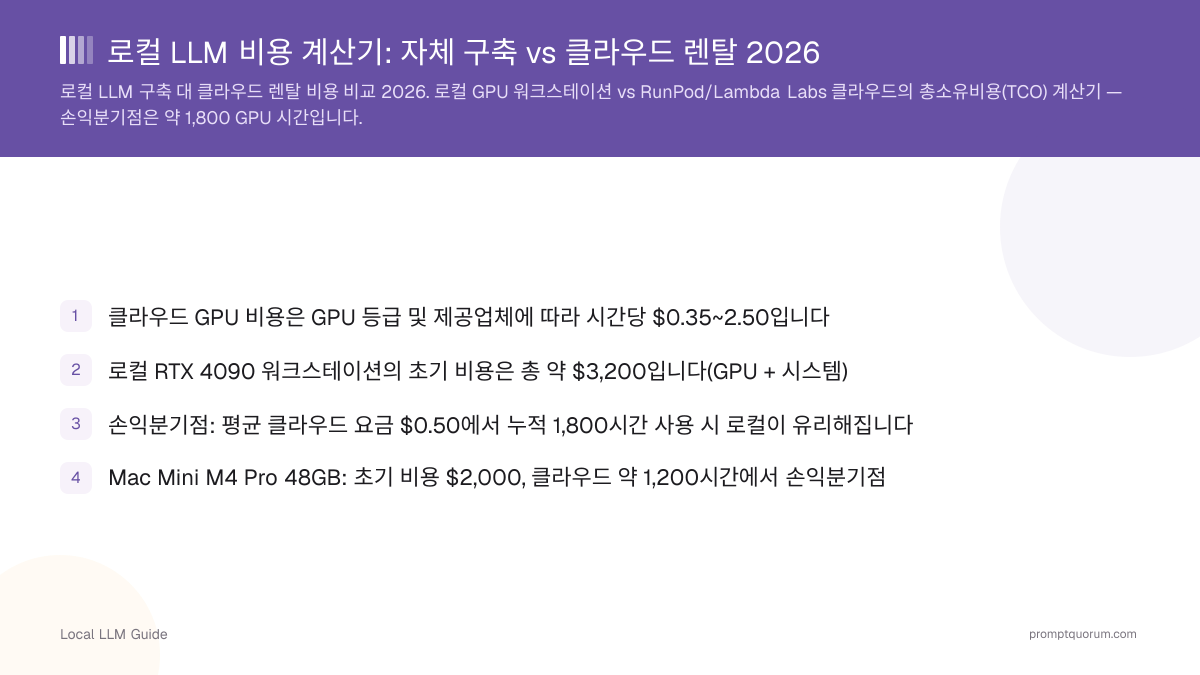
Key Takeaways
- 핵심 질문은 "월 몇 시간 사용하는가"이며, 고정된 로컬-대-클라우드 규칙이 아닙니다
- 클라우드 GPU 렌탈(RunPod, Vast.ai)은 RTX 4090급 GPU 기준 시간당 약 $0.13~0.69입니다
- 추천 로컬 RTX 4090 워크스테이션은 총 약 $2,800입니다
- 단순 손익분기점(가격 ÷ 클라우드 요금만): 5,600시간 — 하지만 전기 요금과 재판매 가치는 무시한 값입니다
- 완전한 TCO 손익분기점(하드웨어 + 전기 − 재판매): 약 4,780시간, 하루 8시간 사용 시 약 20개월 — 정확한 수치는 아래 계산기 참고
- 450W 시스템의 전기 요금은 미국 기준 시간당 약 $0.02, 독일 기준 약 $0.06 추가됩니다
- 월 약 100시간 미만의 산발적·실험적 워크로드에는 클라우드가 유리합니다
- 매일 지속적인 추론, 민감한 데이터, 또는 월 500시간 이상에는 로컬이 유리합니다
빠른 답변: 어떤 방식이 내 사용량에 맞을까?
이는 출발점일 뿐 엄격한 규칙이 아닙니다 — 하드웨어 가격, 클라우드 요금, 전기 요금, 재판매 가치가 실제 손익분기점을 좌우합니다. 정확한 답은 아래 계산기에서 확인하세요.
월간 시간 | 권장 사항 |
|---|---|
| 20시간 미만 | 렌탈 — 로컬은 거의 회수되지 않음 |
| 20~100시간 | 대체로 렌탈이 유리 |
| 100~250시간 | 하드웨어 가격에 따라 신중히 비교 |
| 250~500시간 | 로컬 하드웨어가 매력적이 됨 |
| 500시간 이상 | 총비용 기준 로컬이 보통 유리 |
| 상시 가동(24/7) | 로컬 하드웨어 구매 |
인터랙티브 비용 계산기: 로컬 vs 클라우드
월간 사용 시간, 클라우드 GPU 요금, 로컬 하드웨어 가격, 전기 요금, 예상 재판매 가치, 사용 기간을 입력하세요. 아래 계산기가 클라우드 월 비용, 로컬 운영 비용, 로컬 총소유비용, 손익분기점을 실시간으로 계산합니다. 모든 수치는 입력값과 조사된 참고 가격을 바탕으로 산출한 추정치이며, PromptQuorum이 직접 측정한 결과가 아닙니다.
Average daily use × 30. Example: 8 hr/day = 240 hr/month.
Blended spot/on-demand rate for a comparable GPU (RunPod, Vast.ai, Lambda Labs).
Full system cost — GPU, case, PSU, RAM, storage, not just the GPU.
What you expect to sell the hardware for at the end of the ownership period.
How long you plan to keep and use this hardware.
Recommendation
BUY LOCAL
At this usage, owning hardware costs less than renting over your ownership period.
See the GPU workstation guide →Your numbers
Cloud cost / month
$120
Local operating cost / month
$18
Total local cost over period (hardware + electricity − resale)
$2,461
Break-even (full TCO)
23 months
Break-even in cumulative hours
5,465 hours
Naive break-even (hardware price ÷ cloud rate only, ignoring electricity and resale) for these hardware/cloud-rate inputs: 6,400 hours
하드웨어 결정 표
구체적인 구성 가격을 산출하기 전에 목표 모델 크기와 사용 패턴을 하드웨어 등급에 맞춰보세요.
등급 | VRAM / RAM | 최적 용도 | 가격대 |
|---|---|---|---|
| N150 미니 PC | 16GB RAM | 가벼운 채팅, 7B 이하 | $500 미만 |
| Ryzen 미니 PC | 32~64GB RAM | 7B~14B 일상 사용, 24/7 서버 | $500~1,000 |
| RTX 3090(중고) | 24GB VRAM | 30B Q4까지, 최고의 VRAM/달러 | $1,000~2,000 |
| RTX 4090 | 24GB VRAM | 34B Q4까지, 최고속 단일 GPU | $2,000~4,000 |
| 48GB GPU 구성 | 48GB VRAM | 70B Q4까지, 개발·연구 | $4,000 이상 |
| Mac(통합 메모리) | 48~128GB 통합 | MLX로 70B 이상, 저전력 | $2,000~4,000 이상 |
경로 1 — 낮은 사용량: 클라우드 GPU 렌탈
실험, 가끔 하는 파인튜닝, 변동성 있는 워크로드, 또는 하드웨어 투자 전 테스트에는 렌탈이 적합합니다. 사용한 시간만큼만 비용을 지불하며 유지 관리가 필요 없고, 구매 시 수천 달러가 드는 GPU 등급(H100, A100 80GB)에도 즉시 접근할 수 있습니다.
현재 클라우드 GPU 가격 비교: RunPod 가격과 Vast.ai 가격은 편집상 참고 링크이며 제휴 링크가 아닙니다 — PromptQuorum은 두 제공업체 어디와도 수수료 관계가 없습니다.
경로 2 — 중간 사용량: 미니 PC가 GPU 워크스테이션을 능가할 수 있음
매일 사용하는 7B~14B 모델 — 채팅, Home Assistant 자동화, 24/7 Ollama 운영 — 에는 Ryzen 미니 PC가 와트당 비용과 설치 공간에서 개별 GPU를 능가하는 경우가 많습니다. 실제 24/7 Ollama 운영 사례는 Beelink SER8 리뷰를, 현재 라인업은 로컬 LLM 최고의 미니 PC 가이드와 로컬 LLM 최고의 AMD 미니 PC를 참고하세요. Minisforum UM890 Pro, GMKtec G3 Plus도 포함됩니다.
경로 3 — 집중적인 로컬 AI: GPU 워크스테이션
30B 이상 모델, 파인튜닝, 빠른 다중 사용자 추론이 필요하다면 개별 GPU 워크스테이션이 적합한 등급입니다. 중요한 지표는 단순 벤치마크 속도가 아니라 달러당 VRAM입니다 — VRAM이 애초에 어떤 모델 크기를 로드할 수 있는지를 결정합니다. 로컬 LLM 워크스테이션 구축 가이드와 PromptQuorum의 GPU 워크스테이션 구축 가이드를 참고하세요.
가격대별 "무엇을 사야 할까?"
$500 미만 — 전용 AI 하드웨어를 구매하지 마세요. 이미 가진 장비를 활용하거나 가끔의 필요에는 렌탈을 이용하세요.
$500~1,000 — 32GB 이상 RAM을 갖춘 Ryzen 미니 PC. 로컬 LLM 최고의 AMD 미니 PC와 Beelink SER8 리뷰를 참고하세요.
$1,000~2,000 — 더 강력한 미니 PC, 또는 중고 RTX 3090 구성. 최고의 미니 PC 가이드와 $500 이하 최고의 GPU 가이드를 참고하세요.
$2,000~4,000 — 개별 GPU 워크스테이션(RTX 4090) 또는 대용량 통합 메모리 Mac. 워크스테이션 구축 가이드와 Apple Silicon 가이드를 참고하세요.
$4,000 이상 — 48GB 이상 VRAM, 멀티 GPU, 또는 워크스테이션급. 이용률을 신중히 계산하세요 — 이 등급은 지속적인 고강도 사용에서만 회수됩니다. PromptQuorum의 GPU 워크스테이션 구축 가이드를 참고하세요.
카테고리별 하드웨어 추천
- 예산형: GMKtec G3 Plus — 7B급 모델용 입문 미니 PC
- 중급형: Beelink SER8 — 7B~14B, Home Assistant, 24/7 Ollama 서버; Ryzen 대안으로 Minisforum UM890 Pro
- GPU 가성비: RTX 3090(중고, 약 $800~1,300) — 24GB 기준 달러당 최고의 VRAM
- GPU 성능: RTX 4090(2026년 2분기 단종(EOL), 2026년 8월 기준 약 $2,000~2,600) — 가장 빠른 단일 GPU 옵션, 워크스테이션 구축 가이드 참고
- Apple 옵션: 대용량 통합 메모리 Mac으로 저전력으로 70B 이상 모델 운영 — Apple Silicon 가이드 참고
위 RTX 3090/4090 및 Apple 관련 링크는 단순 제품/참고 링크입니다 — PromptQuorum은 제휴 프로그램이 없으며 어떤 하드웨어 구매에서도 수수료를 받지 않습니다.
로컬 AI 하드웨어를 구매하지 말아야 할 때
- 가끔 사용(월 약 10시간 이하) — 하드웨어가 대부분 유휴 상태로 있게 됩니다
- 매우 변동성 있는 워크로드 — 어떤 달은 집중적, 어떤 달은 전혀 없음
- 프로젝트마다 다른 GPU 등급 필요 — 클라우드는 24GB와 80GB 사이를 즉시 전환할 수 있습니다
- 하드웨어 유지 관리를 원하지 않음 — 드라이버, 냉각, 업그레이드, 고장 대응이 모두 로컬에서는 본인 몫입니다
- 아주 큰 모델이 가끔만 필요함 — H100을 일주일 렌탈하는 편이 구매보다 낫습니다
로컬 AI가 유리한 경우
- 매일 예측 가능한 사용 — 위 사용량 표대로 시간이 빠르게 누적됩니다
- 비용 예측 가능성 — 고정된 하드웨어 비용은 변동하는 클라우드 청구서보다 예산 세우기 쉽습니다
- 민감한 데이터 또는 오프라인 요구 — 아무것도 네트워크 밖으로 나가지 않습니다
- 무제한 추론 필요 — Ollama 공식 문서는 자체 하드웨어에서 모델을 실행하는 것은 무제한이라고 명시하며, 별도 제품인 Ollama의 관리형 클라우드 서비스만 요금제별 사용 제한이 있습니다
- 다년간의 사용 계획이 있고 하드웨어를 잘 활용할 수 있는 경우
국가별 전기 요금
450W 로컬 워크스테이션을 월 240시간(하루 8시간) 가동하면 미국에서는 전기 요금이 약 월 $18, 독일에서는 약 월 $40입니다. 위 계산기에서는 본인의 요금을 입력하세요 — 아래는 참고값입니다.
국가 | 주거용 요금 | 450W 시스템, 월 240시간 |
|---|---|---|
| 미국 | 약 $0.17/kWh | 약 $18/월 |
| 독일 | 약 €0.37/kWh(약 $0.37) | 약 $40/월 |
| 영국 | 약 £0.26/kWh(약 $0.33) | 약 $36/월 |
| 프랑스 | 약 €0.22/kWh(약 $0.22) | 약 $24/월 |
클라우드 GPU 제공업체 비교
2026년 8월 기준 RTX 4090급 대표 요금입니다 — 렌탈 전 항상 최신 가격을 확인하세요. 가격은 자주 변동합니다.
제공업체 | 최적 용도 | 가격 모델 | 결론 |
|---|---|---|---|
| RunPod | 신뢰성, 관리형 팟 | 초 단위 과금, $0.34~0.69/시간 | 꾸준한 워크로드에 무난한 기본 선택 |
| Vast.ai | 최저가, 유연함 | 마켓플레이스 입찰, $0.13~0.34/시간 | 가장 저렴하지만 호스트 품질 편차 있음 |
| Lambda Labs | 데이터센터급 GPU(A100/H100) | 시간당 온디맨드, $1.99~4.29/시간 | 대규모 학습에 적합, 저가 4090 렌탈에는 부적합 |
최종 결론: 보편적인 승자는 없습니다
이 글의 사용 시간 기준 경험칙은 참고용이지 절대적인 법칙이 아닙니다. 실제 손익분기점은 클라우드 요금, 하드웨어 가격, 전기 요금, 재판매 가치에 따라 달라집니다 — 위 계산기는 고정된 임계값이 아니라 본인의 입력값에 대한 실제 답을 계산합니다.
다음 기준으로 결정하세요
다음의 경우 로컬 LLM을 사용하십시오:
- •LLM을 월 250시간 이상 또는 상시 사용함
- •수년에 걸친 비용 예측 가능성이 필요함
- •데이터 프라이버시 또는 오프라인 기능이 필수임
- •하드웨어를 유휴 상태가 아닌 충분히 활용할 수 있음
다음의 경우 클라우드 모델을 사용하십시오:
- •LLM을 월 100시간 미만 사용함
- •워크로드가 산발적이거나 실험적임
- •소유하기에는 너무 비싼 GPU 등급이 필요함(H100, A100 80GB)
- •유지 관리나 초기 자본 지출을 원하지 않음
빠른 결정:
- →실제 수치로 위 계산기를 사용하세요
- →월 100시간 미만 → 클라우드 렌탈
- →월 500시간 이상 또는 상시 가동 → 로컬 구매
- →월 100~500시간 → 하드웨어 가격과 전기 요금이 관건
계산 결과에 따른 다음 단계
- 낮은 사용량(월 100시간 미만): 현재 클라우드 GPU 가격 비교
- 소형 모델, 매일 사용: 로컬 LLM 최고의 미니 PC
- 7B~14B, 24/7 서버: Beelink SER8 리뷰 또는 최고의 AMD 미니 PC
- 30B 이상 모델, 집중적인 로컬 사용: 워크스테이션 구축 가이드
- 70B급, 상시 가동: PromptQuorum의 GPU 워크스테이션 구축 가이드
로컬 AI가 항상 클라우드보다 저렴합니까?
아닙니다. 로컬 하드웨어는 하드웨어 가격, 전기 요금, 클라우드 요금에 따라 달라지는 사용량 임계값 — 중급 GPU 워크스테이션 기준 보통 월 250~500시간 — 을 넘어야만 저렴해집니다. 그 이하에서는 클라우드 렌탈이 보통 더 저렴합니다.
몇 시간부터 로컬 하드웨어 구매가 이득입니까?
$2,800짜리 RTX 4090 워크스테이션을 시간당 $0.50의 클라우드 요금과 비교하면, 단순 손익분기점(가격 ÷ 요금)은 누적 5,600시간입니다. 전기 요금과 재판매 가치를 포함하면, 월 240시간(하루 8시간) 사용 기준 완전한 TCO 손익분기점은 약 4,780시간 — 약 20개월입니다. 정확한 수치는 위 계산기를 이용하세요.
로컬 AI 비용 추정에 전기 요금이 포함되어 있습니까?
포함되어야 하지만, 단순 비교에서는 흔히 빠집니다. 450W 시스템을 하루 8시간 가동하면 미국(약 $0.17/kWh) 기준 월 약 $18, 독일(약 €0.37/kWh) 기준 월 약 $40의 전기 요금이 추가됩니다. 위 계산기에서는 본인의 요금을 직접 입력할 수 있습니다.
로컬 LLM에 Mac이 적합합니까?
대용량 통합 메모리를 갖춘 Mac은 저전력으로 대형 모델(70B급)을 실행할 수 있어, 특히 전기 요금이 높은 국가에서 총소유비용 측면에서 유리합니다. 현재 모델 크기와 성능에 대한 자세한 내용은 위에 링크된 Apple Silicon 가이드를 참고하세요.
로컬 LLM에 VRAM 24GB면 충분합니까?
24GB(RTX 3090 또는 RTX 4090)는 4비트 양자화 기준 약 30~34B 파라미터까지의 모델을 무리 없이 실행할 수 있어, 대부분의 단일 사용자 로컬 AI 용도를 충족합니다. 70B급 모델에는 약 48GB가 필요하며, 듀얼 GPU 구성이나 대용량 통합 메모리 Mac으로 달성할 수 있습니다.
RTX 4090을 구매해야 할까요, 아니면 클라우드 GPU 시간을 렌탈해야 할까요?
수년에 걸쳐 월 약 250~500시간 이상의 지속적인 사용이 예상되고 하드웨어를 충분히 활용할 수 있다면 구매하세요. 사용이 가끔이거나 산발적이거나 아직 워크로드를 검증 중이라면 렌탈하세요 — 렌탈하면 RTX 4090(2026년 8월 기준 EOL 가격, 2026년 2분기 단종)의 초기 투자 비용 약 $2,000~2,600를 완전히 피할 수 있습니다.
로컬 LLM을 실행하는 가장 저렴한 방법은 무엇입니까?
초기 비용을 가장 낮추려면, 양자화된 7B~14B 모델을 구동하는 Ryzen 미니 PC($500~1,000)가 가장 저렴한 전용 로컬 구성입니다. 저사용량에서 추론당 비용을 가장 낮추려면, 하드웨어를 전혀 구매하지 않는 클라우드 GPU 렌탈이 더 저렴합니다.
AI를 로컬로 실행하면 데이터가 제 컴퓨터를 절대 벗어나지 않는다는 뜻입니까?
네, 자체 하드웨어에서 Ollama와 같은 도구를 사용한 로컬 추론의 경우 어디로도 데이터가 전송되지 않습니다. 이는 Ollama의 별도 관리형 클라우드 서비스와는 다릅니다. 그 서비스는 실제로 Ollama의 인프라에 요청을 전송합니다 — 데이터가 완전히 본인의 기기 안에만 머무는 것은 로컬·온디바이스 모드뿐입니다.