Wichtigste Erkenntnisse
- Die Kernfrage ist "wie viele Stunden pro Monat?" — keine feste Lokal-vs-Cloud-Regel
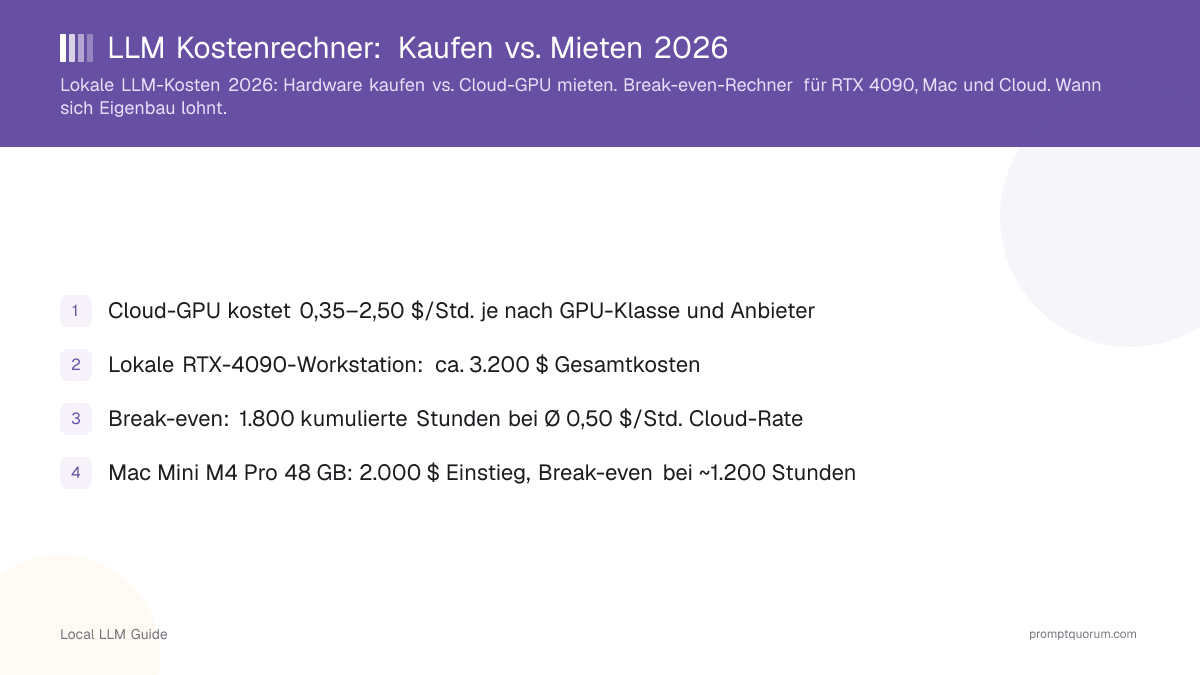
- Cloud-GPU-Miete (RunPod, Vast.ai) kostet etwa 0,13–0,69 $/Std. für eine RTX-4090-Klasse-GPU
- Eine empfohlene lokale RTX-4090-Workstation kostet insgesamt ca. 2.600 €
- Naiver Break-even (Preis ÷ Cloud-Rate): 5.600 Stunden — ignoriert aber Strom und Wiederverkauf
- Vollständiger TCO-Break-even (Hardware + Strom − Wiederverkauf): ca. 4.780 Stunden, etwa 20 Monate bei 8 Std./Tag — Rechner unten für eigene Zahlen nutzen
- Strom fügt bei einem 450-W-System etwa 0,02 $/Std. (USA) bis 0,06 $/Std. (Deutschland) hinzu
- Cloud gewinnt bei sporadischer oder experimenteller Nutzung unter ca. 100 Std./Monat
- Lokal gewinnt bei täglichem Dauerbetrieb, sensiblen Daten oder 500+ Std./Monat
Kurzantwort: Was passt zu Ihrer Nutzung?
Das ist ein Ausgangspunkt, keine feste Regel — Hardwarepreis, Ihre Cloud-Rate, Ihr Strompreis und der Wiederverkaufswert verschieben den tatsächlichen Break-even. Der Rechner unten liefert die exakte Antwort für Ihre Zahlen.
Std./Monat | Empfehlung |
|---|---|
| Unter 20 Std. | Cloud mieten — lokal zahlt sich fast nie aus |
| 20–100 Std. | Meist Cloud mieten |
| 100–250 Std. | Genau vergleichen — Hardwarepreis entscheidet |
| 250–500 Std. | Lokale Hardware wird attraktiv |
| 500+ Std. | Lokal gewinnt meist bei Gesamtkosten |
| Dauerbetrieb 24/7 | Lokale Hardware kaufen |
Interaktiver Kostenrechner: Lokal vs. Cloud
Geben Sie Ihre monatlichen Nutzungsstunden, Cloud-GPU-Tarif, Hardwarepreis, Strompreis, erwarteten Wiederverkaufswert und Nutzungsdauer ein. Der Rechner unten berechnet live Ihre Cloud-Kosten pro Monat, Ihre lokalen Betriebskosten, Ihre Gesamtkosten und Ihren Break-even-Punkt. Alle Werte sind berechnete Schätzungen aus Ihren Eingaben plus recherchierten Referenzpreisen — keine von PromptQuorum selbst gemessenen Werte.
Average daily use × 30. Example: 8 hr/day = 240 hr/month.
Blended spot/on-demand rate for a comparable GPU (RunPod, Vast.ai, Lambda Labs).
Full system cost — GPU, case, PSU, RAM, storage, not just the GPU.
What you expect to sell the hardware for at the end of the ownership period.
How long you plan to keep and use this hardware.
Recommendation
BUY LOCAL
At this usage, owning hardware costs less than renting over your ownership period.
See the GPU workstation guide →Your numbers
Cloud cost / month
$120
Local operating cost / month
$18
Total local cost over period (hardware + electricity − resale)
$2,461
Break-even (full TCO)
23 months
Break-even in cumulative hours
5,465 hours
Naive break-even (hardware price ÷ cloud rate only, ignoring electricity and resale) for these hardware/cloud-rate inputs: 6,400 hours
Hardware-Entscheidungstabelle
Ordnen Sie Ihre Zielmodellgröße und Ihr Nutzungsmuster einer Hardware-Stufe zu, bevor Sie einen konkreten Build kalkulieren.
Stufe | VRAM / RAM | Am besten für | Preisklasse |
|---|---|---|---|
| N150 Mini-PC | 16 GB RAM | Leichter Chat, bis 7B | Unter 500 € |
| Ryzen Mini-PC | 32–64 GB RAM | 7B–14B täglich, 24/7-Server | 500–1.000 € |
| RTX 3090 (gebraucht) | 24 GB VRAM | Bis 30B Q4, bestes VRAM/€ | 750–1.200 € |
| RTX 4090 | 24 GB VRAM | Bis 34B Q4, schnellste Single-GPU | 1.900–2.600 € |
| 48-GB-GPU-Setup | 48 GB VRAM | Bis 70B Q4, Entwicklung | 4.000 €+ |
| Mac (Unified Memory) | 48–128 GB unified | 70B+ via MLX, geringer Verbrauch | 2.000–4.000 €+ |
Weg 1 — Geringe Nutzung: Cloud-GPU mieten
Mieten ist richtig für Experimente, gelegentliches Fine-Tuning, wechselnde Workloads oder zum Testen vor der Anschaffung. Sie zahlen nur genutzte Stunden, ohne Wartung und mit sofortigem Zugriff auf GPU-Klassen (H100, A100 80GB), die im Kauf tausende Dollar kosten würden.
Aktuelle Cloud-GPU-Preise vergleichen: RunPod-Preise und Vast.ai-Preise sind redaktionelle Referenzlinks, keine Affiliate-Links — PromptQuorum hat mit keinem der beiden Anbieter eine Provisionsbeziehung.
Weg 2 — Mittlere Nutzung: Ein Mini-PC schlägt oft die GPU-Workstation
Für täglich genutzte 7B–14B-Modelle — Chat, Home-Assistant-Automatisierungen, Ollama im Dauerbetrieb — schlägt ein Ryzen-Mini-PC eine diskrete GPU oft bei Kosten pro Watt und Platzbedarf. Siehe den Beelink-SER8-Test für einen echten 24/7-Ollama-Einsatz, sowie den Guide zu den besten Mini-PCs für lokale LLMs und besten AMD-Mini-PC für lokale LLMs, einschließlich Minisforum UM890 Pro und GMKtec G3 Plus.
Weg 3 — Intensive lokale KI: GPU-Workstation
Ab 30B+ Modellen, Fine-Tuning oder schneller Multi-User-Inferenz ist eine diskrete GPU-Workstation die richtige Stufe. Entscheidend ist VRAM pro Dollar, nicht die reine Benchmark-Geschwindigkeit — VRAM bestimmt, welche Modellgrößen überhaupt laden. Siehe den Guide zum Bau einer lokalen LLM-Workstation und PromptQuorums GPU-Workstation-Build-Guide.
"Was soll ich kaufen?" nach Preisklasse
Unter 500 € — Keine dedizierte KI-Hardware kaufen. Vorhandene Geräte nutzen oder für gelegentlichen Bedarf mieten.
500–1.000 € — Ein Ryzen-Mini-PC mit 32GB+ RAM. Siehe besten AMD-Mini-PC für lokale LLMs und Beelink-SER8-Test.
750–1.200 € — Eine gebrauchte RTX 3090 oder ein leistungsstärkerer Mini-PC. Siehe Guide zu den besten Mini-PCs und beste GPU unter $500.
1.900–2.600 € — Eine diskrete GPU-Workstation (RTX 4090, EOL-Gebrauchtmarktpreis) oder ein Mac mit großem Unified Memory (ca. 2.000–4.000 €). Siehe Workstation-Build-Guide und Apple-Silicon-Guide.
4.000 €+ — 48GB+ VRAM, Multi-GPU oder Workstation-Klasse. Auslastung sorgfältig kalkulieren — diese Stufe rechnet sich nur bei intensiver Dauernutzung. Siehe PromptQuorums GPU-Workstation-Build-Guide.
Hardware-Empfehlungen nach Kategorie
- Budget: GMKtec G3 Plus — Einstiegs-Mini-PC für 7B-Modelle
- Mittelklasse: Beelink SER8 — 7B–14B, Home Assistant, 24/7-Ollama-Server; Minisforum UM890 Pro als Ryzen-Alternative
- GPU-Preis-Leistung: RTX 3090 (gebraucht, ca. 750–1.200 €) — bestes VRAM pro Euro bei 24GB
- GPU-Leistung: RTX 4090 (ca. 1.900–2.600 €, EOL-Gebrauchtmarktpreis Stand August 2026 — Produktionsende im Q2 2026) — schnellste Single-GPU-Option, siehe Workstation-Build-Guide
- Apple-Option: Mac mit viel Unified Memory für 70B+ Modelle bei geringem Verbrauch — siehe Apple-Silicon-Guide
Die RTX-3090/4090- und Apple-Links oben sind reine Produkt-/Referenzlinks — PromptQuorum hat kein Partnerprogramm und erhält keine Provision auf Hardware-Käufe.
Wann Sie KEINE lokale KI-Hardware kaufen sollten
- Gelegentliche Nutzung (ca. 10 Std./Monat oder weniger) — die Hardware steht meist ungenutzt
- Stark schwankender Bedarf — mal intensiv, mal gar nicht
- Verschiedene GPU-Klassen je Projekt nötig — Cloud erlaubt sofortigen Wechsel zwischen 24GB und 80GB
- Keine Wartung gewünscht — Treiber, Kühlung, Upgrades, Ausfälle liegen bei lokaler Hardware bei Ihnen
- Nur gelegentlich sehr große Modelle nötig — ein H100 für eine Woche mieten schlägt den Kauf
Wann lokale KI gewinnt
- Tägliche, planbare Nutzung — die Stunden summieren sich schnell, siehe Nutzungstabelle oben
- Kostenplanbarkeit — ein fixer Hardwarepreis lässt sich leichter budgetieren als variable Cloud-Rechnungen
- Sensible Daten oder Offline-Pflicht — nichts verlässt Ihr Netzwerk
- Bedarf an unbegrenzter Inferenz — laut Ollamas eigener Dokumentation ist der Betrieb von Modellen auf eigener Hardware unbegrenzt; nur Ollamas separater Cloud-Dienst hat planabhängige Nutzungslimits
- Mehrjähriger Nutzungshorizont mit gut ausgelasteter Hardware
Strompreise nach Land
Eine 450-W-Workstation im Dauerbetrieb von 240 Std./Monat (8 Std./Tag) kostet in den USA etwa 18 $/Monat Strom, in Deutschland etwa 40 $/Monat. Nutzen Sie im Rechner oben Ihren eigenen Tarif — dies sind Referenzwerte.
Land | Haushaltstarif | 450-W-System, 240 Std./Monat |
|---|---|---|
| USA | ~0,17 $/kWh | ~18 $/Monat |
| Deutschland | ~0,37 €/kWh (~0,37 $) | ~40 $/Monat |
| Vereinigtes Königreich | ~0,26 £/kWh (~0,33 $) | ~36 $/Monat |
| Frankreich | ~0,22 €/kWh (~0,22 $) | ~24 $/Monat |
Vergleich Cloud-GPU-Anbieter
Repräsentative RTX-4090-Klasse-Tarife, Stand August 2026 — aktuelle Preise vor der Miete immer prüfen, sie ändern sich häufig.
Anbieter | Am besten für | Preismodell | Fazit |
|---|---|---|---|
| RunPod | Zuverlässigkeit, verwaltete Pods | Pro Sekunde, 0,34–0,69 $/Std. | Solider Standard für stetige Workloads |
| Vast.ai | Niedrigster Preis, flexibel | Marktplatz-Bieten, 0,13–0,34 $/Std. | Günstigste, Hostqualität variiert |
| Lambda Labs | Rechenzentrums-GPUs (A100/H100) | Stündlich on-demand, 1,99–4,29 $/Std. | Beste Wahl für großes Training, nicht für günstige 4090-Miete |
Fazit: Es gibt keinen universellen Gewinner
Die Faustregeln zu Nutzungsstunden in diesem Artikel sind Orientierung, keine feste Regel. Ihr tatsächlicher Break-even hängt von Ihrer Cloud-Rate, Ihrem Hardwarepreis, Ihrem Strompreis und Ihrem Wiederverkaufswert ab — der Rechner oben berechnet die reale Antwort für Ihre Eingaben, nicht eine feste Schwelle.
Entscheiden Sie anhand von
Lokales LLM nutzen, wenn:
- •Sie nutzen LLMs 250+ Std./Monat oder dauerhaft
- •Sie brauchen Kostenplanbarkeit über mehrere Jahre
- •Datenschutz oder Offline-Fähigkeit ist Pflicht
- •Sie können die Hardware gut auslasten, nicht ungenutzt lassen
Cloud-Modell nutzen, wenn:
- •Sie nutzen LLMs unter 100 Std./Monat
- •Ihr Workload ist sporadisch oder experimentell
- •Sie brauchen zu teure GPU-Klassen (H100, A100 80GB)
- •Sie wollen keine Wartung oder Anfangsinvestition
Schnelle Entscheidung:
- →Rechner oben mit Ihren echten Zahlen nutzen
- →Unter 100 Std./Monat → Cloud mieten
- →500+ Std./Monat oder Dauerbetrieb → lokal kaufen
- →100–500 Std./Monat → Hardwarepreis und Strompreis entscheiden
Nächste Schritte nach Ihrem Ergebnis
- Geringe Nutzung (unter 100 Std./Monat): aktuelle Cloud-GPU-Preise vergleichen
- Kleine Modelle, tägliche Nutzung: beste Mini-PCs für lokale LLMs
- 7B–14B, 24/7-Server: Beelink-SER8-Test oder bester AMD-Mini-PC
- 30B+ Modelle, intensive lokale Nutzung: Workstation-Build-Guide
- 70B-Klasse, Dauerbetrieb: PromptQuorums GPU-Workstation-Build-Guide
Ist lokale KI immer günstiger als Cloud?
Nein. Lokale Hardware ist erst ab einer Nutzungsschwelle günstiger, die von Hardwarepreis, Strompreis und Cloud-Rate abhängt — typischerweise etwa 250–500 Std./Monat bei einer Mittelklasse-GPU-Workstation. Darunter ist Cloud-Miete meist günstiger, da keine Anfangsinvestition anfällt.
Ab wie vielen Stunden lohnt sich der Kauf lokaler Hardware?
Für eine 2.600-€-RTX-4090-Workstation gegenüber einer 0,50-$/Std.-Cloud-Rate liegt der naive Break-even (Preis ÷ Rate) bei 5.600 kumulierten Stunden. Rechnet man Strom und Wiederverkaufswert ein, liegt der vollständige TCO-Break-even bei 240 Std./Monat (8 Std./Tag) bei ca. 4.780 Stunden — etwa 20 Monaten. Nutzen Sie den Rechner oben für Ihre eigenen Zahlen.
Ist Strom in Kostenschätzungen für lokale KI enthalten?
Sollte er sein, ist es aber oft nicht in einfachen Vergleichen. Ein 450-W-System im 8-Std.-Tagesbetrieb fügt in den USA (~0,17 $/kWh) etwa 18 $/Monat, in Deutschland (~0,37 €/kWh) etwa 40 $/Monat hinzu. Der Rechner oben erlaubt Ihren eigenen Tarif.
Ist ein Mac für lokale LLMs geeignet?
Macs mit viel Unified Memory können große Modelle (70B-Klasse) bei geringem Stromverbrauch betreiben, was ihre Kostenbilanz verbessert, besonders in Ländern mit hohen Strompreisen. Details im oben verlinkten Apple-Silicon-Guide.
Reichen 24GB VRAM für lokale LLMs?
24GB (RTX 3090 oder RTX 4090) laufen komfortabel mit Modellen bis etwa 30–34B Parametern bei 4-Bit-Quantisierung, was die meisten Einzelnutzer-Anwendungsfälle abdeckt. 70B-Klasse-Modelle benötigen etwa 48GB, erreichbar mit Dual-GPU-Setups oder Macs mit viel Unified Memory.
RTX 4090 kaufen oder Cloud-GPU-Zeit mieten?
Kaufen, wenn Sie über mehrere Jahre anhaltende Nutzung von etwa 250–500+ Std./Monat erwarten und die Hardware gut auslasten können. Mieten, wenn Ihre Nutzung gelegentlich, sporadisch ist oder Sie den Workload noch validieren — Mieten vermeidet die ca. 1.900–2.600-€-Anfangsinvestition einer RTX 4090 (EOL-Gebrauchtmarktpreis, Stand August 2026, Produktionsende im Q2 2026) komplett.
Was ist der günstigste Weg, ein lokales LLM zu betreiben?
Für die niedrigsten Anfangskosten ist ein Ryzen-Mini-PC (500–1.000 $) mit einem quantisierten 7B–14B-Modell das günstigste dedizierte lokale Setup. Für die niedrigsten Kosten pro Inferenz bei geringem Volumen ist Cloud-GPU-Miete ganz ohne Hardwarekauf günstiger.
Bedeutet lokale KI, dass Daten den Computer nie verlassen?
Ja, bei lokaler Inferenz mit Tools wie Ollama auf eigener Hardware werden keine Daten irgendwohin gesendet. Das gilt nicht für Ollamas separaten Cloud-Dienst, der Anfragen an Ollamas Infrastruktur sendet — nur der lokale On-Device-Modus hält Daten vollständig auf Ihrem Rechner.