Wichtigste Erkenntnisse
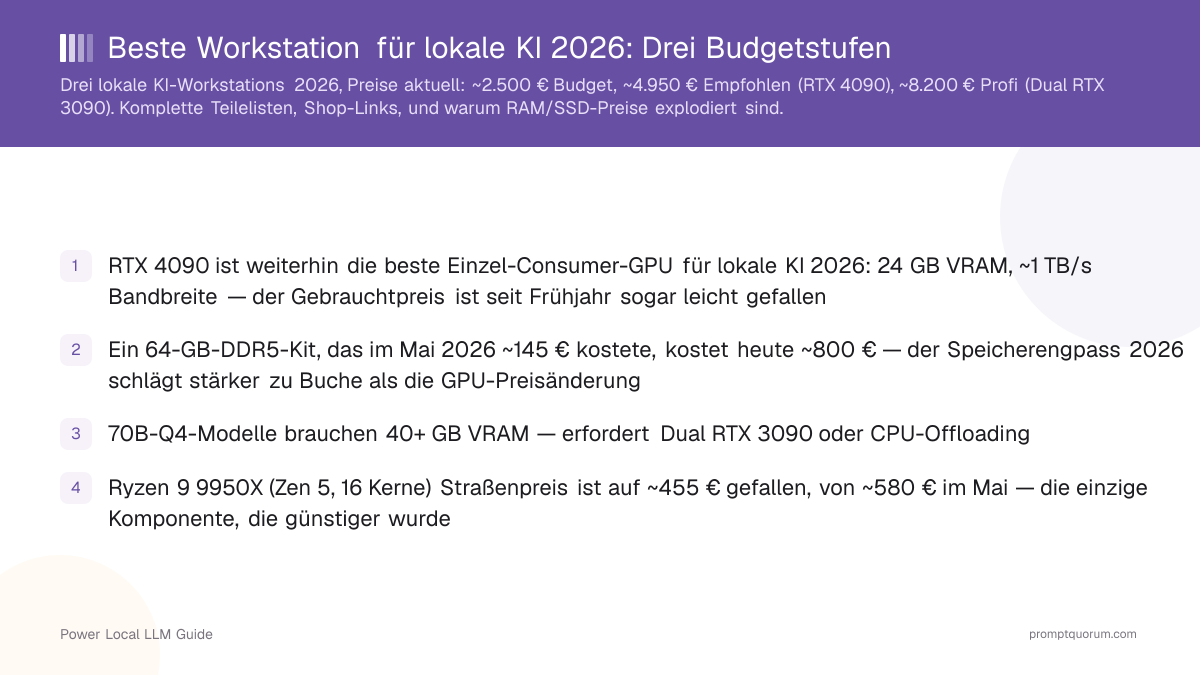
- RTX 4090 ist weiterhin die beste Einzel-Consumer-GPU für lokale KI 2026: 24 GB VRAM, ~1 TB/s Bandbreite — der Gebrauchtpreis ist seit Frühjahr sogar leicht gefallen
- Ein 64-GB-DDR5-Kit, das im Mai 2026 ~145 € kostete, kostet heute ~800 € — der Speicherengpass 2026 schlägt stärker zu Buche als die GPU-Preisänderung
- 70B-Q4-Modelle brauchen 40+ GB VRAM — erfordert Dual RTX 3090 oder CPU-Offloading
- Ryzen 9 9950X (Zen 5, 16 Kerne) Straßenpreis ist auf ~455 € gefallen, von ~580 € im Mai — die einzige Komponente, die günstiger wurde
- PCIe Gen 4/5 NVMe lädt ein 7B-Modell in unter 2 Sekunden, aber eine 4-TB-Gen-5-SSD kostet jetzt ~745 €, vorher ~200 €
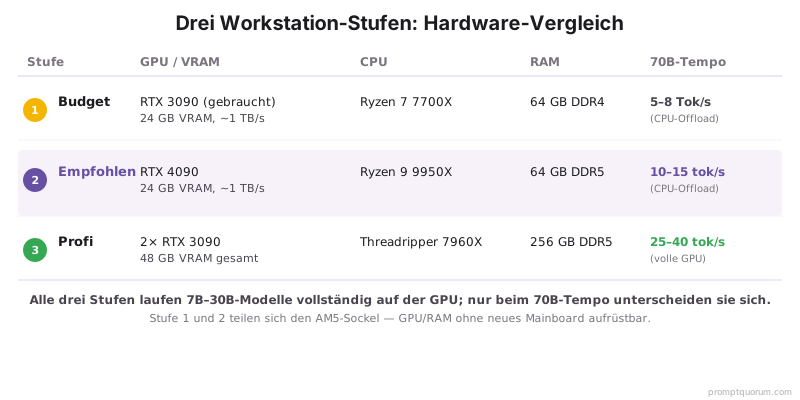
- Stufe 1 und 2 teilen sich den AM5-Sockel — GPU/RAM später ohne neues Mainboard aufrüstbar; Stufe 3 braucht TRX50
Welche Workstation solltest du bauen?
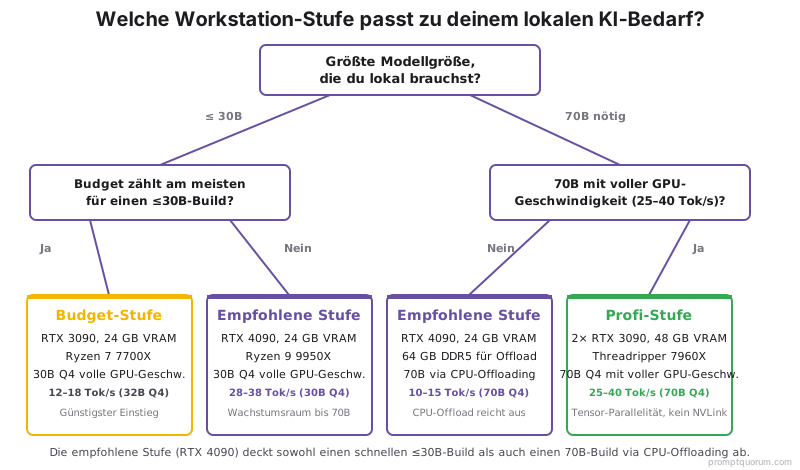
Wähle deinen Build nach dem größten Modell, das du wirklich brauchst: 7B–14B → Budget. 14B–32B → Empfohlen. 70B → Profi. Preise unten sind Komplettsystem-Gesamtpreise, Stand 25. August 2026.
Budget | Empfohlen | Profi | |
|---|---|---|---|
| Preis | ~2.500 € | ~4.950 € | ~8.200 € |
| GPU | RTX 3090 24GB (gebraucht) | RTX 4090 24GB | 2× RTX 3090 (48GB) |
| CPU | Ryzen 7 7700X | Ryzen 9 9950X | Threadripper 7960X |
| RAM | 64GB DDR5 | 64GB DDR5-6000 | 256GB DDR5 ECC |
| Größtes Modell | 32B Q4 auf GPU | 30B Q4 GPU / 70B Offload | 70B Q4 mit GPU-Tempo |
| Am besten für | Budgetkäufer, 7B–14B | Die meisten Nutzer, 14B–32B | 70B-Workloads, Mehrbenutzer |
Jede Summe unten liegt höher als anderswo 2026 zitierte Preise — das ist der DDR5/NAND-Engpass (siehe Hinweis nach den Stufentabellen), kein Fehler. GPU-Preise sind dagegen stabil bis leicht gefallen.
Anzeige
Redaktionsempfehlung: RTX 4090 Empfohlene Workstation
Die beste lokale KI-Workstation insgesamt für 2026 — der Balancepunkt zwischen VRAM, Aufrüstpotenzial und Preis für die breiteste Modellpalette.
- 24 GB VRAM — läuft jedes Modell bis 32B Q4 vollständig auf GPU
- 64 GB DDR5-6000 — genug für 70B via CPU-Offload mit 10–15 Tok/s
- Qwen3 32B Q4 vollständig auf GPU mit 28–38 Tok/s; 70B mit Offloading
- ~4.950 € Komplettsystem, Stand 25. August 2026
- Überspringen, wenn: du nur 7B–14B-Modelle nutzt — der Budget-Build spart ~2.450 € und erledigt das genauso gut
VRAM entscheidet über den Build — Modellgröße zur Hardware passen
Nicht sicher, welche Stufe du brauchst? Geh vom größten Modell aus, das du wirklich einsetzen willst — nicht dem, das du irgendwann mal nutzen könntest.
Modellgröße | Empfohlener VRAM | Bester Build |
|---|---|---|
| 7B | 8–12 GB | Budget (RTX 3090 hat reichlich Reserve) |
| 14B | 16–24 GB | Budget oder Empfohlen |
| 32B Q4 | ~20–24 GB | Empfohlen (RTX 4090) |
| 70B Q4 | ~40 GB+ | Profi (Dual RTX 3090) oder Offload auf Empfohlen |
| 70B Q8 | ~70 GB+ | Nur Multi-GPU — siehe unseren GPU-Ratgeber |
Nur eine einzelne GPU gesucht (nicht als Teil eines Komplett-Builds)? Siehe unseren GPU-Kaufratgeber für Einzelkarten unterhalb der Budget-Stufe.
Stufe 1: ~2.500 € Budget-KI-Workstation
Der Budget-Build nutzt eine gebrauchte RTX 3090 (24 GB VRAM) als Kern. Er läuft Llama 3.1 8B Q8 mit 45–60 Tok/s, Qwen3 14B Q8 mit 20–28 Tok/s und Qwen3 32B Q4 mit 12–18 Tok/s vollständig auf GPU. Kaufe diesen Build, wenn: dein Budget unter 3.000 € liegt, du hauptsächlich 7B–32B-Modelle nutzt und eine gebrauchte GPU kein Problem ist. Überspringen, wenn: 70B dein Hauptworkload ist — CPU-Offloading auf dieser Stufe läuft mit 5–8 Tok/s, funktional aber langsam.
- Vollständig auf GPU unterstützte Modelle: 7B (alle Quants), 13B, 14B Q4/Q8, 30B Q4
- 70B-Unterstützung: CPU-Offloading nötig — ~5–8 Tok/s
- Stromaufnahme Peak: ~450 W
Komponente | Modell | Preis (Aug 2026) |
|---|---|---|
| GPU | NVIDIA RTX 3090 (gebraucht, 24 GB) | ~800 € |
| CPU | AMD Ryzen 7 7700X | ~200 € |
| Mainboard | MSI MAG X670E Tomahawk WiFi | ~175 € |
| RAM | 64 GB DDR5-5600 (2×32 GB) | ~790 € (Mai: ~110 €) |
| Speicher | 2 TB PCIe Gen 4 NVMe | ~325 € (Mai: ~90 €) |
| Netzteil | 850 W 80+ Gold | ~100 € |
| Gehäuse | Mid-Tower ATX, 3+ Lüfterplätze | ~75 € |
| CPU-Kühler | 240mm AIO oder Tower | ~65 € |
| Gesamt | ~2.520 € |
💡Tipp: Gebraucht vs. neu: Gebrauchte RTX-3090-Karten (~650–950 € bei eBay.de) sparen 30–50% gegenüber den wenigen verbliebenen Neuware-Einheiten — auf Kosten der Garantie. Käufer mit Rückgaberecht wählen und auf Mining-Verschleiß (Lüftergeräusche, Wärmeleitpaste-Reste) prüfen.
Stufe 2: ~4.950 € Empfohlene KI-Workstation
Der Empfohlene Build zentriert sich auf die RTX 4090 (24 GB, ~1 TB/s Speicherbandbreite) mit dem AMD Ryzen 9 9950X (Zen 5, 16 Kerne). Die 4090 ist 30–40% schneller als die 3090 pro GB VRAM bei geringerem Stromverbrauch pro Token. Kaufe diesen Build, wenn: du die beste Single-GPU-Workstation willst, regelmäßig 14B–32B-Modelle nutzt und gelegentlich 70B offloaden willst. Überspringen, wenn: 70B dein täglicher Hauptworkload ist — dann besser Profi für GPU-Tempo bei 70B.
- 7B Q4 Geschwindigkeit: ~105–125 Tok/s
- 14B Q8 Geschwindigkeit: ~48–60 Tok/s
- 30B Q4 Geschwindigkeit: ~28–38 Tok/s
- 70B Q4 (CPU-Offloading): ~10–15 Tok/s mit 64 GB RAM
- Stromaufnahme Peak: ~550 W
Komponente | Modell | Preis (Aug 2026) |
|---|---|---|
| GPU | NVIDIA GeForce RTX 4090 24 GB | ~2.050 € |
| CPU | AMD Ryzen 9 9950X (16K/32T, Zen 5) | ~455 € (Mai: ~420 €) |
| Mainboard | ASUS ProArt X870E-Creator WiFi | ~485 € |
| RAM | 64 GB DDR5-6000 CL30 (2×32 GB) | ~835 € (Mai: ~145 €) |
| Speicher | 4 TB PCIe Gen 5 NVMe | ~745 € (Mai: ~200 €) |
| Netzteil | 1000 W 80+ Platinum | ~165 € |
| Gehäuse | Full-Tower ATX | ~130 € |
| CPU-Kühler | 360mm AIO | ~100 € |
| Gesamt | ~4.965 € |
Stufe 3: ~8.200 € Profi-70B-Workstation
Der Profi-Build zielt auf 70B-Modell-Inferenz mit GPU-Geschwindigkeit (25–40 Tok/s) durch dual RTX 3090 GPUs für 48 GB VRAM gesamt. Der Ryzen Threadripper 7960X (24 Kerne) beschleunigt CPU-Offloading. Mit 256 GB DDR5 ECC laden selbst 140B-quantisierte Modelle vollständig in RAM. Kaufe diesen Build, wenn: 70B dein Hauptworkload ist, du 48 GB+ GPU-VRAM brauchst oder mehrere Nutzer gleichzeitig bedienst. Überspringen, wenn: du noch nie ein Modell größer als 32B genutzt hast — diese Stufe ist dann deutlich überdimensioniert.
- 70B Q4 Geschwindigkeit: 25–40 Tok/s (beide RTX 3090s via Tensor-Parallelismus)
- CPU-Offloading mit 256 GB RAM: 140B+ Modelle mit 4–6 Tok/s
- Stromaufnahme Peak: ~900 W
Komponente | Modell | Preis (Aug 2026) |
|---|---|---|
| GPU ×2 | 2× NVIDIA RTX 3090 24 GB (gebraucht) | ~1.580 € |
| CPU | AMD Ryzen Threadripper 7960X (24K) | ~1.300 € (volatil — 950–2.300 € gesehen) |
| Mainboard | ASUS Pro WS TRX50-SAGE WiFi | ~745 € |
| RAM | 256 GB DDR5-5200 ECC (8×32 GB) | ~2.600 € (Mai: ~650 € — vor Kauf prüfen) |
| Speicher | 8 TB PCIe Gen 4 NVMe (2×4 TB) | ~1.300 € (Mai: ~360 €) |
| Netzteil | 1600 W Platinum | ~325 € |
| Gehäuse | Full-Tower HEDT ATX | ~205 € |
| CPU-Kühler | 360mm AIO + Extralüfter | ~140 € |
| Gesamt | ~8.195 € |
⚠️Warnung: Der DDR5-Engpass 2026 traf ECC/RDIMM-Server-RAM am härtesten — 256-GB-DDR5-ECC-Kits sind knapp und preislich volatil. Vor der Bestellung ein Live-Angebot für auf der QVL des Mainboards gelistetes RAM einholen; der Wert oben ist eine geprüfte Schätzung, kein garantierter Preis.
Hardware, die wir für diesen Einsatzzweck NICHT kaufen würden
- Eine 8-GB-GPU, wenn 32B-Modelle das Ziel sind — die VRAM-Grenze wird sofort erreicht; kein CPU-Offloading-Trick gleicht eine zu kleine Karte so aus wie er RAM strecken kann
- Eine teure CPU mit unterdimensionierter GPU — GPU und VRAM entscheiden über die Inferenzgeschwindigkeit weit mehr als die CPU-Taktrate
- Eine SATA-SSD für eine neue KI-Workstation — das Modell-Laden ist 5x langsamer als bei PCIe-Gen-4-NVMe, für einen Unterschied von 20–40 € bei einem Mehrtausend-Euro-Build
- Ein unterdimensioniertes Netzteil — die Profi-Stufe erreicht Spitzen nahe 900 W; ein billiges 750-W-Netzteil bricht unter Dual-GPU-Dauerlast ein
- 32 GB RAM für ernsthaftes 70B-CPU-Offloading — das Modell selbst braucht bereits ~40 GB nur um im Speicher zu liegen
Workstation bauen oder Cloud-GPUs mieten?
Lokale Workstation vs. Cloud-GPU-Miete
Lokales LLM nutzen, wenn:
- •Du nutzt lokale Modelle 2+ Stunden/Tag
- •Datenschutz oder Datenresidenz sind für deinen Workload wichtig
- •Du willst feste, planbare Langzeitkosten
- •Du hast dich bereits für eine Stufe oben entschieden
Cloud-Modell nutzen, wenn:
- •Du nutzt lokale Modelle unter 1 Stunde/Tag
- •Dein Workload ist gelegentlich oder stoßweise (Batch-Jobs, Tests)
- •Du willst keine Hardware-Wartung
- •Du willst ein 70B+-Modell testen, bevor du in Hardware investierst
Schnelle Entscheidung:
- →Intensive tägliche Nutzung → Workstation bauen (siehe Stufentabellen oben)
- →Gelegentliche/Test-Nutzung → Cloud-GPUs mieten
- →Unsicher? Siehe die Amortisationstabelle weiter unten
- →Cloud-GPU-Anbieter vergleichen →
Software-Stack für jeden Build
Sobald die Hardware aufgebaut ist, läuft Ollama in unter 10 Minuten:
- 1Ubuntu 22.04 LTS oder Windows 11 installieren (Ubuntu bevorzugt für CUDA-Stabilität)
- 2NVIDIA-Treiber 550+ von nvidia.com installieren oder
ubuntu-drivers autoinstallausführen - 3Ollama installieren:
curl -fsSL https://ollama.com/install.sh | sh - 4Ein Modell laden:
ollama pull qwen2.5:14b-instruct-q8_0 - 5Als Netzwerkserver ausführen:
OLLAMA_HOST=0.0.0.0 ollama serve - 6Open WebUI für die Browser-Oberfläche installieren:
docker run -d -p 3000:8080 --gpus all ghcr.io/open-webui/open-webui:cuda - 7Über Tailscale für sicheren Fernzugriff von jedem Gerät freigeben
Leistungsvergleich aller drei Builds
Die Hardware-Leistung ist unverändert gegenüber früheren 2026-Messungen — nur die Preise haben sich geändert.
Modell + Quant | Budget (~2.500 €) | Empfohlen (~4.950 €) | Profi (~8.200 €) |
|---|---|---|---|
| Llama 3.1 8B Q4 | 55–70 Tok/s | 105–125 Tok/s | 120–140 Tok/s |
| Qwen3 14B Q8 | 20–28 Tok/s | 48–60 Tok/s | 55–70 Tok/s |
| Qwen3 32B Q4 | 12–18 Tok/s | 28–38 Tok/s | 40–55 Tok/s |
| Llama 3.3 70B Q4 | 5–8 Tok/s (CPU) | 10–15 Tok/s (CPU) | 25–40 Tok/s (GPU) |
| Mixtral 8x22B Q4 | 15–22 Tok/s | 32–45 Tok/s | 45–60 Tok/s |
Gesamtbetriebskosten: Workstation vs. Cloud-GPU
Die Hardwarekosten des Empfohlenen Builds stiegen seit Mai 2026 um ~29% (RAM und Speicher, nicht die GPU) — die Amortisation gegenüber Cloud-Miete verändert sich entsprechend. Unten: Hardware + geschätzter Stromverbrauch vs. RunPod-A40-Miete (0,44 $/Std.) bei drei Nutzungsniveaus, für den Empfohlenen Build (~4.950 €).
Nutzung | Cloud-Kosten/Jahr (A40 @ 0,44 $/Std.) | Stromkosten Workstation/Jahr | Amortisation vs. Cloud |
|---|---|---|---|
| 2 Std./Tag | ~300 € | ~88 € (@0,30 €/kWh) | ~19 Jahre — Cloud gewinnt |
| 4 Std./Tag | ~600 € | ~176 € | ~11,7 Jahre |
| 8 Std./Tag | ~1.200 € | ~352 € | ~5,8 Jahre |
Bei den 2026 gestiegenen Hardwarepreisen gewinnt die Workstation die reine Kostenrechnung erst ab ~8 Std./Tag klar — darunter ist Cloud-Miete finanziell günstiger, auch wenn die A40 (Ampere-Generation) langsamer ist als eine RTX 4090. Datenschutz, Datenresidenz und Unabhängigkeit von Cloud-Verfügbarkeit sind eigenständige Gründe für lokal, unabhängig von der Amortisationszeit. Strompreis angenommen mit 0,30 €/kWh (EU-Durchschnitt).
Sollte ich eine Workstation bauen oder Cloud-GPUs mieten?
Bei regelmäßiger Nutzung (6+ Stunden/Tag): Workstation bauen. Eine A40 48 GB auf RunPod kostet 0,44 $/Stunde — bei 4 Stunden/Tag sind das ~600 €/Jahr. Bei den 2026 gestiegenen Hardwarepreisen amortisiert sich der ~4.950-€-Build erst nach ~12 Jahren bei 4 Std./Tag, oder unter 6 Jahren bei 8 Std./Tag. Bei gelegentlicher Nutzung (unter 2 Stunden/Tag) ist Cloud günstiger.
Warum kostet dieser Build so viel mehr als andere 2026er-Ratgeber angeben?
RAM und NVMe-Speicher, nicht die GPU. Ein DDR5/NAND-Engpass 2026 — Speicherhersteller verlagerten Fertigungskapazität zu KI-Rechenzentrums-HBM-Chips — ließ 64-GB-DDR5-Kit-Preise von ~145 € im Mai 2026 auf ~800 € im August steigen, und 4-TB-NVMe-Laufwerke von ~200 € auf ~700–800 €. GPU-Preise sind im gleichen Zeitraum dagegen stabil bis leicht gefallen.
Sollte ich für den Budget- oder Profi-Build eine gebrauchte oder neue RTX 3090 kaufen?
Gebraucht ist 2026 die Standardwahl bei der RTX 3090 — die Produktion endete 2022, "neue" Einheiten sind lediglich ältere Restbestände zum Aufpreis. Gebrauchte Karten kosten 650–950 €; auf übermäßige Lüftergeräusche oder Brandgeruch unter Last achten (Zeichen von Mining-Verschleiß) und einen Verkäufer mit Rückgaberecht bevorzugen.
Brauche ich NVLink für Ollama mit zwei GPUs?
Nein. Ollama nutzt CUDA Tensor-Parallelismus über PCIe — kein NVLink nötig. Das Dual-RTX-3090-Setup funktioniert vollständig ohne NVLink.
Warum Dual RTX 3090 statt einer RTX 4090 für den Profi-Build?
VRAM ist entscheidend. Zwei RTX 3090s ergeben 48 GB gesamt — genug für Llama 3.3 70B Q4 (~40 GB). Eine einzelne RTX 4090 hat nur 24 GB. Für 70B-Inferenz auf GPU gewinnen die Dual-3090s beim VRAM/Euro-Verhältnis.
Sinnvolle Upgrades, wenn du wachsen willst
Drei Upgrades lohnen sich, wenn du deine Stufe innerhalb eines Jahres wahrscheinlich sprengst:
- RAM: 64 GB → 128 GB — nützlich für CPU-offgeloadete 70B-Modelle auf der Empfohlenen Stufe, hebt die Offload-Geschwindigkeit von ~10–15 auf ~15–20 Tok/s
- Speicher: 2 TB → 4 TB — nützlich, wenn du mehr als 3–4 große Modelle gleichzeitig vorhältst
- Kühlung: 240mm → 360mm AIO — zählt besonders bei der Empfohlenen und Profi-Stufe, wo mehrstündige Inferenz GPU und CPU länger unter Volllast hält als Gaming
Welche Workstation solltest du kaufen?
Immer noch unsicher? Starte mit dem Empfohlenen RTX-4090-Build — er bietet die beste Balance aus Leistung, VRAM, Stromverbrauch und Aufrüstbarkeit für die meisten lokalen KI-Nutzer.
💰 Unter 3.000 € — Budget-Build
~2.500 € · RTX 3090 24GB
Läuft jedes Modell bis 32B Q4 vollständig auf GPU. Am besten bei begrenztem Budget und Bereitschaft für eine gebrauchte GPU.
⭐ Beste Gesamtlösung — Empfohlener Build
~4.950 € · RTX 4090 24GB
Die beste Balance aus Leistung, VRAM, Stromverbrauch und Aufrüstpotenzial für die meisten Nutzer. Bei Unsicherheit hier starten.
🚀 70B / Profi — Profi-Build
~8.200 € · Dual RTX 3090 (48GB)
GPU-Tempo-70B-Inferenz (25–40 Tok/s). Nur kaufen, wenn 70B dein täglicher Hauptworkload ist.
Weiterführende Artikel
- Beste GPU für lokale LLMs 2026 -- GPU-Kaufratgeber für jede Workstation-Stufe
- Beste lokale KI-App für schwache PCs -- Software-Optionen, wenn Sie noch keine vollständige Workstation bereit haben
- Bester Mac für lokale KI 2026 -- Apple Silicon als Alternative zur GPU-Workstation
- Die besten Laptops für lokale LLMs: Kaufberatung 2026 -- mobile Optionen vor dem Kauf einer Workstation
- Qwen Lokales Deployment: Vollständiger Produktionsleitfaden 2026 -- Produktions-Deployment nach dem Aufbau Ihrer Workstation