重要なポイント
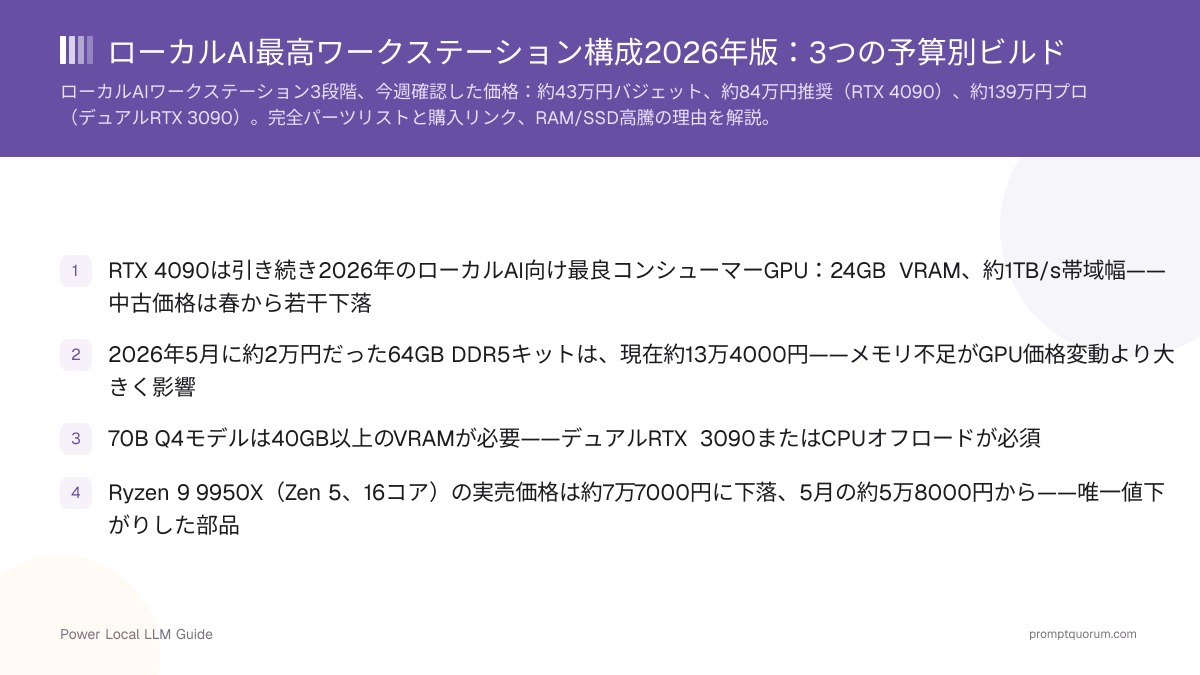
- RTX 4090は引き続き2026年のローカルAI向け最良コンシューマーGPU:24GB VRAM、約1TB/s帯域幅——中古価格は春から若干下落
- 2026年5月に約2万円だった64GB DDR5キットは、現在約13万4000円——メモリ不足がGPU価格変動より大きく影響
- 70B Q4モデルは40GB以上のVRAMが必要——デュアルRTX 3090またはCPUオフロードが必須
- Ryzen 9 9950X(Zen 5、16コア)の実売価格は約7万7000円に下落、5月の約5万8000円から——唯一値下がりした部品
- PCIe Gen 4/5 NVMeは7Bモデルを2秒未満でロードするが、4TB Gen 5ドライブは現在約12万6000円、以前は約2万8000円
- 第1・2段階はAM5ソケットを共有——マザーボード交換なしでGPU/RAMを後でアップグレード可能;第3段階はTRX50が必要
どのワークステーションを構築すべきか?
実際に必要な最大モデルサイズで選ぶ:7B〜14B→バジェット。14B〜32B→推奨。70B→プロ。以下は2026年8月25日確認のシステム総額。
バジェット | 推奨 | プロ | |
|---|---|---|---|
| 価格 | 約43万円 | 約84万円 | 約139万円 |
| GPU | RTX 3090 24GB(中古) | RTX 4090 24GB | 2× RTX 3090(48GB) |
| CPU | Ryzen 7 7700X | Ryzen 9 9950X | Threadripper 7960X |
| RAM | 64GB DDR5 | 64GB DDR5-6000 | 256GB DDR5 ECC |
| 最大モデル | 32B Q4をGPUで | 30B Q4 GPU/70Bオフロード | 70B Q4をGPU速度で |
| 最適な用途 | バジェット重視、7B〜14B | 大多数のユーザー、14B〜32B | 70Bワークロード、複数ユーザー |
以下の合計はどれも他所で2026年に引用された価格より高くなっています——これはDDR5/NAND不足によるもので、誤りではありません(段階別テーブルの後の注記参照)。GPU価格はむしろ春から横ばいか下落しています。
広告
編集部のおすすめ:RTX 4090推奨ワークステーション
2026年の総合ベストなローカルAIワークステーション——最も幅広いモデルに対応するVRAM・拡張余地・価格のバランス点。
- 24GB VRAM——32B Q4までのモデルを完全にGPU上で実行
- 64GB DDR5-6000——CPUオフロードで70Bも10〜15 tok/sで対応
- Qwen3 32B Q4を28〜38 tok/sで完全GPU実行;70Bもオフロード対応
- 約84万円の完全システム、2026年8月25日確認
- 該当する場合はスキップ: 7B〜14Bモデルしか使わないなら、バジェット構成で約41万円節約しつつ同等の性能
VRAMが構成を決める——モデルサイズとハードウェアの対応
どの段階が必要かわからない?「いつか使うかもしれない」ではなく「実際に使う予定の最大モデル」から選ぶ。
モデルサイズ | 推奨VRAM | 最適な構成 |
|---|---|---|
| 7B | 8〜12GB | バジェット(RTX 3090で十分な余裕) |
| 14B | 16〜24GB | バジェットまたは推奨 |
| 32B Q4 | 約20〜24GB | 推奨(RTX 4090) |
| 70B Q4 | 約40GB以上 | プロ(デュアルRTX 3090)または推奨でオフロード |
| 70B Q8 | 約70GB以上 | マルチGPUのみ——GPU購入ガイド参照 |
フルビルドではなくGPU単体が知りたい場合はGPU購入ガイドを参照。
第1段階:約43万円バジェットAIワークステーション
バジェットビルドは中古RTX 3090(24GB VRAM)を中心に構成。Llama 3.1 8B Q8を45〜60 tok/s、Qwen3 14B Q8を20〜28 tok/s、Qwen3 32B Q4を12〜18 tok/sでGPUのみで動作。この構成を選ぶべき場合: 予算が45万円未満、主に7B〜32Bモデルを使う、中古GPUに抵抗がない。避けるべき場合: 70Bが主用途——このクラスのCPUオフロードは5〜8 tok/sで機能はするが遅い。
- フルGPU速度対応モデル: 7B(全量子化)、13B、14B Q4/Q8、30B Q4
- 70Bサポート: CPUオフロード必要 — 約5〜8 tok/s
- 最大消費電力: 約450W
コンポーネント | モデル | 価格 |
|---|---|---|
| GPU | NVIDIA RTX 3090(中古、24GB) | 約13万4000円 |
| CPU | AMD Ryzen 7 7700X | 約3万5000円 |
| マザーボード | MSI MAG X670E Tomahawk WiFi | 約3万円 |
| RAM | 64GB DDR5-5600(2×32GB) | 約13万4000円(5月は約1万5000円) |
| ストレージ | 2TB PCIe Gen 4 NVMe | 約5万5000円(5月は約1万2000円) |
| 電源 | 850W 80+ゴールド | 約1万7000円 |
| ケース | ミドルタワーATX | 約1万3000円 |
| CPUクーラー | 240mm AIOまたはタワー | 約1万1000円 |
| 合計 | 約42万9000円 |
💡ヒント: 中古 vs 新品:中古RTX 3090(eBayで約11万〜16万円)は残り少ない新品より30〜50%安いが、保証は不確実。返品可能な販売者を選び、マイニング使用の痕跡(ファン異音など)を確認すること。
第2段階:約84万円推奨AIワークステーション
推奨ビルドはRTX 4090(24GB、約1TB/sメモリ帯域幅)とAMD Ryzen 9 9950X(Zen 5、16コア)を中心に構成。4090は3090よりVRAM単位で30〜40%高速で、トークンあたりの消費電力も低い。この構成を選ぶべき場合: 最良のシングルGPU構成が欲しい、14B〜32Bモデルを日常的に使う、70Bを時々オフロードで動かしたい。避けるべき場合: 70Bが日常の主用途——その場合はプロ構成でGPU速度の70Bを。
- 7B Q4速度: 約105〜125 tok/s
- 14B Q8速度: 約48〜60 tok/s
- 30B Q4速度: 約28〜38 tok/s
- 70B Q4(CPUオフロード): 約10〜15 tok/s(64GB RAM時)
- 最大消費電力: 約550W
コンポーネント | モデル | 価格 |
|---|---|---|
| GPU | NVIDIA GeForce RTX 4090 24GB | 約34万8000円 |
| CPU | AMD Ryzen 9 9950X(16C/32T、Zen 5) | 約7万7000円(5月は約5万8000円) |
| マザーボード | ASUS ProArt X870E-Creator WiFi | 約8万2000円 |
| RAM | 64GB DDR5-6000 CL30(2×32GB) | 約14万2000円(5月は約2万円) |
| ストレージ | 4TB PCIe Gen 5 NVMe | 約12万6000円(5月は約2万8000円) |
| 電源 | 1000W 80+プラチナ | 約2万8000円 |
| ケース | フルタワーATX | 約2万2000円 |
| CPUクーラー | 360mm AIO | 約1万7000円 |
| 合計 | 約84万2000円 |
第3段階:約139万円プロ70Bワークステーション
デュアルRTX 3090(合計48GB VRAM)でGPU速度(25〜40 tok/s)の70Bモデル推論を実現。Ryzen Threadripper 7960X(24コア)と256GB DDR5 ECCで大型レイヤーのCPUオフロードも高速化。この構成を選ぶべき場合: 70Bが主用途、48GB以上のGPU VRAMが必要、複数ユーザーが同時利用。避けるべき場合: 32Bを超えるモデルを使ったことがない——その場合は明らかにオーバースペック。
- 70B Q4速度: 25〜40 tok/s(両RTX 3090でテンソル並列処理)
- 256GB RAM CPUオフロード: 140B以上を4〜6 tok/sで実行
- 最大消費電力: 約900W
コンポーネント | モデル | 価格 |
|---|---|---|
| GPU ×2 | 2× NVIDIA RTX 3090 24GB(中古) | 約26万9000円 |
| CPU | AMD Ryzen Threadripper 7960X(24C) | 約22万1000円(変動大——15万〜35万円の幅) |
| マザーボード | ASUS Pro WS TRX50-SAGE WiFi | 約12万6000円 |
| RAM | 256GB DDR5-5200 ECC(8×32GB) | 約44万2000円(5月は約9万1000円——購入前に要確認) |
| ストレージ | 8TB PCIe Gen 4 NVMe(2×4TB) | 約22万1000円(5月は約5万円) |
| 電源 | 1600W プラチナ | 約5万5000円 |
| ケース | フルタワーHEDT ATX | 約3万5000円 |
| CPUクーラー | 360mm AIO + 追加ファン | 約2万4000円 |
| 合計 | 約139万3000円 |
⚠️注意: 2026年のDDR5不足はECC/RDIMMサーバーメモリに最も強く影響——256GB DDR5 ECCキットは希少かつ価格変動が激しい。注文前にマザーボードのQVL掲載RAMのリアルタイム見積もりを取得すること。上記は確認済みの推定値であり保証価格ではない。
この用途では買わないハードウェア
- 32Bモデルが目標なのに8GB GPU — 即座にVRAMの壁に当たる。RAMを伸縮できるようにGPUの容量不足を補うトリックはない
- 高価なCPUと容量不足のGPUの組み合わせ — 推論速度を決めるのはGPUとVRAMであり、CPUクロックではない
- 新規AIワークステーションにSATA SSD — モデルロードがPCIe Gen 4 NVMeより5倍遅く、差額はわずか3000〜6000円
- 容量不足の電源 — プロ構成は約900Wに達する。安価な750W電源はデュアルGPU連続稼働で不安定になる
- 本格的な70B CPUオフロードに32GB RAM — モデル自体がメモリに載るだけで約40GB必要
ワークステーションを構築すべきか、クラウドGPUを借りるべきか?
ローカルワークステーション vs クラウドGPUレンタル
ローカルLLMを使うべき場合:
- •ローカルモデルを1日2時間以上使用する
- •プライバシーやデータ所在地が重要
- •固定で予測可能な長期コストを望む
- •既に上記のいずれかの構成に決めている
クラウドモデルを使うべき場合:
- •ローカルモデルを1日1時間未満しか使わない
- •利用が散発的・バースト的(バッチ処理、テストなど)
- •ハードウェア保守をしたくない
- •ハードウェア投資前に70B以上のモデルを試したい
クイック判断:
- →毎日ヘビーに使う → ワークステーションを構築(上記段階別テーブル参照)
- →散発的・評価目的の利用 → クラウドGPUをレンタル
- →迷ったら → 下の元本回収期間テーブルを参照
- →クラウドGPUプロバイダーを比較 →
どの構成でも使えるソフトウェアスタック
ハードウェア組み立て後、Ollamaを起動するまで10分もかかりません:
- 1Ubuntu 22.04 LTSまたはWindows 11をインストール(CUDA安定性のためUbuntu推奨)
- 2nvidia.comから、または
ubuntu-drivers autoinstallでNVIDIAドライバー550+をインストール - 3Ollamaをインストール:
curl -fsSL https://ollama.com/install.sh | sh - 4モデルを取得:
ollama pull qwen2.5:14b-instruct-q8_0 - 5ネットワークサーバーとして実行:
OLLAMA_HOST=0.0.0.0 ollama serve - 6ブラウザUI用にOpen WebUIをインストール:
docker run -d -p 3000:8080 --gpus all ghcr.io/open-webui/open-webui:cuda - 7Tailscale経由で公開し、あらゆるデバイスから安全にリモートアクセス
3つの構成すべての性能比較
ハードウェア性能は2026年初頭の測定値と変わりません——変わったのは価格だけです。
モデル + 量子化 | バジェット(約43万円) | 推奨(約84万円) | プロ(約139万円) |
|---|---|---|---|
| Llama 3.1 8B Q4 | 55–70 tok/s | 105–125 tok/s | 120–140 tok/s |
| Qwen3 14B Q8 | 20–28 tok/s | 48–60 tok/s | 55–70 tok/s |
| Qwen3 32B Q4 | 12–18 tok/s | 28–38 tok/s | 40–55 tok/s |
| Llama 3.3 70B Q4 | 5–8 tok/s (CPU) | 10–15 tok/s (CPU) | 25–40 tok/s (GPU) |
| Mixtral 8x22B Q4 | 15–22 tok/s | 32–45 tok/s | 45–60 tok/s |
総所有コスト:ワークステーション vs クラウドGPU
推奨構成のハードウェアコストは2026年5月から約29%上昇しました(RAMとストレージが原因で、GPUではない)——クラウドレンタルとの投資回収期間もそれに伴い変化しました。
利用状況 | クラウド年間コスト(A40 @$0.44/時) | ワークステーション年間電気代 | クラウド比の回収期間 |
|---|---|---|---|
| 1日2時間 | 約4万7000円 | 約6600円(@22円/kWh) | 約19年——クラウドが有利 |
| 1日4時間 | 約9万3000円 | 約1万3000円 | 約12年 |
| 1日8時間 | 約18万7000円 | 約2万6000円 | 約6年 |
2026年の高騰したハードウェア価格では、純粋なコスト計算でワークステーションが明確に有利になるのは1日6時間以上の利用からです。それ未満ではクラウドレンタルの方が経済的です。プライバシーとクラウド可用性への非依存は、回収期間とは別の理由でローカルを選ぶ根拠になります。
ワークステーションを自作するべきか、クラウドGPUを借りるべきか?
定期利用(1日6時間以上)の場合:ワークステーションを構築。RunPodのA40 48GBは1時間0.44ドル——1日4時間で年間約9万3000円。2026年の高騰した価格では、約84万円の推奨構成は1日4時間利用で回収に約12年、1日8時間なら6年未満です。偶発的な利用(1日2時間未満)の場合:クラウドが安い。
なぜこの構成は他の2026年版ガイドより高いのですか?
GPUではなくRAMとNVMeストレージが原因です。メーカーがAIデータセンター向けHBMチップに製造能力を振り向けたことによる2026年のDDR5/NAND不足で、64GB DDR5キットは2026年5月の約2万円から8月には約13万4000円に、4TB NVMeドライブは約2万8000円から約12万6000円に上昇しました。GPU価格は同期間、横ばいか若干の下落です。
バジェット・プロ構成用のRTX 3090は中古と新品どちらを買うべきですか?
2026年時点では中古が標準的な選択です——生産は2022年に終了しており、「新品」は割高な旧在庫に過ぎません。中古カードは約11万〜16万円で、負荷時の異音や焦げ臭さ(マイニング使用の兆候)を確認し、返品可能な販売者を選んでください。
OllamaをデュアルGPUで動かすためにNVLinkは必要ですか?
いいえ。OllamaはPCIe経由のCUDAテンソル並列処理を使用します——NVLinkは不要。デュアルRTX 3090のセットアップはNVLinkなしで完全に動作します。
プロビルドにRTX 4090の代わりにデュアルRTX 3090を使う理由は?
VRAMが決め手です。2枚のRTX 3090で合計48GB——Llama 3.3 70B Q4(約40GB)を収容できます。単体のRTX 4090は24GBのみ——70BはCPUオフロードなしでは収まりません。GPU速度での70B推論にはデュアル3090がVRAM/円で優れています。
成長を見込むなら価値あるアップグレード
1年以内に現在の段階を超えると予想されるなら、次の3つが投資価値あり:
- RAM:64GB→128GB — 推奨構成でのCPUオフロード70Bに有用、オフロード速度を約10〜15から約15〜20 tok/sへ
- ストレージ:2TB→4TB — 大型モデルを3〜4個以上常時保持するなら有用
- 冷却:240mm→360mm AIO — 推奨・プロ構成で特に重要(長時間の推論負荷)
どのワークステーションを買うべきか?
まだ迷っていますか?推奨RTX 4090構成から始めましょう——大多数のローカルAIユーザーにとって性能・VRAM・消費電力・拡張性の最良のバランスです。
💰 45万円未満 — バジェット構成
約43万円 · RTX 3090 24GB
32B Q4までのモデルを完全にGPUで実行。予算重視で中古GPUに抵抗がない人向け。
🚀 70B/プロ — プロ構成
約139万円 · デュアルRTX 3090(48GB)
GPU速度の70B推論(25〜40 tok/s)。70Bが日常の主用途の場合のみ購入。
関連記事
- ローカルLLM最適GPU購入ガイド2026 -- 各ワークステーション段階向けGPU購入ガイド
- 低スペックPCでもAIを動かす最高のローカルAIアプリ -- フルワークステーションに踏み切る前のソフトウェア選択肢
- ローカルAI向け最高のMac 2026 -- GPU ワークステーションに代わるApple Silicon選択肢
- ローカルLLM向けノートパソコンのおすすめ:購入ガイド2026 -- ワークステーション購入前のモバイル選択肢
- Qwenローカルデプロイ完全ガイド2026:Docker・APIサーバー・マルチGPU -- ワークステーション構築後の本番環境デプロイ