Points clés
- RTX 4090 reste la meilleure GPU grand public pour l'IA locale en 2026 : 24 Go VRAM, ~1 To/s de bande passante — son prix d'occasion a même légèrement baissé depuis le printemps
- Un kit DDR5 64 Go qui coûtait ~145 € en mai 2026 coûte ~800 € aujourd'hui — la pénurie mémoire 2026 pèse plus sur le budget que la variation du prix GPU
- Les modèles 70B Q4 ont besoin de 40+ Go VRAM — nécessite dual RTX 3090 ou déchargement CPU
- Le prix du Ryzen 9 9950X (Zen 5, 16 cœurs) a baissé à ~455 €, contre ~485 € en mai — le seul composant devenu moins cher
- NVMe PCIe Gen 4/5 charge un modèle 7B en moins de 2 secondes, mais un SSD Gen 5 4 To coûte désormais ~745 €, contre ~200 € auparavant
- Les niveaux 1 et 2 partagent le socket AM5 — GPU/RAM évolutifs sans changer de carte mère ; le niveau 3 nécessite un TRX50
Quelle workstation construire ?
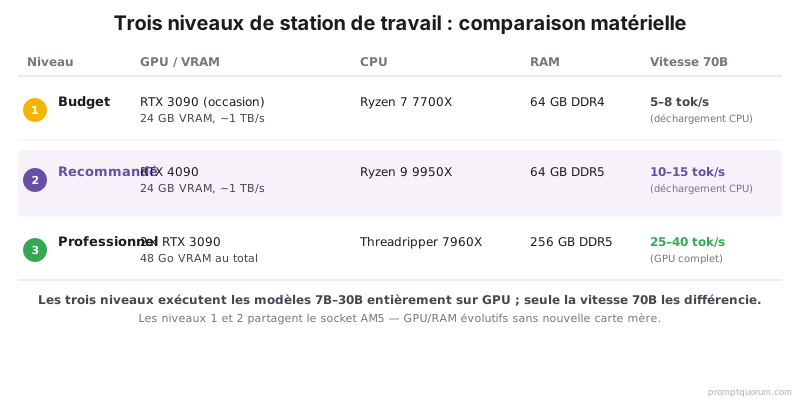
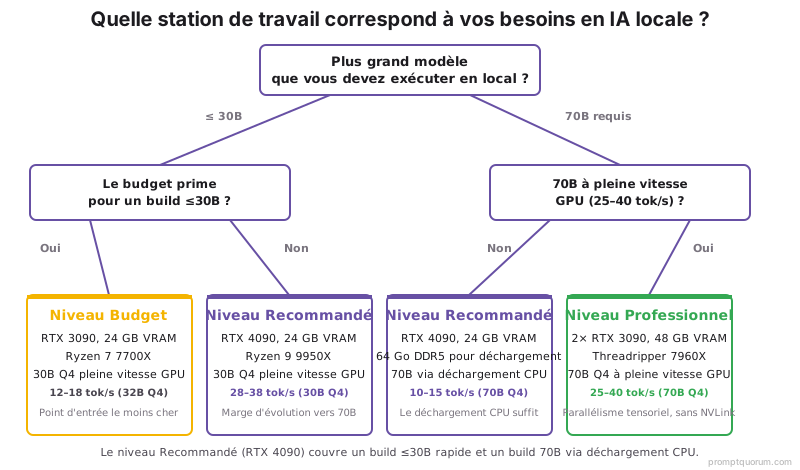
Choisissez votre build selon le plus grand modèle à faire tourner : 7B–14B → Budget. 14B–32B → Recommandé. 70B → Professionnel. Prix ci-dessous : système complet, vérifiés au 25 août 2026.
Budget | Recommandé | Professionnel | |
|---|---|---|---|
| Prix | ~2 500 € | ~4 950 € | ~8 200 € |
| GPU | RTX 3090 24 Go (occasion) | RTX 4090 24 Go | 2× RTX 3090 (48 Go) |
| CPU | Ryzen 7 7700X | Ryzen 9 9950X | Threadripper 7960X |
| RAM | 64 Go DDR5 | 64 Go DDR5-6000 | 256 Go DDR5 ECC |
| Modèle max | 32B Q4 sur GPU | 30B Q4 GPU / 70B offload | 70B Q4 à vitesse GPU |
| Idéal pour | Budget serré, 7B–14B | La plupart des usages, 14B–32B | Charges 70B, multi-utilisateurs |
Chaque total ci-dessous dépasse les prix cités ailleurs en 2026 — c'est la pénurie DDR5/NAND (voir l'encart après les tableaux de niveaux), pas une erreur. Les prix GPU, eux, sont stables voire en légère baisse.
Publicité
Choix de la rédaction : Workstation Recommandée RTX 4090
La meilleure workstation IA locale globale pour 2026 — le point d'équilibre entre VRAM, marge d'évolution et prix pour la plus large gamme de modèles.
- 24 Go VRAM — fait tourner tout modèle jusqu'à 32B Q4 entièrement sur GPU
- 64 Go DDR5-6000 — suffisant pour du 70B via déchargement CPU à 10–15 tok/s
- Qwen3 32B Q4 entièrement sur GPU à 28–38 tok/s ; 70B avec déchargement
- ~4 950 € en système complet, vérifié au 25 août 2026
- À éviter si : vous ne faites tourner que du 7B–14B — le build Budget économise ~2 450 € pour le même usage
La VRAM détermine votre build
Pas sûr du niveau qu'il vous faut ? Partez du plus grand modèle que vous comptez réellement utiliser.
Taille modèle | VRAM recommandée | Meilleur build |
|---|---|---|
| 7B | 8–12 Go | Budget (large marge sur RTX 3090) |
| 14B | 16–24 Go | Budget ou Recommandé |
| 32B Q4 | ~20–24 Go | Recommandé (RTX 4090) |
| 70B Q4 | ~40 Go+ | Professionnel (dual RTX 3090) ou offload sur Recommandé |
| 70B Q8 | ~70 Go+ | Multi-GPU uniquement — voir notre guide GPU |
Juste une GPU seule (hors build complet) ? Voir notre guide d'achat GPU.
Niveau 1 : ~2 500 € Workstation IA budget
Le build budget utilise une RTX 3090 occasion (24 Go VRAM). Il fait tourner Llama 3.1 8B Q8 à 45–60 tok/s, Qwen3 14B Q8 à 20–28 tok/s et Qwen3 32B Q4 à 12–18 tok/s entièrement sur GPU. Prenez ce build si : votre budget est sous 3 000 €, vous utilisez surtout du 7B–32B, et l'achat d'occasion ne vous gêne pas. Évitez si : le 70B est votre usage principal — le déchargement CPU sur ce niveau tourne à 5–8 tok/s, fonctionnel mais lent.
- Modèles supportés à pleine vitesse GPU : 7B, 13B, 14B Q4/Q8, 30B Q4
- Support 70B : déchargement CPU nécessaire — ~5–8 tok/s
- Consommation crête : ~450 W
Composant | Modèle | Prix (août 2026) |
|---|---|---|
| GPU | NVIDIA RTX 3090 (occasion, 24 Go) | ~790 € |
| CPU | AMD Ryzen 7 7700X | ~200 € |
| Carte mère | MSI MAG X670E Tomahawk WiFi | ~175 € |
| RAM | 64 Go DDR5-5600 (2×32 Go) | ~790 € (mai : ~110 €) |
| Stockage | 2 To PCIe Gen 4 NVMe | ~325 € (mai : ~90 €) |
| Alimentation | 850 W 80+ Gold | ~100 € |
| Boîtier | Tour ATX, 3+ emplacements ventilateurs | ~75 € |
| Ventirad CPU | AIO 240mm ou tour | ~65 € |
| Total | ~2 520 € |
💡Astuce: Occasion vs neuf : les cartes RTX 3090 d'occasion (~650–950 € sur eBay.fr) coûtent 30–50% de moins que le peu de neuf restant, au prix d'une garantie incertaine. Privilégiez un vendeur acceptant les retours et vérifiez l'absence d'usure minage.
Niveau 2 : ~4 950 € Workstation IA recommandée
Le build recommandé est centré sur la RTX 4090 (24 Go, ~1 To/s de bande passante mémoire) avec l'AMD Ryzen 9 9950X (Zen 5, 16 cœurs). La 4090 est 30–40% plus rapide que la 3090 par Go de VRAM. Prenez ce build si : vous voulez la meilleure workstation mono-GPU, utilisez du 14B–32B régulièrement, et déchargez occasionnellement du 70B. Évitez si : le 70B est votre usage quotidien principal — préférez le Professionnel pour de la vitesse GPU sur 70B.
- 7B Q4 : ~105–125 tok/s
- 14B Q8 : ~48–60 tok/s
- 30B Q4 : ~28–38 tok/s
- 70B Q4 (déchargement CPU) : ~10–15 tok/s avec 64 Go RAM
Composant | Modèle | Prix (août 2026) |
|---|---|---|
| GPU | NVIDIA GeForce RTX 4090 24 Go | ~2 050 € |
| CPU | AMD Ryzen 9 9950X (16C/32T, Zen 5) | ~455 € (mai : ~420 €) |
| Carte mère | ASUS ProArt X870E-Creator WiFi | ~485 € |
| RAM | 64 Go DDR5-6000 CL30 (2×32 Go) | ~835 € (mai : ~145 €) |
| Stockage | 4 To PCIe Gen 5 NVMe | ~745 € (mai : ~200 €) |
| Alimentation | 1000 W 80+ Platinum | ~165 € |
| Boîtier | Grande tour ATX | ~130 € |
| Ventirad CPU | AIO 360mm | ~100 € |
| Total | ~4 965 € |
Niveau 3 : ~8 200 € Workstation 70B professionnelle
Le build professionnel vise l'inférence 70B à vitesse GPU (25–40 tok/s) avec deux RTX 3090 pour 48 Go VRAM au total, plus un Threadripper 7960X (24 cœurs) et 256 Go DDR5 ECC. Prenez ce build si : le 70B est votre usage principal, vous avez besoin de 48 Go+ de VRAM GPU, ou plusieurs utilisateurs simultanés. Évitez si : vous n'avez jamais utilisé de modèle au-delà de 32B — ce niveau est alors largement surdimensionné.
- 70B Q4 : 25–40 tok/s (les deux RTX 3090 via parallélisme tensoriel)
- Déchargement CPU 256 Go : modèles 140B+ à 4–6 tok/s
- Consommation crête : ~900 W
Composant | Modèle | Prix (août 2026) |
|---|---|---|
| GPU ×2 | 2× NVIDIA RTX 3090 24 Go (occasion) | ~1 580 € |
| CPU | AMD Ryzen Threadripper 7960X (24C) | ~1 300 € (volatil — 950–2 300 € observés) |
| Carte mère | ASUS Pro WS TRX50-SAGE WiFi | ~745 € |
| RAM | 256 Go DDR5-5200 ECC (8×32 Go) | ~2 600 € (mai : ~650 € — vérifier avant achat) |
| Stockage | 8 To PCIe Gen 4 NVMe (2×4 To) | ~1 300 € (mai : ~360 €) |
| Alimentation | 1600 W Platinum | ~325 € |
| Boîtier | Grande tour HEDT ATX | ~205 € |
| Ventirad CPU | AIO 360mm + ventilateurs supplémentaires | ~140 € |
| Total | ~8 195 € |
⚠️Attention: La pénurie DDR5 2026 a le plus touché la RAM serveur ECC/RDIMM — les kits DDR5 ECC 256 Go sont rares et volatils. Obtenez un devis en direct pour de la RAM listée QVL par votre carte mère avant de commander.
Le matériel que nous n'achèterions pas pour cet usage
- Une GPU 8 Go si l'objectif est du 32B — mur de VRAM immédiat, aucun déchargement CPU ne compense une carte sous-dimensionnée aussi bien qu'il étire la RAM
- Un CPU cher avec une GPU sous-dimensionnée — la GPU et sa VRAM décident de la vitesse d'inférence bien plus que la fréquence CPU
- Un SSD SATA pour une nouvelle workstation IA — chargement 5x plus lent qu'un NVMe Gen 4 pour 20–40 € d'écart
- Une alimentation sous-dimensionnée — le niveau Professionnel culmine près de 900 W ; une 750 W bas de gamme décrochera en charge dual-GPU
- 32 Go de RAM pour du déchargement CPU 70B sérieux — le modèle seul a besoin d'environ 40 Go pour tenir en mémoire
Construire une workstation ou louer des GPU cloud ?
Workstation locale vs location GPU cloud
Utilisez un LLM local si :
- •Vous utilisez des modèles locaux 2h+/jour
- •La confidentialité ou la résidence des données compte pour votre usage
- •Vous voulez un coût fixe et prévisible sur le long terme
- •Vous êtes déjà décidé sur un niveau ci-dessus
Utilisez un modèle cloud si :
- •Vous utilisez des modèles locaux moins d'1h/jour
- •Votre usage est occasionnel ou ponctuel (tests, batch)
- •Vous ne voulez pas gérer la maintenance matérielle
- •Vous voulez tester un modèle 70B+ avant d'investir
Décision rapide :
- →Usage quotidien intensif → construire la workstation (voir tableaux ci-dessus)
- →Usage occasionnel/test → louer des GPU cloud
- →Pas sûr ? Voir le tableau d'amortissement ci-dessous
- →Comparer les fournisseurs de GPU cloud →
Stack logiciel pour n'importe quel build
Une fois le matériel assemblé, Ollama est opérationnel en moins de 10 minutes :
- 1Installer Ubuntu 22.04 LTS ou Windows 11 (Ubuntu préféré pour la stabilité CUDA)
- 2Installer les pilotes NVIDIA 550+ depuis nvidia.com ou via
ubuntu-drivers autoinstall - 3Installer Ollama :
curl -fsSL https://ollama.com/install.sh | sh - 4Récupérer un modèle :
ollama pull qwen2.5:14b-instruct-q8_0 - 5Lancer en serveur réseau :
OLLAMA_HOST=0.0.0.0 ollama serve - 6Installer Open WebUI pour l'interface navigateur :
docker run -d -p 3000:8080 --gpus all ghcr.io/open-webui/open-webui:cuda - 7Exposer via Tailscale pour un accès distant sécurisé depuis n'importe quel appareil
Comparaison de performance des trois builds
La performance matérielle est inchangée depuis les mesures 2026 précédentes — seuls les prix ont bougé.
Modèle + Quant | Budget (~2 500 €) | Recommandé (~4 950 €) | Professionnel (~8 200 €) |
|---|---|---|---|
| Llama 3.1 8B Q4 | 55–70 tok/s | 105–125 tok/s | 120–140 tok/s |
| Qwen3 14B Q8 | 20–28 tok/s | 48–60 tok/s | 55–70 tok/s |
| Qwen3 32B Q4 | 12–18 tok/s | 28–38 tok/s | 40–55 tok/s |
| Llama 3.3 70B Q4 | 5–8 tok/s (CPU) | 10–15 tok/s (CPU) | 25–40 tok/s (GPU) |
| Mixtral 8x22B Q4 | 15–22 tok/s | 32–45 tok/s | 45–60 tok/s |
Coût total de possession : workstation vs GPU cloud
Le coût matériel du build Recommandé a augmenté d'environ 29% depuis mai 2026 (RAM et stockage, pas la GPU) — l'amortissement face à la location cloud a changé en conséquence.
Usage | Coût cloud/an (A40 à 0,44 $/h) | Coût électricité workstation/an | Amortissement vs cloud |
|---|---|---|---|
| 2h/jour | ~295 € | ~88 € (@0,30 €/kWh) | ~19 ans — le cloud gagne |
| 4h/jour | ~590 € | ~176 € | ~12 ans |
| 8h/jour | ~1 180 € | ~352 € | ~6 ans |
Aux prix matériel gonflés de 2026, la workstation ne gagne clairement le calcul de coût pur qu'au-delà d'environ 6h/jour d'usage. Confidentialité et indépendance vis-à-vis du cloud restent des raisons valables indépendamment de l'amortissement.
Vaut-il mieux construire une workstation ou louer des GPU cloud ?
Pour une utilisation régulière (6h+/jour) : construire la workstation. Un A40 48 Go sur RunPod à 0,44 $/h pour 4h/jour = ~590 €/an. Aux prix matériel 2026, le build Recommandé à ~4 950 € s'amortit en environ 12 ans à ce rythme, ou moins de 6 ans à 8h/jour. Pour une utilisation occasionnelle (<2h/jour) : le cloud est moins cher.
Pourquoi ce build coûte-t-il tellement plus cher que d'autres guides 2026 ?
La RAM et le stockage NVMe, pas la GPU. Une pénurie DDR5/NAND en 2026 a fait grimper les kits DDR5 64 Go de ~145 € en mai à ~800 € en août, et les SSD NVMe 4 To de ~200 € à ~700–800 €. Les prix GPU sont restés stables voire en légère baisse sur la même période.
Faut-il acheter une RTX 3090 neuve ou d'occasion ?
L'occasion est le choix standard en 2026 — la production a cessé en 2022, donc le « neuf » n'est que du vieux stock à prix majoré. Les cartes d'occasion coûtent 650–950 € ; vérifiez l'absence de bruit de ventilateur excessif ou d'odeur de brûlé en charge, et préférez un vendeur acceptant les retours.
Faut-il NVLink pour faire tourner Ollama sur deux GPU ?
Non. Ollama utilise le parallélisme tensoriel CUDA via PCIe — NVLink n'est pas nécessaire. La configuration dual RTX 3090 fonctionne parfaitement sans NVLink.
Améliorations utiles si vous prévoyez de grandir
Trois améliorations valent le coût si vous pensez dépasser votre niveau dans l'année :
- RAM : 64 Go → 128 Go — utile pour du 70B déchargé CPU sur le niveau Recommandé
- Stockage : 2 To → 4 To — utile si vous gardez plus de 3–4 gros modèles installés
- Refroidissement : AIO 240mm → 360mm — compte surtout sur les niveaux Recommandé et Professionnel
Quelle workstation acheter ?
Toujours indécis ? Commencez par le build Recommandé RTX 4090 — le meilleur équilibre entre performance, VRAM, consommation et évolutivité pour la plupart des utilisateurs.
💰 Moins de 3 000 € — Build Budget
~2 500 € · RTX 3090 24Go
Fait tourner tout modèle jusqu'à 32B Q4 entièrement sur GPU.
⭐ Meilleur choix global — Build Recommandé
~4 950 € · RTX 4090 24Go
Le meilleur équilibre performance/VRAM/prix pour la plupart des usages.
🚀 70B / professionnel — Build Professionnel
~8 200 € · Dual RTX 3090 (48Go)
Inférence 70B à vitesse GPU (25–40 tok/s). À réserver à un usage 70B quotidien.
Lectures complémentaires
- Meilleure GPU pour les LLMs locaux 2026 -- guide d'achat GPU pour chaque niveau de workstation
- Meilleure appli IA locale pour PC modeste -- options logicielles si vous n'êtes pas encore prêt pour une workstation complète
- Meilleur Mac pour IA locale 2026 -- alternative Apple Silicon à une workstation GPU
- Les meilleurs ordinateurs portables pour LLM locaux : guide d'achat 2026 -- options portables avant de vous engager dans un build workstation
- Déploiement Local de Qwen : Guide Complet de Production 2026 -- déploiement en production une fois votre workstation construite