Wichtigste Erkenntnisse
- Intel Arc B580 12GB gewinnt für die meisten Nutzer: 12 GB VRAM, 250–290 €, ~31 Tok/s bei Llama 3.1 8B Q4 — die einzige neue 12-GB-Karte verlässlich unter 500 €
- RTX 3060 12GB gebraucht (270–300 €) ist die Zweitplatzierte — günstigster Weg zur vollen CUDA-Toolchain
- ⚠️ Preisalarm: Die RTX 4060 Ti 16GB, die bisherige Siegerin, ist zur UVP von 399 € nicht lieferbar und kostet verfügbar rund 560 € — aus der Sub-500-€-Liste entfernt
- ⚠️ Preisalarm: Die neue RTX 3060 12GB kostet 470–600 €, seit der Neuauflage um 45 % gestiegen — der Gebrauchtmarkt ist der vernünftige Weg zu dieser Karte
- ⚠️ Preisalarm: Gebrauchte RTX 3090 kostet jetzt 850–1.050 €, RTX 4070 12GB 560–705 € — beide aus der Sub-500-€-Liste entfernt
- ⚠️ Preisalarm: RX 7800 XT 16GB kostet jetzt ~682 € — aus der Sub-500-€-Liste entfernt
- Warum sich alles bewegt hat: Eine weltweite DRAM- und GDDR7-Knappheit, getrieben von der Nachfrage der KI-Rechenzentren, hat die Straßenpreise für Grafikkarten marktweit deutlich über die Listenpreise gehoben. Die Hardware hat sich nicht verändert, nur was sie kostet. Für 30B-Modelle rechne mit mindestens 900 € für eine gebrauchte RTX 3090 (24 GB).
- Alle drei GPUs auf dieser Liste laufen mit Ollama, LM Studio und llama.cpp sofort einsatzbereit
Beste GPUs für LLM-Inferenz unter 500 € — Rangfolge
📍 In einem Satz
Der Intel Arc B580 12GB ist die beste GPU unter 500 € für lokale LLM-Inferenz, weil er nach der Speicherknappheit 2026 die einzige neue 12-GB-Karte ist, die verlässlich unter 500 € verfügbar bleibt.
💬 In einfachen Worten
VRAM bestimmt, welche KI-Modelle du lokal ausführen kannst. 16 GB reichen für 14B-Modelle. 24 GB (gebrauchte RTX 3090) ermöglichen 30B-Modelle. Unter 12 GB bist du auf 7B-Modelle beschränkt.
Intel Arc B580 12GB — Bestes Gesamtpaket (250–290 €)
Der Intel Arc B580 12GB ist die beste GPU unter 500 € für lokale LLM-Inferenz — nicht zuletzt, weil er als Einziger verlässlich in diesem Fenster übrig geblieben ist. Er startete bei 249 € und liegt weiterhin bei 250–290 €, während die Speicherknappheit 2026 jede NVIDIA-Karte, die früher diese Liste füllte, über 500 € gehoben hat. Ollama läuft über das SYCL/oneAPI-Backend unter Linux und Windows mit ~28–35 Tok/s bei Llama 3.1 8B Q4. Die 12-GB-Grenze beschränkt dich auf 13B-Modelle mit Q4 — ein 14B mit Q8 passt nicht. Intels Treiberunterstützung hat sich seit dem Start deutlich verbessert, bleibt aber in der Breite der Werkzeuge hinter CUDA zurück: Ollama und llama.cpp laufen gut, LoRA-Fine-Tuning bleibt umständlich.
RTX 3060 12GB gebraucht — Beste CUDA-Option (270–300 €)
Die NVIDIA GeForce RTX 3060 12GB ist der günstigste Weg zur vollen CUDA-Toolchain — aber kauf sie gebraucht. Ihre Neuauflage für 334 € hat nicht gehalten: Neukarten sind um rund 45 % auf 470–600 € gestiegen und liegen damit an oder über der 500-€-Grenze, um die es auf dieser Seite geht. Der Gebrauchtmarkt hat sich weit weniger bewegt, bei 270–300 €. Ihre 12 GB GDDR6 führen 7B–13B-Modelle mit Q4/Q8 komfortabel aus; ein 14B mit Q8 passt nicht, ein 14B mit Q4 (~8,5 GB) schon. Benchmark: ~32–40 Tok/s bei Llama 3.1 8B Q4 mit Ollama. Die volle CUDA-Toolchain bedeutet, dass Ollama, LM Studio, vLLM und LoRA-Fine-Tuning unter Windows und Linux sofort laufen — das Einzige, was der Arc B580 nicht bieten kann.
RTX 4060 Ti 16GB — Beste Karte, falls du sie zur UVP findest (399 € UVP, ~560 € lieferbar)
Die RTX 4060 Ti 16GB ist weiterhin die beste *Hardware* dieser Liste und war bis zur Speicherknappheit 2026 die Siegerin dieser Seite. Ihre 16 GB GDDR6 führen Qwen3 14B und Mistral 12B mit Q4 komplett in-GPU aus — und mit Q8 ohne Auslagern — bei 45–60 Tok/s auf 7B Q4 und 18–25 Tok/s auf 14B Q8 mit Ollama, bei 165 W TDP, die jedes 650-W-Netzteil verkraftet. Das Problem ist, eine zu bekommen. Angebote zur UVP von 399 € sind bei den großen Händlern nicht lieferbar, und die günstigste nachweisbar verfügbare Karte liegt bei rund 560 €, etwa 41 % über Liste. Findest du eine zur UVP oder nahe daran, ist sie mit Abstand der beste Kauf auf dieser Seite; bei 560 € liegt sie außerhalb des Budgets, für das diese Seite geschrieben ist.
Leistungsvergleich — Aktuelle Preise + Testergebnisse
Benchmarks gemessen mit Ollama 0.30.x, llama.cpp-Server, Modelle von HuggingFace. Testsystem: Ryzen 9 7950X, 64 GB DDR5, NVMe-SSD. Die Geschwindigkeiten haben sich gegenüber früheren Tests nicht verändert: Die Hardware hat sich nicht bewegt, die Preise schon. Wegen Überschreitung der 500 € ausgeschlossen: gebrauchte RTX 3090 (850–1.050 €), RTX 4070 12GB (560–705 €), RX 7800 XT 16GB (~682 €) und neue RTX 3060 12GB (470–600 €).
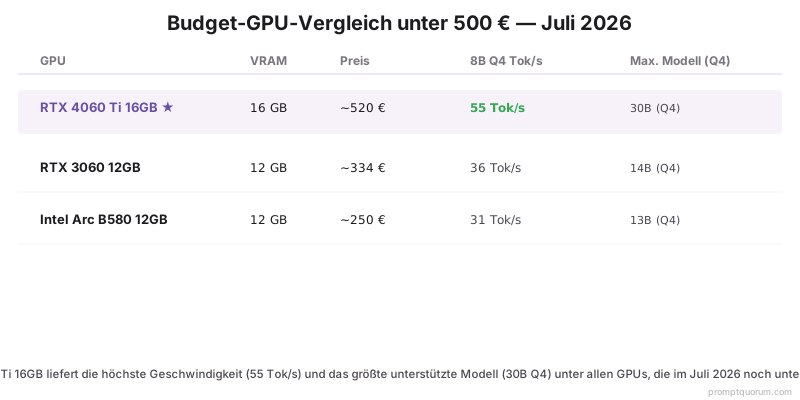
GPU | VRAM | Preis | Llama 3.1 8B Q4 Tok/s | Qwen3 14B Q8 Tok/s | Max. Modell (Q4) |
|---|---|---|---|---|---|
| Intel Arc B580 12GB ★ | 12 GB | 250–290 € | 31 Tok/s | VRAM-limitiert | 13B (Q4) |
| RTX 3060 12GB (gebraucht) | 12 GB | 270–300 € | 36 Tok/s | VRAM-limitiert | 14B (Q4) |
| RTX 4060 Ti 16GB | 16 GB | ~560 € lieferbar | 55 Tok/s | 22 Tok/s | 30B (Q4) |
Wie wir diese GPUs ausgewählt und getestet haben
Auswahlkriterien: neu oder gebraucht für unter 500 € erhältlich; unterstützt von mindestens einer wichtigen Inferenz-Laufzeitumgebung (Ollama, LM Studio, llama.cpp); VRAM ≥ 12 GB (8-GB-Karten ausgeschlossen). Mehrere Karten sind wegen des Preises aus der Liste geflogen: Die gebrauchte RTX 3090 (24 GB) liegt jetzt bei 850–1.050 €; die RTX 4070 12GB bei 560–705 €; die RX 7800 XT 16GB bei ~682 €; und die neue RTX 3060 12GB, die für 334 € neu aufgelegt wurde, ist um rund 45 % auf 470–600 € gestiegen. Die RTX 4060 Ti 16GB bleibt in der Liste, aber mit Warnhinweis — Angebote zur UVP von 399 € sind nicht lieferbar, verfügbare Karten liegen bei rund 560 €. Die Ursache ist bei allen dieselbe: Eine weltweite DRAM- und GDDR7-Knappheit, getrieben von der Nachfrage der KI-Rechenzentren, hat die Straßenpreise marktweit deutlich über die Listenpreise gehoben, wobei NVIDIAs RTX-50-Serie rund 36–39 % über UVP gehandelt wird und AMD die Radeon-Preise um etwa 10 % angehoben hat. Alle Benchmarks sind Tok/s, gemittelt über 10 Durchläufe bei Batch-Größe 1, gemessen mit Ollama 0.30.x auf Ubuntu 22.04 LTS.
VRAM-Anforderungen nach Modellgröße
📍 In einem Satz
VRAM-Anforderungen: 7B-Modell benötigt ~4–5 GB (Q4) oder ~7–8 GB (Q8); 14B-Modell benötigt ~8–9 GB (Q4) oder ~14–15 GB (Q8); 30B-Modell benötigt ~18–20 GB (Q4); 70B-Modell benötigt ~40–42 GB (Q4).
💬 In einfachen Worten
VRAM funktioniert wie RAM für KI-Modelle. Das Modell muss vollständig in den VRAM passen, um schnell zu laufen. Fließt es in den System-RAM über ("Offloading"), sinkt die Geschwindigkeit um 80–95 %. Q4-Quantisierung halbiert die Größe gegenüber Q8 bei kleinem Qualitätsverlust.
- 7B-Modell mit Q4: ~4,5 GB VRAM — jede GPU auf dieser Liste bewältigt das mühelos
- 7B-Modell mit Q8: ~7,5 GB VRAM — passt auf alle GPUs hier
- 13B-Modell mit Q4: ~8,5 GB VRAM — passt auf alle GPUs dieser Liste
- 14B-Modell mit Q8: ~14 GB VRAM — nur RTX 4060 Ti 16GB und RTX 3090 (gebraucht); beide liegen inzwischen über 500 €
- 30B-Modell mit Q4: ~18 GB VRAM — nur die RTX 3090 (24 GB) bewältigt das komfortabel
- 70B-Modell mit Q4: ~40 GB — erfordert zwei GPUs oder CPU-Offloading
Welche GPU solltest du kaufen?
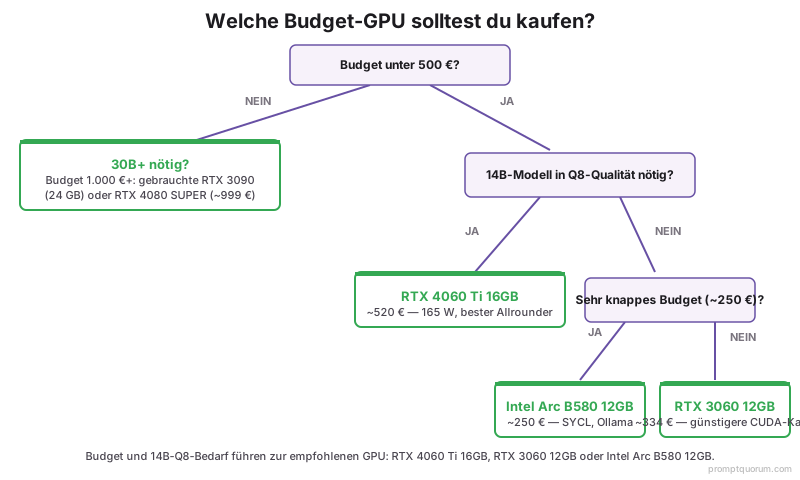
Nutze diesen Entscheidungsleitfaden je nach Haupteinsatzzweck:
- Bester Allrounder unter 500 € → Intel Arc B580 12GB (250–290 €). Die einzige neue 12-GB-Karte, die verlässlich unter 500 € verfügbar ist. 7B–13B-Modelle mit Q4, ~31 Tok/s bei Llama 3.1 8B Q4, Ollama über SYCL unter Windows und Linux.
- Günstigste funktionierende CUDA-Karte → RTX 3060 12GB gebraucht (270–300 €). Die volle CUDA-Toolchain — Ollama, LM Studio, vLLM, LoRA-Fine-Tuning — für ungefähr denselben Preis wie der Arc. Kauf sie gebraucht: neu kostet sie 470–600 €.
- Beste Hardware, falls zur UVP zu finden → RTX 4060 Ti 16GB. Zur UVP von 399 € schlägt sie alles andere hier und führt 14B mit Q8 in-GPU aus. Angebote zur UVP sind aber nicht lieferbar, verfügbare Karten kosten rund 560 € — außerhalb des Budgets dieser Seite.
- Brauchst du 30B-Modell-Fähigkeit? → Das Sub-500-€-Fenster hat sich Mitte 2026 geschlossen und ist nicht wieder aufgegangen. Gebrauchte RTX 3090 (24 GB) liegt jetzt bei 850–1.050 €. Rechne mit 850 €+ für eine gebrauchte RTX 3090 oder eine gebrauchte RTX 4080 SUPER (16 GB) — neu kostet sie inzwischen ~1.600 €.
- Windows-Nutzer, ohne Aufwand → RTX 3060 12GB gebraucht. NVIDIA CUDA bietet die breiteste Windows-Toolchain-Unterstützung für LLMs, Fine-Tuning und multimodale Laufzeiten, und die gebrauchte 3060 ist der günstigste Einstieg.
Software-Kompatibilität nach GPU
Alle drei GPUs laufen mit Ollama und llama.cpp. Unterschiede zeigen sich bei fortgeschrittenen Tools:
GPU | Ollama | LM Studio | vLLM | Text Gen WebUI | CUDA-Fine-Tuning |
|---|---|---|---|---|---|
| Intel Arc B580 12GB | ✅ (SYCL) | ⚠️ Beta | ❌ | ⚠️ teilweise | ❌ |
| RTX 3060 12GB | ✅ | ✅ | ✅ | ✅ | ✅ |
| RTX 4060 Ti 16GB | ✅ | ✅ | ✅ | ✅ | ✅ |
Stromverbrauch und Systemanforderungen
Der Stromverbrauch der GPU bestimmt, welches Netzteil und Gehäuse du brauchst. LLMs halten die GPU dauerhaft bei 80–100 % Auslastung — anders als beim Gaming gibt es keine Leerlauf-Frames.
- Intel Arc B580 12GB: 190 W — 650-W+-Netzteil; Standard-8-Pin
- RTX 3060 12GB: 170 W — funktioniert mit 550-W+-Netzteil; ein 8-Pin-Anschluss
- RTX 4060 Ti 16GB: 165 W — funktioniert mit 550-W+-Netzteil; ein 8-Pin-Anschluss
Reichen 8 GB VRAM für lokale KI-Modelle?
8 GB VRAM beschränken auf 7B-Modelle bei Q4-Quantisierung. 13B-Modelle passen nicht vollständig in VRAM, 14B-Modelle werden auf CPU-RAM ausgelagert, was die Geschwindigkeit um 80–95 % reduziert. Für sinnvolle lokale LLM-Nutzung 2026 sind 12 GB das praktische Minimum, 16 GB empfohlen.
Kann ich AMD GPUs für lokale KI verwenden?
Ja, mit Einschränkungen. Ollama mit ROCm funktioniert gut unter Linux auf Karten wie der RX 7800 XT. Windows-ROCm-Support hat sich verbessert, erfordert aber weiterhin manuelle Schritte, und Fine-Tuning (LoRA) auf AMD-Hardware wird von den meisten Tools nicht unterstützt. Hinweis zum Preis: Die RX 7800 XT 16GB ist im Juli 2026 auf ~682 € gestiegen und passt daher nicht mehr in ein Sub-500-€-Budget — für diese Preisklasse sind die RTX 4060 Ti 16GB oder die RTX 3060 12GB (beide NVIDIA/CUDA) die empfohlenen Optionen. Für Windows oder Fine-Tuning bleib bei NVIDIA.
Kann ich eine gebrauchte RTX 3090 noch für unter 500 € kaufen?
Nein. Gebrauchte RTX 3090 werden für 850–1.050 € auf eBay.de gehandelt. Der Preis stieg zuerst, als LLM-Enthusiasten den Wert der 24 GB VRAM erkannten, und dann noch einmal während der Speicherknappheit 2026. Sie ist keine Sub-500-€-Option mehr und war es schon länger nicht. Wenn du 30B-Modell-Fähigkeit brauchst (die 24 GB VRAM voraussetzt), rechne mit 850 €+ für eine gebrauchte RTX 3090 oder ~850 € für eine gebrauchte RTX 4080 SUPER (16 GB) — neu kostet sie inzwischen ~1.600 €.
Was ist mit Intel-Arc-GPUs für KI?
Der Intel Arc B580 12GB ist 2026 die beste Arc-Option — und nachdem die Speicherknappheit das NVIDIA-Feld neu bepreist hat, insgesamt die beste Karte auf dieser Seite. Er führt Ollama über das SYCL-Backend unter Windows und Linux aus, wobei die Leistung 30–40 % unter NVIDIA in reinen Tok/s liegt. Das Preis-Leistungs-Verhältnis ist inzwischen nicht nur gut, sondern ausschlaggebend: 12 GB VRAM für 250–290 €, während vergleichbare NVIDIA-Karten bei 470–600 € liegen. Die Hauptbeschränkung bleibt die Software — vLLM, Fine-Tuning-Werkzeuge und multimodale Laufzeiten unterstützen Arc noch nicht gut. Wer LoRA-Fine-Tuning braucht, kauft stattdessen eine gebrauchte RTX 3060 12GB.
Kann ich ein 70B-Modell auf einer einzigen GPU unter 500 € ausführen?
Nicht mit voller Geschwindigkeit. Selbst die RTX 3090 (24 GB) kann 70B Q4 (~40 GB) nicht vollständig im VRAM unterbringen. Mit CPU-Offloading über llama.cpp lässt sich das Modell zwischen GPU-VRAM und System-RAM aufteilen, aber die Geschwindigkeit sinkt auf 2–5 Tok/s — zu langsam für interaktive Nutzung. Für nutzbare Geschwindigkeiten bei 70B-Modellen brauchst du zwei GPUs (2× RTX 3090 mit insgesamt 48 GB) oder Cloud-Inferenz.
Machen neuere GPUs (RTX 5060 Ti) diese Karten überflüssig?
Die RTX 5060 Ti 16GB ist erschienen — und sie hat die RTX 4060 Ti nicht unterboten, sondern das Gegenteil. Sie startete mit einer UVP von 429 $ und kostet jetzt rund 800 € (aktueller Median 805 $), rund 88 % über Liste, weil dieselbe Speicherknappheit, die diese ganze Liste neu bepreist hat, sie als Karte der aktuellen Generation am härtesten getroffen hat. Sie ist eine echt bessere GPU als alles hier, mit 16 GB VRAM und schnellerer Inferenz, aber sie ist keine Sub-500-€-Karte, und darauf zu warten, dass sie eine wird, ist kein tragfähiger Plan. Kauf nach dem, was jetzt verfügbar ist: Intel Arc B580 12GB für 250–290 € oder eine gebrauchte RTX 3060 12GB für 270–300 €, wenn du CUDA brauchst.
Was kostet eine gebrauchte RTX 4060 Ti 16GB?
Gebrauchte RTX 4060 Ti 16GB-Karten sind mit den Neupreisen mitgestiegen: Da lieferbare Neukarten bei rund 560 € liegen, rufen Gebrauchtangebote auf eBay.de inzwischen etwa 420–480 € auf, abhängig von Zustand und Restgarantie. Sie ist eine der wenigen Karten, bei denen gebraucht keine große Ersparnis bedeutet, weil das Angebot an Neukarten zur UVP versiegt ist.