Key Takeaways
- La Intel Arc B580 12GB gana para la mayoría: 12 GB VRAM, 250–290 €, ~31 tok/s en Llama 3.1 8B Q4 — la única tarjeta nueva de 12 GB fiablemente por debajo de 500 €
- La RTX 3060 12GB de segunda mano (270–300 €) es la segunda opción — la vía más barata a la cadena de herramientas CUDA completa
- ⚠️ Alerta de precio: la RTX 4060 Ti 16GB, la ganadora anterior, está sin stock a su PVP de 399 € y ronda los 560 € cuando aparece — eliminada de la lista sub-500 €
- ⚠️ Alerta de precio: la RTX 3060 12GB nueva está a 470–600 €, un 45 % más desde su relanzamiento — el mercado de segunda mano es la vía sensata para esta tarjeta
- ⚠️ Alerta de precio: la RTX 3090 de segunda mano ahora vale 850–1.050 €; la RTX 4070 12GB, 560–705 € — ambas eliminadas de la lista sub-500 €
- Por qué se movió todo: una escasez mundial de DRAM y GDDR7, impulsada por la demanda de los centros de datos de IA, ha empujado los precios de calle muy por encima del precio de lista en todo el mercado. El hardware no ha cambiado; solo lo que cuesta.
- ¿Necesitas capacidad para modelos 30B? Presupuesta al menos 850 € para una RTX 3090 usada (24 GB) o una RTX 4080 SUPER de segunda mano (16 GB, ~850 € de segunda mano; nueva ronda ahora los 1.600 € tras la escasez)
- Las tres GPU de esta lista funcionan con Ollama, LM Studio y llama.cpp de fábrica
Mejores GPU para inferencia LLM por menos de 500 € — Clasificadas
La Intel Arc B580 12GB es la mejor GPU por menos de 500 € para inferencia LLM local porque es la única tarjeta nueva de 12 GB que sigue disponible de forma fiable por debajo de 500 € tras la escasez de memoria de 2026.
El VRAM de la GPU determina qué modelos de IA puedes ejecutar. Una GPU de 16 GB ejecuta modelos 14B en alta calidad. Una GPU de 24 GB (como una RTX 3090 de segunda mano) ejecuta modelos de 30B o más. Con menos de 12 GB estás limitado a modelos 7B o más pequeños.
Intel Arc B580 12GB — Mejor opción global (250–290 €)
La Intel Arc B580 12GB es la mejor GPU por menos de 500 € para inferencia LLM local, en buena medida porque es la última que queda de forma fiable dentro de esa ventana. Se lanzó a 249 € y sigue vendiéndose entre 250 y 290 €, mientras que todas las tarjetas NVIDIA que solían ocupar esta lista han superado los 500 € por la escasez de memoria de 2026. Ejecuta Ollama mediante el backend SYCL/oneAPI en Linux y Windows, con ~28–35 tok/s en Llama 3.1 8B Q4. El límite de 12 GB de VRAM te restringe a modelos 13B en Q4 — no alojará un 14B en Q8. El soporte de controladores de Intel ha mejorado mucho desde el lanzamiento, aunque sigue por detrás de CUDA en amplitud de herramientas: espera que Ollama y llama.cpp funcionen bien y que el ajuste fino LoRA sea incómodo.
RTX 3060 12GB usada — Mejor opción CUDA (270–300 €)
La NVIDIA GeForce RTX 3060 12GB es la vía más barata a la cadena de herramientas CUDA completa, pero cómprala de segunda mano. Su relanzamiento minorista a 334 € no se sostuvo: las unidades nuevas han subido en torno a un 45 % hasta 470–600 €, lo que sitúa la tarjeta nueva en el techo de 500 € del que trata esta página, o por encima. El mercado de segunda mano se ha movido mucho menos, entre 270 y 300 €. Sus 12 GB GDDR6 ejecutan modelos 7B–13B en Q4/Q8 con comodidad; no puede alojar un 14B en Q8, pero un 14B en Q4 (~8.5 GB) cabe. Benchmark: ~32–40 tok/s en Llama 3.1 8B Q4 con Ollama. La cadena CUDA completa significa que Ollama, LM Studio, vLLM y el ajuste fino LoRA funcionan de fábrica en Windows y Linux — lo único que la Arc B580 no puede igualar.
RTX 4060 Ti 16GB — La mejor tarjeta, si la encuentras a PVP (399 € PVP, ~560 € con stock)
La RTX 4060 Ti 16GB sigue siendo el mejor *hardware* de esta lista y fue la ganadora de esta página hasta la escasez de memoria de 2026. Sus 16 GB GDDR6 ejecutan Qwen3 14B y Mistral 12B en Q4 completamente en GPU — y en Q8 sin intercambio — a 45–60 tok/s en 7B Q4 y 18–25 tok/s en 14B Q8 con Ollama, con un TDP de 165 W que cualquier fuente de 650 W asume. El problema es comprarla. Los anuncios al PVP de 399 € están sin stock en los grandes minoristas, y la unidad disponible más barata que se puede verificar ronda los 560 €, alrededor de un 41 % por encima del precio de lista. Si encuentras una a PVP o cerca, es con diferencia la mejor compra de esta página; a 560 € queda fuera del presupuesto para el que está escrita. Vigílala, pero no planifiques contando con ella.
Comparación de rendimiento — Precios actuales + Resultados de pruebas
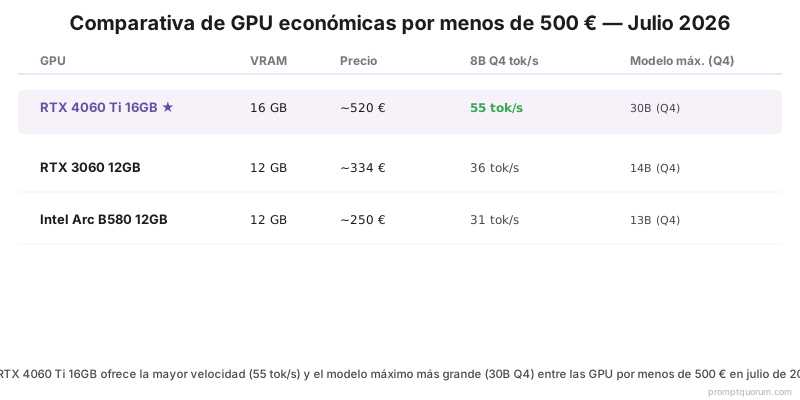
Benchmarks medidos con Ollama 0.30.x, servidor llama.cpp, modelos de HuggingFace. Sistema de prueba: Ryzen 9 7950X, 64 GB DDR5, NVMe SSD. Las velocidades no han cambiado respecto a pruebas anteriores: el hardware no se ha movido, los precios sí. Excluidas por superar los 500 €: RTX 3090 usada (850–1.050 €), RTX 4070 12GB (560–705 €), RX 7800 XT 16GB (~682 €) y RTX 3060 12GB nueva (470–600 €).
GPU | VRAM | Precio | Llama 3.1 8B Q4 tok/s | Qwen3 14B Q8 tok/s | Modelo máximo (Q4) |
|---|---|---|---|---|---|
| Intel Arc B580 12GB ★ | 12 GB | 250–290 € | 31 tok/s | Limitado por VRAM | 13B (Q4) |
| RTX 3060 12GB (usada) | 12 GB | 270–300 € | 36 tok/s | Limitado por VRAM | 14B (Q4) |
| RTX 4060 Ti 16GB | 16 GB | ~560 € con stock | 55 tok/s | 22 tok/s | 30B (Q4) |
Cómo seleccionamos y probamos estas GPU
Criterios de selección: disponibles para compra nueva o usada por menos de 500 €; compatibles con al menos un runtime de inferencia principal (Ollama, LM Studio, llama.cpp); VRAM ≥ 12 GB (tarjetas de 8 GB excluidas). Varias tarjetas han salido de la lista por precio: la RTX 3090 usada (24 GB) cotiza ahora a 850–1.050 €; la RTX 4070 12GB a 560–705 €; la RX 7800 XT 16GB a ~682 €; y la RTX 3060 12GB nueva, que se relanzó a 334 €, ha subido en torno a un 45 % hasta 470–600 €. La RTX 4060 Ti 16GB se mantiene, pero con advertencia: sus anuncios al PVP de 399 € están sin stock y las unidades disponibles rondan los 560 €. La causa es común a todas: una escasez mundial de DRAM y GDDR7 impulsada por la demanda de los centros de datos de IA ha empujado los precios de calle muy por encima del precio de lista en todo el mercado, con las RTX 50 de NVIDIA en torno a un 36–39 % por encima del PVP y AMD subiendo Radeon alrededor de un 10 %. Todos los benchmarks son tok/s, promediados sobre 10 ejecuciones con batch size 1, medidos con Ollama 0.30.x en Ubuntu 22.04 LTS.
Requisitos de VRAM por tamaño de modelo
Requisitos de VRAM: el modelo 7B necesita ~4–5 GB (Q4) o ~7–8 GB (Q8); el modelo 14B necesita ~8–9 GB (Q4) o ~14–15 GB (Q8); el modelo 30B necesita ~18–20 GB (Q4); el modelo 70B necesita ~40–42 GB (Q4).
Piensa en el VRAM como la RAM para los modelos de IA. El modelo debe caber completamente en VRAM para una inferencia rápida. Si se desborda a la RAM del sistema (llamado "offloading"), la velocidad cae un 80–95%. La cuantización Q4 reduce el tamaño a la mitad respecto a Q8 con un pequeño coste en calidad.
- Modelo 7B en Q4: ~4.5 GB VRAM — cualquier GPU de esta lista lo maneja fácilmente
- Modelo 7B en Q8: ~7.5 GB VRAM — cabe en todas las GPU aquí
- Modelo 13B en Q4: ~8.5 GB VRAM — cabe en todas las GPU de esta lista
- Modelo 14B en Q8: ~14 GB VRAM — solo RTX 4060 Ti 16GB y RTX 3090 (usada)
- Modelo 30B en Q4: ~18 GB VRAM — requiere 24 GB (RTX 3090 usada, ahora 850 €+)
- Modelo 70B en Q4: ~40 GB — requiere dos GPU o descarga a CPU
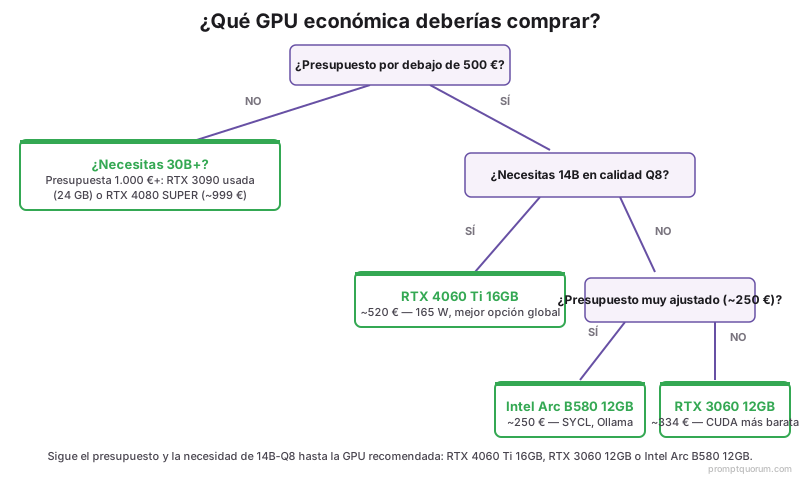
¿Qué GPU deberías comprar?
Usa esta guía de decisión según tu caso de uso principal. Precios verificados:
- Mejor opción general por menos de 500 € → Intel Arc B580 12GB (250–290 €). La única tarjeta nueva de 12 GB fiablemente disponible por debajo de 500 €. Modelos 7B–13B en Q4, ~31 tok/s en Llama 3.1 8B Q4, Ollama vía SYCL en Windows y Linux.
- Tarjeta CUDA más barata que funciona → RTX 3060 12GB de segunda mano (270–300 €). La cadena CUDA completa — Ollama, LM Studio, vLLM, ajuste fino LoRA — por aproximadamente el mismo dinero que la Arc. Cómprala usada: la nueva está a 470–600 €.
- El mejor hardware, si lo encuentras a PVP → RTX 4060 Ti 16GB. A su PVP de 399 € supera a todo lo demás aquí, ejecutando 14B en Q8 en GPU. Pero los anuncios a PVP están sin stock y las unidades disponibles rondan los 560 €, fuera del presupuesto de esta página.
- ¿Necesitas capacidad para modelos 30B? → La ventana sub-500 € se cerró a mediados de 2026 y no se ha reabierto. La RTX 3090 usada (24 GB) ahora cotiza a 850–1.050 €. Presupuesta 850 €+ para una RTX 3090 usada o para una RTX 4080 SUPER (16 GB) de segunda mano — nueva ronda ahora los 1.600 €.
- Usuario de Windows, sin complicaciones → RTX 4060 Ti 16GB. NVIDIA CUDA tiene el soporte más amplio en Windows para LLMs, fine-tuning y runtimes multimodales.
Compatibilidad de software por GPU
Las tres GPU ejecutan Ollama y llama.cpp. Las diferencias aparecen en herramientas avanzadas:
GPU | Ollama | LM Studio | vLLM | Text Gen WebUI | Fine-Tuning CUDA |
|---|---|---|---|---|---|
| Intel Arc B580 12GB | ✅ (SYCL) | ⚠️ beta | ❌ | ⚠️ parcial | ❌ |
| RTX 3060 12GB | ✅ | ✅ | ✅ | ✅ | ✅ |
| RTX 4060 Ti 16GB | ✅ | ✅ | ✅ | ✅ | ✅ |
Consumo energético y requisitos del sistema
El consumo de la GPU determina qué fuente de alimentación y chasis necesitas. Ejecutar LLMs mantiene las GPU al 80–100% de utilización de forma continua — a diferencia del gaming, no hay fotogramas inactivos.
- Intel Arc B580 12GB: 190 W — fuente de 650 W o más; 8 pines estándar
- RTX 3060 12GB: 170 W — funciona con fuente de 550 W o más; un conector de 8 pines
- RTX 4060 Ti 16GB: 165 W — funciona con fuente de 550 W o más; un conector de 8 pines
¿Son suficientes 8 GB de VRAM para ejecutar LLMs localmente?
8 GB de VRAM te limitan a modelos 7B en cuantización Q4 — el modelo apenas cabe. No puedes ejecutar modelos 13B en calidad completa, y los modelos 14B se descargarán parcialmente a la RAM del sistema, reduciendo la velocidad un 80–95%. Para un uso local de LLM significativo en 2026, 12 GB es el mínimo práctico; se recomienda 16 GB.
¿Puedo comprar una RTX 3090 de segunda mano por menos de 500 € en 2026?
No. Las RTX 3090 de segunda mano cotizan a 850–1.050 € en eBay. El precio subió primero cuando los entusiastas de los LLMs reconocieron el valor de sus 24 GB de VRAM, y otra vez durante la escasez de memoria de 2026. Ya no es una opción por debajo de 500 €, y hace tiempo que no lo es. Si necesitas capacidad para modelos 30B (que requiere 24 GB de VRAM), presupuesta 900 €+ para una RTX 3090 usada o considera una RTX 4080 SUPER de segunda mano (16 GB, ~850 €; nueva ronda ahora los 1.600 € tras la escasez) para un 14B Q8 más rápido.
¿Funciona AMD para ejecutar LLMs localmente?
Sí, con matices. Ollama en Linux con ROCm funciona bien en tarjetas como la RX 7800 XT. El soporte ROCm en Windows ha mejorado pero aún requiere pasos manuales, y el fine-tuning (LoRA) en hardware AMD no está soportado por la mayoría de herramientas. Nota sobre el precio: la RX 7800 XT 16GB ha subido a ~682 € en julio de 2026, así que ya no encaja en un presupuesto sub-500 € — para ese rango de precio, la RTX 4060 Ti 16GB o la RTX 3060 12GB (ambas NVIDIA/CUDA) son las opciones recomendadas. Para Windows o fine-tuning, quédate con NVIDIA.
¿Qué hay de las GPU Intel Arc para IA?
La Intel Arc B580 12GB es la mejor opción Arc en 2026 y, después de que la escasez de memoria reajustara el campo NVIDIA, la mejor tarjeta de esta página en conjunto. Ejecuta Ollama en Windows y Linux a través del backend SYCL, aunque el rendimiento está un 30–40 % por debajo de NVIDIA en tok/s brutos. La relación valor-precio es ahora decisiva, no solo buena: 12 GB de VRAM por 250–290 € mientras las tarjetas NVIDIA comparables están a 470–600 €. La limitación principal sigue siendo el software — vLLM, las herramientas de ajuste fino y los runtimes multimodales todavía no soportan bien Arc — así que si necesitas ajuste fino LoRA, compra una RTX 3060 12GB de segunda mano.
¿Puedo ejecutar un modelo de 70B en una sola GPU por menos de 500 €?
No a plena velocidad. Incluso la RTX 3090 (24 GB) no puede almacenar 70B Q4 (~40 GB) completamente en VRAM. Puedes usar descarga a CPU con llama.cpp para dividir el modelo entre VRAM y RAM del sistema, pero la velocidad cae a 2–5 tok/s — demasiado lento para uso interactivo. Para ejecutar modelos 70B a velocidades utilizables, necesitas dos GPU (2× RTX 3090 con 48 GB en total) o inferencia en la nube.
¿Los nuevos modelos (RTX 5060 Ti) harán obsoletas estas GPU?
La RTX 5060 Ti 16GB ya se ha lanzado, y no quedó por debajo de la RTX 4060 Ti: ocurrió lo contrario. Salió con un PVP de 429 $ y ahora se vende en torno a 800 € (mediana reciente de 805 $), alrededor de un 88 % por encima del precio de lista, porque la misma escasez de memoria que reajustó toda esta lista la golpeó con más fuerza al ser una tarjeta de generación actual. Es una GPU genuinamente mejor que cualquiera de las de aquí, con 16 GB de VRAM e inferencia más rápida, pero no es una tarjeta por debajo de 500 € y esperar a que lo sea no es un plan razonable. Compra según lo que hay disponible ahora: la Intel Arc B580 12GB a 250–290 €, o una RTX 3060 12GB de segunda mano a 270–300 € si necesitas CUDA.
¿Cuánto cuesta una RTX 4060 Ti 16GB de segunda mano?
Las RTX 4060 Ti 16GB de segunda mano han seguido la subida del mercado nuevo: con las unidades nuevas disponibles rondando los 560 €, los anuncios de segunda mano están ahora entre 420 y 480 € en eBay, según el estado y la garantía restante. Es una de las pocas tarjetas donde comprar usado no supone un gran ahorro, porque la oferta de unidades nuevas a PVP se agotó.