Points clés
- L'Intel Arc B580 12 Go gagne pour la plupart des utilisateurs : 12 Go VRAM, 250–290 €, ~31 tok/s sur Llama 3.1 8B Q4 — seule carte neuve de 12 Go fiablement sous 500 €
- La RTX 3060 12 Go d'occasion (270–300 €) est l'alternative — la voie la moins chère vers la chaîne CUDA complète
- ⚠️ Alerte prix : la RTX 4060 Ti 16 Go, gagnante précédente, est en rupture au tarif conseillé de 399 € et coûte ~560 € quand disponible — retirée de la liste sous 500 €
- ⚠️ Alerte prix : la RTX 3060 12 Go neuve est à 470–600 €, +45 % depuis sa relance — le marché de l'occasion est la voie raisonnable pour cette carte
- ⚠️ Alerte prix : RTX 3090 occasion à 850–1 050 € et RTX 4070 12 Go à 560–705 € — retirées de la liste sous 500 €
- ⚠️ Alerte prix : RX 7800 XT 16 Go coûte maintenant ~682 € — retirée de la liste sous 500 €
- Pourquoi tout a bougé : une pénurie mondiale de DRAM et de GDDR7, tirée par la demande des centres de données IA, a poussé les prix de rue des cartes graphiques nettement au-dessus des tarifs catalogue sur tout le marché. Le matériel n'a pas changé, seulement son prix. Besoin de modèles 30B ? Prévoyez au moins 900 € pour une RTX 3090 occasion (24 Go).
- Les trois GPU de cette liste fonctionnent avec Ollama, LM Studio et llama.cpp sans configuration
Meilleures GPU pour l'inférence LLM sous 500 € — Classement
📍 En une phrase
L'Intel Arc B580 12 Go est la meilleure GPU sous 500 € pour l'inférence LLM locale car c'est la seule carte neuve de 12 Go encore disponible de façon fiable sous 500 € après la pénurie de mémoire de 2026.
💬 En termes simples
Le VRAM de la GPU détermine quels modèles d'IA vous pouvez faire tourner. 16 Go suffisent pour les modèles 14B. 24 Go (RTX 3090 occasion) permettent les modèles 30B. En dessous de 12 Go, vous êtes limité aux modèles 7B.
Intel Arc B580 12 Go — Meilleur choix global (250–290 €)
L'Intel Arc B580 12 Go est la meilleure GPU sous 500 € pour l'inférence LLM locale, en grande partie parce que c'est la dernière qui reste réellement dans cette fenêtre. Lancé à 249 €, il se vend toujours entre 250 et 290 €, alors que toutes les cartes NVIDIA qui occupaient cette liste sont passées au-dessus de 500 € avec la pénurie de mémoire de 2026. Il fait tourner Ollama via le backend SYCL/oneAPI sous Linux et Windows, à ~28–35 tok/s sur Llama 3.1 8B Q4. Le plafond de 12 Go de VRAM vous limite aux modèles 13B en Q4 — il n'accueillera pas un 14B en Q8. Le support pilotes d'Intel s'est nettement amélioré depuis le lancement, mais reste en retrait de CUDA sur l'étendue de l'outillage : attendez-vous à ce qu'Ollama et llama.cpp fonctionnent bien, et à ce que le fine-tuning LoRA soit pénible.
RTX 3060 12 Go d'occasion — Meilleure option CUDA (270–300 €)
La NVIDIA GeForce RTX 3060 12 Go est la voie la moins chère vers la chaîne d'outils CUDA complète, mais achetez-la d'occasion. Sa relance en boutique à 334 € n'a pas tenu : les cartes neuves ont grimpé d'environ 45 % à 470–600 €, ce qui place la carte neuve au plafond de 500 € dont parle cette page, voire au-dessus. Le marché de l'occasion a beaucoup moins bougé, à 270–300 €. Ses 12 Go GDDR6 font tourner les modèles 7B–13B en Q4/Q8 confortablement ; elle ne peut pas accueillir un 14B en Q8, mais un 14B en Q4 (~8,5 Go) passe. Benchmark : ~32–40 tok/s sur Llama 3.1 8B Q4 avec Ollama. La chaîne CUDA complète signifie qu'Ollama, LM Studio, vLLM et le fine-tuning LoRA fonctionnent d'emblée sous Windows et Linux — la seule chose que l'Arc B580 ne peut pas égaler.
RTX 4060 Ti 16 Go — La meilleure carte, si vous la trouvez au tarif conseillé (399 € conseillé, ~560 € en stock)
La RTX 4060 Ti 16 Go reste le meilleur *matériel* de cette liste et fut la gagnante de cette page jusqu'à la pénurie de mémoire de 2026. Ses 16 Go GDDR6 font tourner Qwen3 14B et Mistral 12B en Q4 entièrement en GPU — et en Q8 sans swap — à 45–60 tok/s sur 7B Q4 et 18–25 tok/s sur 14B Q8 avec Ollama, pour un TDP de 165 W que n'importe quelle alimentation 650 W encaisse. Le problème est d'en acheter une. Les annonces au tarif conseillé de 399 € sont en rupture chez les grands revendeurs, et la carte disponible la moins chère vérifiable tourne autour de 560 €, soit environ 41 % au-dessus du tarif. Si vous en trouvez une au tarif conseillé ou proche, c'est de loin le meilleur achat de cette page ; à 560 €, elle sort du budget pour lequel cette page est écrite.
Comparatif de performances — Prix actuels + résultats de tests
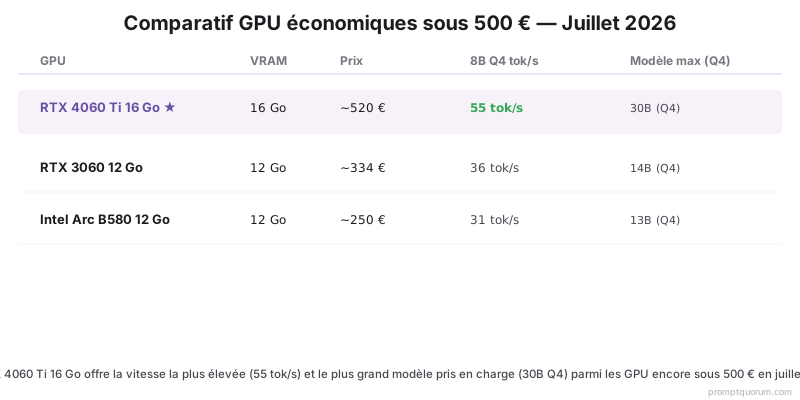
Benchmarks mesurés avec Ollama 0.30.x, serveur llama.cpp, modèles issus de HuggingFace. Système de test : Ryzen 9 7950X, 64 Go DDR5, SSD NVMe. Les vitesses n'ont pas changé par rapport aux tests précédents : le matériel n'a pas bougé, les prix si. Exclues pour dépassement des 500 € : RTX 3090 occasion (850–1 050 €), RTX 4070 12 Go (560–705 €), RX 7800 XT 16 Go (~682 €) et RTX 3060 12 Go neuve (470–600 €).
GPU | VRAM | Prix | Llama 3.1 8B Q4 tok/s | Qwen3 14B Q8 tok/s | Modèle max (Q4) |
|---|---|---|---|---|---|
| Intel Arc B580 12 Go ★ | 12 Go | 250–290 € | 31 tok/s | Limité par la VRAM | 13B (Q4) |
| RTX 3060 12 Go (occasion) | 12 Go | 270–300 € | 36 tok/s | Limité par la VRAM | 14B (Q4) |
| RTX 4060 Ti 16 Go | 16 Go | ~560 € en stock | 55 tok/s | 22 tok/s | 30B (Q4) |
Comment nous avons sélectionné et testé ces GPU
Critères de sélection : disponibles neuves ou d'occasion sous 500 € ; compatibles avec au moins un runtime d'inférence majeur (Ollama, LM Studio, llama.cpp) ; VRAM ≥ 12 Go (cartes 8 Go exclues). Plusieurs cartes sont sorties de la liste sur le prix : la RTX 3090 occasion (24 Go) se négocie désormais à 850–1 050 € ; la RTX 4070 12 Go à 560–705 € ; la RX 7800 XT 16 Go à ~682 € ; et la RTX 3060 12 Go neuve, relancée à 334 €, a grimpé d'environ 45 % à 470–600 €. La RTX 4060 Ti 16 Go est conservée mais signalée — ses annonces au tarif conseillé de 399 € sont en rupture et les cartes disponibles tournent autour de 560 €. La cause leur est commune : une pénurie mondiale de DRAM et de GDDR7 tirée par la demande des centres de données IA a poussé les prix de rue nettement au-dessus des tarifs catalogue sur tout le marché, les RTX 50 de NVIDIA s'échangeant environ 36–39 % au-dessus du prix conseillé et AMD ayant relevé ses tarifs Radeon d'environ 10 %. Tous les benchmarks sont en tok/s, moyennés sur 10 exécutions à batch size 1, mesurés avec Ollama 0.30.x sous Ubuntu 22.04 LTS.
Besoins en VRAM selon la taille du modèle
📍 En une phrase
Besoins en VRAM : un modèle 7B nécessite ~4–5 Go (Q4) ou ~7–8 Go (Q8) ; un modèle 14B nécessite ~8–9 Go (Q4) ou ~14–15 Go (Q8) ; un modèle 30B nécessite ~18–20 Go (Q4) ; un modèle 70B nécessite ~40–42 Go (Q4).
💬 En termes simples
Pensez au VRAM comme à la RAM des modèles d'IA. Le modèle doit tenir entièrement dans le VRAM pour une inférence rapide. S'il déborde vers la RAM système (le « offloading »), la vitesse chute de 80 à 95 %. La quantification Q4 divise la taille par deux par rapport au Q8, pour une légère perte de qualité.
- Modèle 7B en Q4 : ~4,5 Go de VRAM — toutes les GPU de cette liste gèrent cela facilement
- Modèle 7B en Q8 : ~7,5 Go de VRAM — convient à toutes les GPU ici
- Modèle 13B en Q4 : ~8,5 Go de VRAM — convient à toutes les GPU de cette liste
- Modèle 14B en Q8 : ~14 Go de VRAM — seulement la RTX 4060 Ti 16 Go et la RTX 3090 (occasion)
- Modèle 30B en Q4 : ~18 Go de VRAM — seule la RTX 3090 (24 Go) gère cela confortablement
- Modèle 70B en Q4 : ~40 Go — nécessite deux GPU ou un offloading CPU
Quelle GPU devriez-vous acheter ?
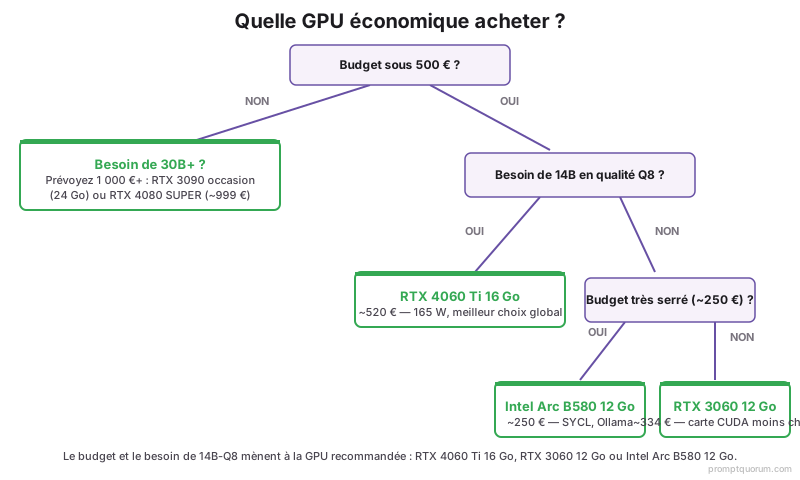
Utilisez ce guide de décision selon votre usage principal. Prix vérifiés :
- Meilleur choix global sous 500 € → Intel Arc B580 12 Go (250–290 €). La seule carte neuve de 12 Go fiablement disponible sous 500 €. Modèles 7B–13B en Q4, ~31 tok/s sur Llama 3.1 8B Q4, Ollama via SYCL sous Windows et Linux.
- Carte CUDA la moins chère qui fonctionne → RTX 3060 12 Go d'occasion (270–300 €). La chaîne CUDA complète — Ollama, LM Studio, vLLM, fine-tuning LoRA — pour à peu près le même prix que l'Arc. Achetez-la d'occasion : la neuve est à 470–600 €.
- Meilleur matériel, si vous le trouvez au tarif → RTX 4060 Ti 16 Go. Au tarif conseillé de 399 € elle bat tout le reste ici, faisant tourner 14B en Q8 en GPU. Mais les annonces au tarif sont en rupture et les cartes disponibles coûtent ~560 €, hors du budget de cette page.
- Besoin de la capacité 30B ? → La fenêtre sous 500 € s'est refermée mi-2026 et ne s'est pas rouverte. La RTX 3090 occasion (24 Go) se négocie désormais à 850–1 050 €. Prévoyez 850 €+ pour une RTX 3090 d'occasion ou une RTX 4080 SUPER (16 Go) d'occasion — le neuf coûte désormais ~1 600 €.
- Utilisateur Windows, sans complications → RTX 4060 Ti 16 Go. NVIDIA CUDA offre le support Windows le plus large pour les LLM, le fine-tuning et les runtimes multimodaux.
Compatibilité logicielle par GPU
Les trois GPU font tourner Ollama et llama.cpp. Les différences apparaissent sur les outils avancés :
GPU | Ollama | LM Studio | vLLM | Text Gen WebUI | Fine-Tuning CUDA |
|---|---|---|---|---|---|
| Intel Arc B580 12 Go | ✅ (SYCL) | ⚠️ bêta | ❌ | ⚠️ partiel | ❌ |
| RTX 3060 12 Go | ✅ | ✅ | ✅ | ✅ | ✅ |
| RTX 4060 Ti 16 Go | ✅ | ✅ | ✅ | ✅ | ✅ |
Consommation électrique et exigences système
La consommation de la GPU détermine l'alimentation et le boîtier nécessaires. Faire tourner des LLM maintient la GPU à 80–100 % d'utilisation en continu — contrairement au jeu vidéo, il n'y a pas d'images inactives.
- Intel Arc B580 12 Go : 190 W — alimentation 650 W+ ; 8 broches standard
- RTX 3060 12 Go : 170 W — fonctionne avec une alimentation 550 W+ ; un connecteur 8 broches
- RTX 4060 Ti 16 Go : 165 W — fonctionne avec une alimentation 550 W+ ; un connecteur 8 broches
8 Go de VRAM suffisent-ils pour les LLMs en local ?
8 Go de VRAM limitent aux modèles 7B en quantification Q4. Pour une utilisation locale sérieuse en 2026, 12 Go est le minimum pratique, 16 Go est recommandé.
Peut-on encore acheter une RTX 3090 occasion pour moins de 500 € ?
Non. Les RTX 3090 d'occasion se négocient à 850–1 050 € sur eBay.fr. Le prix a d'abord augmenté quand les passionnés de LLM ont reconnu la valeur des 24 Go de VRAM, puis de nouveau pendant la pénurie de mémoire de 2026. Ce n'est plus une option sous 500 €, et ça ne l'est plus depuis un moment. Si vous avez besoin de la capacité 30B (qui exige 24 Go de VRAM), prévoyez 850 €+ pour une RTX 3090 d'occasion ou ~850 € pour une RTX 4080 SUPER (16 Go) d'occasion — le neuf coûte désormais ~1 600 €.
Les GPU AMD fonctionnent-elles pour l'IA locale ?
Oui, avec des nuances. Ollama sous Linux avec ROCm fonctionne bien sur des cartes comme la RX 7800 XT. Le support ROCm sous Windows s'est amélioré mais nécessite encore des étapes manuelles, et le fine-tuning (LoRA) sur matériel AMD n'est pas supporté par la plupart des outils. Note sur les prix : la RX 7800 XT 16 Go est montée à ~682 € en juillet 2026, elle ne rentre donc plus dans un budget sous 500 € — pour cette gamme de prix, la RTX 4060 Ti 16 Go ou la RTX 3060 12 Go (toutes deux NVIDIA/CUDA) sont les choix recommandés. Pour Windows ou le fine-tuning, restez sur NVIDIA.
Qu'en est-il des GPU Intel Arc pour l'IA ?
L'Intel Arc B580 12 Go est la meilleure option Arc en 2026 et, depuis que la pénurie de mémoire a repositionné le camp NVIDIA, la meilleure carte de cette page tout court. Il fait tourner Ollama sous Windows et Linux via le backend SYCL, même si les performances restent 30–40 % en dessous de NVIDIA en tok/s bruts. L'argument prix est désormais décisif et non plus seulement bon : 12 Go de VRAM à 250–290 € quand les cartes NVIDIA comparables sont à 470–600 €. La limite principale reste le logiciel — vLLM, les outils de fine-tuning et les runtimes multimodaux ne prennent pas encore bien en charge Arc — donc si vous avez besoin du fine-tuning LoRA, achetez plutôt une RTX 3060 12 Go d'occasion.
Puis-je faire tourner un modèle 70B sur une seule GPU sous 500 € ?
Pas à pleine vitesse. Même la RTX 3090 (24 Go) ne peut pas contenir 70B Q4 (~40 Go) entièrement en VRAM. Vous pouvez utiliser l'offloading CPU avec llama.cpp pour répartir le modèle entre la VRAM et la RAM système, mais la vitesse chute à 2–5 tok/s — trop lent pour un usage interactif. Pour faire tourner des modèles 70B à une vitesse utilisable, il faut deux GPU (2× RTX 3090, soit 48 Go au total) ou de l'inférence cloud.
Les nouvelles GPU (RTX 5060 Ti) rendront-elles ces cartes obsolètes ?
La RTX 5060 Ti 16 Go est sortie, et elle n'a pas passé sous la RTX 4060 Ti : c'est l'inverse qui s'est produit. Lancée à un tarif conseillé de 429 $, elle se vend maintenant autour de 800 € (médiane récente de 805 $), environ 88 % au-dessus du tarif, parce que la pénurie de mémoire qui a repositionné toute cette liste l'a frappée le plus fort en tant que carte de génération actuelle. C'est une GPU réellement meilleure que tout ce qui figure ici, avec 16 Go de VRAM et une inférence plus rapide, mais ce n'est pas une carte sous 500 €, et attendre qu'elle le devienne n'est pas un plan tenable. Achetez selon ce qui est disponible : l'Intel Arc B580 12 Go à 250–290 €, ou une RTX 3060 12 Go d'occasion à 270–300 € si vous avez besoin de CUDA.
Combien coûte une RTX 4060 Ti 16 Go d'occasion ?
Les RTX 4060 Ti 16 Go d'occasion ont suivi la hausse du neuf : avec des cartes neuves disponibles autour de 560 €, les annonces d'occasion tournent désormais entre 420 et 480 € sur eBay.fr, selon l'état et la garantie restante. C'est l'une des rares cartes où l'occasion ne représente pas une grosse économie, car l'offre de cartes neuves au tarif conseillé s'est tarie.