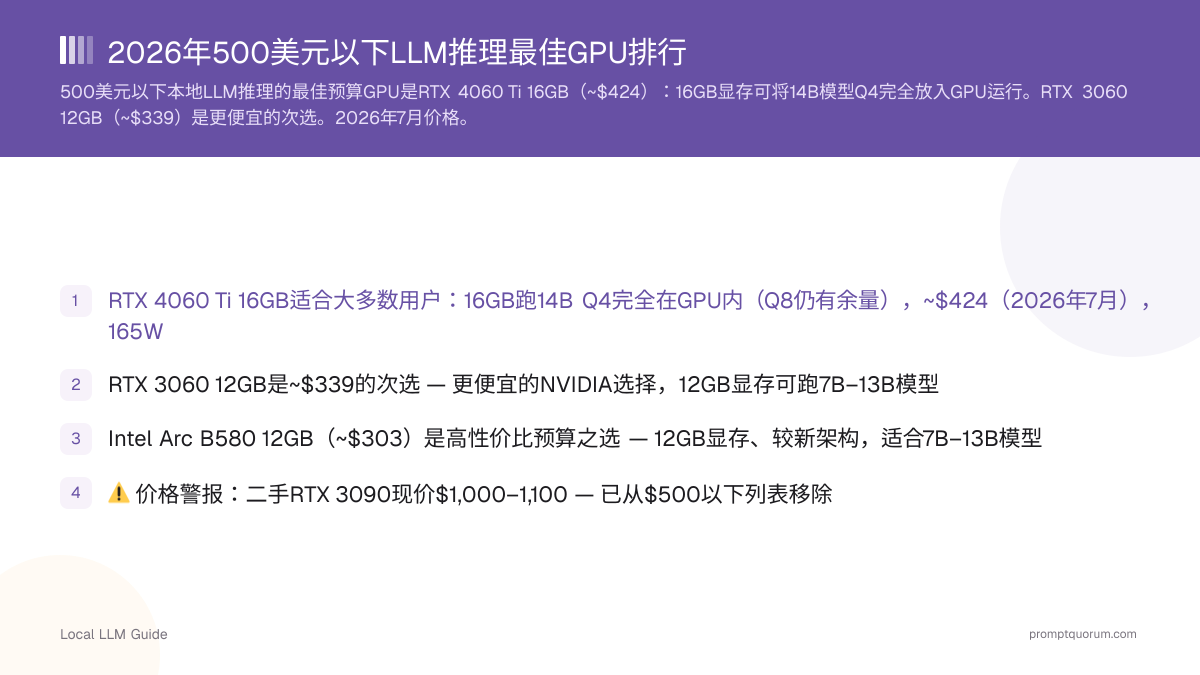
关键要点
- Intel Arc B580 12GB适合大多数用户:12GB显存、$250–290、Llama 3.1 8B Q4约31 tok/s — 唯一稳定低于$500的全新12GB显卡
- 二手RTX 3060 12GB($270–300)是次选 — 获得完整CUDA工具链的最便宜途径
- ⚠️ 价格警报:此前的冠军RTX 4060 Ti 16GB在$399官方定价下缺货,有货时约$562 — 已从$500以下列表移除
- ⚠️ 价格警报:全新RTX 3060 12GB现价$474–599,自重新上市以来上涨45% — 这张卡走二手市场才合理
- ⚠️ 价格警报:二手RTX 3090现价$850–1,050,RTX 4070 12GB现价$560–705 — 均已从$500以下列表移除
- ⚠️ 价格警报:RX 7800 XT 16GB现价约$832 — 已从$500以下列表移除
- 为什么全都变了:AI数据中心需求引发的全球DRAM与GDDR7短缺,已将显卡成交价在整个市场推高至远超官方定价的水平。硬件本身没有变化,变的只是价格。需要30B模型能力?请为二手RTX 3090(24GB)预算$850以上。
- 列表中所有3款GPU均可直接运行Ollama、LM Studio和llama.cpp
500美元以下LLM推理GPU排名
📍 简单一句话
Intel Arc B580 12GB是500美元以下本地LLM推理的最佳GPU,因为在2026年存储器短缺之后,它是唯一仍能稳定以500美元以下买到的全新12GB显卡。
💬 简单来说
GPU显存决定了你能在本地运行哪些AI模型。16GB显存支持14B模型。24GB(二手RTX 3090)支持30B模型。12GB以下只能运行7B或更小的模型。
Intel Arc B580 12GB — 综合最佳 ($250–290)
Intel Arc B580 12GB是$500以下本地LLM推理的最佳GPU,很大程度上是因为它是这一价位里唯一稳定留下来的一张卡。 它发售价$249,如今仍以$250–290在售;而曾经占据这份榜单的每一张NVIDIA显卡,都已被2026年的存储器短缺推到$500以上。它通过SYCL/oneAPI后端在Linux和Windows上运行Ollama,Llama 3.1 8B Q4约28–35 tok/s。12GB显存上限意味着只能跑13B模型的Q4,装不下14B的Q8。Intel的驱动支持自发售以来已大幅改善,但在工具生态的广度上仍落后于CUDA:Ollama和llama.cpp可以正常使用,LoRA微调则相当别扭。
二手RTX 3060 12GB — 最佳CUDA选择 ($270–300)
NVIDIA GeForce RTX 3060 12GB是获得完整CUDA工具链的最便宜途径,但请买二手。它以$339重返零售的价格没有守住:全新卡已上涨约45%至$474–599,这让全新卡触及甚至越过了本文所讨论的$500上限。二手市场的波动小得多,为$270–300。12GB GDDR6可轻松运行7B–13B模型的Q4/Q8;它无法容纳14B模型的Q8,但14B的Q4(约8.5GB)可以装下。基准测试:Ollama下Llama 3.1 8B Q4约32–40 tok/s。完整的CUDA工具链意味着Ollama、LM Studio、vLLM和LoRA微调在Windows和Linux上开箱即用——这正是Arc B580无法比拟的一点。
RTX 4060 Ti 16GB — 最强的卡,前提是能按官方定价买到 ($399官方定价,有货时约$562)
RTX 4060 Ti 16GB依然是本榜单中最好的*硬件*,在2026年存储器短缺之前一直是本文的冠军。16GB GDDR6可将Qwen3 14B和Mistral 12B的Q4完全放入GPU运行,Q8也无需交换;Ollama下7B Q4为45–60 tok/s,14B Q8为18–25 tok/s,165W的TDP任何650W电源都能应付。问题在于买不到。$399官方定价的货源在主流零售商处缺货,可查证的最便宜现货约$562,比官方定价高约41%。如果你能以官方定价或接近的价格买到,它是本文中最值得的选择;但在$562的价位,它已经超出了本文所面向的预算。
性能对比 — 当前价格与测试结果
基准测试使用Ollama 0.30.x、llama.cpp服务端,模型来自HuggingFace。测试系统:Ryzen 9 7950X、64GB DDR5、NVMe SSD。速度与此前测试相比没有变化:变的不是硬件,而是价格。因超出$500而排除:二手RTX 3090($850–1,050)、RTX 4070 12GB($560–705)、RX 7800 XT 16GB(约$832)以及全新RTX 3060 12GB($474–599)。
GPU | 显存 | 价格 | Llama 3.1 8B Q4 tok/s | Qwen3 14B Q8 tok/s | 最大模型(Q4) |
|---|---|---|---|---|---|
| Intel Arc B580 12GB ★ | 12GB | $250–290 | 31 tok/s | 显存受限 | — |
| RTX 3060 12GB(二手) | 12GB | $270–300 | 36 tok/s | 显存受限 | — |
| RTX 4060 Ti 16GB | 16GB | 有货时约$562 | 55 tok/s | 22 tok/s | — |
我们如何挑选并测试这些GPU
筛选标准:能以新品或二手价格在$500以下购得;至少支持一种主流推理运行时(Ollama、LM Studio、llama.cpp);显存≥12GB(8GB显卡已排除)。多款显卡因价格被移出榜单:二手RTX 3090(24GB)现价$850–1,050;RTX 4070 12GB为$560–705;RX 7800 XT 16GB约$832;以$339重新上市的全新RTX 3060 12GB已上涨约45%至$474–599。RTX 4060 Ti 16GB予以保留但加注提醒——$399官方定价缺货,现货约$562。原因是共通的:AI数据中心需求引发的全球DRAM与GDDR7短缺,已将成交价在整个市场推高至远超官方定价的水平,NVIDIA RTX 50系列成交价约高出建议零售价36–39%,AMD也将Radeon上调约10%。所有基准均为tok/s,批大小为1、取10次运行平均,在Ubuntu 22.04 LTS上使用Ollama 0.30.x测得。
按模型规模划分的显存需求
📍 简单一句话
显存需求:7B模型需要约4–5GB(Q4)或约7–8GB(Q8);14B模型需要约8–9GB(Q4)或约14–15GB(Q8);30B模型需要约18–20GB(Q4);70B模型需要约40–42GB(Q4)。
💬 简单来说
可以把显存理解为AI模型专用的内存。模型必须完全放入显存才能快速推理。如果溢出到CPU内存(称为"卸载"),速度会下降80–95%。Q4量化相比Q8体积减半,质量损失很小。
- 7B模型Q4:约4.5GB显存——本榜单任意一款GPU都能轻松运行
- 7B模型Q8:约7.5GB显存——本榜单所有GPU均可运行
- 13B模型Q4:约8.5GB显存——本榜单所有GPU均可运行
- 14B模型Q8:约14GB显存——仅RTX 4060 Ti 16GB和二手RTX 3090支持,但两者现在都不在$500以下
- 30B模型Q4:约18GB显存——仅RTX 3090(24GB)可轻松胜任
- 70B模型Q4:约40GB——需要双GPU或CPU卸载
你应该买哪款GPU?
根据你的主要用途参考以下决策指南:
- $500以下综合最佳 → Intel Arc B580 12GB($250–290)。唯一稳定低于$500的全新12GB显卡。7B–13B模型Q4,Llama 3.1 8B Q4约31 tok/s,通过SYCL在Windows和Linux上运行Ollama。
- 能用的最便宜CUDA显卡 → 二手RTX 3060 12GB($270–300)。以与Arc相近的价格获得完整CUDA工具链——Ollama、LM Studio、vLLM和LoRA微调。请买二手:全新已是$474–599。
- 最强硬件,前提是能按官方定价买到 → RTX 4060 Ti 16GB。在$399官方定价下它胜过这里的一切,可将14B的Q8放入GPU运行。但官方定价缺货,现货约$562,超出本文预算。
- 需要30B模型能力? → $500以下窗口已在2026年年中关闭且未再打开。二手RTX 3090(24GB)现价$850–1,050。请预算$850以上购买二手RTX 3090,或购买二手RTX 4080 SUPER(16GB)——新品短缺后现售约$1,600。
- Windows用户,追求省心 → 二手RTX 3060 12GB。NVIDIA CUDA在LLM、微调和多模态运行时方面拥有最广泛的Windows工具链支持,而二手3060是进入这一生态最便宜的方式。
各GPU的软件兼容性
三款GPU均可运行Ollama和llama.cpp,差异体现在高级工具上:
GPU | Ollama | LM Studio | vLLM | Text Gen WebUI | CUDA微调 |
|---|---|---|---|---|---|
| Intel Arc B580 12GB | ✅(SYCL) | ⚠️ 测试版 | ❌ | ⚠️ 部分支持 | ❌ |
| RTX 3060 12GB | ✅ | ✅ | ✅ | ✅ | ✅ |
| RTX 4060 Ti 16GB | ✅ | ✅ | ✅ | ✅ | ✅ |
功耗与系统要求
GPU功耗决定了你需要的电源和机箱。运行LLM会让GPU持续保持80–100%的利用率——与游戏不同,没有空闲帧。
- RTX 4060 Ti 16GB:165W——550W以上电源即可;单8针接口
- RTX 3060 12GB:170W——550W以上电源即可;单8针接口
- Intel Arc B580 12GB:190W——需650W以上电源;标准8针
8GB显存跑本地大模型够用吗?
8GB显存只能运行7B模型的Q4量化版本。13B模型无法完全放入显存,14B模型需要卸载到CPU内存,速度下降80–95%。2026年本地LLM实际使用中,12GB是最低要求,推荐16GB。
二手RTX 3090还能以$500以下买到吗?
不能。eBay上的二手RTX 3090交易价格为$850–1,050。价格先是在LLM爱好者认识到24GB显存的价值后上涨,随后又在2026年的存储器短缺中再度上涨。它早已不是$500以下的选项。需要30B模型能力(需24GB显存),请预算$850以上购买二手RTX 3090,或考虑二手RTX 4080 SUPER(16GB,约$850;新品短缺后约$1,600)以获得更快的14B Q8性能。
AMD显卡能用于本地AI吗?
可以,但有条件。Linux上Ollama的ROCm后端对RX 7800 XT等显卡效果良好。Windows ROCm支持在改善中,但仍需手动步骤,且大多数工具不支持在AMD硬件上进行LoRA微调。价格提示:RX 7800 XT 16GB已涨至约$832,因此不再符合$500以下预算——在这个价位应选二手RTX 3060 12GB($270–300,CUDA)或Intel Arc B580 12GB($250–290)。若使用Windows或需要微调,请坚持选择NVIDIA。
AI用的Intel Arc显卡怎么样?
Intel Arc B580 12GB是2026年最佳的Arc选择;在存储器短缺重新定价了NVIDIA阵营之后,它也成了本文整体上最好的一张卡。它通过SYCL后端在Windows和Linux上运行Ollama,但原始tok/s性能比NVIDIA低30–40%。性价比如今已不只是有吸引力,而是决定性的:12GB显存$250–290,而同级NVIDIA显卡要$474–599。主要限制仍在软件层面:vLLM、微调工具和多模态运行时对Arc的支持仍不完善,因此若需要LoRA微调,请改买二手RTX 3060 12GB。
单块500美元以下的GPU能跑70B模型吗?
无法流畅运行。即使是RTX 3090(24GB)也无法将70B Q4(约40GB)完全装入显存。用llama.cpp进行CPU卸载可以分割模型,但速度降至2–5 tok/s,无法交互使用。流畅运行70B模型需要双GPU(如2×RTX 3090共48GB)或云推理服务。
新款GPU(RTX 5060 Ti)会让这些显卡过时吗?
RTX 5060 Ti 16GB已经上市,而且并没有低于RTX 4060 Ti,反而相反。它以$429官方定价发布,如今售价约$800(近期中位数为$805),比官方定价高约88%——因为让整份榜单重新定价的那场存储器短缺,对身为当代产品的它冲击最大。它确实是比这里任何一张都更好的GPU,拥有16GB显存和更快的推理速度,但它不是$500以下的显卡,而等待它降到那个价位并不是一个值得依赖的计划。请按现在买得到的东西决策:Intel Arc B580 12GB为$250–290,若需要CUDA则选二手RTX 3060 12GB($270–300)。
二手RTX 4060 Ti 16GB多少钱?
二手RTX 4060 Ti 16GB的价格跟随新品一起上涨:由于有货的新品约$562,二手在eBay上的报价现在大约是$420–480,具体取决于成色和剩余保修。这是少数几张买二手也省不了多少钱的显卡,因为按官方定价供应的新品已经断货。查看eBay上已售出(而非在售)的成交记录更准确。