Key Takeaways
- Mejor opción por presupuesto: Menos de $250 — RX 6700 XT 12GB ($175–250, la 12 GB más barata, fricción de configuración AMD). $270–300 usada — RTX 3060 12GB (mejor opción de segunda mano). $570–600 nueva — RTX 5060 Ti 16GB (mejor tarjeta nueva, más margen de VRAM). $550–700 — RTX 4070 Super 12GB (la más rápida, 25–30 tok/s).
- RTX 3060 12GB ($270–300 usada): Ejecuta todos los modelos 7B-8B en Q4/Q5 y la mayoría de los densos 13B-14B en Q4. Mejor opción económica de segunda mano.
- RTX 5060 Ti 16GB ($570–600 nueva): Tarjeta de generación actual con 4 GB más de VRAM que la 3060 — encaja cómodamente con modelos 13B-14B con margen para ventanas de contexto mayores. Mejor opción económica nueva, aunque se vende alrededor de un 40 % por encima de su precio de lanzamiento de $429.
- Los precios se movieron; el hardware no: la escasez mundial de DRAM y GDDR7 de 2026, impulsada por la demanda de los centros de datos de IA, elevó los precios de calle en toda la gama. Cada cifra de tok/seg de esta página sigue siendo válida — lo único que cambió es lo que pagas. Las tarjetas de estación de trabajo que antes eran gangas económicas (RTX A4000, RTX A2000) cuestan ahora $440–850 de segunda mano y ya no pertenecen a una lista económica.
- RTX 3060 6GB: Limitada a modelos 3B (Phi-4 Mini, Llama 3.2 3B). Insuficiente para 7B.
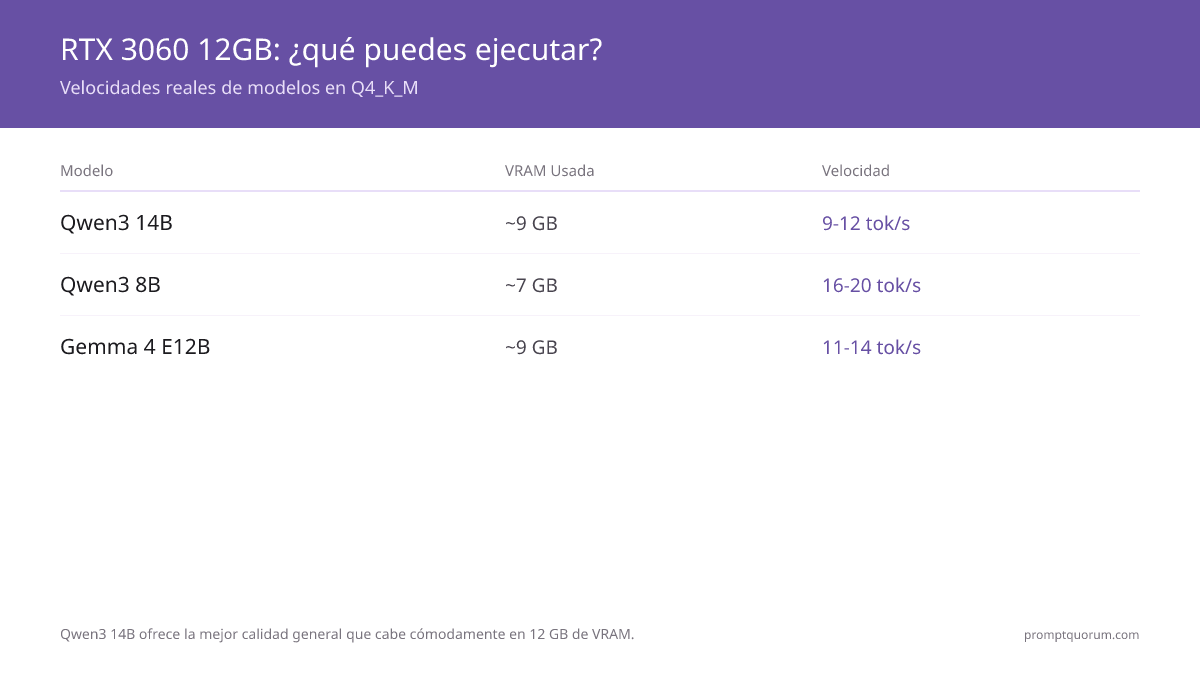
- Mejor modelo general en 12GB: Qwen3 14B a ~9 GB VRAM, 9–12 tok/seg. Mejor calidad densa que cabe cómodamente.
- Mejor modelo de código en 12GB: Qwen3 8B a 16–20 tok/seg.
- Mejor modelo de razonamiento en 12GB: DeepSeek-R1 7B a 10–12 tok/seg. Chain-of-thought.
- Descártalo si: quieres modelos de 70B, Llama 4 Scout (necesita ~55 GB) o 13B en Q8 — necesitas 24GB+ (RTX 4090).
La RTX 3060 12 GB (270–300 $ de segunda mano) mueve Qwen3 14B a 9–12 tok/s y es la mejor GPU económica para LLM locales en 2026.
Lo que decide no es la potencia bruta sino la VRAM: con 12 GB entra un modelo de 14B en 4 bits; la versión de 6 GB solo llega a modelos de 3B. Qwen3 8B va a 16–20 tok/s y Mistral Small a 18 tok/s en la misma tarjeta.
¿Qué puedes ejecutar en RTX 3060 12GB?
La RTX 3060 12GB es la mejor GPU económica para LLMs locales en 2026. 12GB de VRAM cabe con todos los modelos 7B en cuantización Q4/Q5, y la mayoría de los 13B en Q4. Para orientación detallada sobre los requisitos de VRAM según el tamaño del modelo, consulta la guía de requisitos de VRAM →. Aquí están los modelos exactos y las velocidades que puedes esperar:
Modelo | Tamaño | Cuantización | VRAM usada | Velocidad | Ideal para |
|---|---|---|---|---|---|
| Qwen3 14B | 14B (denso) | Q4_K_M | ~9 GB | 9–12 tok/seg | Mejor calidad general que cabe |
| Qwen3 8B | 8B | Q4_K_M | ~7 GB | 16–20 tok/seg | Código, uso general |
| Gemma 4 E12B | 26B MoE | Q4_K_M | ~9 GB | 11–14 tok/seg | Visión, multimodal |
| Mistral Small v0.3 | 7B | Q4_K_M | ~7 GB | 18 tok/seg | Seguimiento de instrucciones |
| DeepSeek-R1 7B | 7B | Q4_K_M | ~7 GB | 10–12 tok/seg | Razonamiento, matemáticas |
| Gemma 4 E4B | E4B (multimodal) | Q4_K_M | ~5 GB | 18–22 tok/seg | Visión ligera, chat rápido |
| Llama 3.2 13B | 13B | Q4_K_M | ~11 GB | 8–10 tok/seg | Chat de mayor calidad (solo Q4, ajustado) |
Qwen3 14B (denso) es el modelo de mayor calidad que cabe cómodamente en una RTX 3060 12GB a Q4_K_M, usando ~9 GB. `ollama pull qwen3:14b`. Nota: Llama 4 Scout (MoE de 17B activos / 109B totales, contexto de 10M tokens, multimodal) necesita ~55 GB en Q4 y no cabe en 12 GB normalmente — es una opción de contexto largo / multimodal grande para equipos con mucha VRAM, no una recomendación de GPU económica. gpt-oss:20b (21B totales / 3.6B activos MoE) necesita 16 GB, por lo que queda justo fuera del alcance de una tarjeta de 12 GB. Todas las velocidades medidas con Ollama en RTX 3060 12GB, 16GB de RAM del sistema, Ryzen 7 7700X. Cuantización Q4_K_M. Las velocidades varían ±15% según la longitud del prompt y la ventana de contexto.
¿Qué puedes ejecutar en RTX 3060 6GB?
La variante de 6GB está muy limitada. Solo los modelos de 3B caben cómodamente. Los modelos 7B en Q4 necesitan ~7GB — más de lo disponible. El offloading a CPU funciona pero reduce la velocidad un 50–70%.
- Phi-4 Mini 3.8B (Q4): ~3GB VRAM, 20–25 tok/seg. Mejor razonamiento en este tamaño. Potente para matemáticas y lógica.
- Llama 3.2 3B (Q4): ~2.5GB VRAM, 25–35 tok/seg. Opción más rápida. Buena para chat simple y preguntas y respuestas.
- Gemma 2 2B (Q4): ~1.7GB VRAM, 35–45 tok/seg. Modelo más ligero. Buena para probar configuraciones.
- 7B con offloading: Posible pero lento. Llama 7B con offload a CPU = ~5–8 tok/seg. Utilizable solo para trabajo por lotes no interactivo.
- Recomendación: Si tienes una tarjeta de 6GB, actualiza a 12GB usada ($270–300) antes de invertir tiempo en soluciones alternativas. La mejora en velocidad y calidad del modelo vale la pena.
RTX 3060 vs otras GPUs económicas
GPU | VRAM | Precio (usada) | Velocidad 7B | Modelo máx. | Veredicto |
|---|---|---|---|---|---|
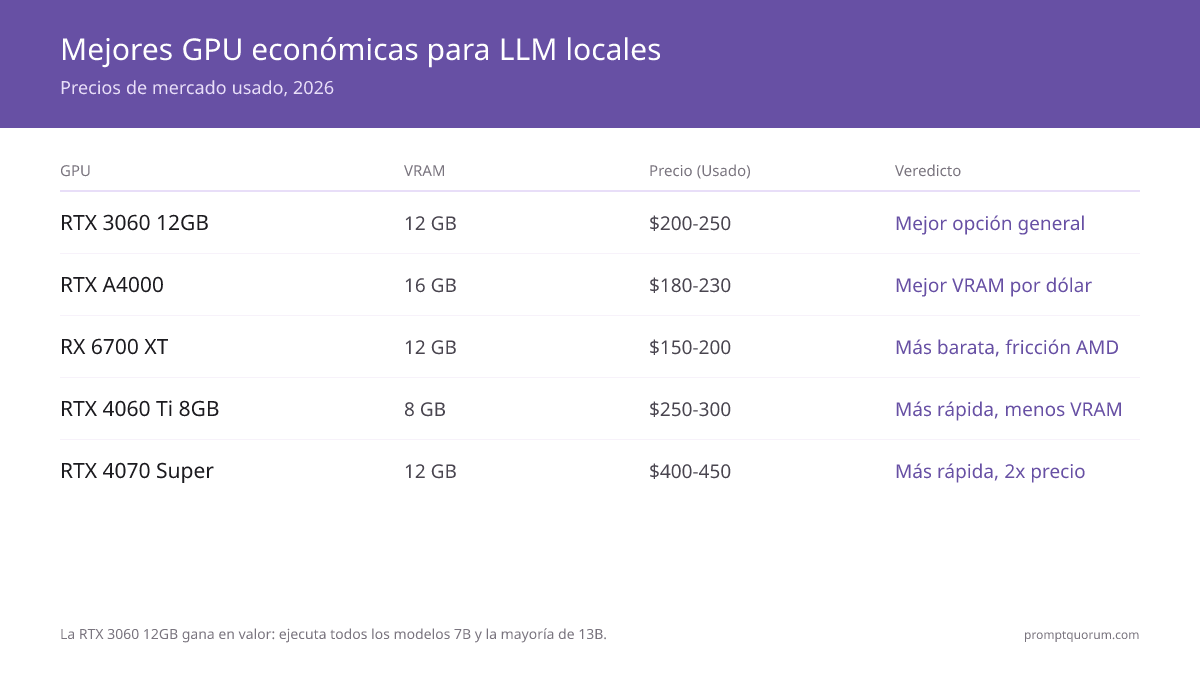
| RTX 3060 12GB ★ | 12 GB | $270–300 | 15–20 tok/seg | 13B (Q4) | Mejor opción de segunda mano |
| RTX 5060 Ti 16GB | 16 GB | ~$570–600 nueva | 25–30 tok/seg | 20B (Q4) | Mejor opción nueva económica |
| RTX 4060 Ti 8GB | 8 GB | ~$270 (nueva desde $420) | 20–25 tok/seg | 7B (Q5 máx) | Más rápida pero menos VRAM |
| RTX A4000 | 16 GB | $790–850 | 12–15 tok/seg | 13B (Q5) | Ya no es económica |
| RTX 4070 Super | 12 GB | $550–700 nueva | 25–30 tok/seg | 13B (Q5) | La 12 GB más rápida, 2× el precio |
| RX 6700 XT | 12 GB | $175–250 | 10–14 tok/seg | 13B (Q4) | La 12 GB más barata, fricción AMD |
RTX 3060 12GB gana en valor de segunda mano: 12GB de VRAM a $270–300 ejecuta todos los modelos 7B y la mayoría de los 13B. Si compras nueva, la RTX 5060 Ti 16GB ($570–600) es la opción de generación actual con más margen de VRAM, aunque supera en torno a un 40 % su precio de lanzamiento. La RX 6700 XT es la vía más barata a 12 GB, a $175–250 de segunda mano, si aceptas la configuración ROCm de AMD. La RTX A4000 era antes la ganadora en VRAM por dólar aquí; a $790–850 de segunda mano ya no lo es y ha sido degradada en consecuencia. Los precios pueden variar según tu país.
¿Cuánta VRAM necesitas para modelos 7B?
Los modelos 7B cuantizados a Q4 (4 bits) requieren 6-8GB de VRAM; Q5 (5 bits) requiere 8-10GB; Q8 (8 bits) requiere 14-16GB.
En la práctica: 8GB es el mínimo absoluto para una inferencia cómoda en modelos 7B a Q4 con margen para procesamiento por lotes.
Las tarjetas de 6GB (RTX 2060) funcionan técnicamente pero requieren una optimización agresiva y no dejan margen para lotes más grandes.
Si tienes menos de 8 GB de VRAM, aún puedes ejecutar LLMs locales eficazmente — consulta los modelos optimizados para hardware de 4–8 GB.
El costo de la GPU es un lado de la economía; el costo por token es el otro. La inferencia local elimina las tarifas de API por token, pero la longitud del prompt sigue afectando la latencia y el rendimiento. Para ver el panorama completo de costos — tokens, niveles de precios y estrategias de optimización — consulta tokens, costos y límites: la economía del prompting con IA.
Mejores modelos por caso de uso en RTX 3060
Elige tu modelo según lo que realmente necesitas, no según el número de parámetros. Estas son las mejores opciones para cada caso de uso en RTX 3060 12GB:
El hardware económico ejecuta modelos más pequeños — pero un buen prompting cierra la brecha de calidad. La guía de prompt engineering cubre técnicas como chain-of-thought y salidas estructuradas que ayudan a los modelos pequeños a rendir por encima de su tamaño. Una carga de trabajo concreta que encaja en el nivel RTX 3060 12 GB es la revisión automatizada de pull requests — consulta revisión de código con LLM local en CI/CD para ver el patrón de GitHub Actions que ejecuta Qwen3 8B contra PRs en exactamente este hardware.
- Chat / Preguntas y respuestas: `ollama run qwen3:14b` — denso de 14B, ~9 GB VRAM, mejor calidad en 12 GB. Para una opción más ligera: `ollama run qwen3:8b` a ~7 GB.
- Código: `ollama run qwen3:8b` — sólido para código de uso general. ~7 GB VRAM. 16–20 tok/seg.
- Razonamiento / Matemáticas: `ollama run deepseek-r1:7b` — Razonamiento chain-of-thought. 10–12 tok/seg. Más lento pero significativamente más preciso en problemas de varios pasos.
- Escritura / Creatividad: `ollama run mistral:7b` — Mejor seguimiento de instrucciones. 18 tok/seg. Salida limpia y estructurada. Ideal para borradores y reescrituras.
- Visión / Imágenes: `ollama run gemma4:e12b` — Multimodal (acepta imágenes). 11–14 tok/seg. Usa ~9GB VRAM. Para una opción más ligera, `ollama run gemma4:e4b` a ~5 GB. Describe fotos, lee capturas de pantalla, analiza gráficos.
- Privacidad / Sin conexión: Cualquiera de los anteriores. Todos se ejecutan 100% localmente. Ningún dato sale de tu equipo. No requiere internet después de descargar el modelo.
- Automatización del hogar / IA siempre activa: `ollama run phi4-mini` — Phi-4 Mini (3,8B, ~3 GB VRAM) gestiona consultas de voz de Home Assistant en una mini PC sin GPU dedicada. Consulta mejor hardware para IA en smart home →.
Usada vs. nueva: ¿dónde comprar?
- Usada ($150-300 más barata): eBay, Facebook Marketplace, Craigslist, tiendas locales de reparación de computadoras. Mayor riesgo de tarjetas defectuosas o VRAM dañada. Prueba siempre antes de comprometerte.
- Nueva ($420-700): Newegg, Amazon, Best Buy, Microcenter. Garantía incluida. Sin sorpresas. Precios estables. Ideal para compradores que prefieren evitar riesgos.
- Tarjetas de minería (cripto, muy baratas): Riesgo extremo. La degradación de la VRAM es habitual. Compra solo si puedes hacer pruebas de estrés completas en el lugar.
Errores comunes con GPUs económicas
- Comprar una RTX 2060 de 4GB esperando una inferencia fluida de 7B — obtendrás errores de memoria constantemente.
- Combinar una GPU de $250 con una fuente de alimentación de $30 — la caída de voltaje arruina la estabilidad. Presupuesta al menos 650W con certificación 80+ Gold.
- Asumir que la RAM DDR5 y la CPU i9 aceleran la inferencia de LLMs — no lo hacen. El ancho de banda de la VRAM de la GPU es el único cuello de botella que importa para la velocidad de inferencia.
- Asumir que Llama 4 Scout cabe en 12 GB. Scout es un MoE de 17B activos / 109B totales que necesita ~55 GB en Q4 (solo entra en 24 GB con un cuant extremo de 1.78-bit, ~20 tok/s). En una RTX 3060 de 12 GB, ejecuta modelos densos en su lugar: Qwen3 14B (~9 GB), Qwen3 8B o Gemma 4 E12B.
- Comprar una tarjeta de 16 GB solo para modelos 13B. Una RTX 3060 de 12 GB ya ejecuta Qwen3 14B en Q4. Pasa a 16 GB solo si necesitas específicamente gpt-oss:20b (16 GB), modelos densos de 20B+ o más margen de contexto.
Próximos pasos
- Mejores GPU AMD para LLM local — ¿Consideras AMD? Comparativa completa AMD vs NVIDIA →
- Mejores modelos Ollama de código abierto — Qué modelos rinden mejor en una GPU de bajo costo →
- ¿Cuánta VRAM necesito? — Ajusta tu GPU al tamaño del modelo →
Preguntas frecuentes
¿Sigue valiendo la pena comprar una RTX 3060 12GB en 2026?
Sí. Tiene más de 4 años, pero 12GB de VRAM sigue siendo muy relevante. Ejecuta Qwen3 14B, Qwen3 8B, Gemma 4 E12B y Mistral Small sin problemas en Q4. Cabe con todos los modelos 7B-8B y la mayoría de los densos 13B-14B.
¿Debería comprar RTX 5060 Ti o RTX 4060 Ti para LLMs locales?
RTX 5060 Ti 16GB ($570-600) sigue siendo la mejor compra nueva: 8 GB más de VRAM que la RTX 4060 Ti de 8GB y un 10-15% más rápida. Es la opción económica de generación actual para una tarjeta nueva, aunque la escasez de memoria de 2026 la ha situado en torno a un 40 % por encima de su precio de lista. Si tienes restricciones de presupuesto, la RTX 4060 Ti de 8GB sigue siendo sólida para modelos 7B. Evita la base 4060/5060 (8GB) y la 4070 (12GB) si planeas ejecutar modelos 13B+ — poco margen de VRAM.
¿Puedo usar una AMD RX 7900 XT o RX 7900 XTX en su lugar?
Sí, pero el soporte de drivers de AMD es más débil que NVIDIA + CUDA. La configuración de HIP/ROCm requiere más esfuerzo. RTX es más segura para principiantes.
¿12GB de VRAM es suficiente para modelos de 13B?
Por muy poco, a cuantización Q4. Q5 o Q8 provocarán errores OOM. Si quieres un 13B cómodo, apunta a 16GB.
¿Debería comprar una GPU empresarial usada como RTX A4000?
Ya no. La RTX A4000 fue una ganga económica real mientras se vendía a $180-230 de segunda mano, pero la escasez de memoria de 2026 la ha llevado a $790-850 usada — cerca del triple que una RTX 3060 12GB por 4 GB más de VRAM y una inferencia más lenta. Lo mismo ocurre con la RTX A2000 12GB a $440-615. Compra en su lugar una RTX 3060 12GB usada o una RTX 5060 Ti 16GB nueva.
¿Cuántos vatios de fuente de alimentación debo comprar con una GPU de $300?
650W mínimo, con certificación 80+ Gold. Una GPU de $300 + CPU + placa base no supera los 400W de consumo, pero quieres margen para picos.
¿Puedo ejecutar Ollama con una GPU económica de $300?
Sí. Ollama es ligero. Una RTX 3060 de 4 años con Ollama ejecutará Qwen3 14B a 9-12 tok/seg o Qwen3 8B a 16-20 tok/seg — completamente utilizable para chat interactivo y asistencia de código.
¿Puedo ejecutar Llama 4 Scout en una RTX 3060 12GB?
Normalmente no. Llama 4 Scout es un MoE de 17B activos / 109B totales que necesita ~55 GB de VRAM en Q4 — muy por encima de una tarjeta de 12 GB. Solo entra en 24 GB con un cuant extremo de 1.78-bit (~20 tok/seg). En una RTX 3060 12GB, ejecuta modelos densos en su lugar: `ollama pull qwen3:14b` (mejor calidad que cabe), Qwen3 8B o Gemma 4 E12B. Scout es una opción de contexto largo (10M tokens) / multimodal grande para equipos con 48 GB+.
¿Puedo usar una AMD RX 6700 o 6800 XT en lugar de NVIDIA para LLMs locales?
Sí, pero el soporte de drivers de AMD para ONNX Runtime es más débil que NVIDIA CUDA. Espera más fricción en la configuración. NVIDIA es más segura para builds económicas.
¿Cuál es la mejor GPU económica por menos de $200?
Por debajo de $200 ya solo quedan tarjetas de 8 GB — en la práctica una RTX 2080 8GB usada a $110-195, que ejecuta modelos 7B en Q4 y nada mayor. Las opciones de 12 GB que antes bajaban de $200 han subido todas durante la escasez de memoria de 2026: la RX 6700 XT 12GB está a $175-250 usada y la RTX A2000 12GB a $440-615. Si puedes llegar a $250, la RX 6700 XT es la 12 GB más barata que merece la pena; a $270-300, la RTX 3060 12GB es la mejor compra.
¿Cómo pruebo una GPU usada en busca de defectos de VRAM antes de comprar?
Ejecuta pruebas de estrés de VRAM: gpu-burn (Linux), prueba de estrés de memoria HWiNFO64 (Windows), o carga un modelo grande en Ollama y observa si hay errores OOM. Prueba antes de devolver la tarjeta.
¿Puedo actualizar mi GPU para ejecutar modelos más grandes más adelante?
Sí, las actualizaciones de GPU son sencillas en PCs de escritorio. Comienza con RTX 3060 12GB y luego actualiza a RTX 4090 o 5090 más adelante. El slot PCIe es retrocompatible entre generaciones.
¿Cuál es la mejor GPU NVIDIA económica para inferencia de LLM local?
RTX 4060 Ti (8 GB, ~$250) para modelos 7B, o RTX 4070 Super (12 GB, ~$550-700) para modelos 13B. Usada: RTX 3060 12GB ($270–300) ejecuta modelos 7-13B sin problemas a Q4. El mejor valor es RTX 3060 12GB usada, o RTX 4070 Super nueva.
¿Cómo se compara la AMD 6800XT con la RTX 4070 para inferencia de IA?
AMD RX 6800 XT (16 GB) supera a RTX 4070 (12 GB) en VRAM y rendimiento en juegos, pero es más lenta en inferencia de LLMs (15-20% menos). La configuración del driver ROCm para llama.cpp también es más compleja que CUDA. Para trabajo puro con LLMs, RTX 4070 es más fácil; para juegos + LLMs, 6800 XT ofrece mejor valor.
¿Cuál es la GPU con mejor precio por GB de VRAM para LLMs locales en 2026?
RTX 3090 usada (24 GB, ~$850-1,050) = $35-44 por GB. RTX 3060 usada (12 GB, ~$270-300) = $23-25 por GB. RTX 4070 Ti (12 GB, ~$600 nueva) = $50 por GB. Mejor valor: RTX 3060 12GB usada. Mayor capacidad por dólar: RTX 3090 24GB usada. Balance precio + rendimiento: RTX 4070 nueva.
Lectura relacionada
- Mini PCs AMD Ryzen AI Max+ (2026) — Alternativa a las GPUs discretas: iGPU + NPU de 50 TOPS a $1.200–2.500.
- ¿Cuánta VRAM para LLMs locales?
- RTX 5090 vs RTX 4090
- GPUs usadas para LLMs locales
- Mejores GPUs para LLMs locales
- Calculadora de VRAM
- Laptop vs Desktop para LLMs locales — Comparación completa de plataformas: GPU de escritorio vs MacBook para LLMs locales.
- Prompt Engineering para LLMs locales — Optimiza prompts para modelos que se ejecutan en hardware económico.
- Prompting Chain-of-Thought — Mejora significativamente la calidad de salida de DeepSeek-R1.
- Mac Mini M5 como servidor de IA local — Alternativa económica a las builds de GPU: IA siempre activa a $599 de hardware + $35/año de electricidad.
- Apple Silicon M5 para LLMs locales — Guía completa de M5 Pro/Max: benchmarks, configuraciones de Mac, niveles de memoria y qué Mac comprar para inferencia local.
- Apple Silicon vs GPU NVIDIA para LLMs locales — Comparación completa de costo y rendimiento: cuándo un Mac supera a una GPU económica.
- Mejores modelos para Apple Silicon 2026 — Recomendaciones de modelos para niveles de memoria unificada de 16GB–128GB.
- Para precios de GPU en Japón, minoristas de Akihabara y opciones del mercado de segunda mano en Mercari y Yahoo Auctions, consulta nuestra <a href="/es/prompt-bites/best-gpu-local-llm-japan-price" class="text-primary hover:underline">guía de las mejores GPUs para LLMs locales en Japón</a>.
- Para precios de GPU en los Emiratos Árabes Unidos y el Golfo, minoristas como Sharaf DG, noon.com y Amazon.ae, además del mercado de segunda mano en dubizzle, consulta nuestra <a href="/es/prompt-bites/best-gpu-local-llm-uae-price" class="text-primary hover:underline">guía de la GPU con mejor relación calidad-precio para LLMs locales en los EAU</a>.
Fuentes
- Meta AI. (2025). "Llama 4 Model Card." — Arquitectura MoE de Scout, requisitos de VRAM
- Qwen Team. (2026). "Qwen3 Technical Report." — Especificaciones de Qwen3 8B
- Base de datos de GPUs TechPowerUp: especificaciones y consumo de energía de RTX 3060 / RTX 4060 Ti / RTX 4070 Super
- Matriz de capacidades CUDA de NVIDIA: ancho de banda de memoria de GPU y rendimiento teórico para cargas de trabajo de inferencia
- Requisitos de modelos de Ollama: recomendaciones de VRAM para niveles de cuantización de Llama 4 Scout, Qwen3 y Mistral Small
- El cumplimiento normativo requiere flujos de trabajo auditables. Establece estándares de gobernanza para la calidad y revisión de prompts de IA: gobernanza de prompts en producción cubre políticas, control de versiones y procesos de aprobación.