로컬 코딩 모델이 따라잡은 이유
LLM 시대 초기 몇 년 동안 클라우드 모델은 코딩 작업에서 로컬 모델을 분명히 앞섰습니다. 그 격차는 2025–2026년에 코딩 중심 학습을 받은 24–30B급 오픈 웨이트 모델이 등장하면서 줄었습니다.
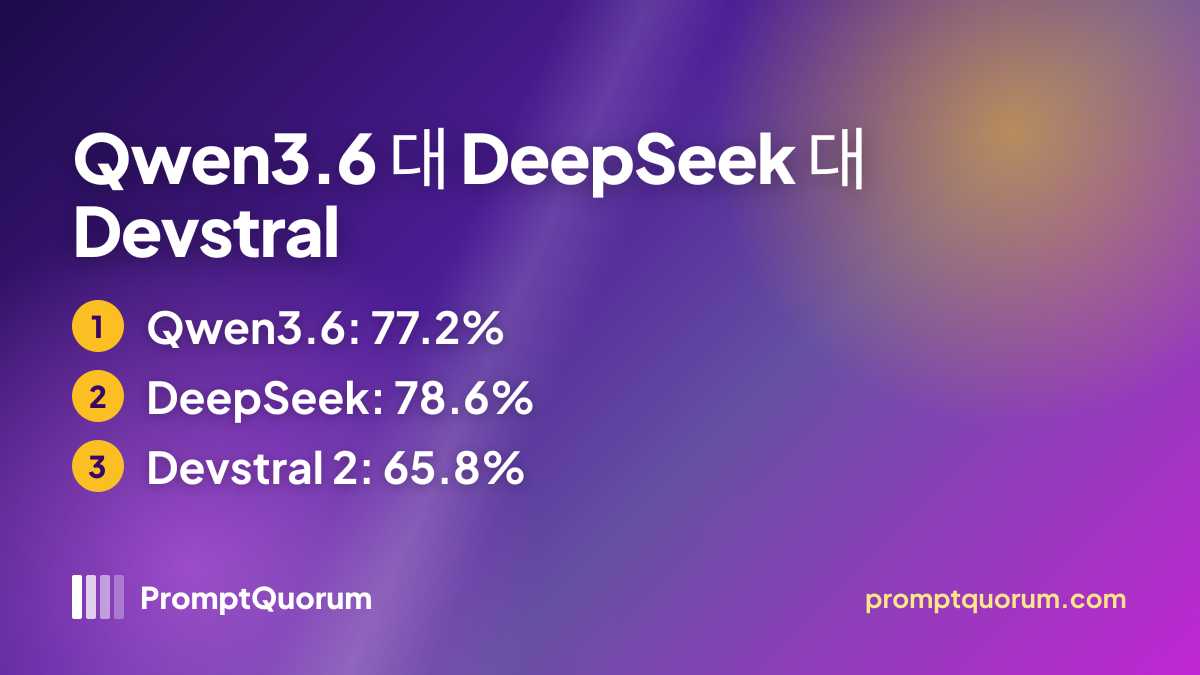
2026년 4월에 공개된 Qwen3.6 27B는 오픈소스 Python 프로젝트의 실제 GitHub 이슈로 구성된 벤치마크인 SWE-bench Verified에서 77.2를 보고했습니다. 같은 모델 카드 표에서 Qwen은 Qwen3.5-27B 75.0, Claude 4.5 Opus 80.9를 제시하므로, 이 벤더 발표 테스트에서 오픈 모델은 선두 클라우드 모델에 가깝습니다. 이는 Qwen이 자체 에이전트 환경으로 낸 결과이며 독립 검증이 아닙니다.
이러한 수렴의 이유로 흔히 꼽히는 것은 (1) 대규모 코딩 중심 학습 데이터, (2) 일반적인 지시 따르기가 아니라 실제 소프트웨어 엔지니어링 작업에 대한 후속 학습, (3) Q4 정밀도에서도 코딩 능력을 보존하는 더 나은 GGUF 양자화입니다.
Qwen3.6 27B는 SWE-bench Verified 77.2%를 보고했으며 18–19 GB 다운로드로 로컬 실행됩니다.
SWE-bench Verified는 AI가 Django, Flask, scikit-learn 같은 오픈소스 프로젝트의 실제 GitHub 이슈를 해결할 수 있는지 시험합니다. 77.2%는 벤더 자체 에이전트 환경으로 측정했을 때 테스트 과제 100개 중 약 77개를 해결했다는 뜻입니다.
벤치마크 표
모든 수치는 모델 카드와 Ollama 페이지에서 가져온 벤더 발표값입니다. 벤더마다 테스트 환경이 다르므로 SWE-bench 수치는 통제된 직접 비교가 아니라 참고용으로 보십시오. PromptQuorum은 이 벤치마크를 다시 실행하지 않았습니다.
벤치마크 | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified (벤더 발표) | 77.2% | 78.6% (High) / 79.0% (Max) | 65.8% | 미공개 |
| 파라미터 (전체 / 활성) | 27B 덴스 | 284B / 활성 13B | 24B 덴스 | 22B 덴스 |
| 컨텍스트 윈도우 | 256K | 1M | 384K | 32K |
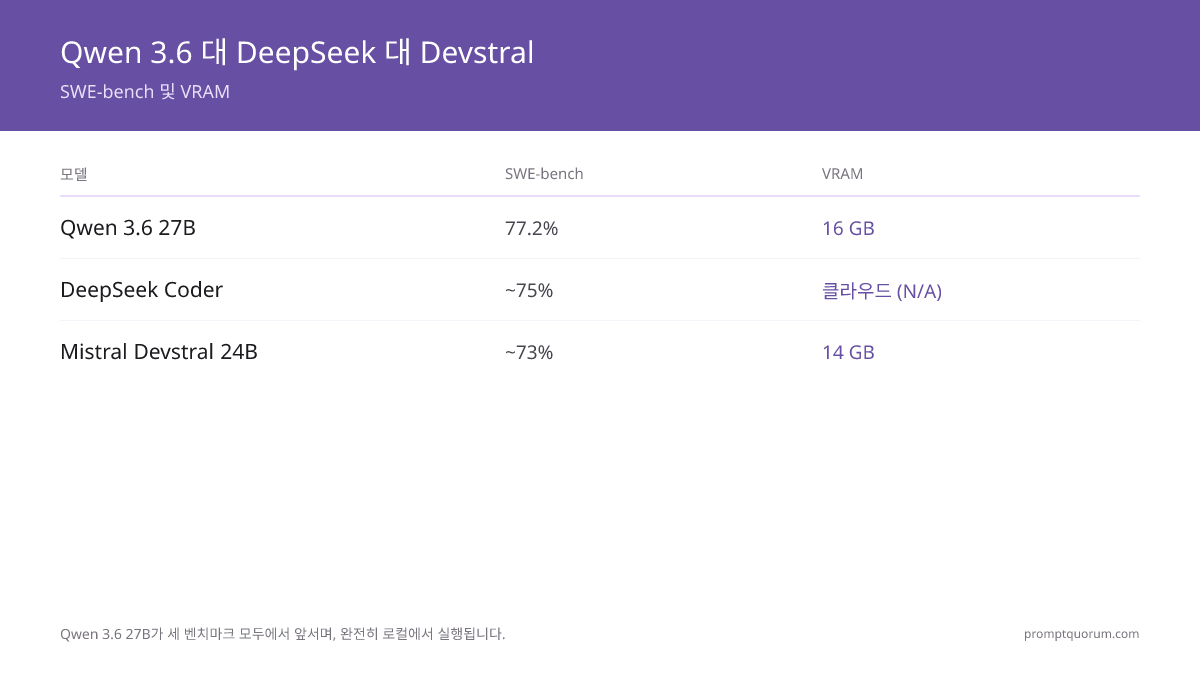
📌참고: Qwen의 77.2는 Qwen 내부 에이전트 환경을 사용한 값입니다. DeepSeek은 73.7(비사고), 78.6(High), 79.0(Max)을 보고합니다. Devstral Small 2의 65.8은 Ollama 페이지에서 가져왔습니다. 환경이 달라 수치를 직접 비교할 수 없습니다.
💡팁: DeepSeek API 모델 이름은 바뀝니다. 배포 전에 api-docs.deepseek.com/quick_start/pricing을 확인하십시오(현재 이름: deepseek-flash, deepseek-v4-pro).
토큰당 비용 계산
코딩 LLM의 경제성은 사용량, 작업 민감도, 하드웨어에 따라 달라집니다. 아래 추정은 개발자 한 명 기준이며 명시한 가정에 근거한 산술이지 측정값이 아닙니다. 전기 요금은 독일의 일반적인 요율인 €0.35/kWh로 계산했으니 본인의 요금제를 확인하십시오.
하루 500만 토큰(자동 완성, 테스트 생성, 코드 리뷰를 많이 하는 세션)과 입력:출력 1:2 비율에서 DeepSeek API(deepseek-flash, 비피크 기준 100만 토큰당 입력 $0.15, 출력 $0.60)는 하루 약 $2.25, 250 근무일 기준 약 $560입니다. 피크 요금(입력 $0.30, 출력 $1.20)에서는 같은 사용량이 하루 약 $4.50, 연 약 $1,125입니다.
로컬 구성은 이것을 하드웨어와 전력으로 바꿉니다. 가정한 $2,300짜리 RTX 4090이 250일 동안 하루 8시간 350 W를 쓰면 700 kWh, 연 약 €245입니다. 환율을 무시하면 하드웨어는 API 비피크 요금 대비 약 7년, 피크 요금 대비 약 2.6년에 회수됩니다. 민감한 코드라면 비교가 비용만의 문제가 아닙니다. 클라우드 API는 코드를 제3자에게 보냅니다.
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
실제 지연 시간
대화형 코딩에서는 지연 시간이 중요합니다. 자동 완성은 500 ms를 넘으면 쓸 수 없고, 코드 리뷰는 3초까지 허용되며, 배치 작업은 지연 시간에 둔감합니다. PromptQuorum은 이 모델들을 측정하지 않았습니다. 표는 RTX 4090(24 GB, Ollama 0.34.4, 2026년 9월)에서 Ollama로 진행된 제3자 테스트 하나를 보여 주며, 이는 이 모델들에 대해 찾은 유일한 공개 측정입니다. 실제 속도는 양자화, 컨텍스트 길이, 드라이버에 따라 달라집니다.
구성 | 지속 속도 (토큰/초) | 비고 |
|---|---|---|
| Qwen3.6 27B, RTX 4090 (드래프트 디코딩 켬) | 115.4 | 프롬프트 5개 평균, 출력 256토큰 |
| Qwen3.6 27B, RTX 4090 (드래프트 디코딩 끔) | 48.9 | 프롬프트 1개 재실행, 같은 구성 |
| Qwen3-Coder 30B, RTX 4090 | 224.7 | 활성 파라미터 3.3B의 MoE |
| Devstral Small 2 | 측정 안 됨 | 공개된 측정 없음 |
| DeepSeek API (deepseek-flash) | 측정 안 됨 | 네트워크와 피크 시간대에 따라 다름 |
출처: Ollama Models Cheat Sheet(제3자 테스트이며 PromptQuorum의 측정이 아님). 해당 글에 따르면 추측 디코딩(드래프트 토큰)은 출력 품질을 바꾸지 않고 이 테스트에서 Qwen3.6 27B를 약 2.4배 빠르게 했습니다. Apple은 로컬 LLM의 토큰 속도를 공개하지 않습니다. 정확한 수치는 직접 하드웨어에서 ollama run --verbose로 측정하십시오. 자동 완성에서는 로컬 추론이 네트워크 왕복을 피합니다.
⚠️경고: Ollama의 기본 컨텍스트 윈도우(사용 가능한 VRAM에 맞춰 조정됨)는 처리하는 토큰이 적어 겉보기 처리량을 높이지만 컨텍스트를 잘라 냅니다. 의미 있는 코딩 지연 시간 측정을 위해 num_ctx 32768로 설정하십시오.
하드웨어 요구 사항
- Qwen3.6 27B Q4_K_M (Ollama `qwen3.6:27b`, 18–19 GB 다운로드): 24 GB GPU(RTX 3090, RTX 4090) 또는 통합 메모리 36–48 GB 이상의 Apple Silicon. 16 GB 카드는 가중치를 담지 못합니다.
- Devstral Small 2 24B (Ollama `devstral-small-2`, 15 GB 다운로드): RTX 4070 Ti Super(16 GB, 컨텍스트를 더하면 빠듯함), RTX 3090 또는 RTX 4090(24 GB), 또는 통합 메모리 24 GB 이상의 Apple Silicon.
- Codestral 22B Q4_K_M (13 GB 다운로드): RTX 4070 Ti(12 GB는 한계, 16 GB 권장).
- 두 모델 동시 실행: Qwen3.6 27B(18–19 GB)와 Devstral Small 2(15 GB)는 컨텍스트 전에 합쳐 약 34 GB이므로 24 GB GPU 두 장 또는 통합 메모리 64 GB 이상의 Apple Silicon(예: M5 Max Mac Studio, 최대 128 GB)이 필요합니다.
- Apple Silicon: Apple은 2026년 8월 25일 Mac mini와 Mac Studio 라인업을 새로 발표했고(2026년 9월 22일부터 판매) M4 Pro/M4 Max 구성을 대체했습니다. Apple에 따르면 M5 Pro Mac mini는 $1,699부터(통합 메모리 최대 64 GB, 307 GB/s), M5 Max Mac Studio는 $2,499부터(최대 128 GB), M5 Ultra Mac Studio는 $5,499부터(최대 512 GB, 512 GB 구성은 10월 말 출시)입니다. 36–48 GB 구성이면 Qwen3.6 27B를 담을 수 있고, 64 GB 이상이면 Qwen3.6 27B와 Devstral Small 2를 함께 담습니다. Apple은 로컬 LLM의 초당 토큰 수치를 공개하지 않으며 PromptQuorum도 이 칩을 측정하지 않았으니 ollama run --verbose로 직접 측정하십시오. 가격은 미국 달러 기준이며 현지 가격은 다를 수 있습니다.
- 저예산 Apple Silicon 옵션: 입문용 M6 Mac mini는 $899부터(통합 메모리 최대 32 GB, Apple 기준 최대 170 GB/s)이며 Devstral Small 2(15 GB)와 Codestral 22B(13 GB)를 여유 있게 담습니다. Qwen3.6 27B(18–19 GB)는 32 GB 구성에서만 들어가고 컨텍스트 여유가 적습니다. 메모리 대역폭이 M5 Pro보다 낮아(170 대 307 GB/s) 생성이 더 느리며, PromptQuorum은 M6를 측정하지 않았습니다.
# num_ctx 및 GPU 레이어를 설정한 Qwen3.6 27B Ollama 구성
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
멀티 모델 디스패치 전략
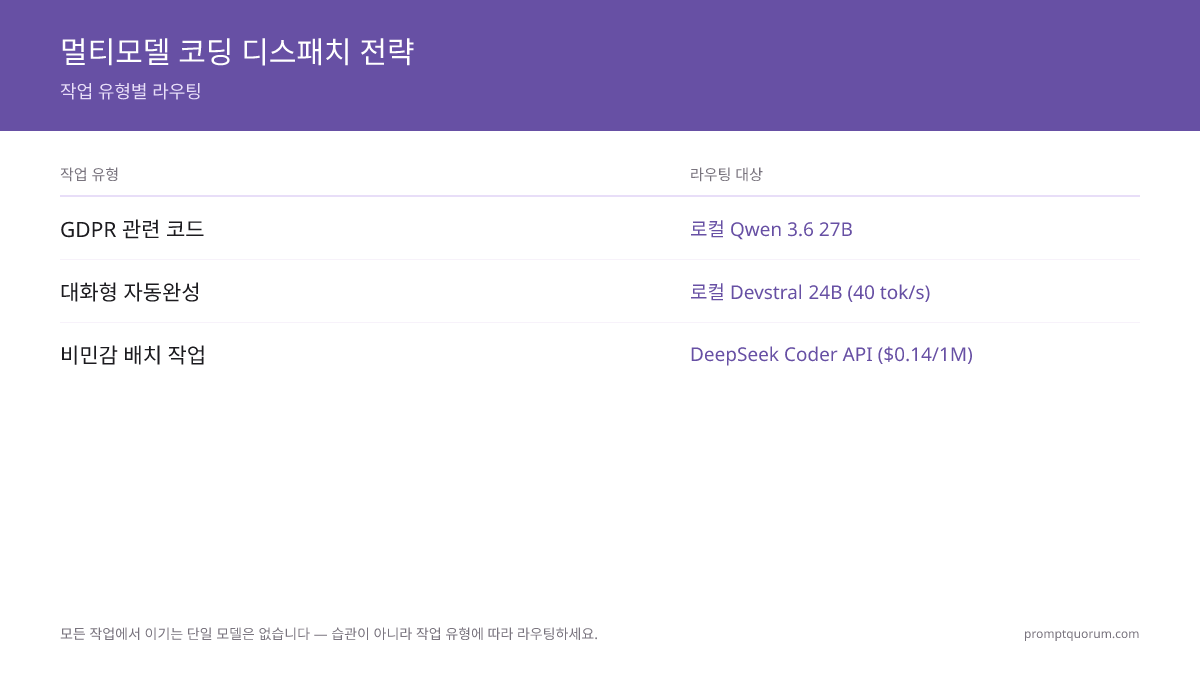
모든 작업에서 이기는 코딩 모델은 없습니다. Qwen3.6 27B는 여기서 가장 강력한 로컬 SWE-bench 수치를 가집니다. Devstral Small 2는 더 가벼운 에이전트형 모델입니다. DeepSeek API는 민감하지 않은 코드를 대규모로 처리할 때 토큰당 가장 저렴합니다. 작업 유형별로 라우팅하는 디스패치 계층은 세 가지의 장점을 모두 활용합니다.
개발 팀을 위한 디스패치 매트릭스 예시:
작업 유형 | 추천 모델 | 이유 |
|---|---|---|
| 비공개 코드 (고객 데이터) | Qwen3.6 27B (로컬) | 코드가 내 하드웨어에 남음 |
| 자동 완성 (대화형) | Devstral Small 2 (로컬) | 더 가벼운 모델, 네트워크 왕복 없음 |
| 코드 리뷰 (민감하지 않음) | DeepSeek API | 비피크 입력 $0.15/1M, 높은 처리량 |
| 복잡한 리팩터링 (여러 파일) | Qwen3.6 27B (로컬) + PromptQuorum 합의 | 가장 강력한 로컬 SWE-bench 수치, 코드는 로컬 |
| 배치 테스트 생성 | DeepSeek API | 민감하지 않은 대량 작업에 비용 최적화 |
PromptQuorum 연동
PromptQuorum은 사용자가 정의한 작업 분류 규칙에 따라 로컬 Qwen, 로컬 Devstral, 클라우드 API로 코드 작업을 라우팅합니다. 이를 통해 수동 모델 전환이 불필요해지며 위의 디스패치 매트릭스가 자동으로 구현됩니다.
PromptQuorum은 코딩 작업을 민감한 코드는 로컬 Qwen3.6으로, 민감하지 않은 대량 생성은 DeepSeek API로 라우팅합니다.
# 코딩 워크로드를 위한 PromptQuorum 라우팅 설정
# PromptQuorum 설정 또는 .env 파일에 지정하십시오

# 로컬 모델 (Ollama를 통해)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B (num_ctx 32768)
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# 클라우드 폴백
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_MODEL=deepseek-flash

# 라우팅 규칙 (PromptQuorum 디스패치)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (로컬)
# route: task_type == "autocomplete" → devstral (로컬)
# route: token_count > 50000 → deepseek-chat (클라우드, 비민감 전용)
# default → qwen36-local (로컬)자주 묻는 질문
로컬 코딩에서 Qwen3.6 27B가 DeepSeek보다 낫습니까?
Qwen3.6 27B는 SWE-bench Verified 77.2%를 보고했고 18–19 GB 다운로드로 전적으로 내 하드웨어에서 실행되므로 24 GB GPU를 계획하십시오. DeepSeek V4 Flash는 High 모드 78.6%를 보고했지만 284B 파라미터 모델이어서 대부분 비피크 입력 100만 토큰당 $0.15의 클라우드 API로 사용합니다. 더 나은 선택은 단일 승자가 아니라 데이터 민감도와 예산에 달려 있습니다. 두 점수 모두 서로 다른 테스트 환경의 벤더 발표값입니다.
Devstral Small 2는 무엇이며 왜 여기서 다룹니까?
Devstral Small 2는 Mistral AI의 24B 모델입니다. Devstral 계열은 여러 파일 수정과 도구 사용 같은 에이전트형 소프트웨어 엔지니어링을 겨냥합니다. Ollama 페이지에는 15 GB 다운로드, 384K 컨텍스트 윈도우, Apache 2.0 라이선스, SWE-bench Verified 65.8%가 표시됩니다. 여기서는 더 가벼운 로컬 옵션이며, Qwen3.6 27B가 더 높은 SWE-bench 수치를 보고했습니다.
Qwen3.6 27B와 Devstral Small 2를 동시에 실행할 수 있습니까?
24 GB GPU 한 장에서는 안 됩니다. Qwen3.6 27B는 18–19 GB, Devstral Small 2는 15 GB를 내려받으므로 컨텍스트 전에 합쳐 약 34 GB입니다. 24 GB GPU 두 장 또는 통합 메모리 64 GB 이상의 Apple Silicon이 필요합니다. GPU 한 장에서는 한 번에 한 모델만 실행하고 Ollama로 전환하십시오.
EU 기업의 코드에 DeepSeek API를 써도 안전합니까?
DeepSeek API는 중국에 설립된 기업 DeepSeek이 운영하는 서버에서 데이터를 처리하며, EU 집행위원회는 중국에 대한 적정성 결정을 내리지 않았습니다. EU 개인 데이터나 개인 정보가 포함된 소스 코드를 보내려면 GDPR 제5장(제44조 이하)에 따른 법적 검토가 필요합니다. 개인 데이터가 없는 독점 코드는 법무팀과 상의하십시오. Qwen3.6 27B 같은 로컬 모델은 코드를 내 하드웨어에 두어 제3자 전송을 피하지만, 그것만으로 프로젝트가 GDPR을 준수하게 되는 것은 아닙니다. 이는 일반 정보이며 법률 자문이 아닙니다.
SWE-bench Verified란 무엇이며 왜 중시합니까?
SWE-bench Verified는 사람이 검증한 과제 집합으로, 모델이 Django, Flask, scikit-learn 같은 오픈소스 Python 프로젝트의 실제 GitHub 이슈를 해결할 수 있는지 시험합니다. HumanEval 같은 고립된 함수 수준 테스트보다 실무 소프트웨어 엔지니어링을 더 잘 측정합니다. 점수는 에이전트 환경에 크게 좌우되므로 벤더 수치는 신중하게 비교하십시오.