Pourquoi les modèles de code locaux ont rattrapé leur retard
Pendant les premières années de l'ère LLM, les modèles cloud devançaient nettement les modèles locaux en programmation. Cet écart s'est réduit en 2025–2026 lorsque des modèles open-weight de 24–30 milliards de paramètres ont reçu un entraînement centré sur le code.
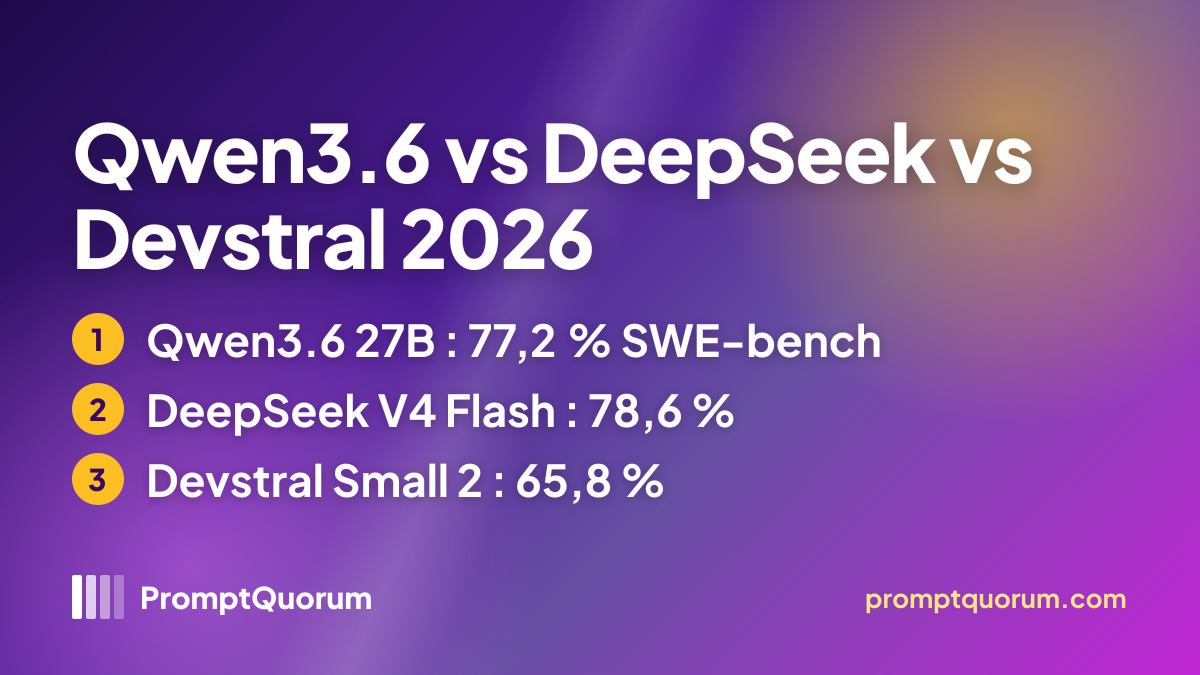
Qwen3.6 27B, publié en avril 2026, annonce 77,2 sur SWE-bench Verified, un benchmark de vraies issues GitHub de projets Python open source. Dans le même tableau de sa model card, Qwen indique 75,0 pour Qwen3.5-27B et 80,9 pour Claude 4.5 Opus : le modèle ouvert se situe donc près d'un modèle cloud de pointe sur ce test publié par l'éditeur. Ce sont les résultats propres de Qwen, obtenus avec un dispositif d'agent interne, pas une vérification indépendante.
Les raisons le plus souvent citées de cette convergence sont (1) des données d'entraînement centrées sur le code à grande échelle, (2) un post-entraînement sur de vraies tâches d'ingénierie logicielle plutôt que sur du suivi d'instructions générique, et (3) une meilleure quantisation GGUF qui préserve la capacité de codage en précision Q4.
📍 En une phrase
Qwen3.6 27B annonce 77,2 % sur SWE-bench Verified et tourne en local avec un téléchargement de 18–19 Go.
💬 En termes simples
SWE-bench Verified teste si une IA peut résoudre de vraies issues GitHub de projets open source comme Django, Flask et scikit-learn. Un score de 77,2 % signifie que le modèle a résolu environ 77 tâches de test sur 100, mesuré avec le dispositif d'agent de l'éditeur.
Tableau de benchmarks
Tous les chiffres sont ceux des éditeurs, tirés des model cards et des fiches Ollama. Les protocoles de test diffèrent d'un éditeur à l'autre : considérez les scores SWE-bench comme indicatifs, pas comme un duel contrôlé. PromptQuorum n'a pas relancé ces benchmarks.
Benchmark | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified (chiffre éditeur) | 77,2 % | 78,6 % (High) / 79,0 % (Max) | 65,8 % | Non publié |
| Paramètres (total / actifs) | 27B dense | 284B / 13B actifs | 24B dense | 22B dense |
| Fenêtre de contexte | 256K | 1M | 384K | 32K |

📌Remarque: Le 77,2 de Qwen vient du dispositif d'agent interne de Qwen. DeepSeek annonce 73,7 (sans réflexion), 78,6 (High) et 79,0 (Max). Le 65,8 de Devstral Small 2 vient de sa fiche Ollama. Les dispositifs diffèrent : les chiffres ne sont pas directement comparables.
💡Astuce: Les noms de modèles de l'API DeepSeek changent. Vérifiez api-docs.deepseek.com/quick_start/pricing avant le déploiement (noms actuels : deepseek-flash et deepseek-v4-pro).
Coût par token
L'économie des LLM de code dépend du volume d'utilisation, de la sensibilité des tâches et du matériel. La projection ci-dessous concerne un développeur et repose sur les hypothèses indiquées : c'est de l'arithmétique, pas une mesure. L'électricité est comptée à 0,35 €/kWh, un tarif allemand typique ; vérifiez votre propre tarif.
À 5 millions de tokens par jour (session intensive d'autocomplétion, de génération de tests et de revue de code) avec un ratio entrée/sortie de 1:2, l'API DeepSeek (deepseek-flash, 0,15 $ en entrée et 0,60 $ en sortie par million de tokens hors pointe) coûte environ 2,25 $ par jour, soit environ 560 $ sur 250 jours ouvrés. Aux tarifs de pointe (0,30 $ en entrée, 1,20 $ en sortie), le même usage coûte environ 4,50 $ par jour, soit environ 1 125 $ par an.
Une configuration locale échange cela contre du matériel et de l'électricité. Une RTX 4090 à 2 300 $ (hypothèse), consommant 350 W pendant 8 heures sur 250 jours, utilise 700 kWh, soit environ 245 € par an. Sans tenir compte des taux de change, le matériel est amorti en environ 7 ans face aux tarifs hors pointe de l'API et en environ 2,6 ans face aux tarifs de pointe. Pour du code sensible, la comparaison ne porte pas que sur le coût : une API cloud envoie votre code à un tiers.
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
Réalité de la latence
La latence compte pour le codage interactif : l'autocomplétion devient inutilisable au-delà de 500 ms, la revue de code est acceptable jusqu'à 3 s, les traitements par lots sont insensibles à la latence. PromptQuorum n'a pas mesuré ces modèles. Le tableau montre un test tiers sous Ollama sur une RTX 4090 (24 Go, Ollama 0.34.4, septembre 2026), la seule mesure publiée que nous ayons trouvée pour ces modèles ; vos vitesses varieront selon la quantisation, la longueur de contexte et les pilotes.
Configuration | Soutenu (tok/s) | Remarques |
|---|---|---|
| Qwen3.6 27B, RTX 4090 (draft decoding activé) | 115,4 | Moyenne de cinq prompts, 256 tokens en sortie |
| Qwen3.6 27B, RTX 4090 (draft decoding désactivé) | 48,9 | Un seul prompt, même configuration |
| Qwen3-Coder 30B, RTX 4090 | 224,7 | MoE avec 3,3B de paramètres actifs |
| Devstral Small 2 | Non mesuré | Aucune mesure publiée trouvée |
| API DeepSeek (deepseek-flash) | Non mesuré | Dépend du réseau et des heures de pointe |
Source : Ollama Models Cheat Sheet (test tiers, pas de PromptQuorum). Selon l'article, le décodage spéculatif (draft tokens) a rendu Qwen3.6 27B environ 2,4 fois plus rapide dans ce test sans changer la qualité de sortie. Apple ne publie pas de vitesses en tokens pour les LLM locaux. Lancez ollama run --verbose sur votre propre matériel pour un chiffre fiable. Pour l'autocomplétion, l'inférence locale évite l'aller-retour réseau.
⚠️Attention: La fenêtre de contexte par défaut d'Ollama (ajustée à la VRAM disponible) augmente le débit apparent car moins de tokens sont traités, mais tronque le contexte. Définissez num_ctx 32768 pour des mesures de latence de codage pertinentes.
Configuration matérielle requise
- Qwen3.6 27B Q4_K_M (Ollama `qwen3.6:27b`, téléchargement de 18–19 Go) : un GPU de 24 Go (RTX 3090, RTX 4090) ou un Apple Silicon avec 36–48 Go ou plus de mémoire unifiée. Une carte de 16 Go ne peut pas contenir les poids.
- Devstral Small 2 24B (Ollama `devstral-small-2`, téléchargement de 15 Go) : RTX 4070 Ti Super (16 Go, juste une fois le contexte ajouté), RTX 3090 ou RTX 4090 (24 Go), ou Apple Silicon avec 32 Go ou plus de mémoire unifiée.
- Codestral 22B Q4_K_M (téléchargement de 13 Go) : RTX 4070 Ti (12 Go en limite, 16 Go recommandé).
- Faire tourner deux modèles en même temps : Qwen3.6 27B (18–19 Go) plus Devstral Small 2 (15 Go) représentent environ 34 Go avant le contexte : il faut deux GPU de 24 Go ou un Apple Silicon avec 64 Go ou plus de mémoire unifiée, par exemple un Mac Studio M5 Max (jusqu'à 128 Go).
- Apple Silicon : Apple a renouvelé la gamme Mac mini et Mac Studio le 25 août 2026 (disponible à partir du 22 septembre 2026), remplaçant les configurations M4 Pro/M4 Max. Selon Apple, le Mac mini M5 Pro démarre à 1 699 $ (jusqu'à 64 Go de mémoire unifiée, 307 Go/s), le Mac Studio M5 Max à 2 499 $ (jusqu'à 128 Go) et le Mac Studio M5 Ultra à 5 499 $ (jusqu'à 512 Go ; la configuration 512 Go est livrée fin octobre). Une configuration de 36–48 Go accueille Qwen3.6 27B ; à partir de 64 Go, Qwen3.6 27B et Devstral Small 2 tiennent ensemble. Apple ne publie aucune vitesse en tokens par seconde pour les LLM locaux et PromptQuorum n'a pas testé ces puces : mesurez avec ollama run --verbose. Prix en dollars US ; les tarifs locaux peuvent différer.
- Option Apple Silicon économique : le Mac mini M6 d'entrée de gamme démarre à 899 $ (jusqu'à 32 Go de mémoire unifiée, jusqu'à 170 Go/s selon Apple) et accueille confortablement Devstral Small 2 (15 Go) et Codestral 22B (13 Go). Qwen3.6 27B (18–19 Go) ne tient que dans la configuration de 32 Go, avec peu de marge pour le contexte. Sa bande passante mémoire est inférieure à celle du M5 Pro (170 contre 307 Go/s), donc la génération est plus lente ; PromptQuorum n'a pas testé le M6.
# Ollama config for Qwen3.6 27B with num_ctx and GPU layers
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
Stratégie de dispatch multi-modèles
Aucun modèle de code ne remporte toutes les tâches. Qwen3.6 27B affiche le meilleur chiffre SWE-bench local ici. Devstral Small 2 est un modèle agentique plus léger. Une API DeepSeek est la moins chère par token à grande échelle pour le code non sensible. Une couche de dispatch qui route les tâches par type capte les avantages des trois.
Matrice de dispatch suggérée pour une équipe de développement :
Type de tâche | Modèle recommandé | Raison |
|---|---|---|
| Code privé (données clients) | Qwen3.6 27B (local) | Le code reste sur votre matériel |
| Autocomplétion (interactive) | Devstral Small 2 (local) | Modèle plus léger, pas d'aller-retour réseau |
| Revue de code (non sensible) | API DeepSeek | 0,15 $/1M en entrée hors pointe, haut débit |
| Refactoring complexe (multi-fichiers) | Qwen3.6 27B (local) + consensus PromptQuorum | Meilleur chiffre SWE-bench local, code local |
| Génération de tests par lots | API DeepSeek | Optimisé en coût pour le volume non sensible |

Intégration PromptQuorum
PromptQuorum route les tâches de code entre Qwen local, Devstral local et les API cloud selon des règles de classification que vous définissez. Cela élimine les changements manuels de modèle et implémente automatiquement la matrice de dispatch ci-dessus.
📍 En une phrase
PromptQuorum route les tâches de code vers Qwen3.6 local pour le code sensible et vers une API DeepSeek pour la génération en volume non sensible.
# PromptQuorum routing config for coding workloads
# Set in your PromptQuorum settings or .env file

# Local models (via Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B with num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Cloud fallback
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_MODEL=deepseek-flash

# Routing rules (PromptQuorum dispatch)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (local)
# route: task_type == "autocomplete" → devstral-small-2 (local)
# route: token_count > 50000 → deepseek-flash (cloud, non-sensitive only)
# default → qwen36-local (local)Questions fréquemment posées
Qwen3.6 27B est-il meilleur que DeepSeek pour le code local ?
Qwen3.6 27B annonce 77,2 % sur SWE-bench Verified et tourne entièrement sur votre matériel avec un téléchargement de 18–19 Go : prévoyez un GPU de 24 Go. DeepSeek V4 Flash annonce 78,6 % (mode High) mais compte 284 milliards de paramètres ; on l'utilise donc surtout via l'API cloud à 0,15 $ par million de tokens d'entrée hors pointe. Le bon choix dépend de la sensibilité de vos données et de votre budget, pas d'un gagnant unique. Les deux scores sont ceux des éditeurs, avec des protocoles différents.
Qu'est-ce que Devstral Small 2 et pourquoi est-il mentionné ici ?
Devstral Small 2 est un modèle de 24B de Mistral AI. La gamme Devstral vise l'ingénierie logicielle agentique, comme les modifications multi-fichiers et l'utilisation d'outils. Sa fiche Ollama indique 15 Go de téléchargement, 384K de contexte, la licence Apache 2.0 et 65,8 % sur SWE-bench Verified. C'est l'option locale plus légère ici ; Qwen3.6 27B annonce le meilleur chiffre SWE-bench.
Peut-on faire tourner Qwen3.6 27B et Devstral Small 2 simultanément ?
Pas sur un seul GPU de 24 Go. Qwen3.6 27B pèse 18–19 Go et Devstral Small 2 15 Go, soit environ 34 Go avant le contexte. Il faudrait deux GPU de 24 Go ou un Apple Silicon avec 64 Go ou plus de mémoire unifiée. Sur un seul GPU, utilisez un modèle à la fois et basculez via Ollama.
Une API DeepSeek est-elle sûre pour le code d'une entreprise européenne ?
L'API DeepSeek traite les données sur des serveurs exploités par DeepSeek, société immatriculée en Chine, et la Commission européenne n'a pas émis de décision d'adéquation pour la Chine. Lui envoyer des données personnelles européennes, ou du code source contenant des informations personnelles, exige une analyse juridique au titre du chapitre V du RGPD (articles 44 et suivants). Pour du code propriétaire sans données personnelles, consultez votre service juridique. Un modèle local comme Qwen3.6 27B garde le code sur votre propre matériel et évite un transfert à un tiers ; cela ne rend pas à lui seul un projet conforme au RGPD. Ces informations sont générales et ne constituent pas un conseil juridique.
Qu'est-ce que SWE-bench Verified et pourquoi s'y concentrer ?
SWE-bench Verified teste, sur une sélection de tâches validées par des humains, si un modèle peut résoudre de vraies issues GitHub de projets Python open source comme Django, Flask et scikit-learn. Il mesure l'ingénierie logicielle pratique mieux que des tests isolés au niveau de la fonction comme HumanEval. Les scores dépendent fortement du dispositif d'agent : comparez les chiffres des éditeurs avec prudence.