لماذا لحقت نماذج الكود المحلية بالنماذج السحابية
في السنوات الأولى من عصر النماذج اللغوية، كانت النماذج السحابية متقدمة بوضوح على المحلية في البرمجة. ضاقت هذه الفجوة في 2025–2026 مع وصول النماذج مفتوحة الأوزان إلى نطاق 24–30B معامل بتدريب يركز على الشيفرة.
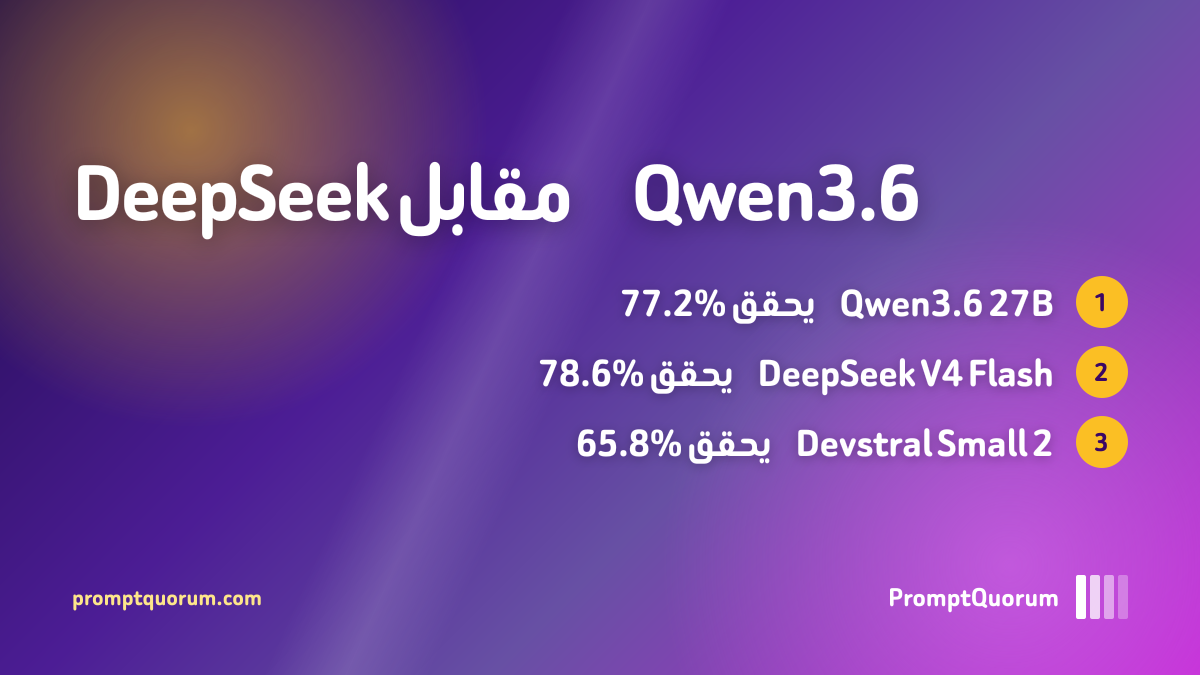
يُعلن Qwen3.6 27B، الذي صدر في أبريل 2026، عن 77.2 في SWE-bench Verified، وهو معيار لمشكلات GitHub حقيقية في مشاريع بايثون مفتوحة المصدر. وفي الجدول نفسه على بطاقة النموذج تذكر Qwen الرقم 75.0 لـ Qwen3.5-27B و80.9 لـ Claude 4.5 Opus، فيقع النموذج المفتوح قريبًا من نموذج سحابي رائد في هذا الاختبار الذي نشرته الجهة المطوّرة. هذه نتائج Qwen نفسها بإطار وكيل داخلي، وليست تحققًا مستقلًا.
الأسباب الأكثر ذكرًا لهذا التقارب هي (1) بيانات تدريب تركز على الشيفرة بحجم كبير، (2) تدريب لاحق على مهام هندسة برمجيات حقيقية بدل اتباع التعليمات العامة، و(3) تكميم GGUF أفضل يحافظ على القدرة البرمجية عند دقة Q4.
يُعلن Qwen3.6 27B عن 77.2% في SWE-bench Verified ويعمل محليًا من تنزيل بحجم 18–19 GB.
يختبر SWE-bench Verified ما إذا كان الذكاء الاصطناعي قادرًا على حل مشكلات GitHub حقيقية في مشاريع مفتوحة المصدر مثل Django وFlask وscikit-learn. تعني درجة 77.2% أن النموذج حلّ نحو 77 من كل 100 مهمة اختبار، مقيسة بإطار الوكيل الخاص بالجهة المطوّرة.
جدول المعايير
جميع الأرقام صادرة عن الجهات المطوّرة ومأخوذة من بطاقات النماذج وصفحات Ollama. تختلف إعدادات الاختبار بين الجهات، فاعتبر أرقام SWE-bench استرشادية لا مواجهة محكومة. لم تُعد PromptQuorum تشغيل هذه المعايير.
المعيار | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified (رقم الجهة المطوّرة) | 77.2% | 78.6% (High) / 79.0% (Max) | 65.8% | غير منشور |
| المعاملات (الإجمالي / النشط) | 27B كثيف | 284B / 13B نشط | 24B كثيف | 22B كثيف |
| نافذة السياق | 256K | 1M | 384K | 32K |
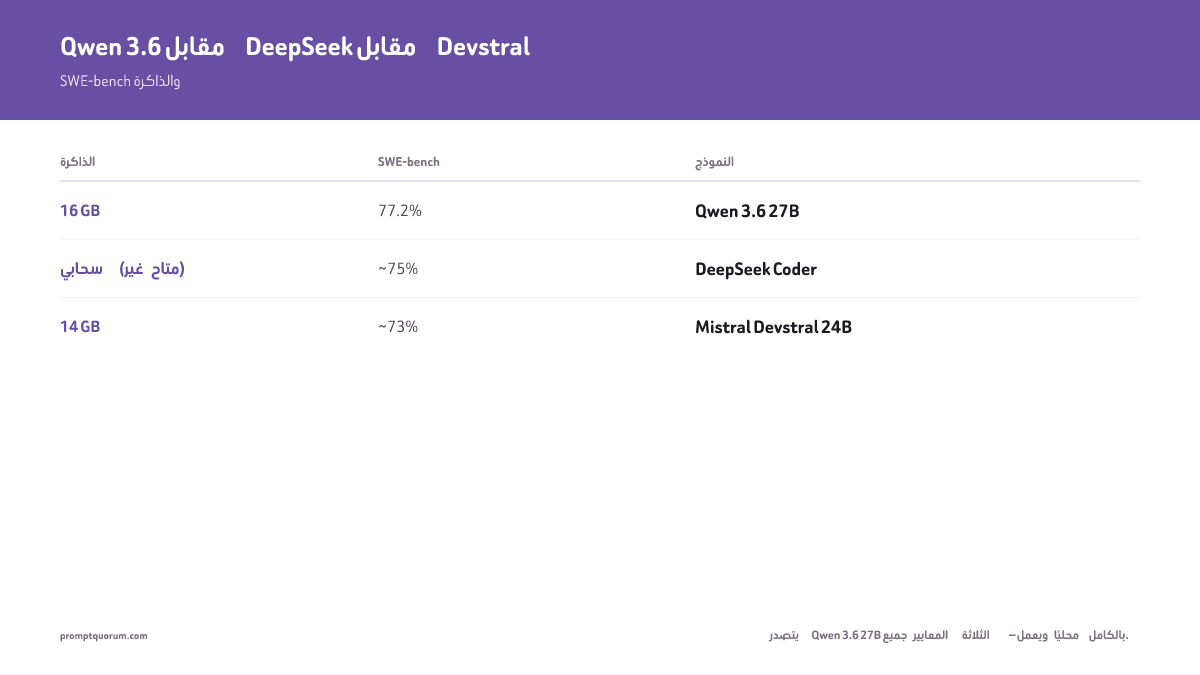
📌ملاحظة: رقم Qwen البالغ 77.2 يستخدم إطار الوكيل الداخلي لدى Qwen. وتُعلن DeepSeek عن 73.7 (دون تفكير) و78.6 (High) و79.0 (Max). ورقم Devstral Small 2 البالغ 65.8 مأخوذ من صفحته على Ollama. تختلف الأطر، فلا يمكن مقارنة الأرقام مباشرة.
💡نصيحة: تتغير أسماء نماذج DeepSeek API. راجع api-docs.deepseek.com/quick_start/pricing قبل النشر (الأسماء الحالية: deepseek-flash وdeepseek-v4-pro).
حسابات تكلفة الـ token
تعتمد اقتصاديات نماذج البرمجة على حجم الاستخدام وحساسية المهام والعتاد. التقدير أدناه لمطوّر واحد ويستند إلى الافتراضات المذكورة؛ هو حساب حسابي وليس قياسًا. سعر الكهرباء 0.35 يورو/كيلوواط ساعة، وهو معدل ألماني نموذجي؛ راجع تعرفتك.
عند 5 ملايين رمز يوميًا (جلسة مكثفة من الإكمال التلقائي وتوليد الاختبارات ومراجعة الشيفرة) وبنسبة إدخال إلى إخراج 1:2، تكلف DeepSeek API (deepseek-flash، بواقع 0.15 دولار إدخالًا و0.60 دولار إخراجًا لكل مليون رمز خارج الذروة) نحو 2.25 دولار يوميًا، أي نحو 560 دولارًا على 250 يوم عمل. وبأسعار الذروة (0.30 دولار إدخالًا، 1.20 دولار إخراجًا) يكلف الاستخدام نفسه نحو 4.50 دولار يوميًا، أي نحو 1,125 دولارًا سنويًا.
الإعداد المحلي يستبدل ذلك بالعتاد والطاقة. بطاقة RTX 4090 بسعر مفترض 2,300 دولار، تسحب 350 واط لمدة 8 ساعات على مدى 250 يومًا، تستهلك 700 كيلوواط ساعة، أي نحو 245 يورو سنويًا. وبتجاهل أسعار الصرف يسترد العتاد تكلفته خلال نحو 7 سنوات مقابل أسعار API خارج الذروة، وخلال نحو 2.6 سنة مقابل أسعار الذروة. وفي الشيفرة الحساسة لا تقتصر المقارنة على التكلفة: فواجهة API السحابية ترسل شيفرتك إلى طرف ثالث.
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
واقع الكمون
يهم زمن الاستجابة في البرمجة التفاعلية: يصبح الإكمال التلقائي غير صالح فوق 500 ملّي ثانية، ومراجعة الشيفرة مقبولة حتى 3 ثوانٍ، والمهام الدُفعية لا تتأثر بزمن الاستجابة. لم تقس PromptQuorum هذه النماذج. يعرض الجدول اختبارًا لطرف ثالث باستخدام Ollama على RTX 4090 (24 GB، Ollama 0.34.4، سبتمبر 2026)، وهو التشغيل المنشور الوحيد الذي وجدناه لهذه النماذج؛ وستختلف سرعاتك بحسب التكميم وطول السياق وبرامج التشغيل.
الإعداد | السرعة المستمرة (رمز/ثانية) | ملاحظات |
|---|---|---|
| Qwen3.6 27B على RTX 4090 (فك الترميز التخميني مفعّل) | 115.4 | متوسط خمس مطالبات، مخرجات 256 رمزًا |
| Qwen3.6 27B على RTX 4090 (فك الترميز التخميني معطّل) | 48.9 | إعادة بمطالبة واحدة وبالإعداد نفسه |
| Qwen3-Coder 30B على RTX 4090 | 224.7 | MoE بمعاملات نشطة 3.3B |
| Devstral Small 2 | لم يُقَس | لم نجد تشغيلًا منشورًا |
| DeepSeek API (deepseek-flash) | لم يُقَس | يعتمد على الشبكة وساعات الذروة |
المصدر: Ollama Models Cheat Sheet (اختبار لطرف ثالث، وليس من PromptQuorum). بحسب المقال، جعل فك الترميز التخميني (رموز المسودة) نموذج Qwen3.6 27B أسرع بنحو 2.4 مرة في ذلك الاختبار دون تغيير جودة المخرجات. لا تنشر Apple سرعات الرموز للنماذج المحلية. شغّل ollama run --verbose على عتادك للحصول على رقم موثوق. وفي الإكمال التلقائي يتجنب الاستدلال المحلي الذهاب والإياب عبر الشبكة.
⚠️تحذير: نافذة السياق الافتراضية في Ollama (المضبوطة بحسب VRAM المتاحة) ترفع الإنتاجية الظاهرية لأن عدد الرموز المعالجة أقل، لكنها تقتطع السياق. اضبط num_ctx 32768 للحصول على قياسات زمن استجابة ذات معنى في البرمجة.
متطلبات الأجهزة
- Qwen3.6 27B Q4_K_M (Ollama `qwen3.6:27b`، تنزيل 18–19 GB): بطاقة 24 GB (RTX 3090 أو RTX 4090) أو Apple Silicon بذاكرة موحدة 36–48 GB أو أكثر. لا تتسع بطاقة 16 GB للأوزان.
- Devstral Small 2 24B (Ollama `devstral-small-2`، تنزيل 15 GB): RTX 4070 Ti Super (16 GB، ضيقة عند إضافة السياق) أو RTX 3090 أو RTX 4090 (24 GB) أو Apple Silicon بذاكرة موحدة 24 GB أو أكثر.
- Codestral 22B Q4_K_M (تنزيل 13 GB): RTX 4070 Ti (12 GB بالحد الأدنى، و16 GB موصى بها).
- تشغيل نموذجين معًا: يبلغ Qwen3.6 27B (18–19 GB) مع Devstral Small 2 (15 GB) نحو 34 GB قبل السياق، فيلزم بطاقتا 24 GB أو Apple Silicon بذاكرة موحدة 64 GB أو أكثر، مثل Mac Studio بشريحة M5 Max (حتى 128 GB).
- Apple Silicon: جدّدت Apple تشكيلة Mac mini وMac Studio في 25 أغسطس 2026 (متاحة من 22 سبتمبر 2026) لتحل محل إعدادات M4 Pro/M4 Max. بحسب Apple يبدأ Mac mini بشريحة M5 Pro من 1,699 دولار (حتى 64 GB ذاكرة موحدة، 307 GB/s)، ويبدأ Mac Studio بشريحة M5 Max من 2,499 دولار (حتى 128 GB)، وMac Studio بشريحة M5 Ultra من 5,499 دولار (حتى 512 GB؛ ويصل إعداد 512 GB في أواخر أكتوبر). يستوعب إعداد 36–48 GB النموذج Qwen3.6 27B؛ ومع 64 GB أو أكثر يتسع Qwen3.6 27B وDevstral Small 2 معًا. لا تنشر Apple أرقام رموز في الثانية للنماذج المحلية ولم تختبر PromptQuorum هذه الشرائح، فقِس باستخدام ollama run --verbose. الأسعار بالدولار الأمريكي وقد تختلف الأسعار المحلية.
- خيار Apple Silicon اقتصادي: يبدأ Mac mini الأساسي بشريحة M6 من 899 دولارًا (حتى 32 GB ذاكرة موحدة، وحتى 170 GB/s بحسب Apple) ويستوعب Devstral Small 2 (15 GB) وCodestral 22B (13 GB) بارتياح. أما Qwen3.6 27B (18–19 GB) فيتسع فقط في إعداد 32 GB مع هامش ضيق للسياق. عرض نطاق ذاكرته أقل من M5 Pro (170 مقابل 307 GB/s)، مما يعني توليدًا أبطأ؛ ولم تختبر PromptQuorum شريحة M6.
# Configuración de Ollama para Qwen3.6 27B con num_ctx y capas GPU
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
استراتيجية التوزيع متعدد النماذج
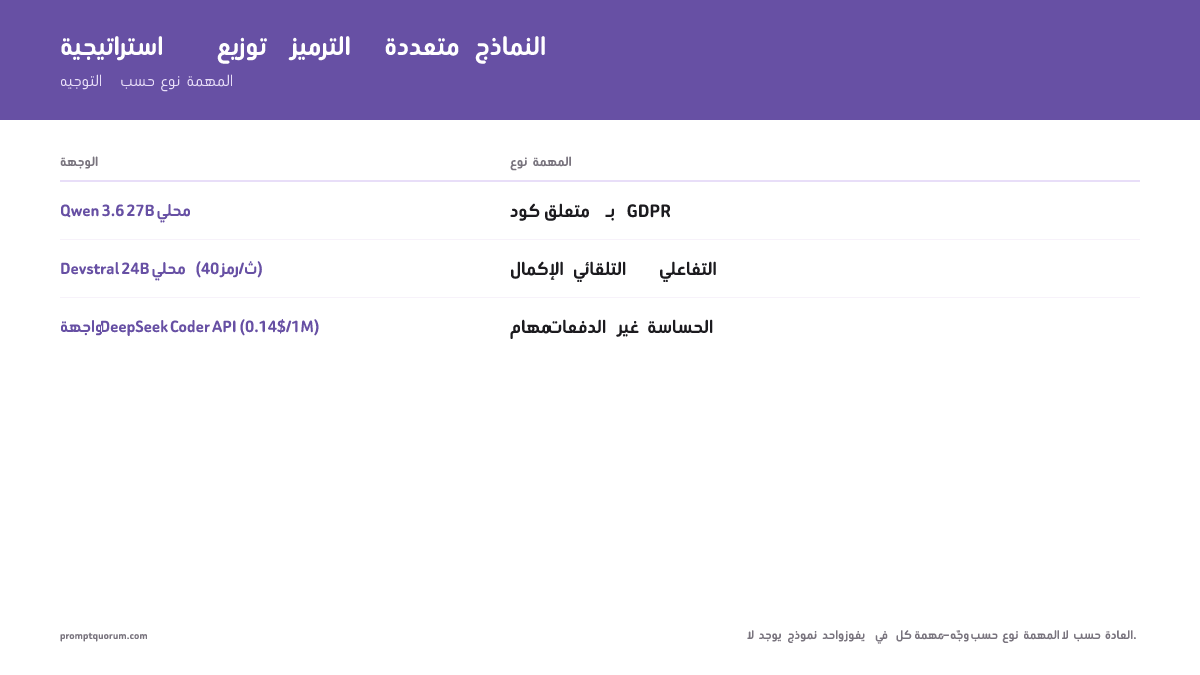
لا يتفوق نموذج برمجة واحد في كل المهام. يملك Qwen3.6 27B أقوى رقم SWE-bench محلي هنا. وDevstral Small 2 نموذج وكيلي أخف. وDeepSeek API هي الأرخص لكل رمز على نطاق واسع للشيفرة غير الحساسة. وطبقة توزيع تُوجّه المهام بحسب نوعها تجمع مزايا الثلاثة.
مصفوفة توزيع مقترحة لفريق تطوير:
نوع المهمة | النموذج الموصى به | السبب |
|---|---|---|
| شيفرة خاصة (بيانات العملاء) | Qwen3.6 27B (محلي) | تبقى الشيفرة على عتادك |
| إكمال تلقائي (تفاعلي) | Devstral Small 2 (محلي) | نموذج أخف ودون ذهاب وإياب عبر الشبكة |
| مراجعة شيفرة (غير حساسة) | DeepSeek API | 0.15 دولار/مليون إدخال خارج الذروة، إنتاجية عالية |
| إعادة هيكلة معقدة (عدة ملفات) | Qwen3.6 27B (محلي) + إجماع PromptQuorum | أقوى رقم SWE-bench محلي، والشيفرة تبقى محلية |
| توليد اختبارات دُفعي | DeepSeek API | محسّن التكلفة للحجم غير الحساس |
التكامل مع PromptQuorum
يُوجّه PromptQuorum مهام الكود بين Qwen المحلي وDevstral المحلي وواجهات API السحابية وفق قواعد تصنيف تحددها أنت. هذا يلغي التبديل اليدوي للنماذج ويُنفّذ مصفوفة التوزيع أعلاه تلقائيًا.
توجّه PromptQuorum مهام البرمجة إلى Qwen3.6 المحلي للشيفرة الحساسة وإلى DeepSeek API للتوليد الضخم غير الحساس.
# Configuración de enrutamiento PromptQuorum para cargas de trabajo de código
# Establécelo en los ajustes de PromptQuorum o en el archivo .env

# Modelos locales (vía Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B con num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Fallback cloud
DEEPSEEK_API_KEY=tu_clave_aqui
DEEPSEEK_MODEL=deepseek-flash

# Reglas de enrutamiento (despacho PromptQuorum)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (local)
# route: task_type == "autocomplete" → devstral-small-2 (local)
# route: token_count > 50000 → deepseek-flash (cloud, solo no sensible)
# default → qwen36-local (local)الأسئلة الشائعة
هل Qwen3.6 27B أفضل من DeepSeek للبرمجة المحلية؟
يُعلن Qwen3.6 27B عن 77.2% في SWE-bench Verified ويعمل بالكامل على عتادك من تنزيل بحجم 18–19 GB، لذا خطّط لبطاقة 24 GB. ويُعلن DeepSeek V4 Flash عن 78.6% (وضع High) لكنه نموذج بـ 284B معامل، ولهذا يستخدمه معظم الناس عبر واجهة API السحابية بسعر 0.15 دولار لكل مليون رمز إدخال خارج الذروة. يعتمد الخيار الأفضل على حساسية البيانات والميزانية، لا على فائز وحيد. والرقمان صادران عن الجهتين المطوّرتين بإعدادات اختبار مختلفة.
ما Devstral Small 2 ولماذا يُذكر هنا؟
Devstral Small 2 نموذج بحجم 24B من Mistral AI. تستهدف سلسلة Devstral هندسة البرمجيات الوكيلية مثل التعديلات متعددة الملفات واستخدام الأدوات. وتعرض صفحته على Ollama تنزيلًا بحجم 15 GB ونافذة سياق 384K وترخيص Apache 2.0 ودرجة 65.8% في SWE-bench Verified. هو الخيار المحلي الأخف هنا؛ بينما يُعلن Qwen3.6 27B عن رقم SWE-bench أعلى.
هل يمكنني تشغيل Qwen3.6 27B وDevstral Small 2 في آن واحد؟
ليس على بطاقة 24 GB واحدة. حجم تنزيل Qwen3.6 27B هو 18–19 GB وDevstral Small 2 هو 15 GB، أي نحو 34 GB معًا قبل السياق. ستحتاج إلى بطاقتين بسعة 24 GB أو Apple Silicon بذاكرة موحدة 64 GB أو أكثر. وعلى بطاقة واحدة شغّل نموذجًا واحدًا في كل مرة وبدّل بينهما عبر Ollama.
هل DeepSeek API آمنة لشيفرة شركات الاتحاد الأوروبي؟
تعالج DeepSeek API البيانات على خوادم تشغّلها DeepSeek، وهي شركة مسجلة في الصين، ولم تُصدر المفوضية الأوروبية قرار كفاية بشأن الصين. وإرسال بيانات شخصية أوروبية، أو شيفرة مصدرية تحتوي معلومات شخصية، إليها يستلزم تقييمًا قانونيًا وفق الفصل الخامس من GDPR (المواد 44 وما بعدها). وللشيفرة المملوكة التي لا تتضمن بيانات شخصية استشر فريقك القانوني. أما النموذج المحلي مثل Qwen3.6 27B فيُبقي الشيفرة على عتادك ويتجنب النقل إلى طرف ثالث؛ لكنه لا يجعل المشروع وحده متوافقًا مع GDPR. هذه معلومات عامة وليست استشارة قانونية.
ما SWE-bench Verified ولماذا نركز عليه؟
يختبر SWE-bench Verified، عبر مجموعة مهام راجعها بشر، ما إذا كان النموذج قادرًا على حل مشكلات GitHub حقيقية في مشاريع بايثون مفتوحة المصدر مثل Django وFlask وscikit-learn. وهو يقيس هندسة البرمجيات العملية أكثر من اختبارات الدوال المعزولة مثل HumanEval. تعتمد الدرجات كثيرًا على إطار الوكيل، لذا قارن أرقام الجهات المطوّرة بحذر.