ローカルのコーディングモデルが追いついた理由
LLM時代の初期の数年間、コーディングではクラウドモデルがローカルモデルを明確に上回っていました。その差は、コード重視の学習を受けた24~30B規模のオープンウェイトモデルが登場した2025~2026年に縮まりました。
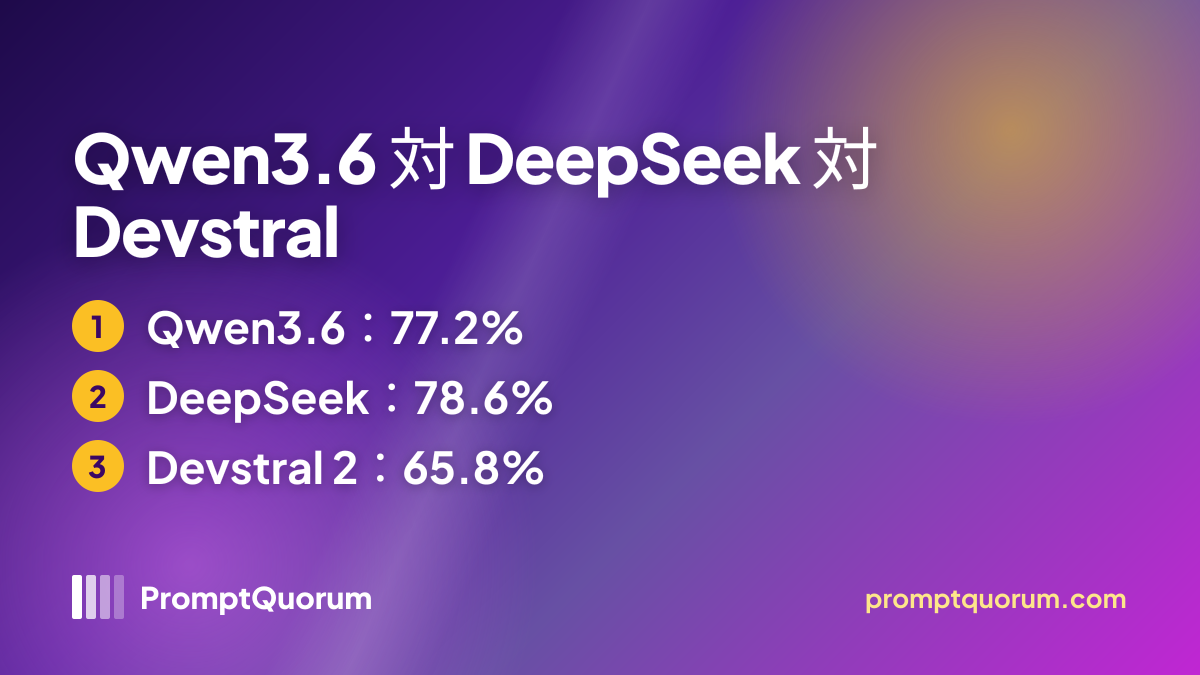
2026年4月に公開されたQwen3.6 27Bは、オープンソースPythonプロジェクトの実際のGitHub issueで構成されるベンチマークSWE-bench Verifiedで77.2を公表しています。同じモデルカードの表でQwenはQwen3.5-27Bを75.0、Claude 4.5 Opusを80.9としているため、このベンダー公表のテストでは、オープンモデルが先頭のクラウドモデルに近い位置にあります。これはQwen自身が内部のエージェント環境で得た結果であり、第三者による検証ではありません。
この収束の理由として、よく挙げられるのは(1)大規模なコード重視の学習データ、(2)一般的な指示追従ではなく実際のソフトウェアエンジニアリング課題での追加学習、(3)Q4精度でもコーディング能力を保つ改良されたGGUF量子化です。
📍 一文で説明
Qwen3.6 27BはSWE-bench Verifiedで77.2%と公表され、18~19 GBのダウンロードでローカル実行できます。
💬 簡潔に説明
SWE-bench Verifiedは、AIがDjango、Flask、scikit-learnなど実在のオープンソースプロジェクトのGitHub issueを解決できるかを測ります。77.2%は、ベンダー独自のエージェント環境で測定した場合、テスト課題100件のうち約77件を解決したという意味です。
ベンチマーク表
すべての数値は、モデルカードとOllamaのページに基づくベンダー公表値です。テスト環境はベンダーごとに異なるため、SWE-benchの数値は統制された直接比較ではなく参考値として扱ってください。PromptQuorumはこれらのベンチマークを再実行していません。
ベンチマーク | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified(ベンダー公表) | 77.2% | 78.6%(High)/ 79.0%(Max) | 65.8% | 未公開 |
| パラメータ(総数 / アクティブ) | 27B Dense | 284B / アクティブ13B | 24B Dense | 22B Dense |
| コンテキストウィンドウ | 256K | 1M | 384K | 32K |
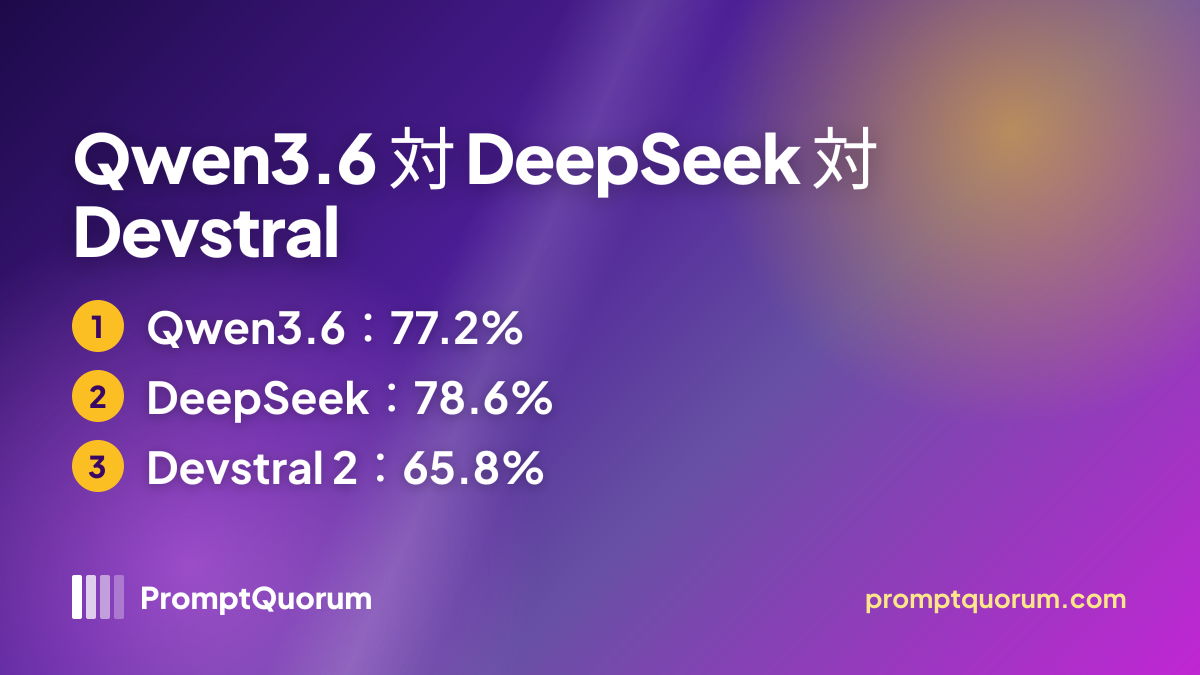
📌補足: Qwenの77.2はQwen内部のエージェント環境によるものです。DeepSeekは73.7(非思考)、78.6(High)、79.0(Max)を公表しています。Devstral Small 2の65.8はOllamaのページからのものです。環境が異なるため、数値は直接比較できません。
💡ヒント: DeepSeek APIのモデル名は変わります。デプロイ前にapi-docs.deepseek.com/quick_start/pricingを確認してください(現在の名称:deepseek-flash、deepseek-v4-pro)。
トークン単価の計算
コーディングLLMの経済性は、利用量、タスクの機密性、ハードウェアによって決まります。以下の試算は開発者1人分で、明記した前提に基づく計算であり、測定値ではありません。電気料金は、ドイツの一般的な水準である€0.35/kWhで計算しています。ご自身の料金プランを確認してください。
1日500万トークン(自動補完、テスト生成、コードレビューを多用するセッション)、入力:出力が1:2の場合、DeepSeek API(deepseek-flash、オフピークで100万トークンあたり入力$0.15、出力$0.60)は1日約$2.25、250営業日で約$560です。ピーク時料金(入力$0.30、出力$1.20)では同じ使用量で1日約$4.50、年間約$1,125になります。
ローカル構成は、これをハードウェアと電力に置き換えます。想定価格$2,300のRTX 4090が、250日間、1日8時間350 Wを消費すると700 kWh、年間約€245です。為替を無視すると、ハードウェアはAPIのオフピーク料金に対して約7年、ピーク料金に対して約2.6年で元が取れます。機密性の高いコードでは、比較はコストだけではありません。クラウドAPIはコードを第三者に送信します。
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
レイテンシの実際
対話型コーディングではレイテンシが重要です。自動補完は500 msを超えると使いにくく、コードレビューは3秒まで許容でき、バッチ処理はレイテンシの影響を受けません。PromptQuorumはこれらのモデルを測定していません。表はRTX 4090(24 GB、Ollama 0.34.4、2026年9月)でのOllamaによるサードパーティのテスト1件で、これらのモデルについて見つけられた唯一の公開結果です。実際の速度は量子化、コンテキスト長、ドライバーによって異なります。
構成 | 持続速度(トークン/秒) | 備考 |
|---|---|---|
| Qwen3.6 27B、RTX 4090(ドラフトデコード有効) | 115.4 | 5つのプロンプトの平均、出力256トークン |
| Qwen3.6 27B、RTX 4090(ドラフトデコード無効) | 48.9 | 1プロンプトでの再実行、同一構成 |
| Qwen3-Coder 30B、RTX 4090 | 224.7 | アクティブパラメータ3.3BのMoE |
| Devstral Small 2 | 未測定 | 公開された測定結果なし |
| DeepSeek API(deepseek-flash) | 未測定 | ネットワークとピーク時間帯に依存 |
出典:Ollama Models Cheat Sheet(サードパーティのテストであり、PromptQuorumによるものではありません)。記事によると、投機的デコード(ドラフトトークン)は出力品質を変えずに、このテストでQwen3.6 27Bを約2.4倍高速化しました。Appleはローカル LLMのトークン速度を公開していません。確実な数値は、お使いのハードウェアでollama run --verboseを実行して測定してください。自動補完では、ローカル推論はネットワークの往復を避けられます。
⚠️注意: Ollamaのデフォルトのコンテキストウィンドウ(利用可能なVRAMに応じて調整)は、処理するトークンが減るため見かけのスループットを高めますが、コンテキストを切り詰めます。意味のあるコーディング用レイテンシ測定には、num_ctx 32768を設定してください。
ハードウェア要件
- Qwen3.6 27B Q4_K_M(Ollama `qwen3.6:27b`、18~19 GBのダウンロード):24 GBのGPU(RTX 3090、RTX 4090)、またはユニファイドメモリ36~48 GB以上のApple Silicon。16 GBのカードでは重みを保持できません。
- Devstral Small 2 24B(Ollama `devstral-small-2`、15 GBのダウンロード):RTX 4070 Ti Super(16 GB、コンテキストを加えると厳しい)、RTX 3090またはRTX 4090(24 GB)、またはユニファイドメモリ32 GB以上のApple Silicon。
- Codestral 22B Q4_K_M(13 GBのダウンロード):RTX 4070 Ti(12 GBは限界、16 GB推奨)。
- 2つのモデルを同時に実行:Qwen3.6 27B(18~19 GB)とDevstral Small 2(15 GB)は、コンテキストを除いて合計約34 GBです。24 GBのGPU 2枚、または64 GB以上のユニファイドメモリを搭載したApple Silicon(例:M5 Max搭載Mac Studio、最大128 GB)が必要です。
- Apple Silicon:Appleは2026年8月25日にMac miniとMac Studioのラインアップを刷新し(2026年9月22日から販売)、M4 Pro/M4 Max構成を置き換えました。Appleによると、M5 Pro搭載Mac miniは$1,699から(ユニファイドメモリ最大64 GB、307 GB/s)、M5 Max搭載Mac Studioは$2,499から(最大128 GB)、M5 Ultra搭載Mac Studioは$5,499から(最大512 GB。512 GB構成は10月下旬に出荷)です。36~48 GB構成ならQwen3.6 27Bを収容でき、64 GB以上ならQwen3.6 27BとDevstral Small 2を同時に収容できます。Appleはローカル LLMの秒あたりトークン数を公開しておらず、PromptQuorumもこれらのチップを測定していないため、ollama run --verboseで測定してください。価格は米ドルで、現地価格は異なる場合があります。
- 低予算のApple Siliconオプション:エントリーモデルのM6搭載Mac miniは$899から(ユニファイドメモリ最大32 GB、Apple公表で最大170 GB/s)で、Devstral Small 2(15 GB)とCodestral 22B(13 GB)を余裕を持って収容できます。Qwen3.6 27B(18~19 GB)は32 GB構成にしか収まらず、コンテキストの余裕は小さくなります。メモリ帯域がM5 Proより低く(170 GB/s対307 GB/s)、生成は遅くなります。PromptQuorumはM6を測定していません。
# Ollama config for Qwen3.6 27B with num_ctx and GPU layers
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
マルチモデル ディスパッチ戦略
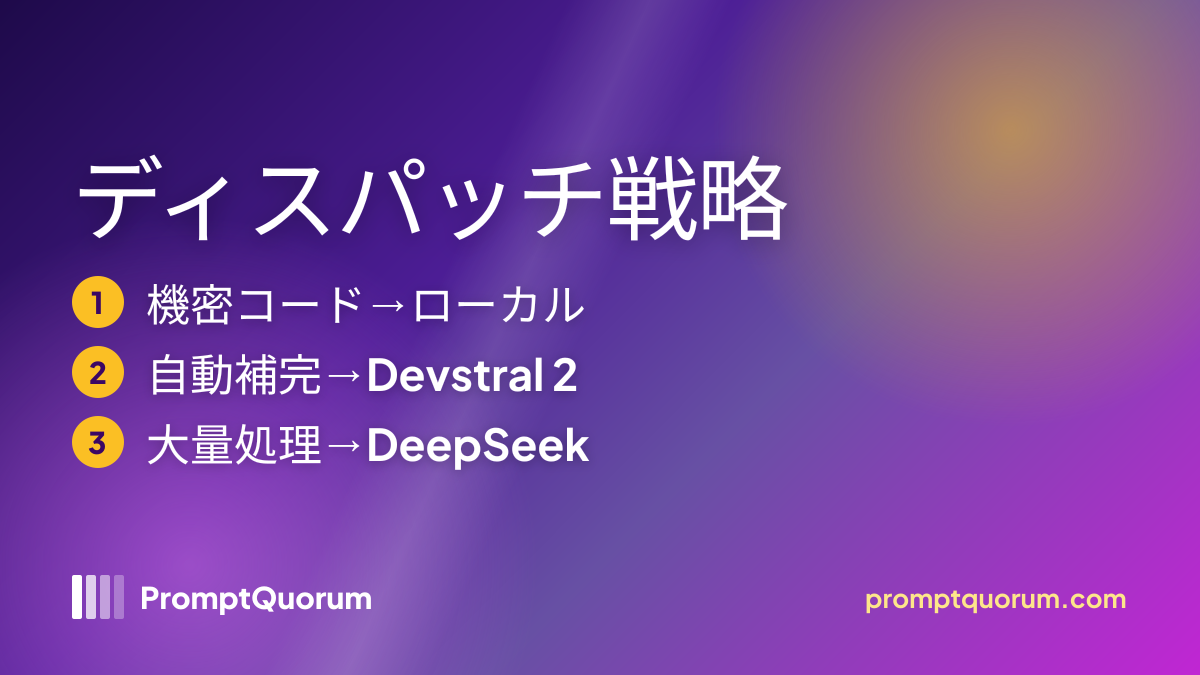
すべてのタスクで勝つコーディングモデルはありません。Qwen3.6 27Bはここで最も強力なローカルのSWE-bench値を持ちます。Devstral Small 2はより軽量なエージェント型モデルです。DeepSeek APIは、機密でないコードを大規模に処理する場合にトークンあたり最も安価です。タスクの種類ごとにルーティングするディスパッチ層を置くと、3つの利点をすべて活かせます。
開発チーム向けのディスパッチ・マトリクスの例:
タスクの種類 | 推奨モデル | 理由 |
|---|---|---|
| 非公開コード(顧客データ) | Qwen3.6 27B(ローカル) | コードが手元のハードウェアに留まる |
| 自動補完(対話型) | Devstral Small 2(ローカル) | より軽量で、ネットワークの往復なし |
| コードレビュー(機密でない) | DeepSeek API | オフピーク入力$0.15/1M、高スループット |
| 複雑なリファクタリング(複数ファイル) | Qwen3.6 27B(ローカル)+PromptQuorumコンセンサス | ローカル最強のSWE-bench値、コードはローカルのまま |
| バッチのテスト生成 | DeepSeek API | 機密でない大量処理向けにコスト最適化 |
PromptQuorum連携
PromptQuorumは、定義した分類ルールに基づいて、コーディングタスクをローカルのQwen、ローカルのDevstral、クラウドAPIに振り分けます。手動のモデル切り替えが不要になり、上記のディスパッチ・マトリクスが自動的に実装されます。
📍 一文で説明
PromptQuorumは、コーディングタスクのうち機密コードはローカルのQwen3.6へ、機密でない大量生成はDeepSeek APIへ振り分けます。
# PromptQuorum routing config for coding workloads
# Set in your PromptQuorum settings or .env file

# Local models (via Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B with num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Cloud fallback
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_MODEL=deepseek-flash

# Routing rules (PromptQuorum dispatch)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (local)
# route: task_type == "autocomplete" → devstral-small-2 (local)
# route: token_count > 50000 → deepseek-flash (cloud, non-sensitive only)
# default → qwen36-local (local)よくある質問
ローカルコーディングにはQwen3.6 27BのほうがDeepSeekより優れていますか?
Qwen3.6 27BはSWE-bench Verifiedで77.2%と公表され、18~19 GBのダウンロードで自分のハードウェア上だけで動作するため、24 GBのGPUを想定してください。DeepSeek V4 Flashは78.6%(Highモード)と公表されていますが284Bパラメータのモデルなので、多くの人はオフピークで入力100万トークンあたり$0.15のクラウドAPIとして使います。どちらが良いかは単一の勝者ではなく、データの機密性と予算で決まります。両スコアとも、異なるテスト環境によるベンダー公表値です。
Devstral Small 2とは何ですか、なぜここで取り上げられていますか?
Devstral Small 2はMistral AIの24Bモデルです。Devstralシリーズは、複数ファイルの編集やツール利用といったエージェント型のソフトウェアエンジニアリングを対象としています。Ollamaのページには、15 GBのダウンロード、384Kのコンテキストウィンドウ、Apache 2.0ライセンス、SWE-bench Verified 65.8%と表示されています。ここではより軽量なローカル選択肢で、より高いSWE-bench値を公表しているのはQwen3.6 27Bです。
Qwen3.6 27BとDevstral Small 2を同時に実行できますか?
24 GBのGPU1枚では不可能です。Qwen3.6 27Bは18~19 GB、Devstral Small 2は15 GBのダウンロードで、コンテキストを除いて合計約34 GBです。24 GBのGPU 2枚、または64 GB以上のユニファイドメモリを搭載したApple Siliconが必要です。GPU1枚では、一度に1つのモデルを実行し、Ollamaで切り替えてください。
EU企業のコードにDeepSeek APIを使用しても安全ですか?
DeepSeek APIは、中国で法人登記されているDeepSeekが運営するサーバーでデータを処理します。EU委員会は中国に対する十分性認定を出していません。EUの個人データや個人情報を含むソースコードを送信するには、GDPR第5章(第44条以下)に基づく法的評価が必要です。個人データを含まない専有コードについては法務チームに相談してください。Qwen3.6 27Bのようなローカルモデルはコードを自分のハードウェアに留め、第三者への送信を避けられますが、それだけでプロジェクトがGDPRに準拠することにはなりません。これは一般的な情報であり、法的助言ではありません。
SWE-bench Verifiedとは何であり、なぜ重視されるのですか?
SWE-bench Verifiedは、人間が検証した課題セットを使い、モデルがDjango、Flask、scikit-learnなどのオープンソースPythonプロジェクトの実際のGitHub issueを解決できるかをテストします。HumanEvalのような孤立した関数レベルのテストよりも、実践的なソフトウェアエンジニアリングを測定します。スコアはエージェント環境に大きく左右されるため、ベンダーの数値は慎重に比較してください。