本地编程模型为何追了上来
在 LLM 时代的最初几年,云端模型在编程任务上明显领先本地模型。这一差距在 2025–2026 年缩小,因为 24–30B 规模、经过侧重代码训练的开放权重模型出现了。
Qwen3.6 27B 于 2026 年 4 月发布,公布其在 SWE-bench Verified 上得分为 77.2,该基准由开源 Python 项目中的真实 GitHub issue 构成。在其模型卡的同一张表中,Qwen 列出 Qwen3.5-27B 为 75.0,Claude 4.5 Opus 为 80.9,因此在这项厂商公布的测试中,开放模型接近领先的云端模型。这是 Qwen 自己用内部智能体环境得出的结果,并非独立验证。
人们常提到的趋同原因有:(1)大规模的、侧重代码的训练数据;(2)基于真实软件工程任务而非通用指令跟随的后训练;(3)能在 Q4 精度下保留编程能力的更好的 GGUF 量化。
📍 简单一句话
Qwen3.6 27B 公布的 SWE-bench Verified 得分为 77.2%,以 18–19 GB 的下载量在本地运行。
💬 简单来说
SWE-bench Verified 测试 AI 能否解决 Django、Flask、scikit-learn 等真实开源项目中的 GitHub issue。77.2% 表示在厂商自己的智能体环境下,模型解决了约 77% 的测试任务。
基准测试表
所有数字均为厂商公布值,来自模型卡和 Ollama 页面。各厂商的测试环境不同,因此请将 SWE-bench 数字视为参考,而非受控的直接对比。PromptQuorum 没有重新运行这些基准测试。
基准 | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified(厂商公布) | 77.2% | 78.6%(High)/ 79.0%(Max) | 65.8% | 未公布 |
| 参数(总量 / 激活) | 27B 稠密 | 284B / 激活 13B | 24B 稠密 | 22B 稠密 |
| 上下文窗口 | 256K | 1M | 384K | 32K |
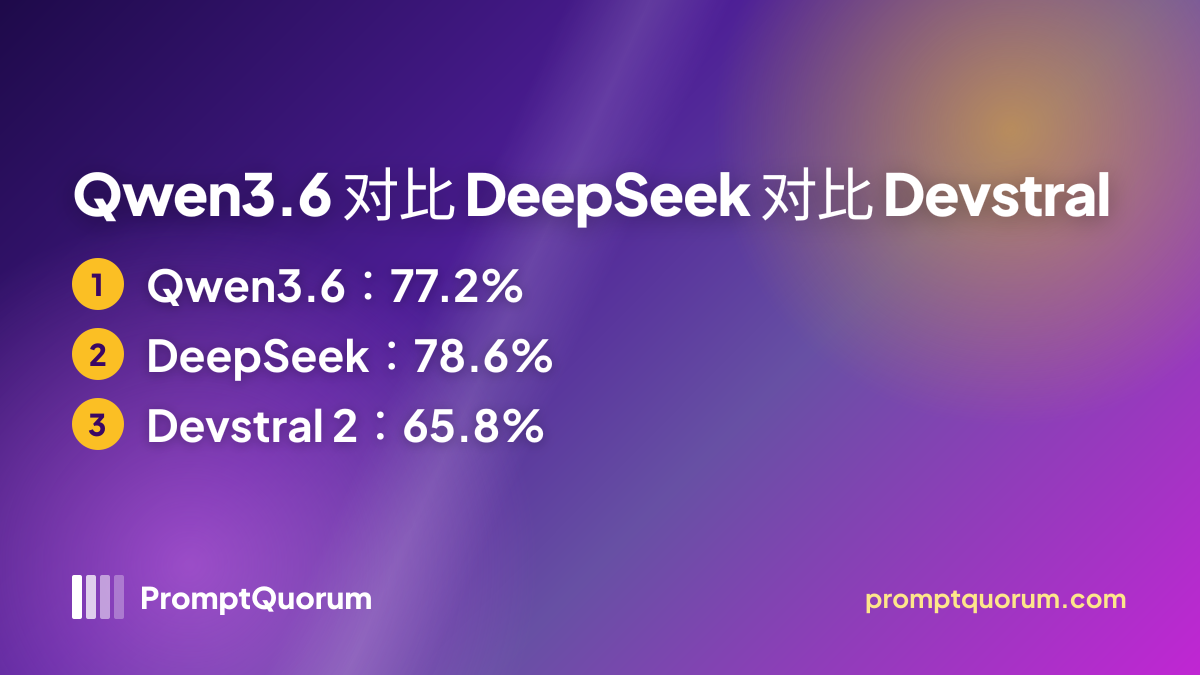
📌注: Qwen 的 77.2 使用的是 Qwen 内部的智能体环境。DeepSeek 公布 73.7(非思考)、78.6(High)和 79.0(Max)。Devstral Small 2 的 65.8 来自其 Ollama 页面。环境不同,因此数字不能直接比较。
💡提示: DeepSeek API 的模型名称会变化。部署前请查看 api-docs.deepseek.com/quick_start/pricing(当前名称:deepseek-flash 和 deepseek-v4-pro)。
每令牌成本计算
编程 LLM 的经济性取决于使用量、任务敏感度和硬件。下面的估算针对一名开发者,基于所述假设:它是算术,不是测量。电价按 0.35 欧元/千瓦时计算,这是德国的典型水平;请核对您自己的电价。
按每天 500 万令牌(密集使用自动补全、测试生成和代码审查)、输入与输出 1:2 计算,DeepSeek API(deepseek-flash,非高峰时段每百万令牌输入 $0.15、输出 $0.60)每天约 $2.25,250 个工作日约 $560。按高峰时段价格(输入 $0.30、输出 $1.20),同样用量每天约 $4.50,每年约 $1,125。
本地方案则把这笔费用换成硬件和电力。一张假定 $2,300 的 RTX 4090,250 天每天 8 小时按 350 W 计算,用电 700 千瓦时,约每年 245 欧元。忽略汇率,硬件相对 API 非高峰价格约 7 年回本,相对高峰价格约 2.6 年回本。对于敏感代码,比较不只是成本:云 API 会把您的代码发送给第三方。
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
延迟实况
延迟对交互式编程很重要:自动补全超过 500 ms 就难以使用,代码审查可接受到 3 s,批处理任务对延迟不敏感。PromptQuorum 没有测量过这些模型。下表展示的是 RTX 4090(24 GB,Ollama 0.34.4,2026 年 9 月)上使用 Ollama 的一项第三方测试,这是我们为这些模型找到的唯一公开结果;实际速度会因量化、上下文长度和驱动而不同。
配置 | 持续速度(令牌/秒) | 备注 |
|---|---|---|
| Qwen3.6 27B,RTX 4090(开启草稿解码) | 115.4 | 五个提示词的平均值,输出 256 个令牌 |
| Qwen3.6 27B,RTX 4090(关闭草稿解码) | 48.9 | 单个提示词重测,配置相同 |
| Qwen3-Coder 30B,RTX 4090 | 224.7 | 激活参数 3.3B 的 MoE |
| Devstral Small 2 | 未测试 | 未找到公开测试结果 |
| DeepSeek API(deepseek-flash) | 未测试 | 取决于网络和高峰时段 |
来源:Ollama Models Cheat Sheet(第三方测试,并非 PromptQuorum 所测)。据该文章称,推测解码(草稿令牌)在不改变输出质量的情况下,使 Qwen3.6 27B 在该测试中快了约 2.4 倍。Apple 不公布本地 LLM 的令牌速度。请在自己的硬件上运行 ollama run --verbose 获取可靠数字。对于自动补全,本地推理省去了网络往返。
⚠️警告: Ollama 默认的上下文窗口(按可用显存调整)会因处理的令牌更少而提高表观吞吐量,但会截断上下文。为获得有意义的编程延迟测量,请设置 num_ctx 32768。
硬件要求
- Qwen3.6 27B Q4_K_M(Ollama `qwen3.6:27b`,下载 18–19 GB):24 GB 显卡(RTX 3090、RTX 4090),或统一内存 36–48 GB 及以上的 Apple Silicon。16 GB 显卡装不下权重。
- Devstral Small 2 24B(Ollama `devstral-small-2`,下载 15 GB):RTX 4070 Ti Super(16 GB,加上上下文后偏紧)、RTX 3090 或 RTX 4090(24 GB),或统一内存 32 GB 及以上的 Apple Silicon。
- Codestral 22B Q4_K_M(下载 13 GB):RTX 4070 Ti(12 GB 勉强,推荐 16 GB)。
- 同时运行两个模型:Qwen3.6 27B(18–19 GB)加 Devstral Small 2(15 GB)在不含上下文时约 34 GB,需要两张 24 GB 显卡,或配备 64 GB 以上统一内存的 Apple Silicon,例如配备 M5 Max 的 Mac Studio(最高 128 GB)。
- Apple Silicon:Apple 于 2026 年 8 月 25 日更新了 Mac mini 和 Mac Studio 产品线(2026 年 9 月 22 日起发售),取代了 M4 Pro/M4 Max 配置。据 Apple 介绍,配备 M5 Pro 的 Mac mini 起价 $1,699(统一内存最高 64 GB,307 GB/s),配备 M5 Max 的 Mac Studio 起价 $2,499(最高 128 GB),配备 M5 Ultra 的 Mac Studio 起价 $5,499(最高 512 GB;512 GB 配置于 10 月下旬发货)。36–48 GB 配置可容纳 Qwen3.6 27B;64 GB 及以上可同时容纳 Qwen3.6 27B 和 Devstral Small 2。Apple 不公布本地 LLM 的每秒令牌数,PromptQuorum 也未测试这些芯片,请用 ollama run --verbose 自行测量。价格为美元,当地价格可能不同。
- 入门级 Apple Silicon 选择:入门款配备 M6 的 Mac mini 起价 $899(统一内存最高 32 GB,据 Apple 最高 170 GB/s),可轻松容纳 Devstral Small 2(15 GB)和 Codestral 22B(13 GB)。Qwen3.6 27B(18–19 GB)只能放进 32 GB 配置,留给上下文的余量很小。其内存带宽低于 M5 Pro(170 对 307 GB/s),生成速度会更慢;PromptQuorum 未测试 M6。
# Ollama config for Qwen3.6 27B with num_ctx and GPU layers
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
多模型调度策略
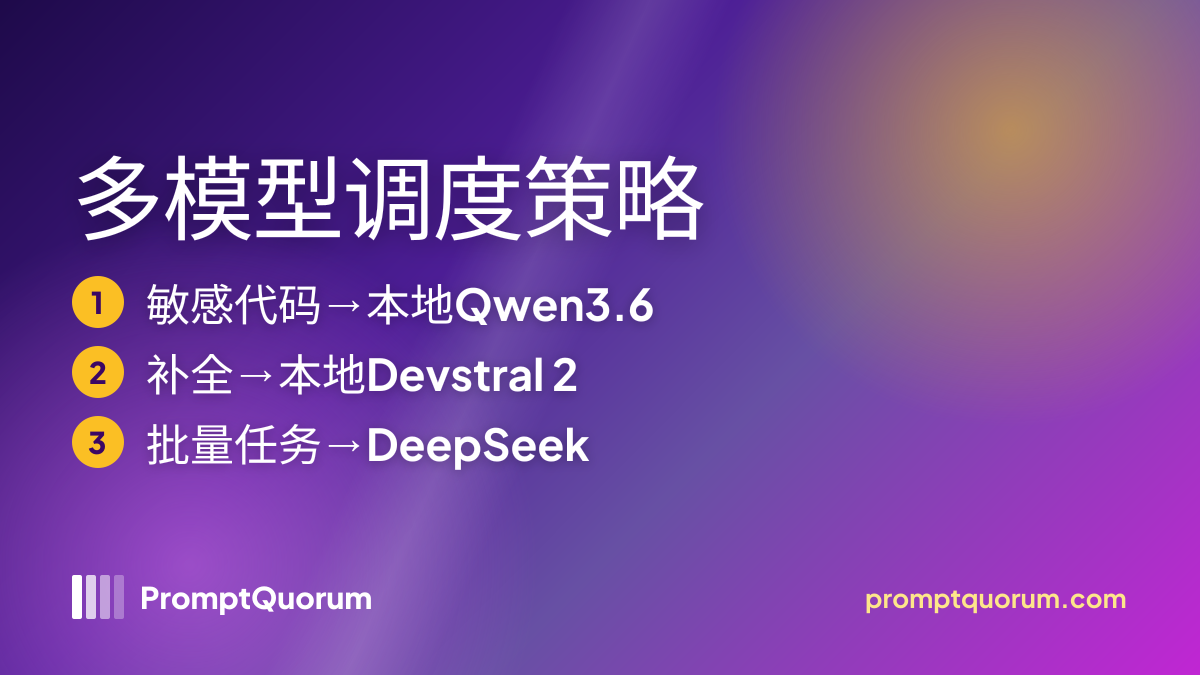
没有哪个编程模型能赢下所有任务。Qwen3.6 27B 拥有这里最强的本地 SWE-bench 数字。Devstral Small 2 是更轻量的智能体模型。对于非敏感代码,DeepSeek API 在大规模使用时每令牌最便宜。按任务类型路由的调度层可以兼得三者的优势。
面向开发团队的调度矩阵建议:
任务类型 | 推荐模型 | 原因 |
|---|---|---|
| 私有代码(客户数据) | Qwen3.6 27B(本地) | 代码留在您的硬件上 |
| 自动补全(交互式) | Devstral Small 2(本地) | 更轻量,没有网络往返 |
| 代码审查(非敏感) | DeepSeek API | 非高峰输入 $0.15/1M,吞吐量高 |
| 复杂重构(多文件) | Qwen3.6 27B(本地)+ PromptQuorum 共识 | 本地最强的 SWE-bench 数字,代码留在本地 |
| 批量测试生成 | DeepSeek API | 针对非敏感大批量任务优化成本 |
PromptQuorum 集成
PromptQuorum 根据您定义的分类规则,把编程任务路由到本地 Qwen、本地 Devstral 和云 API。这省去了手动切换模型,并自动实现上面的调度矩阵。
📍 简单一句话
PromptQuorum 把编程任务中的敏感代码路由到本地 Qwen3.6,把非敏感的大批量生成路由到 DeepSeek API。
# PromptQuorum routing config for coding workloads
# Set in your PromptQuorum settings or .env file

# Local models (via Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B with num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Cloud fallback
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_MODEL=deepseek-flash

# Routing rules (PromptQuorum dispatch)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (local)
# route: task_type == "autocomplete" → devstral-small-2 (local)
# route: token_count > 50000 → deepseek-flash (cloud, non-sensitive only)
# default → qwen36-local (local)常见问题
在本地编程方面,Qwen3.6 27B比DeepSeek更好吗?
Qwen3.6 27B 公布的 SWE-bench Verified 得分为 77.2%,以 18–19 GB 的下载量完全在你自己的硬件上运行,请按 24 GB 显卡规划。DeepSeek V4 Flash 公布 78.6%(High 模式),但它是 284B 参数的模型,因此多数人通过云 API 使用,非高峰时段每百万输入令牌 $0.15。更好的选择取决于数据敏感度和预算,而不是唯一的赢家。两个分数都是不同测试环境下的厂商公布值。
Devstral Small 2是什么,为什么在这里提及?
Devstral Small 2 是 Mistral AI 的 24B 模型。Devstral 系列面向智能体式软件工程,例如多文件修改和工具使用。其 Ollama 页面显示 15 GB 下载、384K 上下文窗口、Apache 2.0 许可证以及 SWE-bench Verified 65.8%。它是这里更轻量的本地选择;公布更高 SWE-bench 数值的是 Qwen3.6 27B。
我可以同时运行Qwen3.6 27B和Devstral Small 2吗?
在单张 24 GB 显卡上不行。Qwen3.6 27B 下载 18–19 GB,Devstral Small 2 下载 15 GB,不含上下文合计约 34 GB。您需要两张 24 GB 显卡,或配备 64 GB 以上统一内存的 Apple Silicon。使用单张显卡时,一次运行一个模型并通过 Ollama 切换。
DeepSeek API用于欧盟企业代码是否安全?
DeepSeek API 在由 DeepSeek(一家在中国注册成立的公司)运营的服务器上处理数据,欧盟委员会尚未就中国发布充分性认定决定。向其发送欧盟个人数据或包含个人信息的源代码,需要依据 GDPR 第五章(第 44 条及以下)进行法律评估。对于不含个人数据的专有代码,请咨询您的法务团队。像 Qwen3.6 27B 这样的本地模型把代码留在您自己的硬件上,避免向第三方传输;但这本身并不使项目符合 GDPR。以上为一般性信息,不构成法律意见。
什么是SWE-bench Verified,为什么要关注它?
SWE-bench Verified 使用由人工验证的任务集,测试模型能否解决 Django、Flask、scikit-learn 等开源 Python 项目中的真实 GitHub issue。相比 HumanEval 这类孤立的函数级测试,它更能衡量实际的软件工程能力。分数在很大程度上取决于智能体环境,因此请谨慎比较各厂商的数字。