Por que os modelos locais de código alcançaram os da nuvem
Nos primeiros anos da era dos LLMs, os modelos na nuvem estavam claramente à frente dos locais em programação. Essa diferença diminuiu em 2025–2026, quando modelos open-weight de 24–30 bilhões de parâmetros receberam treinamento focado em código.
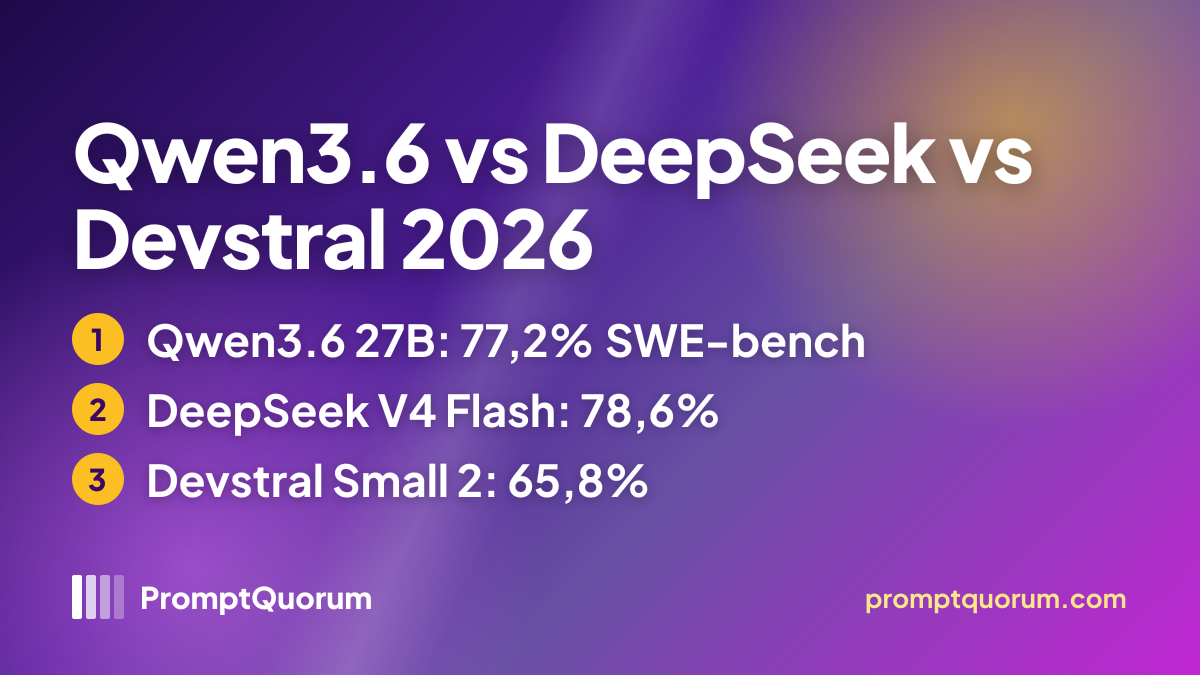
O Qwen3.6 27B, lançado em abril de 2026, informa 77,2 no SWE-bench Verified, um benchmark de issues reais do GitHub em projetos Python de código aberto. Na mesma tabela do seu model card, a Qwen lista 75,0 para o Qwen3.5-27B e 80,9 para o Claude 4.5 Opus, de modo que o modelo aberto fica perto de um modelo de nuvem de ponta neste teste divulgado pelo fabricante. São resultados da própria Qwen com um arcabouço de agente interno, não uma verificação independente.
As razões mais citadas para a convergência são (1) dados de treinamento focados em código em grande escala, (2) pós-treinamento em tarefas reais de engenharia de software em vez de seguir instruções genéricas e (3) melhor quantização GGUF, que preserva a capacidade de programar em precisão Q4.
O Qwen3.6 27B informa 77,2% no SWE-bench Verified e roda localmente a partir de um download de 18–19 GB.
O SWE-bench Verified testa se uma IA consegue resolver issues reais do GitHub em projetos de código aberto como Django, Flask e scikit-learn. Uma pontuação de 77,2% significa que o modelo resolveu cerca de 77 de cada 100 tarefas de teste, medido com o arcabouço de agente do próprio fabricante.
Tabela de benchmarks
Todos os números são dos fabricantes, extraídos de model cards e páginas do Ollama. As configurações de teste diferem entre fabricantes, então trate os números do SWE-bench como indicativos, não como um confronto controlado. A PromptQuorum não executou esses benchmarks novamente.
Benchmark | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified (número do fabricante) | 77,2% | 78,6% (High) / 79,0% (Max) | 65,8% | Não publicado |
| Parâmetros (total / ativos) | 27B denso | 284B / 13B ativos | 24B denso | 22B denso |
| Janela de contexto | 256K | 1M | 384K | 32K |
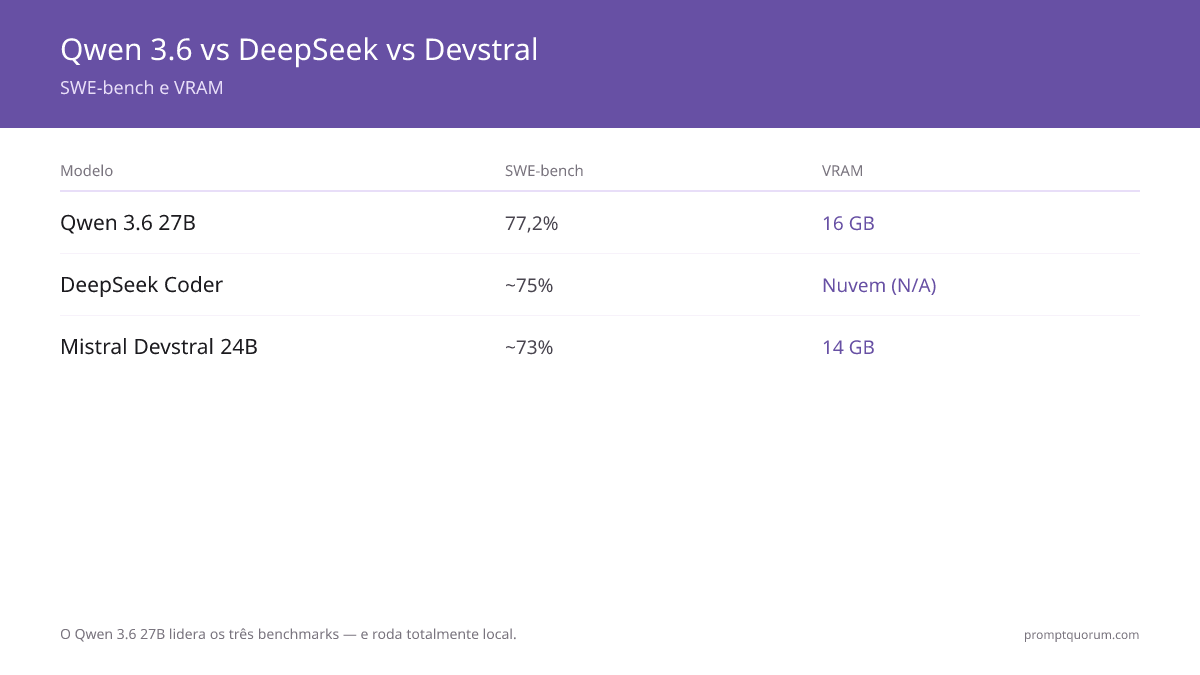
📌Nota: O 77,2 da Qwen usa o arcabouço de agente interno da Qwen. A DeepSeek informa 73,7 (sem raciocínio), 78,6 (High) e 79,0 (Max). O 65,8 do Devstral Small 2 vem da sua página no Ollama. Os arcabouços diferem, então os números não são diretamente comparáveis.
💡Dica: Os nomes de modelo da API do DeepSeek mudam. Confira api-docs.deepseek.com/quick_start/pricing antes da implantação (nomes atuais: deepseek-flash e deepseek-v4-pro).
Matemática de custo por token
A economia dos LLMs de código depende do volume de uso, da sensibilidade das tarefas e do hardware. A projeção abaixo é para um desenvolvedor e se baseia nas premissas indicadas: é aritmética, não uma medição. A eletricidade é calculada a € 0,35/kWh, uma tarifa alemã típica; verifique a sua própria tarifa.
Com 5 milhões de tokens por dia (uma sessão intensa de autocompletar, geração de testes e revisão de código) e proporção de entrada para saída de 1:2, a API do DeepSeek (deepseek-flash, US$ 0,15 de entrada e US$ 0,60 de saída por milhão de tokens fora do pico) custa cerca de US$ 2,25 por dia, ou aproximadamente US$ 560 em 250 dias úteis. Nas tarifas de pico (US$ 0,30 de entrada, US$ 1,20 de saída), o mesmo uso custa cerca de US$ 4,50 por dia, ou aproximadamente US$ 1.125 por ano.
Uma configuração local troca isso por hardware e energia. Uma RTX 4090 a US$ 2.300 (premissa), consumindo 350 W por 8 horas em 250 dias, usa 700 kWh, cerca de € 245 por ano. Ignorando taxas de câmbio, o hardware se paga em cerca de 7 anos contra as tarifas fora do pico da API e em cerca de 2,6 anos contra as tarifas de pico. Para código sensível, a comparação não é só de custo: uma API na nuvem envia seu código a terceiros. Para o Brasil, substitua o preço da GPU e a tarifa pelos valores que você realmente paga em reais (R$/kWh com impostos, conforme a sua fatura); os valores em dólar e em euro acima são apenas premissas explícitas.
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
A realidade da latência
A latência importa na programação interativa: o autocompletar fica inutilizável acima de 500 ms, a revisão de código é aceitável até 3 s e tarefas em lote são insensíveis à latência. A PromptQuorum não mediu esses modelos. A tabela mostra um teste de terceiros com o Ollama em uma RTX 4090 (24 GB, Ollama 0.34.4, setembro de 2026), a única medição publicada que encontramos para esses modelos; suas velocidades vão variar conforme a quantização, o tamanho do contexto e os drivers.
Configuração | Sustentado (tok/s) | Observações |
|---|---|---|
| Qwen3.6 27B, RTX 4090 (draft decoding ligado) | 115,4 | Média de cinco prompts, 256 tokens de saída |
| Qwen3.6 27B, RTX 4090 (draft decoding desligado) | 48,9 | Um único prompt, mesma configuração |
| Qwen3-Coder 30B, RTX 4090 | 224,7 | MoE com 3,3B de parâmetros ativos |
| Devstral Small 2 | Não medido | Nenhuma medição publicada encontrada |
| API do DeepSeek (deepseek-flash) | Não medido | Depende da rede e dos horários de pico |
Fonte: Ollama Models Cheat Sheet (teste de terceiros, não da PromptQuorum). Segundo o artigo, a decodificação especulativa (draft tokens) deixou o Qwen3.6 27B cerca de 2,4 vezes mais rápido nesse teste sem alterar a qualidade da saída. A Apple não publica velocidades em tokens para LLMs locais. Execute ollama run --verbose no seu próprio hardware para um número confiável. No autocompletar, a inferência local evita a ida e volta pela rede.
⚠️Aviso: A janela de contexto padrão do Ollama (ajustada à VRAM disponível) aumenta a vazão aparente porque menos tokens são processados, mas trunca o contexto. Defina num_ctx 32768 para medições de latência de programação relevantes.
Requisitos de hardware
- Qwen3.6 27B Q4_K_M (Ollama `qwen3.6:27b`, download de 18–19 GB): uma GPU de 24 GB (RTX 3090, RTX 4090) ou Apple Silicon com 36–48 GB ou mais de memória unificada. Uma placa de 16 GB não comporta os pesos.
- Devstral Small 2 24B (Ollama `devstral-small-2`, download de 15 GB): RTX 4070 Ti Super (16 GB, apertada ao adicionar contexto), RTX 3090 ou RTX 4090 (24 GB), ou Apple Silicon com 24 GB ou mais de memória unificada.
- Codestral 22B Q4_K_M (download de 13 GB): RTX 4070 Ti (12 GB no limite, 16 GB recomendado).
- Rodar dois modelos ao mesmo tempo: Qwen3.6 27B (18–19 GB) mais Devstral Small 2 (15 GB) somam cerca de 34 GB antes do contexto, então são necessárias duas GPUs de 24 GB ou Apple Silicon com 64 GB ou mais de memória unificada, por exemplo um Mac Studio com M5 Max (até 128 GB).
- Apple Silicon: a Apple renovou a linha Mac mini e Mac Studio em 25 de agosto de 2026 (disponível a partir de 22 de setembro de 2026), substituindo as configurações M4 Pro/M4 Max. Segundo a Apple, o Mac mini com M5 Pro começa em US$ 1.699 (até 64 GB de memória unificada, 307 GB/s), o Mac Studio com M5 Max em US$ 2.499 (até 128 GB) e o Mac Studio com M5 Ultra em US$ 5.499 (até 512 GB; a configuração de 512 GB chega no fim de outubro). Uma configuração de 36–48 GB comporta o Qwen3.6 27B; com 64 GB ou mais cabem juntos o Qwen3.6 27B e o Devstral Small 2. A Apple não publica números de tokens por segundo para LLMs locais e a PromptQuorum não avaliou esses chips: meça com ollama run --verbose. Preços em dólares americanos; os preços locais podem variar.
- Opção econômica de Apple Silicon: o Mac mini de entrada com M6 começa em US$ 899 (até 32 GB de memória unificada, até 170 GB/s segundo a Apple) e comporta com folga o Devstral Small 2 (15 GB) e o Codestral 22B (13 GB). O Qwen3.6 27B (18–19 GB) só cabe na configuração de 32 GB, com pouca margem para o contexto. A largura de banda de memória é menor que a do M5 Pro (170 contra 307 GB/s), o que significa geração mais lenta; a PromptQuorum não avaliou o M6.
# Configuração do Ollama para Qwen3.6 27B com num_ctx e camadas de GPU
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
Estratégia de despacho multimodelo
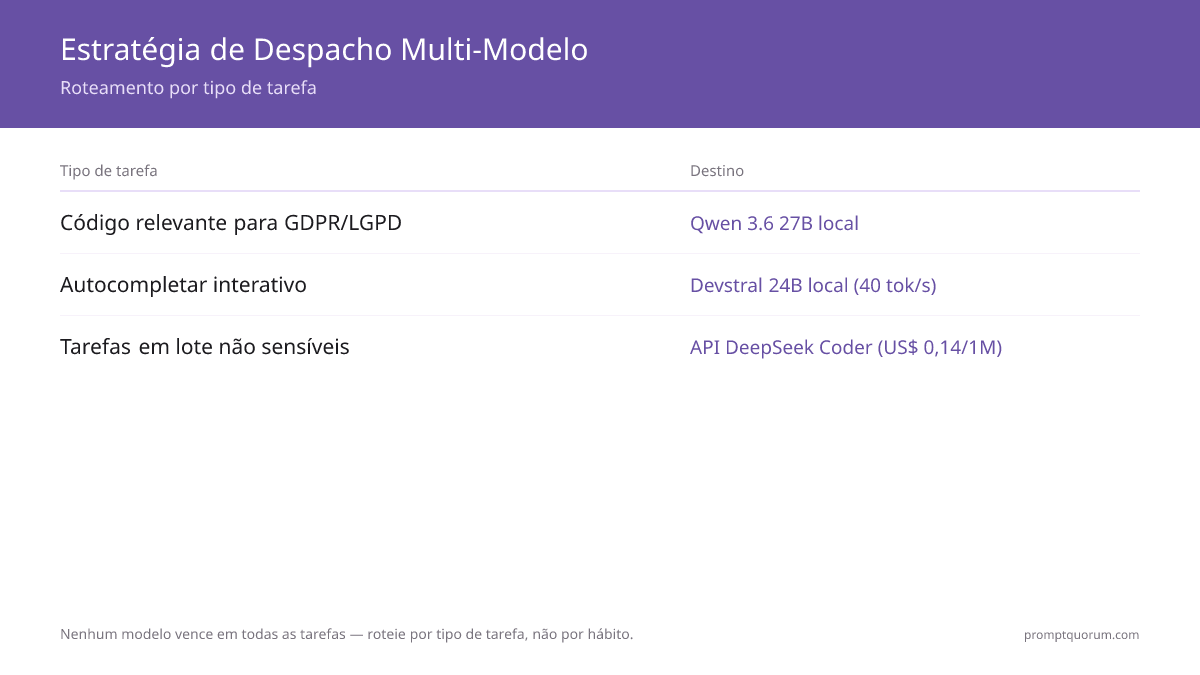
Nenhum modelo de código vence em todas as tarefas. O Qwen3.6 27B tem o melhor número local de SWE-bench aqui. O Devstral Small 2 é um modelo agêntico mais leve. Uma API do DeepSeek é a mais barata por token em escala para código não sensível. Uma camada de despacho que roteia as tarefas por tipo aproveita as vantagens dos três.
Uma matriz de despacho sugerida para uma equipe de desenvolvimento:
Tipo de tarefa | Modelo recomendado | Por quê |
|---|---|---|
| Código privado (dados de clientes) | Qwen3.6 27B (local) | O código permanece no seu hardware |
| Autocompletar (interativo) | Devstral Small 2 (local) | Modelo mais leve, sem ida e volta pela rede |
| Revisão de código (não sensível) | API do DeepSeek | US$ 0,15/1M de entrada fora do pico, alto desempenho |
| Refatoração complexa (vários arquivos) | Qwen3.6 27B (local) + consenso PromptQuorum | Melhor número local de SWE-bench, código local |
| Geração de testes em lote | API do DeepSeek | Otimizado em custo para volume não sensível |
Integração com o PromptQuorum
O PromptQuorum roteia as tarefas de código entre o Qwen local, o Devstral local e APIs em nuvem conforme regras de classificação que você define. Isso elimina a troca manual de modelos e implementa automaticamente a matriz de despacho acima.
A PromptQuorum roteia tarefas de código para o Qwen3.6 local em código sensível e para uma API do DeepSeek na geração em massa não sensível.
# Configuração de roteamento do PromptQuorum para cargas de trabalho de código
# Defina nas configurações do PromptQuorum ou no arquivo .env

# Modelos locais (via Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B com num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Fallback em nuvem
DEEPSEEK_API_KEY=sua_chave_aqui
DEEPSEEK_MODEL=deepseek-flash

# Regras de roteamento (despacho PromptQuorum)
# route: task_contains("private") OR task_contains("customer") -> qwen36-local (local)
# route: task_type == "autocomplete" -> devstral (local)
# route: token_count > 50000 -> deepseek-chat (nuvem, apenas nao sensivel)
# default -> qwen36-local (local)Perguntas frequentes
O Qwen3.6 27B é melhor que o DeepSeek para programar localmente?
O Qwen3.6 27B informa 77,2% no SWE-bench Verified e roda totalmente no seu hardware a partir de um download de 18–19 GB, então planeje uma GPU de 24 GB. O DeepSeek V4 Flash informa 78,6% (modo High), mas é um modelo de 284B parâmetros, por isso a maioria o usa pela API na nuvem a US$ 0,15 por milhão de tokens de entrada fora do pico. A melhor escolha depende da sensibilidade dos dados e do orçamento, não de um único vencedor. Os dois números são dos fabricantes e usam configurações de teste diferentes.
O que é o Devstral Small 2 e por que ele é citado aqui?
O Devstral Small 2 é um modelo de 24B da Mistral AI. A linha Devstral mira engenharia de software agêntica, como edições em vários arquivos e uso de ferramentas. A página dele no Ollama mostra download de 15 GB, janela de contexto de 384K, licença Apache 2.0 e 65,8% no SWE-bench Verified. É a opção local mais leve aqui; o Qwen3.6 27B informa o número de SWE-bench mais alto.
Posso rodar o Qwen3.6 27B e o Devstral Small 2 ao mesmo tempo?
Não em uma única GPU de 24 GB. O Qwen3.6 27B tem download de 18–19 GB e o Devstral Small 2 de 15 GB, cerca de 34 GB juntos antes do contexto. Você precisaria de duas GPUs de 24 GB ou Apple Silicon com 64 GB ou mais de memória unificada. Com uma GPU, rode um modelo por vez e alterne pelo Ollama.
Uma API do DeepSeek é segura para código de empresas da UE?
A API do DeepSeek processa dados em servidores operados pela DeepSeek, empresa constituída na China, e a Comissão Europeia não emitiu decisão de adequação para a China. Enviar a ela dados pessoais da UE, ou código-fonte com informações pessoais, exige avaliação jurídica conforme o Capítulo V do GDPR (artigos 44 e seguintes). Para código proprietário sem dados pessoais, consulte seu time jurídico. Um modelo local como o Qwen3.6 27B mantém o código no seu próprio hardware e evita a transferência a terceiros; isso não torna, por si só, um projeto conforme à legislação. Esta é uma informação geral, não aconselhamento jurídico.
O que é o SWE-bench Verified e por que focar nele?
O SWE-bench Verified testa, com uma seleção de tarefas validadas por pessoas, se um modelo consegue resolver issues reais do GitHub em projetos Python de código aberto como Django, Flask e scikit-learn. Ele mede engenharia de software prática melhor do que testes isolados em nível de função, como o HumanEval. As pontuações dependem muito do arcabouço do agente, então compare os números dos fabricantes com cuidado.