로컬 LLM에 VRAM이 얼마나 필요합니까?
빠른 답변
4 GB VRAM으로 Llama 3.2 3B와 Phi-3.5-mini를 컨텍스트 확장 여유를 두고 편안하게 실행할 수 있습니다. 6 GB로 Q4에서 Llama 3.1 8B를 실행할 수 있습니다. 12 GB로 Qwen3 14B Q4를 효율적으로 로드할 수 있습니다. Q4에서 70B 모델은 16+ GB가 필요합니다.
- ▸4 GB: Llama 3.2 3B Q4, Phi-3.5-mini Q4
- ▸6 GB: Llama 3.1 8B Q4_K_M
- ▸8~12 GB: Llama 3.1 8B Q5_K_M, Qwen3 14B Q4
핵심 요점
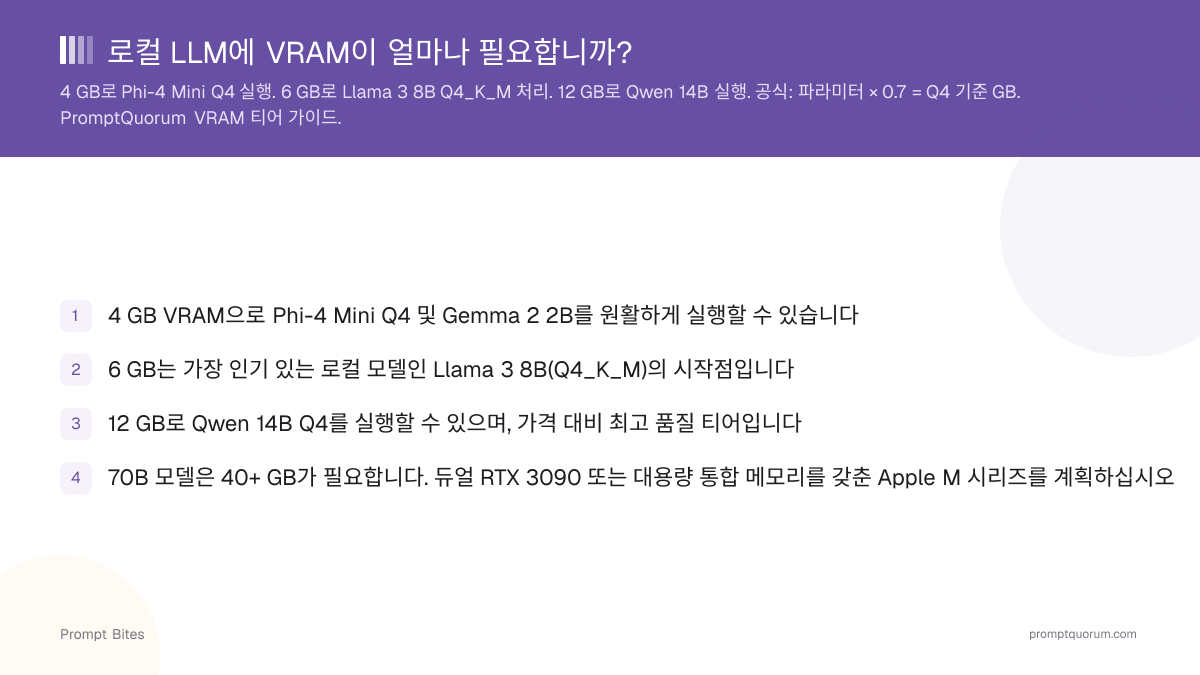
- ✓4 GB VRAM으로 Llama 3.2 3B 및 Phi-3.5-mini를 원활하게 실행할 수 있습니다
- ✓6 GB는 가장 인기 있는 로컬 모델 크기인 Llama 3.1 8B(Q4_K_M)의 시작점입니다
- ✓12 GB로 Qwen3 14B Q4를 실행할 수 있으며, 가격 대비 최고 품질 티어입니다
- ✓70B 모델은 40+ GB가 필요합니다. 듀얼 RTX 3090 또는 대용량 통합 메모리를 갖춘 Apple M 시리즈를 계획하십시오
모델 크기별 VRAM 요구사항
모델의 VRAM 필요량은 실제 GGUF 파일 크기로 검증된 단순한 계산식을 따릅니다: 파라미터 수(십억 단위) × 0.6 = Q4 양자화 기준 대략적인 GB. 8B 모델은 가중치에 약 4.8 GB가 필요하며, 컨텍스트 오버헤드로 0.5~1 GB가 추가됩니다. 따라서 6 GB가 7~8B 티어의 최소 요건이며, 12 GB로 14B 티어를 여유 있게 실행할 수 있습니다.
아래 표를 빠른 의사결정 참조용으로 사용하십시오. "속도" 열은 기본 컨텍스트(2048 토큰)에서 데스크톱 GPU로 Ollama를 실행하는 경우를 가정합니다.
항상 모델의 명시된 요구사항보다 1~2 GB의 VRAM을 여유로 남겨 두십시오. 운영체제, 브라우저 탭, Ollama 런타임은 모델이 로드되지 않아도 500 MB~1 GB를 소비합니다. Llama 3.1 8B Q4_K_M(~4.8 GB)을 실행하는 6 GB 카드는 여유 공간이 약 1.2 GB뿐이므로 --num-ctx를 2048 토큰보다 크게 늘리면 메모리 부족 오류가 발생합니다. 안전한 여유가 있는 6 GB 티어에 대해서는 6 GB VRAM 최적 로컬 LLM을 참조하십시오.
| VRAM | Q4_K_M 최적 모델 | 속도 |
|---|---|---|
| 4 GB | Llama 3.2 3B 또는 Phi-3.5-mini Q4 | ~25 tok/s |
| 6 GB | Llama 3.1 8B Q4_K_M | ~20 tok/s |
| 8 GB | Llama 3.1 8B Q5_K_M | ~18 tok/s |
| 12 GB | Qwen3 14B Q4_K_M | ~15 tok/s |
| 16+ GB | Qwen3 32B Q4 또는 Llama 3.3 70B 부분 로드 | ~8 tok/s |
📍 한 문장으로
모델의 VRAM 필요량은 실제 GGUF 파일 크기로 검증된 계산식을 따릅니다: 파라미터 수(십억 단위) × 0.6 = Q4 양자화 기준 대략적인 GB.
💬 쉽게 설명하면
8B 모델은 가중치에 약 4.8 GB가 필요하고, 컨텍스트 오버헤드로 0.5~1 GB가 추가됩니다. 따라서 7~8B 티어의 최소 요건은 6 GB이며, 12 GB로 14B 티어를 여유 있게 실행할 수 있습니다.
VRAM이 부족할 때의 대처법
모델이 VRAM을 초과할 경우 세 가지 옵션이 있습니다. 양자화를 낮추거나(Q5 대신 Q4_K_M), --num-ctx 2048로 컨텍스트 창을 줄이거나, Ollama가 레이어를 시스템 RAM으로 오프로드하도록 허용하는 방법입니다.
CPU 오프로드는 작동하지만 속도가 느립니다. RAM으로 이동된 레이어마다 지연이 추가됩니다. 인터랙티브 사용을 위해서는 GPU의 VRAM 한도 내에서 유지하십시오. 7-8B 모델에서 컨텍스트를 4096에서 2048 토큰으로 줄이면 약 2 GB를 절약할 수 있습니다.
모델 크기와 VRAM 추정 계산에 대한 전체 분석은 로컬 LLM VRAM 완전 가이드를 참조하십시오. 7B 티어에 대해서는 7B 모델에 필요한 RAM 용량을 참조하십시오.
관련 읽을거리
VRAM에 관한 자주 묻는 질문
8 GB VRAM으로 로컬 LLM을 실행하기에 충분합니까?▾
4 GB VRAM으로 7B 모델을 실행할 수 있습니까?▾
컨텍스트 창 크기가 VRAM 사용량에 영향을 줍니까?▾
모델이 예상보다 더 많은 VRAM을 사용할 때 어떻게 해야 합니까?▾
--num-ctx 2048을 설정하십시오. 이렇게 하면 모델 파일을 변경하지 않고도 7B 모델에서 VRAM을 최대 2 GB까지 줄일 수 있습니다.