6 GB VRAM에 최적인 로컬 LLM은?
빠른 답변
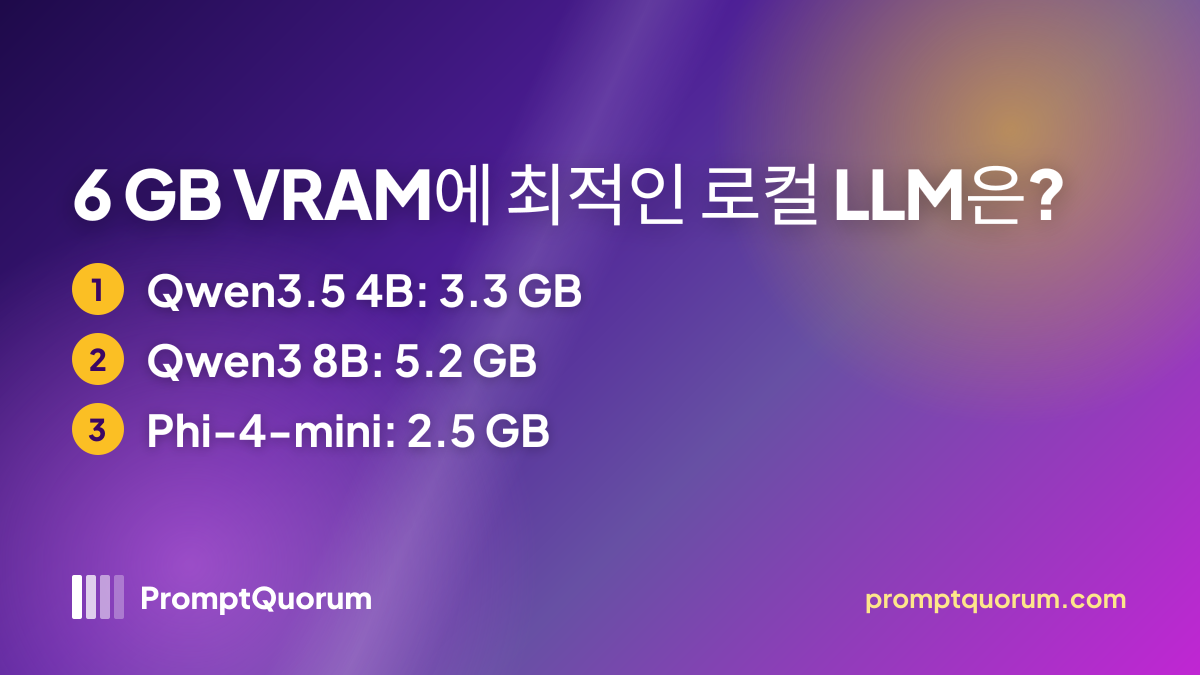
6 GB VRAM에는 Qwen3.5 4B Q4_K_M이 가장 적합합니다. 다운로드 3.3 GB로 컨텍스트용 약 2.7 GB가 남습니다. Qwen3 8B Q4_K_M(5.2 GB)은 더 강력하지만 여유가 빠듯하고, Phi-4-mini(2.5 GB)는 가장 가벼운 선택지입니다.
- ▸Qwen3.5 4B Q4_K_M: 6 GB에 가장 적합(3.3 GB, 텍스트·이미지 입력)
- ▸Qwen3 8B Q4_K_M: 더 강력하지만 빠듯함(5.2 GB, 짧은 컨텍스트만)
- ▸Phi-4-mini Q4_K_M: 가장 가벼움(2.5 GB, 컨텍스트 여유 최대)
핵심 요점
- ✓Qwen3.5 4B Q4_K_M(3.3 GB)은 6 GB VRAM에 가장 적합합니다: GPU에 전부 올라가고 컨텍스트 여유도 남습니다
- ✓Qwen3 8B Q4_K_M(5.2 GB)은 더 강력하지만 컨텍스트용으로 1 GB 미만만 남으므로 프롬프트를 짧게 유지하세요
- ✓6 GB에 들어가지 않는 모델: Qwen3.5 9B(6.6 GB), Ministral 3 8B(6.0 GB), Gemma 4 E4B(6.1 GB 이상)는 컨텍스트 이전에 한도를 넘습니다
6 GB VRAM용 상위 3개 모델
6 GB VRAM에서는 파일 크기가 약 4 GB 이하인 모델을 고르면 컨텍스트 캐시와 데스크톱 화면도 카드에 함께 들어갑니다. 아래 크기는 Ollama 라이브러리의 다운로드 크기입니다. 컨텍스트 윈도우에는 추가 메모리가 필요하고, Windows는 화면 출력용으로 VRAM 일부를 예약합니다.
Qwen3.5 4B는 2026년에 출시되었으며 텍스트·이미지 입력, 도구 호출, 기본으로 켜진 사고 모드(답변 전에 토큰이 추가로 생성됨)를 지원합니다. PromptQuorum은 6 GB 카드에서 이 모델들을 측정하지 않았으므로 생성 속도는 사용하는 GPU에 따라 다르며, 파일이 작을수록 보통 더 빠르게 생성됩니다.
| 모델 | 크기 | Ollama 태그 | 적합한 용도 |
|---|---|---|---|
| Qwen3.5 4B Q4_K_M | 3.3 GB | qwen3.5:4b | 채팅, 코딩, 이미지 |
| Qwen3 8B Q4_K_M | 5.2 GB | qwen3:8b | 최고 품질, 짧은 컨텍스트 |
| Phi-4-mini Q4_K_M | 2.5 GB | phi4-mini | 경량, 긴 컨텍스트 |
6 GB GPU와 들어가는 모델
흔한 6 GB 카드는 GTX 1060 6 GB, GTX 1660 Super, RTX 2060(6 GB 버전), RTX 3050 6 GB, RTX 3060 Laptop, RTX 4050 Laptop입니다. Ollama는 CUDA를 통해 모두에서 동작하며, GTX 1060 같은 오래된 카드도 작동하지만 Tensor 코어가 없어 생성이 더 느립니다.
모델이 들어가지 않으면 Ollama는 일부 레이어를 시스템 RAM과 CPU로 옮깁니다. 모델은 계속 실행되지만 생성 속도가 크게 떨어지므로, 6 GB 카드에서 Qwen3 8B는 공짜 업그레이드가 아니라 절충입니다. ollama ps로 GPU/CPU 분배를 확인하세요.
Apple Silicon은 다른 경우입니다. Mac은 CPU와 GPU가 통합 메모리를 공유하고, macOS는 기본적으로 16 GB 기기에서 GPU가 그 약 3분의 2를 쓰게 하므로 16 GB MacBook은 이 페이지가 너무 크다고 보는 모델도 실행할 수 있습니다. 16 GB RAM 노트북용 최고의 로컬 LLM을 참고하세요.
6 GB에서 8 GB로 올리면 Qwen3 8B Q4_K_M을 컨텍스트 여유를 두고 실행할 수 있습니다. 12 GB 옵션과 14B 모델은 RTX 3060 12 GB용 최고의 Ollama 모델을, VRAM 전체 기준은 로컬 LLM에 필요한 VRAM을 참고하세요.
6 GB VRAM용 최고의 코딩 모델
6 GB VRAM에서 코딩을 시작한다면 Qwen3.5 4B Q4_K_M이 출발점이며, 코드 자동 완성에는 코드 특화 Qwen2.5-Coder 7B Q4_K_M(4.7 GB)도 선택지입니다. Qwen3.5 4B 모델 카드는 LiveCodeBench v6에서 55.8을 보고합니다(개발사 수치, 사고 모드). Qwen2.5-Coder는 2024년 계열로 컨텍스트 윈도우가 32K라서, 7B 파일은 긴 프롬프트를 위한 여유가 거의 없습니다.
LM Studio는 같은 GGUF 파일을 불러오며, Aider나 에디터 플러그인은 로컬 API를 통해 Ollama 모델을 사용할 수 있습니다. 코드 프롬프트는 길고 컨텍스트가 잘리면 잘못된 답이 나오므로 기본값보다 크게 설정하세요(예: Ollama 프롬프트에서 /set parameter num_ctx 8192).
| 모델 | 크기 | 용도 |
|---|---|---|
| Qwen3.5 4B Q4_K_M | 3.3 GB | 코딩 + 채팅, 도구 호출 |
| Qwen2.5-Coder 7B Q4_K_M | 4.7 GB | 코드 완성, 짧은 컨텍스트 |
| Qwen2.5-Coder 3B Q4_K_M | 1.9 GB | 빠른 자동 완성 |
관련 가이드
- ▸2 GB RAM으로 RAG를 실행할 수 있습니까? -- RAG on low RAM
- ▸6 GB VRAM용 최적 양자화 -- Q4_K_M vs Q5_K_M
- ▸16 GB RAM 노트북용 최고의 로컬 LLM -- 노트북 등급
6 GB VRAM 모델에 대한 빠른 답변
6 GB VRAM으로 로컬 LLM을 충분히 쓸 수 있나요?▾
Qwen3 8B가 6 GB VRAM에 들어가나요?▾
/set parameter num_ctx 2048로 제한하거나 Qwen3.5 4B(3.3 GB)를 쓰세요. ollama ps로 모델이 100% GPU에 있는지 확인할 수 있습니다.Ministral 8B, Gemma 4, Qwen3.5 9B는 6 GB에 들어가나요?▾
gemma4:e2b-it-qat, 4.3 GB)는 들어갑니다.6 GB VRAM에 가장 좋은 코딩 모델은 무엇인가요?▾
ollama_chat/ 접두사로 Ollama 모델을 사용할 수 있습니다.어떤 GPU가 6 GB VRAM인가요?▾
VRAM이 아니라 시스템 RAM이 6 GB라면요?▾
qwen3.5:2b, 1.9 GB) 같은 1~2B 모델을 쓰고 컨텍스트를 짧게 유지하세요.