¿Mejor LLM local para 6 GB de VRAM?
Respuesta rápida
Con 6 GB de VRAM, Qwen3 8B Q4_K_M es la mejor opción con ~5,0 GB, con excelentes capacidades de chat y programación a ~20 tok/s. Phi-4-mini Q4_K_M y Ministral 8B Q4_K_M son alternativas sólidas.
- ▸Qwen3 8B Q4_K_M: mejor opción general para 6 GB (5,0 GB VRAM)
- ▸Phi-4-mini Q4_K_M: la opción más ligera, con más margen de contexto (2,5 GB VRAM)
- ▸Ministral 8B Q4_K_M: el más rápido en 6 GB (4,9 GB VRAM)
Puntos clave
- ✓Qwen3 8B Q4_K_M es la mejor opción para 6 GB de VRAM: 5,0 GB, ~20 tok/s, excelente para chat y código
- ✓Phi-4-mini Q4_K_M (2,5 GB) es la opción más ligera, con más margen para ventanas de contexto largas
- ✓6 GB de VRAM cubre RTX 3050/4050 en Windows y cualquier MacBook con 16 GB de memoria unificada
Top 3 modelos para 6 GB de VRAM
A septiembre de 2026, 6 GB de VRAM cubre dos clases de hardware muy diferentes: portátiles Windows de bajo coste (RTX 3050/4050) y cualquier MacBook con 16 GB de memoria unificada. El rendimiento difiere entre ellos en un 30–50% — el Mac ejecuta Qwen3 8B Q4_K_M a ~25 tok/s gracias al ancho de banda de la memoria unificada, mientras la GPU discreta Windows lo hace a ~18 tok/s debido a la sobrecarga de transferencia PCIe.
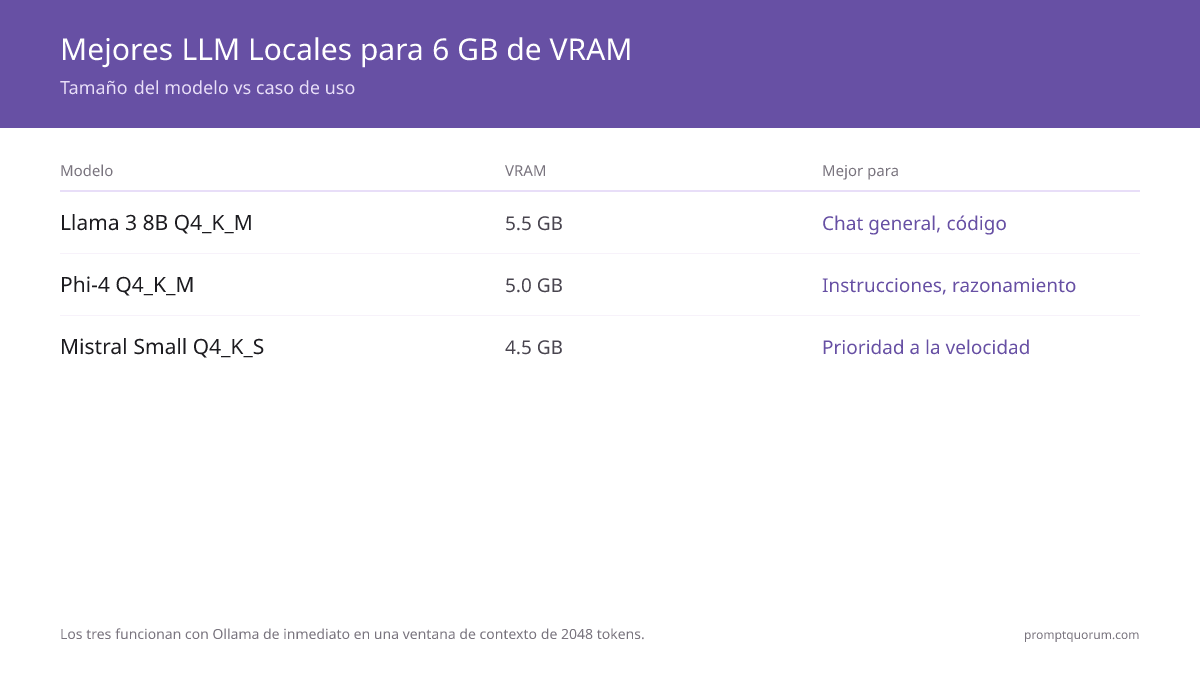
Los tres modelos funcionan con Ollama sin configuración especial. Las cifras de velocidad siguientes asumen una ventana de contexto de 2048 tokens. Ampliar a 4096 tokens añade ~1 GB — aún dentro de 6 GB para los tres modelos.
| Modelo | VRAM | Mejor para |
|---|---|---|
| Qwen3 8B Q4_K_M | 5,0 GB | Chat general, programación |
| Phi-4-mini Q4_K_M | 2,5 GB | Ligero, contexto largo |
| Ministral 8B Q4_K_M | 4,9 GB | Tareas donde la velocidad es prioritaria |
6 GB de VRAM en Windows vs MacBook
En Windows, la RTX 3050 6 GB y la RTX 4050 6 GB son las dos GPUs principales en este rango. Ambas ejecutan Ollama vía CUDA con un rendimiento casi idéntico — la más nueva RTX 4050 es alrededor de un 10% más eficiente por vatio pero no significativamente más rápida en la práctica.
En macOS, cualquier MacBook con 16 GB de memoria unificada tiene aproximadamente 6 GB disponibles para la carga de trabajo GPU. La memoria unificada elimina el cuello de botella PCIe que limita las tarjetas discretas, por lo que el rendimiento de macOS suele ser igual o mejor que el de una RTX 3050 discreta.
Actualizar de 6 GB a 8 GB desbloquea la cuantización Q5_K_M en modelos 7–8B (+3% calidad) y ventanas de contexto más rápidas. Para opciones de 12 GB y modelos 14B, consulta los mejores modelos Ollama para RTX 3060 12 GB. Para la referencia completa de VRAM, consulta cuánta VRAM necesita un LLM local.
6 GB es la VRAM mínima donde un LLM local compite con los modelos en la nube en tareas cotidianas. Por debajo de 6 GB, estás limitado a modelos pequeños que tienen dificultades con código o razonamiento extenso. Con 6 GB, Qwen3 8B Q4_K_M está completamente desbloqueado. Para dar el salto a modelos 14B, consulta las opciones del nivel de 12 GB.
Guías relacionadas
- ▸¿Puedes ejecutar RAG con 2 GB de RAM? -- RAG on low RAM
Respuestas rápidas sobre modelos con 6 GB de VRAM
¿Son suficientes 6 GB de VRAM para uso diario de LLMs?▾
¿Cabe Qwen3 8B en 6 GB de VRAM?▾
--num-ctx 2048) o elige Phi-4-mini Q4_K_M en su lugar (2,5 GB, mucho más margen).