أفضل نموذج لغوي محلي لـ 6 GB من VRAM؟
إجابة سريعة
مع 6 GB من VRAM، يُعدّ Qwen3 8B Q4_K_M الخيار الأمثل بحجم ~5.0 GB، مع قدرات ممتازة في المحادثة والبرمجة بسرعة ~20 tok/s. يُمثّل Phi-4-mini Q4_K_M وMinistral 8B Q4_K_M بديلَين قويَّين.
- ▸Qwen3 8B Q4_K_M: أفضل خيار شامل لـ 6 GB (5.0 GB VRAM)
- ▸Phi-4-mini Q4_K_M: الخيار الأخف وزنًا، مع أكبر هامش للسياق (2.5 GB VRAM)
- ▸Ministral 8B Q4_K_M: الأسرع عند 6 GB (4.9 GB VRAM)
النقاط الرئيسية
- ✓Qwen3 8B Q4_K_M هو الخيار الأمثل لـ 6 GB من VRAM: 5.0 GB، ~20 tok/s، ممتاز للمحادثة والبرمجة
- ✓Phi-4-mini Q4_K_M (2.5 GB) هو الخيار الأخف وزنًا، مع أكبر هامش لنوافذ السياق الطويلة
- ✓6 GB من VRAM يغطي RTX 3050/4050 على Windows وأي MacBook بذاكرة موحدة 16 GB
أفضل 3 نماذج لـ 6 GB من VRAM
اعتبارًا من سبتمبر 2026، تغطي 6 GB من VRAM فئتَي أجهزة مختلفتَين تمامًا: أجهزة الحاسوب المحمولة ذات الميزانية المحدودة بنظام Windows (RTX 3050/4050) وأي MacBook بذاكرة موحدة 16 GB. يختلف الأداء بينهما بنسبة 30–50% — يعمل Mac على تشغيل Qwen3 8B Q4_K_M بسرعة ~25 tok/s بفضل نطاق ترددي للذاكرة الموحدة، بينما تعمل وحدة المعالجة الرسومية المستقلة على Windows بسرعة ~18 tok/s بسبب عبء نقل البيانات عبر PCIe.
تعمل النماذج الثلاثة مع Ollama دون أي إعداد خاص. تفترض أرقام السرعة أدناه نافذة سياق مؤلفة من 2048 رمزًا. يؤدي التوسيع إلى 4096 رمزًا إضافةَ ~1 GB — لا يزال ضمن 6 GB للنماذج الثلاثة جميعًا.
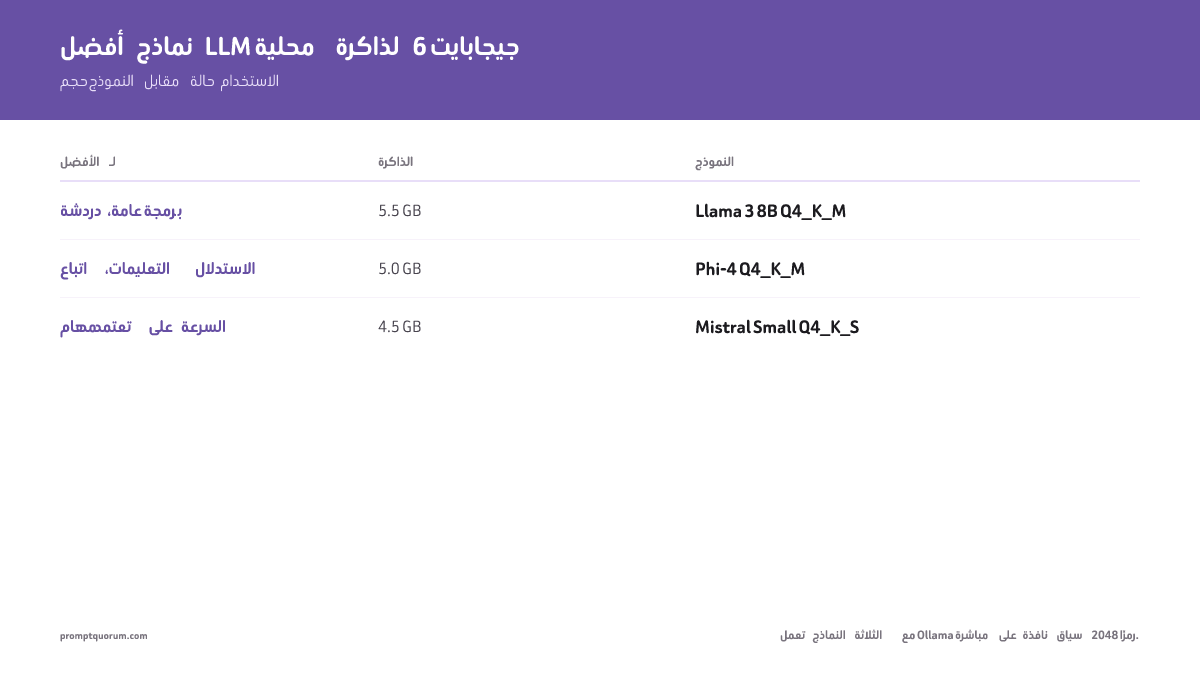
| النموذج | VRAM | الأفضل لـ |
|---|---|---|
| Qwen3 8B Q4_K_M | 5.0 GB | المحادثة العامة، البرمجة |
| Phi-4-mini Q4_K_M | 2.5 GB | خفيف الوزن، سياق طويل |
| Ministral 8B Q4_K_M | 4.9 GB | المهام ذات الأولوية للسرعة |
6 GB من VRAM على Windows مقابل MacBook
على Windows، تُعدّ RTX 3050 6 GB وRTX 4050 6 GB وحدتَي المعالجة الرسومية الرئيسيتَين في هذه الفئة. كلتاهما تشغّل Ollama عبر CUDA بأداء متطابق تقريبًا — الطراز الأحدث RTX 4050 أكثر كفاءةً بنحو 10% لكل واط، لكنه ليس أسرع بشكل ملحوظ في الاستخدام الفعلي.
على macOS، يتوفر لأي MacBook بذاكرة موحدة 16 GB نحو 6 GB لأعباء عمل وحدة المعالجة الرسومية. تُلغي الذاكرة الموحدة اختناق النطاق الترددي PCIe الذي يحدّ من بطاقات المعالجة الرسومية المستقلة، لذا يكون أداء macOS في الغالب مساويًا لأداء RTX 3050 المستقلة أو أفضل منه.
يُتيح الترقية من 6 GB إلى 8 GB تكميم Q5_K_M على نماذج 7–8B (+3% جودة) ونوافذ سياق أسرع. للاطلاع على خيارات 12 GB ونماذج 14B، راجع أفضل نماذج Ollama لـ RTX 3060 12 GB. للمرجع الكامل لـ VRAM، راجع مقدار VRAM الذي يحتاجه النموذج اللغوي المحلي.
6 GB هو الحد الأدنى من VRAM الذي يستطيع عنده النموذج اللغوي المحلي منافسة نماذج السحابة في المهام اليومية. دون 6 GB، تقتصر الخيارات على نماذج صغيرة تعاني مع البرمجة أو الاستدلال المطوّل. مع 6 GB، يكون Qwen3 8B Q4_K_M متاحًا بالكامل. للانتقال إلى نماذج 14B، راجع خيارات فئة 12 GB.
أدلة ذات صلة
- ▸هل يمكن تشغيل RAG بـ2 GB RAM؟ -- RAG on low RAM
إجابات سريعة حول نماذج 6 GB من VRAM
هل تكفي 6 GB من VRAM للاستخدام اليومي للنماذج اللغوية؟▾
هل يتناسب Qwen3 8B مع 6 GB من VRAM؟▾
--num-ctx 2048) أو اختر Phi-4-mini Q4_K_M بدلًا من ذلك (2.5 GB، بهامش أكبر بكثير).