Wie viel VRAM brauchen Sie für ein lokales LLM?
Schnelle Antwort
4 GB VRAM reichen für Llama 3.2 3B und Phi-3.5-mini mit sicherer Pufferzone für Kontexterweiterung. 6 GB betreiben Llama 3.1 8B bei Q4. 12 GB fassen Qwen3 14B Q4 effizient. Für 70B-Modelle bei Q4 werden 16+ GB benötigt.
- ▸4 GB: Llama 3.2 3B Q4, Phi-3.5-mini Q4
- ▸6 GB: Llama 3.1 8B Q4_K_M
- ▸8–12 GB: Llama 3.1 8B Q5_K_M, Qwen3 14B Q4
Wichtigste Punkte
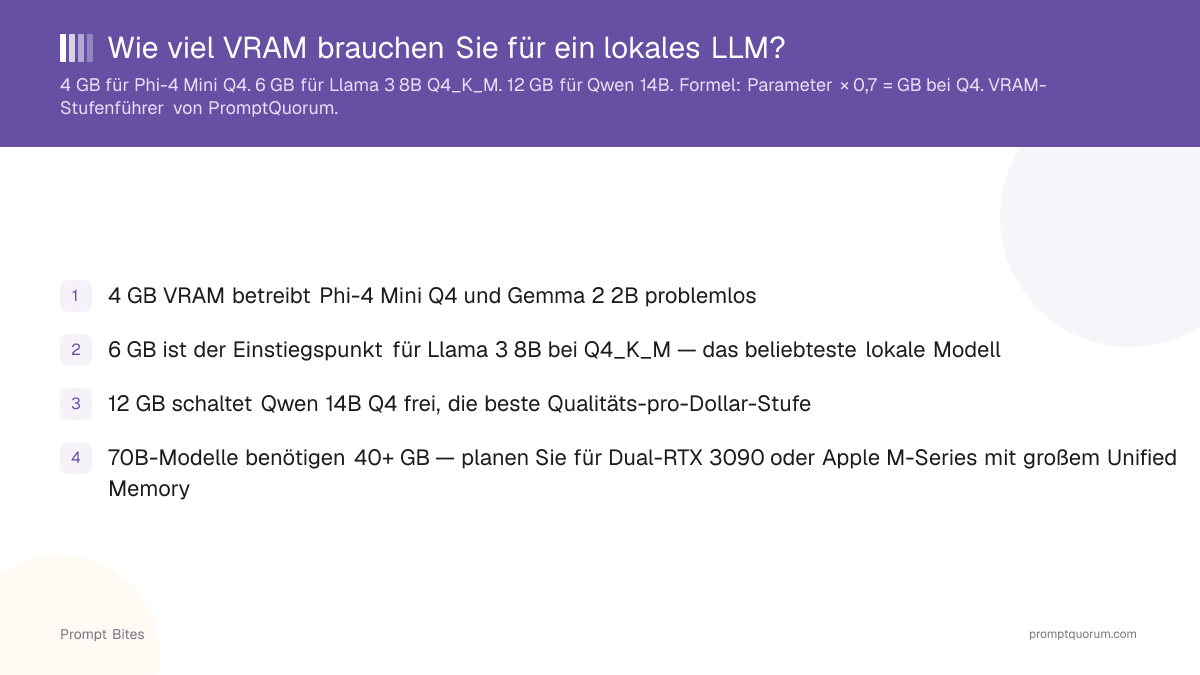
- ✓4 GB VRAM betreibt Llama 3.2 3B und Phi-3.5-mini problemlos
- ✓6 GB ist der Einstiegspunkt für Llama 3.1 8B bei Q4_K_M — die beliebteste lokale Modellgröße
- ✓12 GB schaltet Qwen3 14B Q4 frei, die beste Qualitäts-pro-Dollar-Stufe
- ✓70B-Modelle benötigen 40+ GB — planen Sie für Dual-RTX 3090 oder Apple M-Series mit großem Unified Memory
VRAM-Anforderungen nach Modellgröße
Der VRAM-Bedarf eines Modells folgt einer einfachen, anhand realer GGUF-Dateigrößen verifizierten Formel: Parameteranzahl in Milliarden × 0,6 = ungefähre GB bei Q4-Quantisierung. Ein 8B-Modell benötigt ~4,8 GB für die Gewichte, plus 0,5–1 GB Kontext-Overhead. Deshalb sind 6 GB das Minimum für die 7–8B-Tier und warum 12 GB die 14B-Tier mit Spielraum freischaltet.
Verwenden Sie die nachstehende Tabelle als schnelle Entscheidungsreferenz. Die Spalte "Geschwindigkeit" setzt Ollama auf einer Desktop-GPU mit Standard-Kontext (2048 Tokens) voraus.
Halten Sie stets 1–2 GB VRAM über dem angegebenen Bedarf Ihres Modells frei. Betriebssysteme, Browser-Tabs und die Ollama-Laufzeit verbrauchen 500 MB–1 GB, selbst wenn kein Modell geladen ist. Eine 6-GB-Karte, die Llama 3.1 8B Q4_K_M (~4,8 GB) betreibt, lässt nur etwa 1,2 GB Spielraum — Out-of-Memory-Fehler treten auf, sobald Sie --num-ctx deutlich über 2048 Tokens erhöhen. Für die 6-GB-Tier mit sicherem Spielraum, siehe beste lokale LLMs für 6 GB VRAM.
| VRAM | Bestes Modell bei Q4_K_M | Geschwindigkeit |
|---|---|---|
| 4 GB | Llama 3.2 3B oder Phi-3.5-mini Q4 | ~25 tok/s |
| 6 GB | Llama 3.1 8B Q4_K_M | ~20 tok/s |
| 8 GB | Llama 3.1 8B Q5_K_M | ~18 tok/s |
| 12 GB | Qwen3 14B Q4_K_M | ~15 tok/s |
| 16+ GB | Qwen3 32B Q4 oder Llama 3.3 70B partiell | ~8 tok/s |
Was tun, wenn der VRAM nicht ausreicht
Wenn ein Modell Ihren VRAM überschreitet, haben Sie drei Möglichkeiten: Quantisierung reduzieren (Q4_K_M statt Q5), das Kontextfenster mit --num-ctx 2048 verkleinern oder Ollama Schichten in den System-RAM auslagern lassen.
CPU-Offload funktioniert, ist aber langsam — jede in den RAM verschobene Schicht erhöht die Latenz. Für interaktive Nutzung bleiben Sie innerhalb des VRAM-Limits Ihrer GPU. Die Reduzierung des Kontexts von 4096 auf 2048 Tokens spart etwa 2 GB bei einem 7–8B-Modell.
Für eine vollständige Aufschlüsselung der Modellgrößen und die Berechnung hinter VRAM-Schätzungen, siehe den vollständigen VRAM-Leitfaden für lokale LLMs. Speziell für die 7B-Tier, siehe wie viel RAM ein 7B-Modell benötigt.
Schnelle Antworten zum Thema VRAM
Reichen 8 GB VRAM für lokale LLMs aus?▾
Kann ich ein 7B-Modell auf 4 GB VRAM betreiben?▾
Beeinflusst die Kontextfenstergröße den VRAM-Verbrauch?▾
Was sollte ich tun, wenn mein Modell mehr VRAM als erwartet verbraucht?▾
--num-ctx 2048 in Ihrem Ollama-Befehl. Das reduziert den VRAM-Verbrauch bei 7B-Modellen um bis zu 2 GB, ohne die Modelldatei zu ändern.