运行本地LLM需要多少显存?
快速回答
4 GB显存可安全运行Llama 3.2 3B和Phi-3.5-mini并具有上下文扩展足够余量。6 GB可Q4运行Llama 3.1 8B。12 GB有效容纳Qwen3 14B Q4。70B模型Q4需16+ GB。
- ▸4 GB:Llama 3.2 3B Q4,Phi-3.5-mini Q4
- ▸6 GB:Llama 3.1 8B Q4_K_M
- ▸8–12 GB:Llama 3.1 8B Q5_K_M,Qwen3 14B Q4
Quantization & VRAM
关键要点
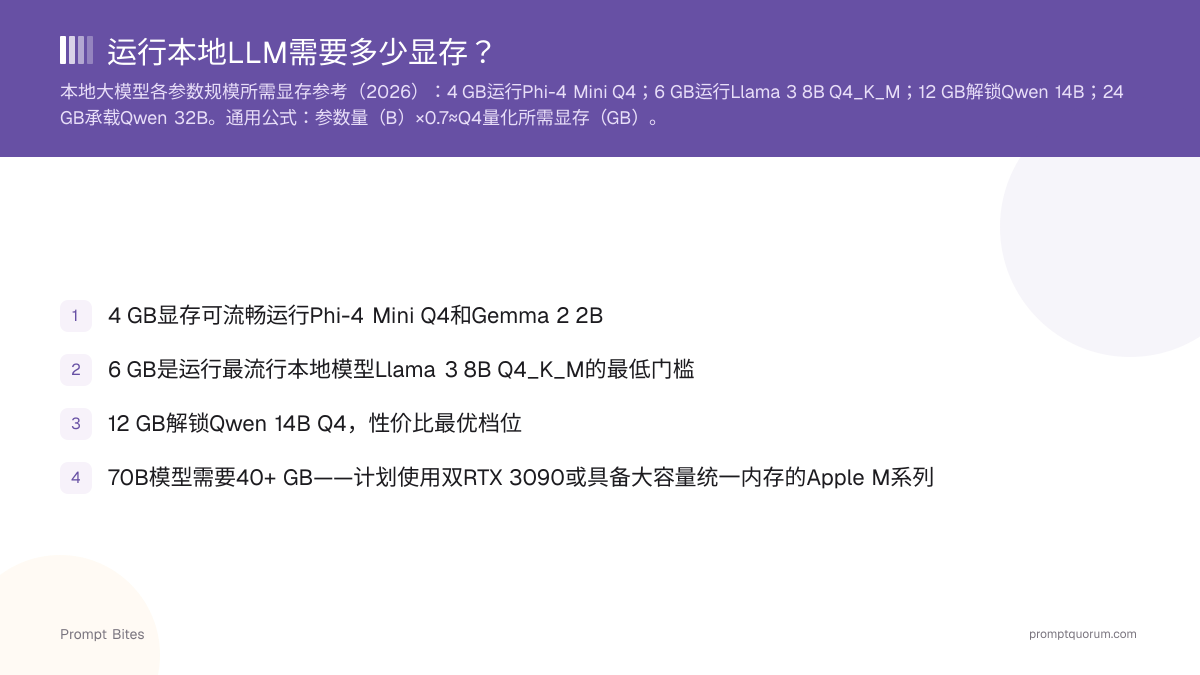
- ✓4 GB显存可流畅运行Llama 3.2 3B和Phi-3.5-mini
- ✓6 GB是运行最流行本地模型规格Llama 3.1 8B Q4_K_M的最低门槛
- ✓12 GB解锁Qwen3 14B Q4,性价比最优档位
- ✓70B模型需要40+ GB——计划使用双RTX 3090或具备大容量统一内存的Apple M系列
按模型大小划分的显存需求
模型的显存需求遵循一个经过真实GGUF文件大小验证的简单公式:参数量(十亿为单位)× 0.6 = Q4量化下的近似GB数。8B模型的权重需要约4.8 GB,另加0.5–1 GB的上下文开销。这就是为什么6 GB是7–8B档位的最低要求,以及12 GB能够为14B档位留有余量的原因。
请将下表作为快速决策参考。「速度」列假设Ollama在台式机GPU上以默认上下文(2048令牌)运行。
始终在模型声明需求基础上保留1–2 GB的空闲显存。操作系统、浏览器标签页和Ollama运行时即使在未加载模型时也会消耗500 MB–1 GB。运行Llama 3.1 8B Q4_K_M(约4.8 GB)的6 GB显卡只剩约1.2 GB余量——一旦将--num-ctx大幅增加到2048令牌以上就会出现内存不足错误。有关安全余量的6 GB档位建议,请参阅6 GB显存最佳本地LLM。
| 显存 | Q4_K_M最佳模型 | 速度 |
|---|---|---|
| 4 GB | Llama 3.2 3B或Phi-3.5-mini Q4 | ~25 tok/s |
| 6 GB | Llama 3.1 8B Q4_K_M | ~20 tok/s |
| 8 GB | Llama 3.1 8B Q5_K_M | ~18 tok/s |
| 12 GB | Qwen3 14B Q4_K_M | ~15 tok/s |
| 16+ GB | Qwen3 32B Q4或Llama 3.3 70B部分运行 | ~8 tok/s |
显存不足时的解决方案
当模型超出显存时,您有三个选择:降低量化等级(用Q4_K_M代替Q5)、使用--num-ctx 2048缩小上下文窗口,或让Ollama将层卸载到系统RAM。
CPU卸载可以运行但速度较慢——每个移至RAM的层都会增加延迟。对于交互式使用,请保持在GPU显存限制内。将上下文从4096缩减到2048令牌,7-8B模型约可节省2 GB显存。
有关模型大小的完整分类以及显存估算的计算方法,请参阅本地LLM完整显存指南。关于7B档位的详情,请参阅7B模型所需RAM量。
关于显存的常见问题
8 GB显存足够运行本地LLM吗?▾
足够。8 GB可以Q5_K_M运行Llama 3.1 8B,速度约每秒18个令牌,还有充足余量。在此档位下,日常聊天和编程任务都能得到良好支持。
4 GB显存能运行7B模型吗?▾
不能。Q4的7B模型需要约4.5–5.5 GB显存(参数量 × 0.6,另加上下文开销),最小可用量化仍超过4 GB。完整分析请参阅7B模型所需RAM量。
上下文窗口大小会影响显存使用量吗?▾
会。7B模型每增加1,000个上下文令牌约使用250 MB显存。默认2048令牌上下文使用约0.5 GB;16,384令牌在模型权重基础上额外使用约4 GB。
如果模型占用的显存超出预期怎么办?▾
在Ollama命令中设置
--num-ctx 2048。这可以在不修改模型文件的情况下,将7B模型的显存使用减少最多2 GB。