ローカルLLMに必要なVRAM量は?
クイック回答
4 GB VRAMでLlama 3.2 3BとPhi-3.5-miniがコンテキスト拡張用安全余裕で動作します。6 GBではQ4でLlama 3.1 8Bが動作します。12 GBでQwen3 14B Q4を効率的に収納できます。70BモデルのQ4には16+ GBが必要です。
- ▸4 GB: Llama 3.2 3B Q4, Phi-3.5-mini Q4
- ▸6 GB: Llama 3.1 8B Q4_K_M
- ▸8–12 GB: Llama 3.1 8B Q5_K_M, Qwen3 14B Q4
重要なポイント
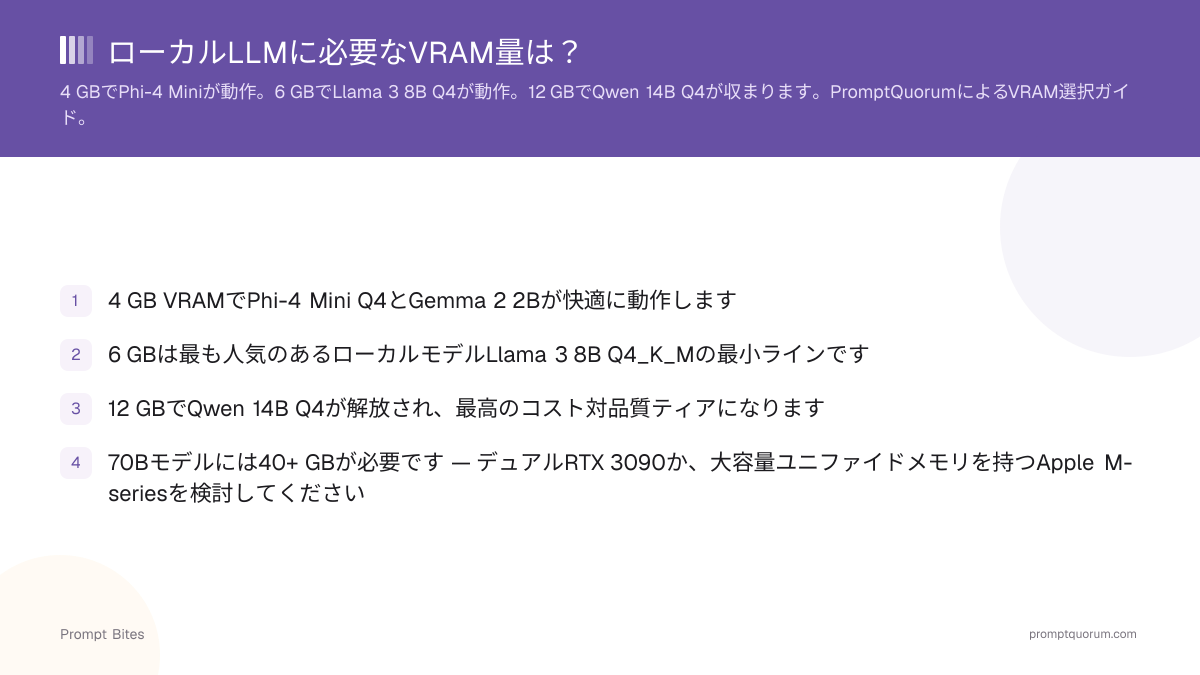
- ✓4 GB VRAMでLlama 3.2 3BとPhi-3.5-miniが快適に動作します
- ✓6 GBは最も人気のあるローカルモデルサイズLlama 3.1 8B Q4_K_Mの最小ラインです
- ✓12 GBでQwen3 14B Q4が解放され、最高のコスト対品質ティアになります
- ✓70Bモデルには40+ GBが必要です — デュアルRTX 3090か、大容量ユニファイドメモリを持つApple M-seriesを検討してください
モデルサイズ別のVRAM要件
モデルのVRAM要件は、実際のGGUFファイルサイズで検証済みの単純な計算式に従います:パラメータ数(十億単位)× 0.6 = Q4量化での概算GB。8Bモデルは重みに~4.8 GB、加えてコンテキストオーバーヘッドに0.5–1 GBが必要です。これが7–8Bティアの最小が6 GBである理由であり、12 GBが余裕を持って14Bティアを解放する理由です。
以下の表を素早い決定リファレンスとして使用してください。「速度」列はデフォルトコンテキスト(2048トークン)で動作するデスクトップGPU上のOllamaを前提としています。
モデルの必要VRAMより常に1–2 GB多くの空き容量を確保してください。OSや、ブラウザタブ、Ollamaのランタイムは、モデルを読み込んでいない状態でも500 MB–1 GBを消費します。Llama 3.1 8B Q4_K_M(~4.8 GB)を動かす6 GBカードには約1.2 GBしか余裕がなく、--num-ctxを2048トークンより大幅に増やすとメモリ不足エラーが発生します。安全な余裕のある6 GBティアについては、6 GB VRAM向け最良ローカルLLMを参照してください。
| VRAM | Q4_K_Mでの最良モデル | 速度 |
|---|---|---|
| 4 GB | Llama 3.2 3BまたはPhi-3.5-mini Q4 | ~25 tok/s |
| 6 GB | Llama 3.1 8B Q4_K_M | ~20 tok/s |
| 8 GB | Llama 3.1 8B Q5_K_M | ~18 tok/s |
| 12 GB | Qwen3 14B Q4_K_M | ~15 tok/s |
| 16+ GB | Qwen3 32B Q4またはLlama 3.3 70B部分実行 | ~8 tok/s |
VRAMが不足している場合の対処法
モデルがVRAMを超える場合、3つの選択肢があります:量化を下げる(Q5の代わりにQ4_K_M)、--num-ctx 2048でコンテキストウィンドウを縮小する、またはOllamaにレイヤーをシステムRAMにオフロードさせる。
CPUオフロードは機能しますが低速です — RAMに移動された各レイヤーがレイテンシを増加させます。インタラクティブな使用では、GPUのVRAM制限内に収めてください。コンテキストを4096から2048トークンに削減すると、7-8Bモデルで約2 GBを節約できます。
モデルサイズの完全な内訳とVRAM推定の計算については、ローカルLLMの完全VRAMガイドを参照してください。7Bティアについては、7Bモデルに必要なRAM量を参照してください。
VRAMに関するよくある質問
8 GB VRAMはローカルLLMに十分ですか?▾
4 GB VRAMで7Bモデルを動かせますか?▾
コンテキストウィンドウのサイズはVRAM使用量に影響しますか?▾
モデルが予想より多くのVRAMを使用している場合はどうすればいいですか?▾
--num-ctx 2048を設定してください。これにより、モデルファイルを変更せずに7Bモデルで最大2 GBのVRAMを削減できます。