كم VRAM تحتاج للنماذج اللغوية المحلية؟
إجابة سريعة
4 GB من VRAM يستوعب Llama 3.2 3B وPhi-3.5-mini بسهولة مع هامش لتوسيع السياق. 6 GB يشغّل Llama 3.1 8B بتكميم Q4. 12 GB يستوعب Qwen3 14B Q4 بكفاءة. النماذج بـ 70B عند Q4 تحتاج 16+ GB.
- ▸4 GB: Llama 3.2 3B Q4، Phi-3.5-mini Q4
- ▸6 GB: Llama 3.1 8B Q4_K_M
- ▸8–12 GB: Llama 3.1 8B Q5_K_M، Qwen3 14B Q4
النقاط الرئيسية
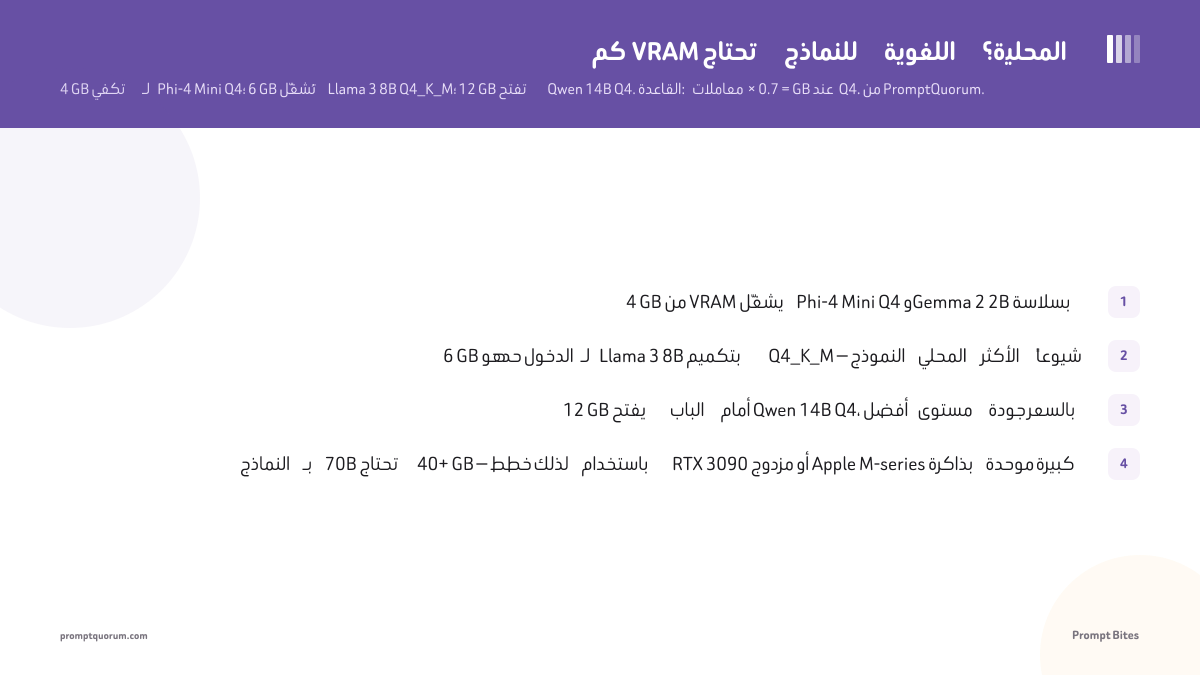
- ✓4 GB من VRAM يشغّل Llama 3.2 3B وPhi-3.5-mini بسلاسة
- ✓6 GB هو حد الدخول لـ Llama 3.1 8B بتكميم Q4_K_M — حجم النموذج المحلي الأكثر شيوعاً
- ✓12 GB يفتح الباب أمام Qwen3 14B Q4، أفضل مستوى جودة بالسعر
- ✓النماذج بـ 70B تحتاج 40+ GB — خطط لذلك باستخدام RTX 3090 مزدوج أو Apple M-series بذاكرة موحدة كبيرة
متطلبات VRAM حسب حجم النموذج
يتبع استهلاك VRAM للنموذج معادلة بسيطة، تم التحقق منها مقابل أحجام ملفات GGUF الفعلية: المعاملات بالمليار × 0.6 = GB تقريبياً عند تكميم Q4. نموذج 8B يحتاج ~4.8 GB للأوزان، بالإضافة إلى 0.5–1 GB كنفقات عامة للسياق. لهذا السبب 6 GB هو الحد الأدنى للنطاق 7–8B، و12 GB يفتح نطاق 14B مع هامش.
استخدم الجدول التالي كمرجع سريع. عمود "السرعة" يفترض Ollama على GPU مكتبية مع سياق افتراضي (2048 توكن).
اترك دائماً 1–2 GB من VRAM فارغة فوق احتياجات النموذج المُعلنة. نظام التشغيل ونوافذ المتصفح وبيئة تشغيل Ollama تستهلك 500 MB–1 GB حتى بدون تحميل نموذج. راجع الدليل الشامل لـ VRAM للنماذج المحلية لمزيد من التفاصيل.
| VRAM | أفضل نموذج بـ Q4_K_M | السرعة |
|---|---|---|
| 4 GB | Llama 3.2 3B أو Phi-3.5-mini Q4 | ~25 توكن/ث |
| 6 GB | Llama 3.1 8B Q4_K_M | ~20 توكن/ث |
| 8 GB | Llama 3.1 8B Q5_K_M | ~18 توكن/ث |
| 12 GB | Qwen3 14B Q4_K_M | ~15 توكن/ث |
| 16+ GB | Qwen3 32B Q4 أو Llama 3.3 70B جزئي | ~8 توكن/ث |
ماذا تفعل عندما تكون VRAM غير كافية
إذا تجاوز النموذج VRAM المتاحة لديك، فلديك ثلاثة خيارات: تقليل التكميم (Q4_K_M بدلاً من Q5)، تقليل نافذة السياق باستخدام --num-ctx 2048، أو السماح لـ Ollama بنقل الطبقات إلى RAM الجهاز.
النقل إلى CPU يعمل لكنه بطيء — كل طبقة تُنقل إلى RAM تضيف كمون. للاستخدام التفاعلي، ابقَ ضمن حد VRAM لـ GPU. تقليل السياق من 4096 إلى 2048 توكن يوفر ~2 GB في نموذج 7-8B.
للتفاصيل الكاملة حول أحجام النماذج وحساب VRAM، راجع الدليل الشامل لـ VRAM للنماذج المحلية. للنطاق 7B تحديداً، راجع كم ذاكرة يحتاج نموذج 7B.
أسئلة شائعة حول VRAM
هل 8 GB من VRAM كافية للنماذج اللغوية المحلية؟▾
هل يمكن تشغيل نموذج 7B بـ 4 GB VRAM؟▾
هل يؤثر حجم نافذة السياق على استهلاك VRAM؟▾
ماذا أفعل إذا استخدم نموذجي VRAM أكثر من المتوقع؟▾
--num-ctx 2048 في أمر Ollama. هذا يقلل استخدام VRAM بما يصل إلى 2 GB في نماذج 7B دون تعديل ملف النموذج.