로컬 LLM용으로 살 만한 AMD GPU는 무엇입니까?
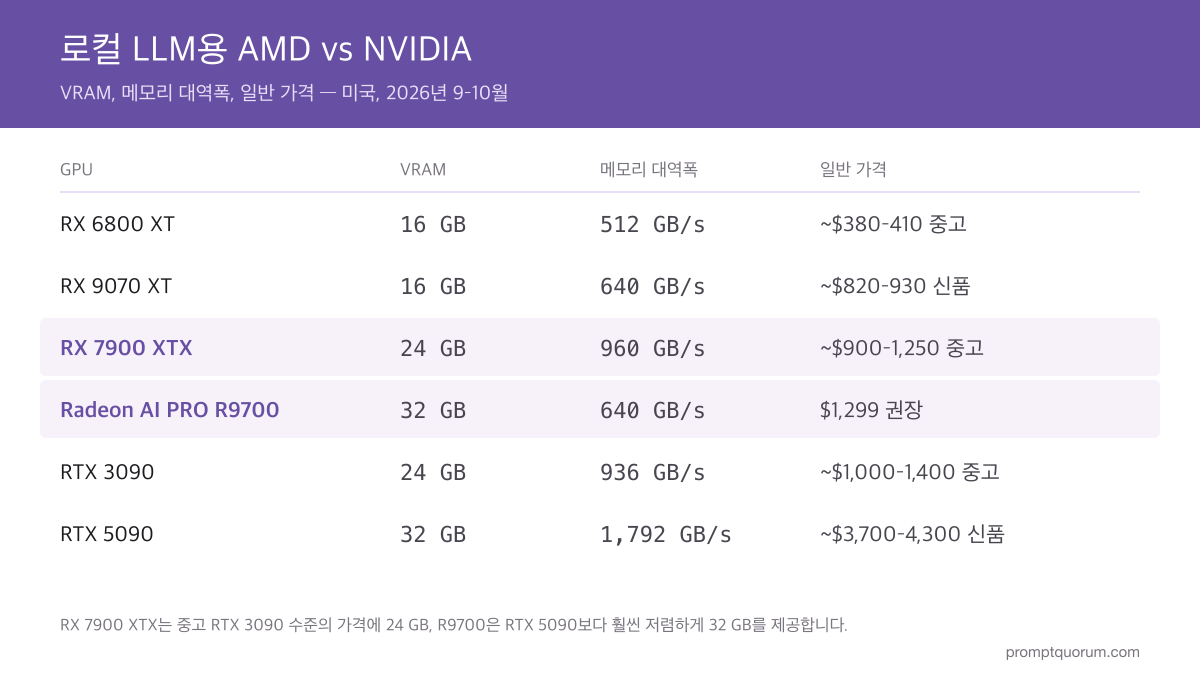
- RX 7900 XTX(24 GB GDDR6, 960 GB/s, RDNA 3): AMD 소비자용 카드 중 VRAM과 대역폭이 가장 큰 카드입니다. 32B 모델의 Q4_K_M은 약 20 GB이므로 컨텍스트 여유를 두고 담을 수 있습니다. AMD의 ROCm 7.2.1 지원표와 Ollama의 Linux·Windows ROCm 목록에 있습니다. 중고 약 $900–1,250.
- RX 9070 XT(16 GB GDDR6, 640 GB/s, RDNA 4): 더 최신인 16 GB 선택지로, AMD의 ROCm 7.2.1 지원표와 Ollama의 Linux ROCm 목록에 있습니다. 14B 모델을 Q4–Q6으로 여유 있게 실행합니다. 신품 약 $820–930.
- Radeon AI PRO R9700(32 GB GDDR6, 640 GB/s, RDNA 4): 이 등급에서 AMD가 판매하는 가장 큰 VRAM을 가진 워크스테이션 카드입니다. 32B 모델의 Q4–Q6을 처리하며, 두 장(64 GB)이면 70B 모델의 Q4를 담습니다. AMD 권장가 $1,299이며 보고된 실거래가는 더 높습니다.
- RX 7900 XT(20 GB GDDR6, 800 GB/s, RDNA 3): Q4 기준 약 24–27B 모델까지 담습니다. 중고 7900 XTX보다 확실히 저렴할 때만 구매하십시오. 이번 업데이트에서는 가격을 다시 확인하지 않았습니다.
- RX 6800 XT(16 GB GDDR6, 512 GB/s, RDNA 2): 중고 약 $380–410의 예산형 선택지입니다. 대역폭이 낮아 생성이 느리고, AMD의 현재 Radeon ROCm 지원표에서는 더 이상 나열하지 않으므로 Ollama의 Linux ROCm 경로 또는 Vulkan을 전제로 하십시오.
- Ryzen AI Max+ 395 미니 PC(최대 128 GB 통합 메모리, 256 GB/s): 그래픽 카드는 아니지만 매우 큰 Mixture-of-Experts 모델을 AMD에서 돌리는 비용이 비교적 낮은 방법입니다. 128 GB 시스템은 2026년 9월 하순에 약 $3,300–4,350으로 등록되어 있었습니다(가격 추적 사이트). 로컬 LLM용 AMD 미니 PC 추천을 참고하십시오.
AMD GPU는 VRAM과 가격에서 NVIDIA와 어떻게 비교됩니까?
GPU | VRAM | 메모리 대역폭 | 일반 가격 | 주요 백엔드 |
|---|---|---|---|---|
| RX 6800 XT | 16 GB | 512 GB/s | 약 $380–410(중고) | ROCm(Linux), Vulkan |
| RX 9070 XT | 16 GB | 640 GB/s | 약 $820–930(신품) | ROCm(Linux), Vulkan |
| RX 7900 XT | 20 GB | 800 GB/s | 재확인하지 않음 | ROCm, Vulkan |
| RX 7900 XTX | 24 GB | 960 GB/s | 약 $900–1,250(중고) | ROCm, Vulkan |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 권장 $1,299, 실거래 약 $1,400–1,900 | ROCm(Linux), Vulkan |
| RTX 3090 | 24 GB | 936 GB/s | 약 $1,000–1,400(중고) | CUDA, Vulkan |
| RTX 4090 | 24 GB | 1,008 GB/s | 약 $2,250(중고) | CUDA, Vulkan |
| RTX 5090 | 32 GB | 1,792 GB/s | 약 $3,700–4,300(신품) | CUDA, Vulkan |
VRAM 용량과 메모리 대역폭은 제조사 사양입니다(AMD RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700). 가격은 공개 가격 추적 사이트와 리뷰에서 가져온 미국 호가 스냅샷(2026년 9–10월)이며 PromptQuorum의 측정값이 아닙니다. 국내 가격은 다를 수 있으므로 구매 전에 실제 거래 가격을 확인하십시오.
LLM 추론에서 AMD GPU는 NVIDIA에 비해 얼마나 빠릅니까?
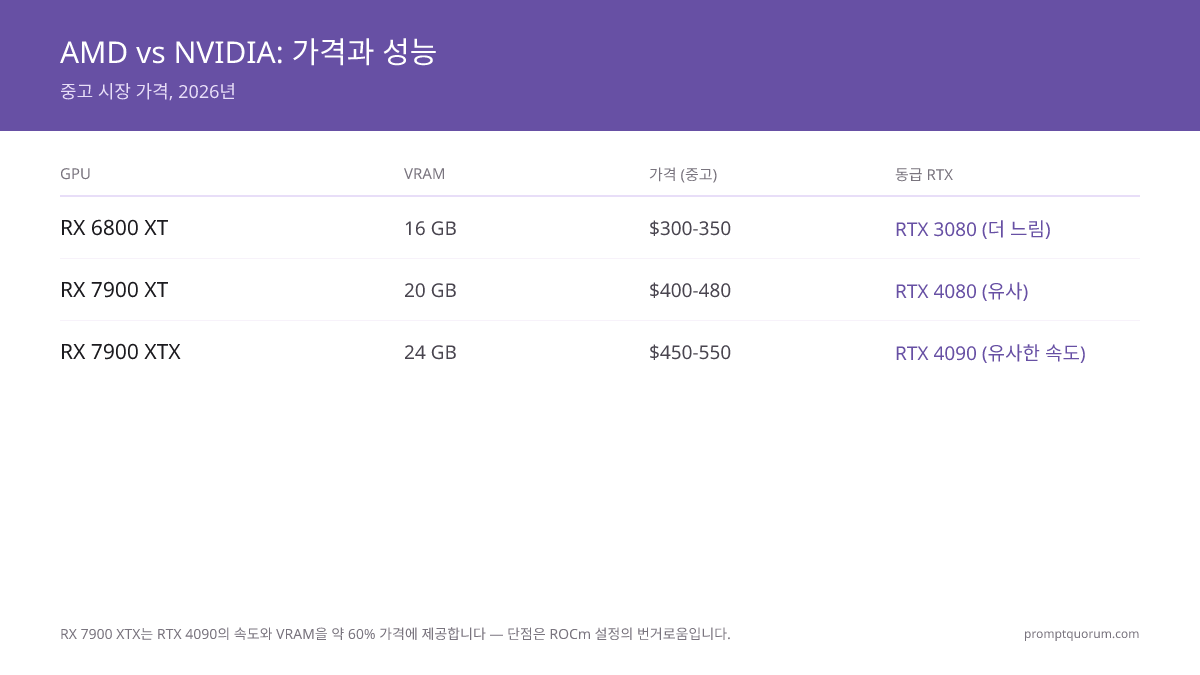
토큰 생성 속도는 TFLOPS보다 메모리 대역폭에 좌우되며, 이 기준에서 AMD의 상위 카드는 NVIDIA의 이전 세대 플래그십에 가깝습니다. RX 7900 XTX(960 GB/s)는 RTX 3090(936 GB/s)과 비슷하고, RTX 4090(1,008 GB/s)과 RTX 5090(1,792 GB/s)보다는 낮습니다.
프롬프트 처리(prefill)에서는 NVIDIA의 우위가 더 뚜렷합니다. 커뮤니티 llama.cpp 비교(llama.cpp 토론 #19890, 제3자 리뷰에서 인용)에서 RTX 5090은 Radeon AI PRO R9700보다 prefill이 약 2.6–3.4배, 같은 모델의 생성이 약 1.5배 빨랐다고 보고되었습니다. 이는 개발자가 보고한 데이터이며 PromptQuorum의 측정값이 아닙니다.
백엔드 선택에 따라 결과가 달라집니다. Vulkan과 ROCm(HIP)은 모델, 카드, 드라이버 버전에 따라 우열이 바뀝니다. llama.cpp는 둘 다 함께 빌드할 수 있으므로, 결정하기 전에 본인의 카드에서 둘 다 테스트하십시오.
실제로는 AMD가 대역폭당 생성 속도에서는 경쟁력이 있고, 긴 프롬프트에서는 느리며, 소프트웨어 완성도는 다소 떨어진다고 보면 됩니다.
2026년에 ROCm 설정은 얼마나 어렵습니까?
Vulkan은 그래픽 드라이버만 있으면 되지만, ROCm은 지원되는 GPU, Linux 배포판, 커널이 필요합니다. 구매 전에 다음을 확인하십시오.
1. 카드를 AMD 지원표와 대조합니다. Radeon용 ROCm 7.2.1 지원표는 Ubuntu 24.04.4, Ubuntu 22.04.5, RHEL 10.1에서 RX 9070 XT, RX 9060 XT, RX 7900 XTX, RX 7900 XT, RX 7900 GRE, RX 7800 XT, Radeon AI PRO R9700을 나열합니다.
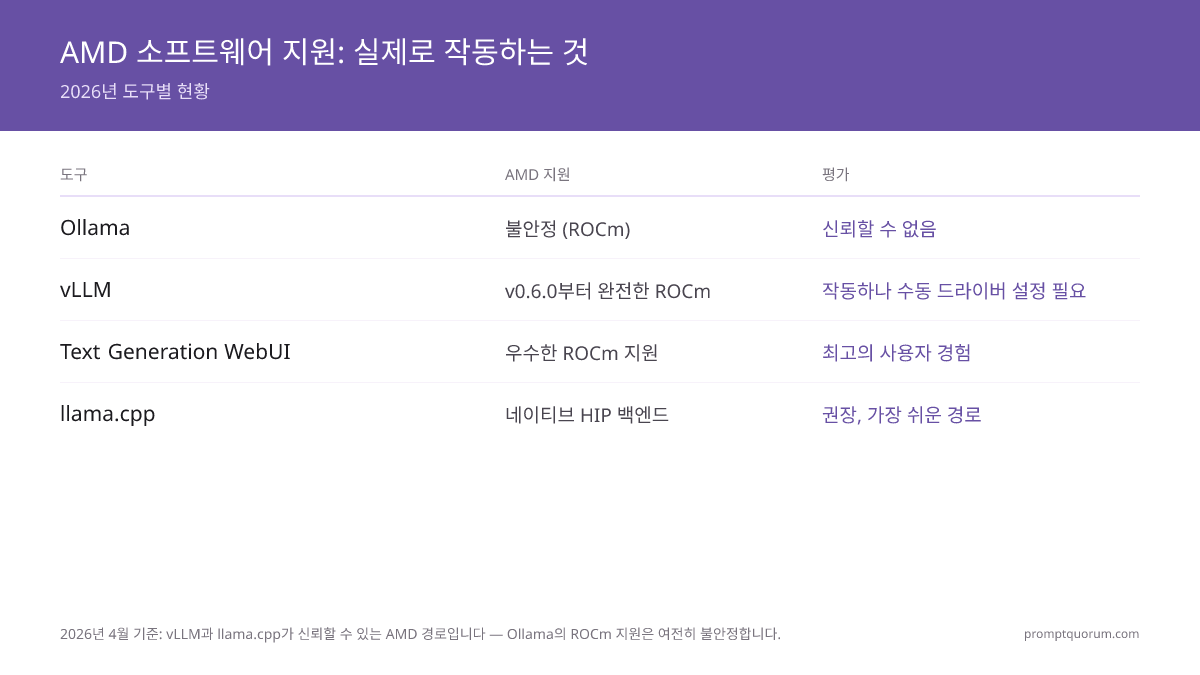
2. Ollama의 목록도 확인합니다. Ollama 문서는 Linux ROCm용으로 RX 6800 XT, 6900 XT 등 RX 6000 시리즈를 추가하고 Ryzen AI Max+ 395도 명시합니다. 목록에 없는 카드는 Linux에서 `HSA_OVERRIDE_GFX_VERSION`을 시도할 수 있으나 Windows에서는 지원되지 않습니다.
3. ROCm v7 스택을 설치합니다. AMD의 `amdgpu-install` 유틸리티를 사용합니다(Linux). Ollama는 Linux에서 ROCm v7을 요구합니다.
4. 인식 여부를 확인합니다. `rocminfo`에서 GPU가 에이전트로 표시되어야 합니다(예: RX 7900 XTX는 gfx1100, RX 9070 XT는 gfx1201).
5. Windows에서는 Ollama의 ROCm 목록이 RX 7000 시리즈를 명시합니다. RX 9070 시리즈를 포함한 다른 카드는 해당 목록에 없으므로 Vulkan 백엔드를 사용하십시오.
ROCm의 최신 릴리스는 7.14.0(2026년 7월 16일)으로, ROCm을 모듈식 빌드 시스템 TheRock으로 옮겼습니다. 확인 시점에 AMD의 Radeon 호환성 페이지는 7.2.1까지를 다루었으므로, 설치할 버전에 해당하는 지원표와 카드를 대조하십시오.
AMD GPU에서 동작하는 로컬 LLM 도구는 무엇입니까?
Ollama: 위에 나열한 카드는 Linux에서 ROCm v7을 사용하고, Windows에서는 RX 7000 시리즈가 ROCm으로 동작합니다. Vulkan은 백엔드를 설치하면 기본으로 활성화되며 `OLLAMA_VULKAN=0`으로 끌 수 있습니다. 현재 릴리스는 v0.40.10(2026년 10월 23일)이며 Linux ROCm 빌드를 포함합니다.
llama.cpp: AMD용으로 HIP(ROCm) 또는 Vulkan(`-DGGML_VULKAN=1`)으로 빌드할 수 있습니다. 두 백엔드를 함께 컴파일하고 `--device`로 장치별로 선택할 수 있습니다. 대부분의 프런트엔드가 이를 기반으로 합니다.
LM Studio: llama.cpp 런타임(Vulkan과 ROCm)을 통해 AMD GPU를 지원합니다. ROCm 런타임이 카드를 인식하지 못할 때는 Vulkan이 일반적인 대안입니다. (이 페이지의 이전 버전은 LM Studio를 NVIDIA 전용이라고 했으나 잘못된 내용이었습니다.)
vLLM: ROCm 빌드를 제공합니다(ROCm 7.14.0 릴리스는 vLLM 0.23.0을 나열합니다). 서빙과 배치 처리를 대상으로 하므로, 의존하기 전에 본인의 GPU 타깃에 대해 vLLM 문서를 확인하십시오.
경험칙: 편의성은 Ollama나 LM Studio, 세밀한 제어는 llama.cpp, 다중 사용자 서빙은 vLLM입니다.
AMD GPU 하드웨어에서 양자화 LLM 추론은 어떻게 실행합니까?
- 1모델 크기를 VRAM에 맞춥니다. Q4_K_M 파일은 파라미터 10억 개당 약 0.6 GB를 사용합니다(14B는 약 9 GB, 32B는 약 20 GB이며 추정치입니다). 컨텍스트 캐시용으로 2–4 GB를 남겨 두십시오.
- 2백엔드를 선택합니다. Vulkan이 가장 빠른 시작입니다(그래픽 드라이버만 필요). 지원되는 Linux 환경에서는 ROCm(HIP)이 더 낫습니다.
- 3런타임을 설치합니다. ROCm 경로라면 Linux에서 먼저 `amdgpu-install`로 ROCm v7을 설치한 뒤, Ollama(`curl -fsSL https://ollama.com/install.sh | sh`) 또는 LM Studio를 설치합니다.
- 4양자화 모델을 실행합니다. 예를 들어 `ollama run qwen3:14b`, 또는 llama.cpp에서 `llama-server -m model.gguf -ngl 99`로 모든 레이어를 GPU에 올립니다.
- 5GPU 사용 여부를 확인합니다. `ollama ps`가 100% GPU를 표시해야 하며 `rocm-smi`로 사용 중인 VRAM을 볼 수 있습니다. CPU로 표시되면 ROCm 설치를 다시 확인하거나 Vulkan으로 전환하십시오.
로컬 LLM용으로 언제 NVIDIA 대신 AMD를 사야 합니까?
다음의 경우 AMD를 사십시오.
- 카드 한 장으로 32 GB를 더 저렴하게 원하는 경우: Radeon AI PRO R9700은 RTX 5090의 3분의 1~절반 가격입니다.
- 이미 지원되는 Radeon을 가지고 있거나 게임 성능도 좋은 카드를 원하는 경우.
- Linux를 쓰거나 Vulkan으로 충분하며, 사용하는 도구(Ollama, llama.cpp, LM Studio)가 이미 AMD를 지원하는 경우.
다음의 경우 NVIDIA를 사십시오.
- CUDA 전용 도구, 학습·파인튜닝 스택, 가장 빠른 프롬프트 처리가 필요한 경우.
- 중고 24 GB 카드를 비교하는 경우: 중고 RTX 3090은 중고 RX 7900 XTX와 가격이 비슷하므로 CUDA 지원이 결정 요인이 될 수 있습니다.
- 설정에 쓰는 시간을 최소화하고 싶은 경우.
NVIDIA 최신 카드보다 저렴하게 24–32 GB VRAM을 원한다면 AMD를 사고, CUDA 전용 도구에 의존하거나 설정에 시간을 쓰고 싶지 않다면 건너뛰십시오.
부족한 것이 VRAM이고 소프트웨어 경로(Linux ROCm 또는 Vulkan)가 맞는다면 AMD는 좋은 선택입니다. 로컬 LLM이 처음이고 그냥 동작하길 원한다면 NVIDIA로 시작하십시오.
AMD Instinct와 NVIDIA 데이터센터 GPU 중 LLM에는 무엇이 낫습니까?
AMD Instinct(MI300X, MI350X)는 NVIDIA의 데이터센터 GPU와 경쟁하는 제품으로, 데스크톱이 아니라 서버용으로 구매합니다. Ollama의 ROCm 목록에는 Instinct 카드가 포함되어 있고 ROCm 자체가 이들을 중심으로 만들어졌으므로, 소비자용 Radeon보다 지원 범위가 넓습니다.
MI300X는 가속기당 192 GB의 HBM3 메모리를 탑재하며(AMD 사양), 매우 큰 모델을 한 대에서 돌리는 데 적합합니다. 1인용 머신이라면 해당되는 AMD 선택지는 Radeon RX 또는 Radeon AI PRO입니다.
서버와 클라우드 결정에 대해서는 기업용 GPU 서버 구매 가이드와 클라우드 GPU 임대 비교를 참고하십시오.
AMD를 도입할 때 가장 흔한 실수는 무엇입니까?
- 24 GB로 70B 모델을 돌릴 수 있다고 가정하는 것: 70B 모델은 Q4에서 약 40 GB 이상이 필요하므로 24 GB 카드 한 장은 약 30–35B가 한계입니다. 70B에는 카드 두 장 또는 32 GB R9700 두 장을 계획하십시오.
- ROCm이 지원하지 않는 카드를 사는 것: 먼저 AMD 지원표와 Ollama 목록을 확인하십시오. RX 6000 시리즈는 AMD의 현재 Radeon 지원표에 없습니다.
- Vulkan을 건너뛰는 것: ROCm이 카드를 인식하지 못하면 GPU를 쓸 수 없다고 결론짓기 전에 Vulkan 백엔드를 시도하십시오.
- 호가를 그대로 믿는 것: GPU와 메모리 가격은 2026년 동안 눈에 띄게 움직였습니다. 표시 가격이 아니라 실제 거래 가격을 비교하십시오.
다음 단계
- 로컬 LLM용 가성비 GPU — 예산이 빠듯하십니까? LLM 추론에 가성비 좋은 GPU →
- GPU vs CPU vs Apple Silicon — AMD, Apple, CPU 중 어떤 플랫폼이 내 워크플로에 맞을까요? →
- VRAM은 얼마나 필요합니까? — GPU VRAM을 모델 크기에 맞추기 →
지역별 데이터 법규는 AMD와 NVIDIA 선택에 어떤 영향을 줍니까?
데이터 보호 의무를 바꾸는 것은 GPU 제조사가 아니라 추론을 로컬에서 실행하는지 여부입니다. 기기에서 직접 추론하면 프롬프트와 문서가 사용자의 하드웨어에 머물러, 한국의 개인정보 보호법(PIPA)과 개인정보보호위원회(PIPC)의 감독, EU GDPR, 일본 APPI, 중국 PIPL 및 데이터안전법에 따른 국외 이전 위험을 줄일 수 있습니다. 다만 적법한 근거, 보관 규칙, 침해 대응 절차는 여전히 필요하므로 규제 대상 데이터는 정식 검토를 받으십시오.
수출 통제 규정은 일부 시장에서 AMD와 NVIDIA의 고성능 가속기를 모두 제한할 수 있습니다. 수입이나 구매 전에 해당 국가의 최신 규정을 확인하십시오.
자주 묻는 질문
AMD GPU는 로컬 LLM 실행에 적합합니까?
네, 다만 조건이 있습니다. RX 7900 XTX(24 GB)와 Radeon AI PRO R9700(32 GB) 같은 AMD 카드는 Ollama, LM Studio, llama.cpp에서 ROCm 또는 Vulkan으로 양자화 LLM을 실행합니다. NVIDIA CUDA는 여전히 소프트웨어 지원이 더 넓고 프롬프트 처리가 빠르므로, 달러당 VRAM이 중요할 때 AMD가 적합합니다.
AI와 로컬 LLM용으로 가장 좋은 AMD 카드는 무엇입니까?
RX 7900 XTX가 종합적으로 가장 좋습니다. 24 GB VRAM, 960 GB/s 대역폭을 갖추고 AMD의 ROCm 7.2.1 지원표와 Ollama에서 지원됩니다. 카드당 VRAM을 더 늘리려면 Radeon AI PRO R9700(32 GB), 7B–14B 모델이라면 RX 9070 XT(16 GB)로 충분합니다.
로컬 LLM에는 AMD와 NVIDIA 중 무엇을 사야 합니까?
CUDA 호환성과 최소한의 설정을 원하면 NVIDIA를 사십시오. 달러당 VRAM을 더 원하면 AMD, 특히 RTX 5090 대비 32 GB R9700을 고르십시오. 중고 RX 7900 XTX는 중고 RTX 3090과 가격이 비슷하므로 그 경우에는 소프트웨어 지원이 결정 요인입니다.
Ollama는 AMD GPU에서 동작합니까?
네. Ollama는 Linux에서 ROCm v7 드라이버가 필요하며 RX 9070 XT, RX 7900 XTX, RX 6800 XT, Radeon AI PRO R9700 등을 나열합니다. Windows에서는 ROCm 목록이 RX 7000 시리즈를 포함하고, Vulkan 백엔드를 설치하면 Vulkan이 기본으로 활성화됩니다.
LM Studio는 AMD GPU를 지원합니까?
네. LM Studio는 llama.cpp 런타임인 Vulkan 또는 ROCm으로 AMD GPU를 실행합니다. ROCm 런타임이 카드를 인식하지 못하면 런타임을 Vulkan으로 바꾸십시오. 이 페이지의 이전 버전은 LM Studio를 NVIDIA 전용이라고 잘못 안내했습니다.
AMD GPU 하드웨어에서 양자화 LLM 추론은 어떻게 실행합니까?
VRAM에 들어가는 양자화 모델(Q4_K_M은 파라미터 10억 개당 약 0.6 GB)을 고르고, Ollama 또는 LM Studio를 설치한 뒤 Vulkan이나 ROCm을 사용합니다. Linux에서는 amdgpu-install로 ROCm v7을 설치하고 모델을 실행한 다음 ollama ps 또는 rocm-smi로 GPU 사용을 확인하십시오.
로컬 LLM에는 RX 9070 XT와 RX 7900 XTX 중 무엇이 낫습니까?
로컬 LLM에는 RX 7900 XTX가 더 낫습니다. 24 GB는 Q4에서 약 30–35B 모델까지 담지만 RX 9070 XT의 16 GB는 약 14B–24B가 한계입니다. RX 9070 XT는 더 최신이고 저렴하므로 16 GB로 충분하다면 선택하십시오.
$500 이하에서 가장 좋은 AMD GPU는 무엇입니까?
중고 약 $380–410의 RX 6800 XT(16 GB)가 $500 이하에서 가장 가성비 좋은 AMD 카드입니다. 7B–14B 모델을 Q4–Q8로 실행하지만 AMD의 현재 Radeon ROCm 지원표에는 없으므로 Ollama의 Linux ROCm 경로 또는 Vulkan을 전제로 하십시오.
Radeon AI PRO R9700은 로컬 AI에 살 만합니까?
카드 한 장에 32 GB가 필요하다면 그렇습니다. 권장가는 $1,299로 RTX 5090의 약 $3,700–4,300보다 낮지만, 보고된 실거래가는 더 높고 프롬프트 처리는 더 느립니다. R9700 두 장이면 70B 모델의 Q4를 위한 64 GB가 됩니다.
AMD ROCm에는 Linux가 필요합니까, Windows에서도 동작합니까?
Linux가 ROCm 지원이 더 잘 갖춰진 경로입니다. AMD 지원표는 Ubuntu 24.04.4, Ubuntu 22.04.5, RHEL 10.1을 나열합니다. Windows에서는 Ollama의 ROCm 목록이 RX 7000 시리즈를 포함하며, 다른 카드는 Vulkan 백엔드를 사용합니다.
LLM에는 AMD Instinct와 NVIDIA GPU 중 무엇이 낫습니까?
Instinct(MI300X, MI350X)는 NVIDIA의 데이터센터 GPU와 경쟁하며 서버용으로 구매하고, MI300X는 192 GB HBM3를 갖추고 있습니다. 데스크톱 한 대에는 Radeon 또는 Radeon AI PRO가 해당되는 AMD 선택지이며, NVIDIA의 CUDA 생태계는 여전히 더 넓습니다.
딥러닝과 머신러닝에 가장 좋은 AMD GPU는 무엇입니까?
추론에는 RX 7900 XTX(24 GB)와 Radeon AI PRO R9700(32 GB)이 최선의 AMD 선택지입니다. ROCm은 PyTorch 빌드를 제공합니다(ROCm 7.14.0 릴리스는 PyTorch 2.12.0을 나열합니다). CUDA를 전제로 하는 학습과 연구 코드에서는 NVIDIA 생태계가 여전히 더 넓으므로, 구매 전에 사용하는 프레임워크의 AMD 지원을 확인하십시오.
Ryzen AI Max+ 395 미니 PC가 단독 AMD GPU보다 낫습니까?
모델 크기에 따라 다릅니다. Ryzen AI Max+ 395 시스템은 최대 128 GB 통합 메모리를 제공하지만 대역폭은 256 GB/s에 그치므로 큰 Mixture-of-Experts 모델에 적합하고, VRAM에 들어가는 모델에서는 단독 카드가 토큰을 더 빠르게 생성합니다.
출처
- Ollama GPU 문서: AMD ROCm v7 요구 사항, 지원되는 Radeon, Radeon AI PRO, Radeon PRO, Ryzen AI, Instinct 카드, Vulkan 백엔드
- Ollama 릴리스: v0.40.10, 2026년 10월 23일
- Radeon 및 Ryzen용 AMD ROCm — Linux 호환성: ROCm 7.2.1이 지원하는 Radeon GPU와 배포판
- ROCm 릴리스: ROCm 7.14.0, 2026년 7월 16일, 프레임워크 버전
- llama.cpp 빌드 문서: HIP 및 Vulkan 백엔드
- AMD 제품 사양: RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700
- 가격 스냅샷(미국, 2026년 9–10월): 공개 GPU 가격 추적 사이트와 제3자 리뷰이며, 호가이므로 빠르게 변합니다
- AMD GPU는 높은 초당 토큰 속도를 내지만 속도만으로 응답 품질이 결정되지는 않습니다. 모델에 무엇을 묻는지가 응답 속도만큼 중요합니다. 컨텍스트 윈도우 설명에서 GPU 메모리 한도 안에서 긴 요청을 구성하는 방법을 다룹니다.