ローカルLLM向けに買う価値のあるAMD GPUはどれ?
- RX 7900 XTX(24 GB GDDR6、960 GB/s、RDNA 3):AMD一般向けカードの中でVRAM容量とメモリ帯域が最大のカードです。32BモデルのQ4_K_Mは約20 GBなので、コンテキスト用の余裕もあります。AMDのROCm 7.2.1対応表と、OllamaのLinux・Windows向けROCmリストに載っています。中古で約$900〜1,250。
- RX 9070 XT(16 GB GDDR6、640 GB/s、RDNA 4):新しい16 GBの選択肢で、AMDのROCm 7.2.1対応表とOllamaのLinux向けROCmリストに載っています。14BモデルのQ4〜Q6を余裕で動かせます。新品で約$820〜930。
- Radeon AI PRO R9700(32 GB GDDR6、640 GB/s、RDNA 4):このクラスでAMDが売る中で最大のVRAMを持つワークステーション向けカードです。32BモデルのQ4〜Q6を扱え、2枚(64 GB)なら70BのQ4が収まります。AMD希望価格は$1,299で、報告されている実売価格はそれより高めです。
- RX 7900 XT(20 GB GDDR6、800 GB/s、RDNA 3):約24〜27BまでのモデルをQ4で扱えます。中古の7900 XTXよりはっきり安い場合のみ検討してください。今回の更新では価格を再確認していません。
- RX 6800 XT(16 GB GDDR6、512 GB/s、RDNA 2):中古で約$380〜410の予算向けカードです。帯域が低いため生成は遅めで、AMDの現行Radeon向けROCm対応表にも載っていないため、OllamaのLinux向けROCm経路かVulkanを前提にしてください。
- Ryzen AI Max+ 395搭載ミニPC(最大128 GBのユニファイドメモリ、256 GB/s):グラフィックスカードではありませんが、非常に大きなMixture-of-ExpertsモデルをAMDで動かす比較的低コストな方法です。128 GBモデルは2026年9月下旬に約$3,300〜4,350で掲載されていました(価格トラッカー)。ローカルLLM向けAMDミニPCのおすすめを参照してください。
AMD GPUはVRAMと価格でNVIDIAとどう違う?
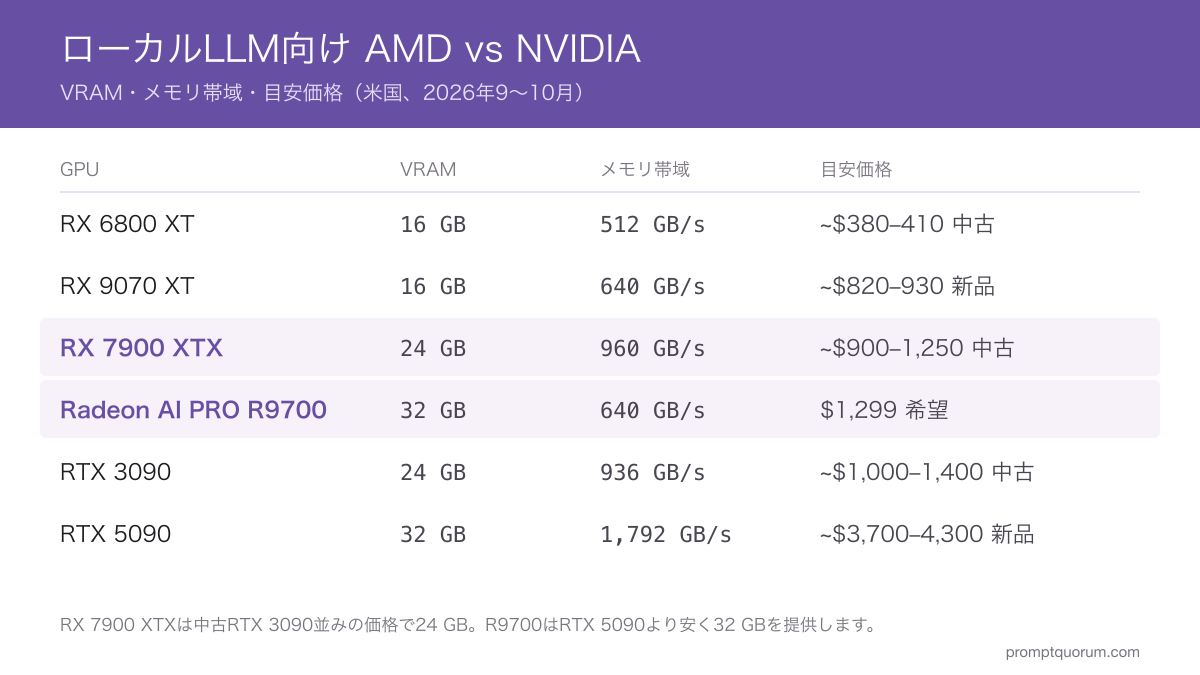
GPU | VRAM | メモリ帯域 | 目安価格 | 主なバックエンド |
|---|---|---|---|---|
| RX 6800 XT | 16 GB | 512 GB/s | 約$380〜410(中古) | ROCm(Linux)、Vulkan |
| RX 9070 XT | 16 GB | 640 GB/s | 約$820〜930(新品) | ROCm(Linux)、Vulkan |
| RX 7900 XT | 20 GB | 800 GB/s | 再確認していません | ROCm、Vulkan |
| RX 7900 XTX | 24 GB | 960 GB/s | 約$900〜1,250(中古) | ROCm、Vulkan |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 希望$1,299/実売約$1,400〜1,900 | ROCm(Linux)、Vulkan |
| RTX 3090 | 24 GB | 936 GB/s | 約$1,000〜1,400(中古) | CUDA、Vulkan |
| RTX 4090 | 24 GB | 1,008 GB/s | 約$2,250(中古) | CUDA、Vulkan |
| RTX 5090 | 32 GB | 1,792 GB/s | 約$3,700〜4,300(新品) | CUDA、Vulkan |
VRAM容量とメモリ帯域はメーカー仕様です(AMD RX 7900 XTX、RX 9070 XT、Radeon AI PRO R9700)。価格は公開の価格トラッカーとレビューから集めた米国の提示価格のスナップショット(2026年9〜10月)で、PromptQuorumの計測ではありません。日本では価格が異なります。購入前に実際の取引価格を確認してください。

LLM推論でAMD GPUはNVIDIAと比べてどれくらい速い?
トークン生成の速度はTFLOPSよりメモリ帯域に左右され、AMDの上位カードはその点でNVIDIAの旧世代フラッグシップに近い水準です。 RX 7900 XTX(960 GB/s)はRTX 3090(936 GB/s)に近く、RTX 4090(1,008 GB/s)とRTX 5090(1,792 GB/s)には届きません。
プロンプト処理(プリフィル)では、NVIDIAの優位がよりはっきり出ます。コミュニティのllama.cpp比較(llama.cppのディスカッション#19890、第三者のレビューが引用)では、RTX 5090はRadeon AI PRO R9700よりプリフィルで約2.6〜3.4倍、同じモデルの生成で約1.5倍速いと報告されています。これは開発者による報告であり、PromptQuorumの計測ではありません。
バックエンドの選択でも結果は変わります。VulkanとROCm(HIP)は、モデル、カード、ドライバのバージョンによって優劣が入れ替わります。llama.cppは両方を同時にビルドできるので、決める前に自分のカードで両方を試してください。
実際には、AMDは帯域あたりの生成速度では互角に近く、長いプロンプトでは遅れ、ソフトウェアの完成度ではやや劣ると考えておくとよいでしょう。
2026年のROCmセットアップはどれだけ大変か?
Vulkanはグラフィックスドライバだけで動きますが、ROCmには対応するGPU、Linuxディストリビューション、カーネルが必要です。 購入前に次を確認してください。
1. カードをAMDの対応表と照合する。 RadeonのROCm 7.2.1対応表には、RX 9070 XT、RX 9060 XT、RX 7900 XTX、RX 7900 XT、RX 7900 GRE、RX 7800 XT、Radeon AI PRO R9700がUbuntu 24.04.4、Ubuntu 22.04.5、RHEL 10.1向けに載っています。
2. Ollamaのリストも確認する。 OllamaのドキュメントはLinuxのROCm向けにRX 6800 XT、6900 XTなどのRX 6000シリーズを追加し、Ryzen AI Max+ 395も挙げています。リストにないカードはLinuxで`HSA_OVERRIDE_GFX_VERSION`を試せますが、Windowsでは未対応です。
3. ROCm v7スタックをインストールする。 AMDの`amdgpu-install`ユーティリティを使います(Linux)。OllamaはLinuxでROCm v7を必要とします。
4. 認識を確認する。 `rocminfo`でGPUがエージェントとして表示されるかを見ます(例:RX 7900 XTXはgfx1100、RX 9070 XTはgfx1201)。
5. Windowsの場合。 OllamaのROCmリストはRX 7000シリーズを対象としています。RX 9070シリーズなどそれ以外のカードはそのリストにないため、Vulkanバックエンドを使います。
ROCmの最新リリースは7.14.0(2026年7月16日)で、モジュール式のビルドシステムTheRockに移行しました。確認時点でAMDのRadeon互換性ページは7.2.1までを扱っていたため、インストールするバージョンの対応表と照合してください。
AMD GPUで動くローカルLLMツールは?
Ollama: 上記のカードはLinuxでROCm v7、WindowsではRX 7000シリーズがROCmで動作します。Vulkanはバックエンド導入時にデフォルトで有効になり、`OLLAMA_VULKAN=0`で無効化できます。現行リリースはv0.40.10(2026年10月23日)で、LinuxのROCmビルドを含みます。
llama.cpp: AMD向けにHIP(ROCm)またはVulkan(`-DGGML_VULKAN=1`)でビルドできます。両方を同時にビルドし、`--device`でデバイスごとに選べます。多くのフロントエンドがこれを土台にしています。
LM Studio: llama.cppランタイム(VulkanとROCm)を通じてAMD GPUに対応します。ROCmランタイムがカードを認識しないときは、Vulkanが通常の代替手段です。(このページの以前の版はLM StudioをNVIDIA専用としていましたが、誤りでした。)
vLLM: ROCmビルドを提供しています(ROCm 7.14.0のリリースはvLLM 0.23.0を挙げています)。用途はサービングとバッチ処理で、頼る前にお使いのGPUターゲットをvLLMのドキュメントで確認してください。
目安: 手軽さならOllamaかLM Studio、細かな制御ならllama.cpp、複数ユーザー向けのサービングならvLLMです。

AMD GPUで量子化LLM推論を動かすには?
- 1モデルサイズをVRAMに合わせます。 Q4_K_Mのファイルはパラメータ10億あたり約0.6 GBです(14Bで約9 GB、32Bで約20 GB。いずれも目安)。コンテキストキャッシュ用に2〜4 GBを空けておきます。
- 2バックエンドを選びます。 Vulkanが最も手早く始められます(グラフィックスドライバのみ)。対応するLinux環境ではROCm(HIP)が適しています。
- 3ランタイムを入れます。 ROCmを使う場合、Linuxではまず`amdgpu-install`でROCm v7を入れ、その後Ollama(`curl -fsSL https://ollama.com/install.sh | sh`)またはLM Studioを入れます。
- 4量子化モデルを実行します。 例:`ollama run qwen3:14b`。llama.cppなら`llama-server -m model.gguf -ngl 99`で全レイヤーをGPUにオフロードします。
- 5GPUが使われていることを確認します。 `ollama ps`が100% GPUを示し、`rocm-smi`で使用中のVRAMが見えるはずです。CPUと表示される場合は、ROCmのインストールを見直すかVulkanに切り替えます。
ローカルLLMでNVIDIAよりAMDを選ぶべきなのはどんなとき?
AMDを選ぶのは次の場合です。
- 32 GBを1枚で安く手に入れたい。Radeon AI PRO R9700の価格はRTX 5090の3分の1〜半額程度です。
- すでに対応するRadeonを持っている、またはゲームにも強いカードが欲しい。
- Linuxを使う、またはVulkanで問題なく、使うツール(Ollama、llama.cpp、LM Studio)がすでにAMDに対応している。
NVIDIAを選ぶのは次の場合です。
- CUDA専用ツール、学習やファインチューニングの環境、最速のプロンプト処理が必要。
- 中古の24 GBカードを比べている。中古のRTX 3090は中古のRX 7900 XTXとほぼ同じ価格なので、CUDAの対応が決め手になることがあります。
- セットアップにかける時間を最小限にしたい。
📍 一文で説明
NVIDIAの最新カードより安く24〜32 GBのVRAMが欲しいならAMD、CUDA専用ツールに依存する場合やセットアップの手間をかけたくない場合は見送りましょう。
💬 簡潔に説明
足りないのがVRAMで、ソフトウェア経路(LinuxのROCmまたはVulkan)が自分に合うなら、AMDはお買い得です。ローカルLLMが初めてで、そのまま動いてほしいならNVIDIAから始めてください。
AMD InstinctとNVIDIAデータセンターGPU、LLMにはどちらが良い?
AMD Instinct(MI300X、MI350X)はNVIDIAのデータセンターGPUと競合する製品で、デスクトップ用ではなくサーバー用に購入します。 OllamaのROCmリストにはInstinctカードが含まれ、ROCmもInstinctを中心に作られているため、一般向けRadeonより対応は広くなっています。
MI300Xはアクセラレータ1基あたり192 GBのHBM3メモリを搭載しており(AMD仕様)、非常に大きなモデルを1台に収めるのに向いています。1人で使うマシンなら、関係するAMDの選択肢はRadeon RXまたはRadeon AI PROです。
サーバーやクラウドの判断については、エンタープライズGPUサーバー購入ガイドとクラウドGPUレンタル比較を参照してください。
AMD導入でよくある失敗は?
- 24 GBで70Bモデルが動くと思い込む:70BモデルはQ4で約40 GB以上が必要なので、24 GBのカード1枚では約30〜35Bが上限です。70Bには2枚、または32 GBのR9700を2枚用意します。
- ROCm非対応のカードを買う:事前にAMDの対応表とOllamaのリストを確認してください。RX 6000シリーズはAMDの現行Radeon対応表にありません。
- Vulkanを試さない:ROCmがカードを認識しないときは、GPUが使えないと結論づける前にVulkanバックエンドを試してください。
- 提示価格を鵜呑みにする:2026年はGPUとメモリの価格が目立って動きました。表示価格ではなく、実際の取引価格を比べてください。
次のステップ
- ローカルLLM向けのコスパ重視GPU — 予算重視なら。LLM推論向けのコスパの良いGPU →
- GPU vs CPU vs Apple Silicon — AMD、Apple、CPU。自分の使い方に合うプラットフォームは? →
- 必要なVRAMはどれくらい? — GPUのVRAMをモデルサイズに合わせる →
地域のデータ規制はAMDとNVIDIAの選択にどう影響する?
データ保護の義務を変えるのはGPUのメーカーではなく、推論をローカルで行うかどうかです。 端末上での推論はプロンプトや文書を自分のハードウェア内にとどめるため、日本の個人情報保護法(APPI)、EUのGDPR、中国のPIPLおよびデータセキュリティ法に基づく越境移転のリスクを下げられる場合があります。ただし、適法な根拠、保存ルール、漏えい時の手順は引き続き必要です。企業での導入では、経済産業省(METI)のAIガバナンスに関する指針も参照し、規制対象のデータは正式なレビューを受けてください。
輸出管理の規則により、一部の市場ではAMDとNVIDIAの両方の高性能アクセラレータが制限される場合があります。輸入や購入の前に、お住まいの国の最新の規則を確認してください。
よくある質問
AMD GPUはローカルLLMの実行に向いていますか?
はい。ただし条件があります。RX 7900 XTX(24 GB)やRadeon AI PRO R9700(32 GB)などのAMDカードは、Ollama、LM Studio、llama.cppでROCmまたはVulkan経由の量子化LLMを動かせます。NVIDIA CUDAはソフトウェア対応が広くプロンプト処理も速いため、AMDはドルあたりのVRAMを重視する場合に向きます。
AIとローカルLLM向けに最適なAMDカードはどれですか?
総合ではRX 7900 XTXです。24 GBのVRAM、960 GB/sの帯域を持ち、AMDのROCm 7.2.1対応表とOllamaに対応しています。1枚あたりのVRAMを増やしたいならRadeon AI PRO R9700(32 GB)、7B〜14BならRX 9070 XT(16 GB)で足ります。
ローカルLLMはAMDとNVIDIAのどちらを買うべきですか?
CUDAとの互換性と手間の少なさを求めるならNVIDIAです。ドルあたりのVRAMを重視するならAMDで、特に32 GBのR9700はRTX 5090より安く買えます。中古のRX 7900 XTXは中古のRTX 3090とほぼ同じ価格なので、その比較ではソフトウェアの対応が決め手になります。
OllamaはAMD GPUで動きますか?
はい。OllamaはLinuxでROCm v7ドライバを必要とし、RX 9070 XT、RX 7900 XTX、RX 6800 XT、Radeon AI PRO R9700などを掲載しています。WindowsではROCmリストがRX 7000シリーズを対象とし、Vulkanはバックエンド導入時にデフォルトで有効になります。
LM StudioはAMD GPUに対応していますか?
はい。LM Studioはllama.cppランタイムのVulkanまたはROCmでAMD GPUを動かします。ROCmランタイムがカードを認識しない場合は、ランタイムをVulkanに切り替えてください。このページの以前の版はLM StudioをNVIDIA専用としていましたが、誤りでした。
AMD GPUハードウェアで量子化LLM推論を動かすにはどうすればよいですか?
VRAMに収まる量子化モデルを選び(Q4_K_Mはパラメータ10億あたり約0.6 GB)、OllamaまたはLM Studioを入れ、VulkanかROCmを使います。LinuxではROCm v7をamdgpu-installで入れ、モデルを実行して、ollama psまたはrocm-smiでGPUの使用を確認します。
ローカルLLMにはRX 9070 XTとRX 7900 XTXのどちらが良いですか?
ローカルLLMではRX 7900 XTXが優れています。24 GBならQ4で約30〜35Bのモデルが収まりますが、RX 9070 XTの16 GBは約14B〜24Bが上限です。RX 9070 XTは新しく安いので、16 GBで足りるならそちらを選んでください。
$500以下で買える最良のAMD GPUはどれですか?
中古で約$380〜410のRX 6800 XT(16 GB)が、$500以下では最もコスパの良いAMDカードです。7B〜14BモデルのQ4〜Q8を動かせますが、AMDの現行Radeon向けROCm対応表には載っていないため、OllamaのLinux向けROCm経路かVulkanを前提にしてください。
Radeon AI PRO R9700はローカルAIに買う価値がありますか?
1枚で32 GBが必要なら価値があります。希望価格は$1,299で、RTX 5090の約$3,700〜4,300より安い一方、報告されている実売価格は高めで、プロンプト処理も遅くなります。2枚あれば64 GBとなり、70BモデルのQ4に対応できます。
AMDのROCmにはLinuxが必要ですか?Windowsでも動きますか?
ROCmはLinuxのほうが対応が手厚く、AMDの対応表にはUbuntu 24.04.4、Ubuntu 22.04.5、RHEL 10.1が載っています。WindowsではOllamaのROCmリストがRX 7000シリーズを対象とし、それ以外のカードはVulkanバックエンドを使います。
LLMにはAMD InstinctとNVIDIA GPUのどちらが良いですか?
Instinct(MI300X、MI350X)はNVIDIAのデータセンターGPUと競合する製品で、サーバー用に購入します。MI300Xは192 GBのHBM3を搭載しています。1台のデスクトップならRadeonまたはRadeon AI PROが該当し、NVIDIAのCUDAエコシステムは今も幅広いです。
ディープラーニングや機械学習に最適なAMD GPUはどれですか?
推論ならRX 7900 XTX(24 GB)とRadeon AI PRO R9700(32 GB)が最良のAMD選択肢です。ROCmはPyTorchのビルドを提供しています(ROCm 7.14.0のリリースはPyTorch 2.12.0を挙げています)。CUDAを前提とする学習や研究用コードでは、NVIDIAのエコシステムが依然として広いので、購入前にお使いのフレームワークのAMD対応を確認してください。
Ryzen AI Max+ 395搭載ミニPCは、単体のAMD GPUより優れていますか?
モデルのサイズ次第です。Ryzen AI Max+ 395は最大128 GBのユニファイドメモリを持ちますが帯域は256 GB/sにとどまるため、大きなMixture-of-Expertsモデル向きです。単体カードは、VRAMに収まるモデルならトークンをより速く生成します。
出典
- OllamaのGPUドキュメント:AMD ROCm v7の要件、対応するRadeon、Radeon AI PRO、Radeon PRO、Ryzen AI、Instinctカード、Vulkanバックエンド
- Ollamaのリリース:v0.40.10(2026年10月23日)
- Radeon・Ryzen向けAMD ROCm — Linux互換性:ROCm 7.2.1が対応するRadeon GPUとディストリビューション
- ROCmのリリース:ROCm 7.14.0(2026年7月16日)、フレームワークのバージョン
- llama.cppのビルドドキュメント:HIPおよびVulkanバックエンド
- AMD製品仕様:RX 7900 XTX、RX 9070 XT、Radeon AI PRO R9700
- 価格のスナップショット(米国、2026年9〜10月):公開のGPU価格トラッカーと第三者のレビュー。提示価格であり、すぐに変動します
- AMD GPUは高いトークン/秒を出せますが、速度だけで回答の品質は決まりません。モデルに何を尋ねるかも、応答の速さと同じくらい重要です。コンテキストウィンドウの解説では、GPUメモリの制約内で長いリクエストを構成する方法を紹介しています。