أي بطاقات AMD تستحق الشراء لنماذج LLM المحلية؟
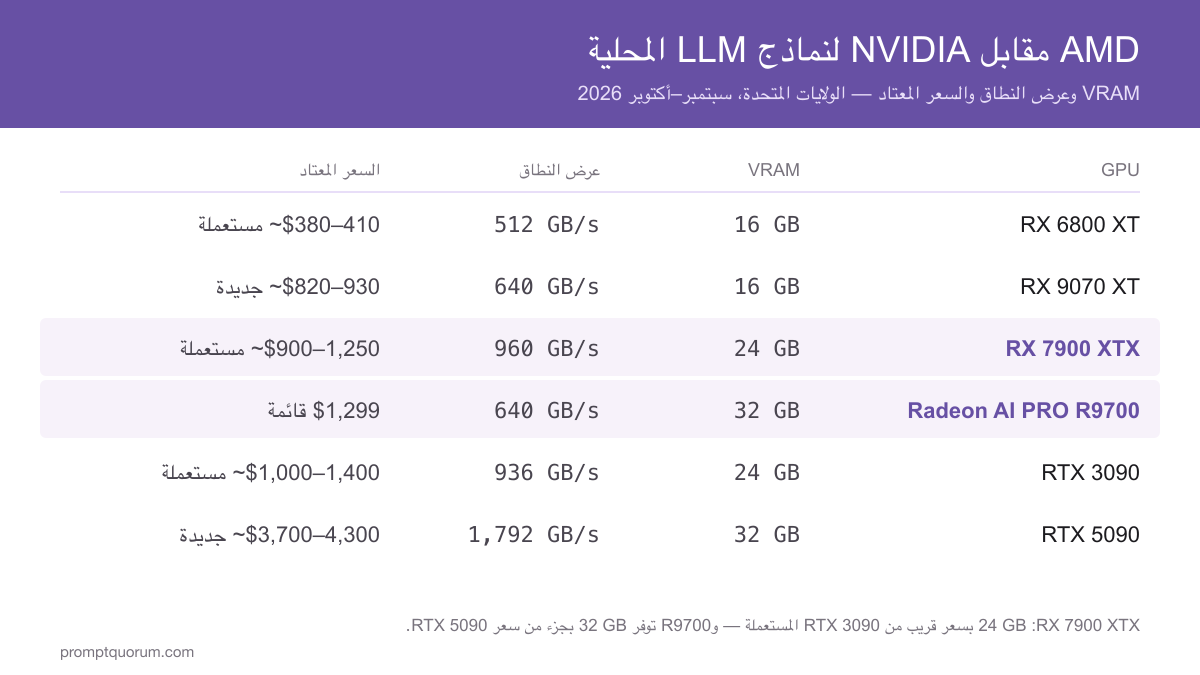
- RX 7900 XTX (24 GB GDDR6، 960 GB/s، RDNA 3): بطاقة AMD الاستهلاكية ذات أكبر VRAM وأعلى عرض نطاق. حجم نموذج 32B بصيغة Q4_K_M نحو 20 GB، فيتّسع مع هامش للسياق. موجودة في مصفوفة ROCm 7.2.1 من AMD وفي قائمة ROCm لدى Ollama على Linux وWindows. مستعملة: نحو 900–1,250 دولار.
- RX 9070 XT (16 GB GDDR6، 640 GB/s، RDNA 4): خيار 16 GB الأحدث، في مصفوفة ROCm 7.2.1 من AMD وقائمة ROCm على Linux لدى Ollama. تشغّل نماذج 14B بصيغة Q4–Q6 براحة. جديدة: نحو 820–930 دولارًا.
- Radeon AI PRO R9700 (32 GB GDDR6، 640 GB/s، RDNA 4): بطاقة محطات عمل بأكبر VRAM تبيعه AMD في هذه الفئة. تتعامل مع نماذج 32B بصيغة Q4–Q6؛ وبطاقتان (64 GB) تستوعبان نموذج 70B بصيغة Q4. سعر القائمة لدى AMD: 1,299 دولار؛ وأسعار السوق المبلغ عنها أعلى.
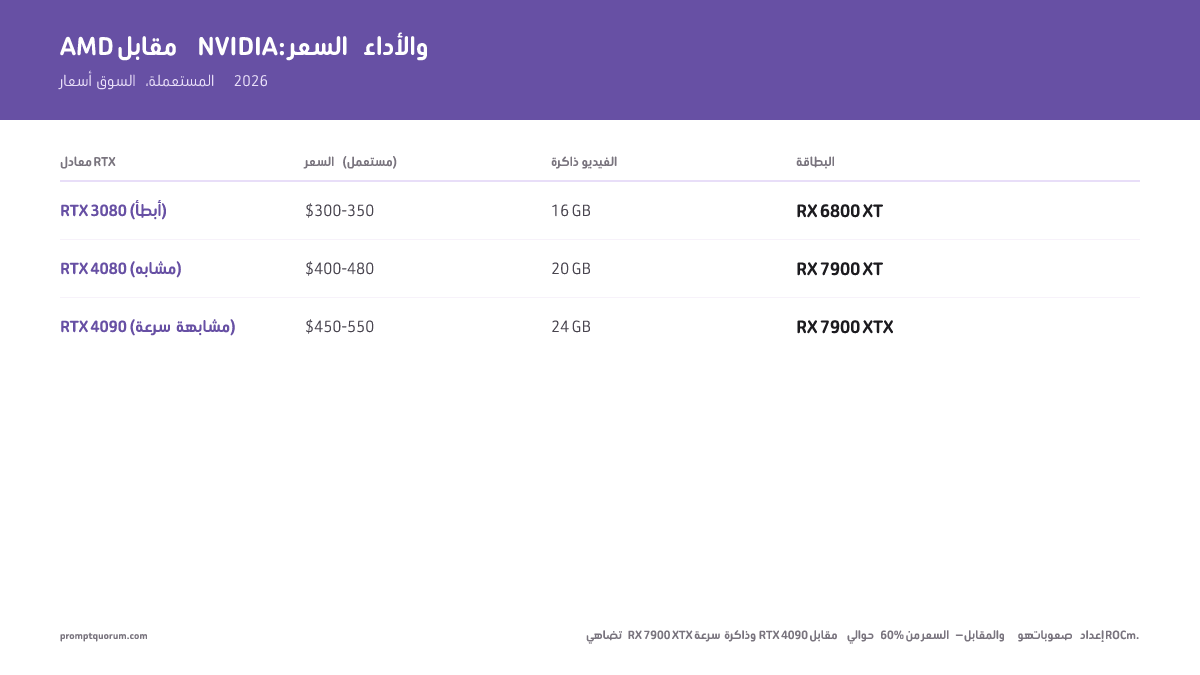
- RX 7900 XT (20 GB GDDR6، 800 GB/s، RDNA 3): تستوعب نماذج حتى نحو 24–27B بصيغة Q4. اشترِها فقط إذا كانت أرخص بوضوح من 7900 XTX المستعملة؛ ولم يُعاد التحقق من سعرها في هذا التحديث.
- RX 6800 XT (16 GB GDDR6، 512 GB/s، RDNA 2): خيار الميزانية بنحو 380–410 دولارات مستعملة. عرض نطاق أقل يعني توليدًا أبطأ، ولم تعد مصفوفة ROCm الحالية من AMD لبطاقات Radeon تدرجها، فاعتمد على مسار ROCm على Linux لدى Ollama أو على Vulkan.
- أجهزة Mini PC بمعالج Ryzen AI Max+ 395 (حتى 128 GB ذاكرة موحّدة، 256 GB/s): ليست بطاقة رسوميات، لكنها طريقة أقل تكلفة لتشغيل نماذج Mixture-of-Experts الكبيرة جدًا على AMD. أُدرجت أنظمة 128 GB بنحو 3,300–4,350 دولار في أواخر سبتمبر 2026 (متتبعات الأسعار). راجع أفضل أجهزة AMD Mini PC لنماذج LLM المحلية.
كيف تقارن بطاقات AMD بـ NVIDIA في VRAM والسعر؟
GPU | VRAM | عرض النطاق | السعر المعتاد | الواجهة الخلفية |
|---|---|---|---|---|
| RX 6800 XT | 16 GB | 512 GB/s | ~380–410 دولارًا مستعملة | ROCm (Linux)، Vulkan |
| RX 9070 XT | 16 GB | 640 GB/s | ~820–930 دولارًا جديدة | ROCm (Linux)، Vulkan |
| RX 7900 XT | 20 GB | 800 GB/s | لم يُعاد التحقق منه | ROCm، Vulkan |
| RX 7900 XTX | 24 GB | 960 GB/s | ~900–1,250 دولارًا مستعملة | ROCm، Vulkan |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 1,299 دولار قائمة؛ ~1,400–1,900 سوق | ROCm (Linux)، Vulkan |
| RTX 3090 | 24 GB | 936 GB/s | ~1,000–1,400 دولار مستعملة | CUDA، Vulkan |
| RTX 4090 | 24 GB | 1,008 GB/s | ~2,250 دولارًا مستعملة | CUDA، Vulkan |
| RTX 5090 | 32 GB | 1,792 GB/s | ~3,700–4,300 دولار جديدة | CUDA، Vulkan |
سعة VRAM وعرض النطاق مواصفات من الشركات المصنّعة (AMD RX 7900 XTX وRX 9070 XT وRadeon AI PRO R9700). الأسعار لقطات من أسعار معروضة في الولايات المتحدة مأخوذة من متتبعات أسعار عامة ومراجعات (سبتمبر–أكتوبر 2026)، وليست قياسات من PromptQuorum؛ وقد تختلف الأسعار في بلدك. تحقق من أسعار البيع الفعلية قبل الشراء.
ما سرعة بطاقات AMD مقارنة بـ NVIDIA في استدلال LLM؟
تعتمد سرعة توليد الرموز (tokens) على عرض نطاق الذاكرة أكثر من TFLOPS، وتقترب أقوى بطاقات AMD في هذا المقياس من بطاقات NVIDIA الرائدة السابقة. تقترب RX 7900 XTX (960 GB/s) من RTX 3090 (936 GB/s) وتقل عن RTX 4090 (1,008 GB/s) وRTX 5090 (1,792 GB/s).
معالجة الموجّه (prefill) هي المجال الذي تتفوق فيه NVIDIA بوضوح أكبر. في مقارنة مجتمعية باستخدام llama.cpp (نقاش llama.cpp رقم 19890، وتكرره مراجعات أطراف ثالثة) كانت RTX 5090 أسرع بنحو 2.6–3.4 مرة من Radeon AI PRO R9700 في prefill وبنحو 1.5 مرة في التوليد للنموذج نفسه. هذه بيانات أبلغ عنها مطورون، وليست قياسًا من PromptQuorum.
يغيّر اختيار الواجهة الخلفية النتائج: يتبادل Vulkan وROCm (HIP) التفوق بحسب النموذج والبطاقة وإصدار المشغّل. يمكن بناء llama.cpp بالواجهتين معًا، فاختبرهما على بطاقتك قبل أن تحسم قرارك.
عمليًا، توقّع أن تكون AMD منافسة في سرعة التوليد بالنسبة لكل GB/s من عرض النطاق، وأبطأ مع الموجّهات الطويلة، وأقل صقلًا من حيث البرمجيات.
ما مدى صعوبة إعداد ROCm في 2026؟
يحتاج Vulkan إلى مشغّل رسوميات فقط؛ أما ROCm فيحتاج إلى GPU وتوزيعة Linux ونواة مدعومة. تحقق مما يلي قبل الشراء:
1. طابِق بطاقتك مع مصفوفة AMD. تدرج مصفوفة ROCm 7.2.1 لبطاقات Radeon كلًا من RX 9070 XT وRX 9060 XT وRX 7900 XTX وRX 7900 XT وRX 7900 GRE وRX 7800 XT وRadeon AI PRO R9700 على Ubuntu 24.04.4 وUbuntu 22.04.5 وRHEL 10.1.
2. راجع قائمة Ollama أيضًا. تضيف وثائق Ollama بطاقات RX 6800 XT وRX 6900 XT وغيرها من سلسلة RX 6000 لـ ROCm على Linux، وتذكر Ryzen AI Max+ 395. يمكن للبطاقات غير المدرجة تجربة `HSA_OVERRIDE_GFX_VERSION` على Linux؛ وهو غير مدعوم على Windows.
3. ثبّت حزمة ROCm v7 بأداة `amdgpu-install` من AMD (Linux). يتطلب Ollama ROCm v7 على Linux.
4. تحقق من الاكتشاف بالأمر `rocminfo`: يجب أن يظهر GPU كوكيل (agent)، مثل gfx1100 لبطاقة RX 7900 XTX وgfx1201 لبطاقة RX 9070 XT.
5. على Windows، تذكر قائمة ROCm لدى Ollama بطاقات RX سلسلة 7000. أما بقية البطاقات، ومنها سلسلة RX 9070، فليست في هذه القائمة، فاستخدم واجهة Vulkan الخلفية.
أحدث إصدار من ROCm هو 7.14.0 (16 يوليو 2026) الذي نقل ROCm إلى نظام البناء المعياري TheRock. وكانت صفحة التوافق لبطاقات Radeon لدى AMD تغطي الإصدارات حتى 7.2.1 عند التحقق، فطابِق بطاقتك مع مصفوفة الإصدار الذي ستثبّته.
أي أدوات LLM المحلية تعمل على بطاقات AMD؟
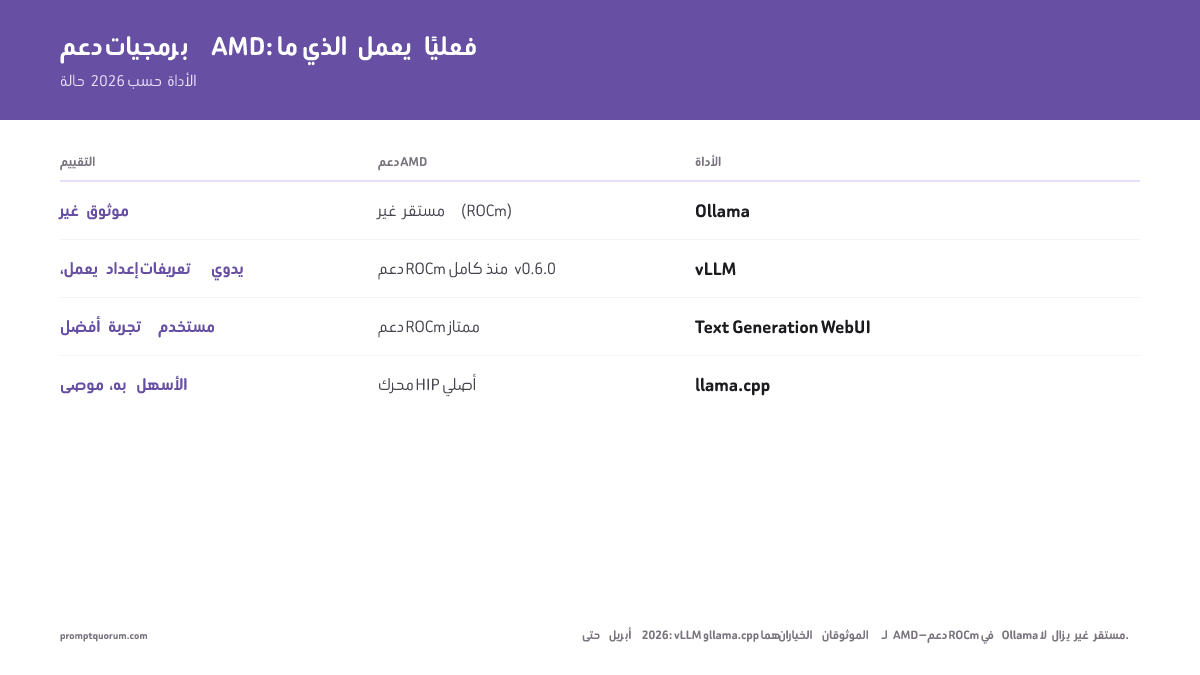
Ollama: ROCm v7 على Linux للبطاقات المذكورة أعلاه؛ وعلى Windows تعمل بطاقات RX سلسلة 7000 عبر ROCm. يكون Vulkan مفعّلًا افتراضيًا عند تثبيت واجهته الخلفية ويمكن تعطيله بـ `OLLAMA_VULKAN=0`. الإصدار الحالي v0.40.10 (23 أكتوبر 2026) ويتضمن بناء ROCm لـ Linux.
llama.cpp: يُبنى لـ AMD باستخدام HIP (ROCm) أو Vulkan (`-DGGML_VULKAN=1`). يمكن تجميع الواجهتين معًا واختيار إحداهما لكل جهاز بالخيار `--device`. معظم الواجهات الرسومية مبنية عليه.
LM Studio: يدعم بطاقات AMD عبر بيئات تشغيل llama.cpp — Vulkan وROCm. يُعد Vulkan البديل المعتاد عندما لا تكتشف بيئة ROCm البطاقة. (كانت نسخة سابقة من هذه الصفحة تقول إن LM Studio يعمل مع NVIDIA فقط؛ وهذا خطأ.)
vLLM: يوفّر إصدارات ROCm (يذكر إصدار ROCm 7.14.0 نسخة vLLM 0.23.0). يستهدف خدمة النماذج والمعالجة الدفعية؛ راجع وثائق vLLM لهدف GPU الخاص بك قبل الاعتماد عليه.
قاعدة عامة: استخدم Ollama أو LM Studio للسهولة، وllama.cpp للتحكم، وvLLM لخدمة عدة مستخدمين.
كيف تشغّل استدلال LLM المكمَّم على بطاقة AMD؟
- 1اختر حجم النموذج بما يناسب VRAM. يستهلك ملف Q4_K_M نحو 0.6 GB لكل مليار معامل (نحو 9 GB لنموذج 14B و20 GB لنموذج 32B؛ تقديرات). اترك 2–4 GB لذاكرة السياق المؤقتة.
- 2اختر واجهة خلفية. يوفّر Vulkan أسرع بداية (مشغّل الرسوميات فقط). ويُفضَّل ROCm (HIP) على إعدادات Linux المدعومة.
- 3ثبّت بيئة تشغيل. على Linux ثبّت ROCm v7 أولًا بـ `amdgpu-install` لمسار ROCm، ثم ثبّت Ollama (`curl -fsSL https://ollama.com/install.sh | sh`) أو LM Studio.
- 4شغّل نموذجًا مكمَّمًا. مثلًا `ollama run qwen3:14b`، أو في llama.cpp الأمر `llama-server -m model.gguf -ngl 99` لتفريغ كل الطبقات على GPU.
- 5تأكد من استخدام GPU. يجب أن يعرض `ollama ps` القيمة 100% GPU؛ ويعرض `rocm-smi` الـ VRAM المستخدم. إذا ظهر CPU فراجع تثبيت ROCm أو انتقل إلى Vulkan.
متى تشتري AMD بدلًا من NVIDIA لنماذج LLM المحلية؟
اشترِ AMD إذا:
- أردت 32 GB على بطاقة واحدة بمال أقل: تكلّف Radeon AI PRO R9700 من ثلث سعر RTX 5090 إلى نصفه تقريبًا.
- كنت تملك بطاقة Radeon مدعومة، أو أردت بطاقة تؤدي جيدًا في الألعاب أيضًا.
- كنت تستخدم Linux أو يكفيك Vulkan، وكانت أدواتك (Ollama وllama.cpp وLM Studio) تدعم AMD أصلًا.
اشترِ NVIDIA إذا:
- احتجت إلى أدوات CUDA فقط أو حزم التدريب والضبط الدقيق أو أسرع معالجة للموجّه.
- كنت تقارن بطاقات 24 GB المستعملة: تكلّف RTX 3090 المستعملة تقريبًا ما تكلّفه RX 7900 XTX المستعملة، فقد يحسم دعم CUDA الأمر.
- أردت قضاء أقل وقت ممكن في الإعداد.
اشترِ AMD عندما تريد 24–32 GB من VRAM بسعر أقل من أحدث بطاقات NVIDIA؛ وتجاوزها إذا كنت تعتمد على أدوات CUDA فقط أو لا تريد أي جهد في الإعداد.
تكون AMD صفقة جيدة عندما يكون الناقص لديك هو VRAM ويناسبك مسار البرمجيات (ROCm على Linux أو Vulkan). وإذا كنت جديدًا على نماذج LLM المحلية وتريد أن يعمل كل شيء مباشرة فابدأ بـ NVIDIA.
AMD Instinct أم وحدات NVIDIA لمراكز البيانات: أيهما أفضل لنماذج LLM؟
تنافس AMD Instinct (MI300X وMI350X) وحدات NVIDIA لمراكز البيانات، وتُشترى للخوادم لا لمكاتب العمل. تتضمن قائمة ROCm لدى Ollama بطاقات Instinct، وقد بُني ROCm حولها، لذا فدعمها أوسع من بطاقات Radeon الاستهلاكية.
يحمل MI300X ذاكرة HBM3 بسعة 192 GB لكل مسرّع (مواصفات AMD)، وهذا يناسب النماذج الكبيرة جدًا في جهاز واحد. أما لجهاز بمستخدم واحد فالخيارات ذات الصلة من AMD هي Radeon RX أو Radeon AI PRO.
لقرارات الخوادم والسحابة راجع دليل شراء خوادم GPU للمؤسسات ومقارنة تأجير GPU السحابي.
ما أكثر الأخطاء شيوعًا عند اعتماد AMD؟
- افتراض أن 24 GB تشغّل نماذج 70B: يحتاج نموذج 70B بصيغة Q4 إلى نحو 40 GB أو أكثر، فتبلغ بطاقة 24 GB الواحدة حدّها عند 30–35B تقريبًا. خطّط لبطاقتين أو لزوج R9700 بسعة 32 GB لنماذج 70B.
- شراء بطاقة لا يدعمها ROCm: تحقق أولًا من مصفوفة AMD وقائمة Ollama. بطاقات RX سلسلة 6000 ليست في مصفوفة AMD الحالية لبطاقات Radeon.
- تجاهل Vulkan: إذا لم يكتشف ROCm بطاقتك فجرّب واجهة Vulkan قبل أن تستنتج أن GPU غير قابل للاستخدام.
- الوثوق بالأسعار المعروضة: تحركت أسعار GPU والذاكرة بوضوح خلال 2026. قارن أسعار البيع الفعلية لا أسعار الإعلانات.
الخطوات التالية
- أفضل بطاقات GPU الاقتصادية لنماذج LLM المحلية — ميزانيتك محدودة؟ أفضل بطاقات GPU قيمةً لاستدلال LLM →
- GPU مقابل CPU مقابل Apple Silicon — AMD أم Apple أم CPU: أي منصة تناسب سير عملك؟ →
- كم VRAM أحتاج؟ — طابِق VRAM لبطاقتك مع حجم النموذج →
كيف تؤثر قوانين البيانات الإقليمية في قرار AMD مقابل NVIDIA؟
الشركة المصنّعة لـ GPU لا تغيّر التزامات حماية البيانات؛ أما تشغيل الاستدلال محليًا فيغيّرها. يُبقي الاستدلال على الجهاز الموجّهات والمستندات على عتادك، وهذا قد يقلل التعرّض لمخاطر النقل عبر الحدود بموجب GDPR في الاتحاد الأوروبي وAPPI في اليابان وPIPL وقانون أمن البيانات في الصين، وكذلك أنظمة حماية البيانات الشخصية الإقليمية في الخليج مثل نظام PDPL السعودي. ومع ذلك يظل الامتثال متطلبًا لأساس نظامي وقواعد للاحتفاظ بالبيانات وإجراءات للتعامل مع الاختراقات، فاطلب مراجعة رسمية للبيانات الخاضعة للتنظيم.
قد تقيّد قواعد ضبط الصادرات المسرّعات عالية الأداء من AMD وNVIDIA في بعض الأسواق. تحقق من القواعد السارية في بلدك قبل الاستيراد أو الشراء.
الأسئلة الشائعة
هل بطاقات AMD جيدة لتشغيل نماذج LLM المحلية؟
نعم، مع بعض التحفظات. تشغّل بطاقات AMD مثل RX 7900 XTX (24 GB) وRadeon AI PRO R9700 (32 GB) نماذج LLM المكمَّمة عبر ROCm أو Vulkan في Ollama وLM Studio وllama.cpp. ما زالت NVIDIA CUDA تتمتع بدعم برمجي أوسع ومعالجة أسرع للموجّه، لذا تناسب AMD أكثر عندما يهمّك VRAM لكل دولار.
ما أفضل بطاقة AMD للذكاء الاصطناعي ونماذج LLM المحلية؟
RX 7900 XTX هي أفضل بطاقة AMD عامة لنماذج LLM المحلية: 24 GB من VRAM وعرض نطاق 960 GB/s ودعم في مصفوفة ROCm 7.2.1 من AMD وفي Ollama. وللحصول على VRAM أكبر في البطاقة الواحدة توفر Radeon AI PRO R9700 سعة 32 GB؛ وللنماذج من 7B إلى 14B تكفي RX 9070 XT (16 GB).
AMD أم NVIDIA لنماذج LLM المحلية: أيهما أشتري؟
اشترِ NVIDIA إذا أردت توافق CUDA وأقل قدر من الإعداد. واشترِ AMD إذا أردت VRAM أكبر لكل دولار، خصوصًا R9700 بسعة 32 GB مقابل RTX 5090. تكلّف RX 7900 XTX المستعملة تقريبًا ما تكلّفه RTX 3090 المستعملة، وهنا يتوقف الاختيار على البرمجيات.
هل يعمل Ollama مع بطاقات AMD؟
نعم. يتطلب Ollama مشغّل ROCm v7 على Linux ويدرج RX 9070 XT وRX 7900 XTX وRX 6800 XT وRadeon AI PRO R9700 وغيرها. وعلى Windows تشمل قائمة ROCm بطاقات RX سلسلة 7000، ويكون Vulkan مفعّلًا افتراضيًا عند تثبيت واجهته الخلفية.
هل يدعم LM Studio بطاقات AMD؟
نعم. يشغّل LM Studio بطاقات AMD عبر بيئات تشغيل llama.cpp، إما Vulkan أو ROCm. إذا لم تكتشف بيئة ROCm بطاقتك فبدّل البيئة إلى Vulkan. كانت نسخ سابقة من هذه الصفحة تذكر خطأً أن LM Studio يعمل مع NVIDIA فقط.
كيف أشغّل استدلال LLM مكمَّمًا على عتاد GPU من AMD؟
اختر نموذجًا مكمَّمًا يتّسع في VRAM (يستهلك Q4_K_M نحو 0.6 GB لكل مليار معامل)، وثبّت Ollama أو LM Studio، واستخدم Vulkan أو ROCm. على Linux ثبّت ROCm v7 بـ amdgpu-install، ثم شغّل النموذج وتأكد من استخدام GPU عبر ollama ps أو rocm-smi.
RX 9070 XT أم RX 7900 XTX لنماذج LLM المحلية؟
لنماذج LLM المحلية تُفضَّل RX 7900 XTX لأن 24 GB تستوعب نماذج حتى نحو 30–35B بصيغة Q4، بينما تبلغ سعة 16 GB في RX 9070 XT حدّها عند نحو 14B–24B. RX 9070 XT أحدث وأرخص، فاخترها إذا كانت 16 GB تكفيك.
ما أفضل بطاقة AMD بأقل من 500 دولار؟
RX 6800 XT (16 GB) بنحو 380–410 دولارات مستعملة هي أفضل بطاقة AMD بأقل من 500 دولار. تشغّل نماذج 7B–14B بصيغة Q4–Q8، لكنها ليست في مصفوفة ROCm الحالية من AMD لبطاقات Radeon، فاعتمد على مسار ROCm على Linux لدى Ollama أو على Vulkan.
هل تستحق Radeon AI PRO R9700 الشراء للذكاء الاصطناعي المحلي؟
نعم إذا كنت تحتاج إلى 32 GB على بطاقة واحدة. سعر القائمة 1,299 دولار مقابل نحو 3,700–4,300 دولار لبطاقة RTX 5090، لكن أسعار السوق المبلغ عنها أعلى ومعالجة الموجّه أبطأ. بطاقتا R9700 تعطيان 64 GB لنماذج 70B بصيغة Q4.
هل أحتاج إلى Linux لـ ROCm من AMD أم يعمل على Windows؟
Linux هو مسار ROCm الأفضل دعمًا: تدرج مصفوفة AMD كلًا من Ubuntu 24.04.4 وUbuntu 22.04.5 وRHEL 10.1. وعلى Windows تشمل قائمة ROCm لدى Ollama بطاقات RX سلسلة 7000، وتستخدم بقية البطاقات واجهة Vulkan الخلفية.
أيهما أفضل لنماذج LLM: AMD Instinct أم بطاقات NVIDIA؟
تنافس Instinct (MI300X وMI350X) وحدات NVIDIA لمراكز البيانات وتُشترى للخوادم؛ ويحمل MI300X ذاكرة HBM3 بسعة 192 GB. أما لحاسوب مكتبي واحد فالخيارات ذات الصلة من AMD هي Radeon أو Radeon AI PRO، ويظل نظام CUDA البيئي لدى NVIDIA أوسع.
ما أفضل بطاقة AMD للتعلم العميق وتعلم الآلة؟
للاستدلال، تُعد RX 7900 XTX (24 GB) وRadeon AI PRO R9700 (32 GB) أفضل خيارات AMD. يوفّر ROCm إصدارات من PyTorch (يذكر إصدار ROCm 7.14.0 نسخة PyTorch 2.12.0). أما التدريب والشفرات البحثية التي تفترض CUDA فما زال لدى NVIDIA نظام بيئي أوسع لها، فتحقق من دعم إطار عملك لـ AMD قبل الشراء.
هل جهاز Mini PC بمعالج Ryzen AI Max+ 395 أفضل من بطاقة AMD مستقلة؟
يعتمد ذلك على حجم النموذج. توفّر أنظمة Ryzen AI Max+ 395 حتى 128 GB من الذاكرة الموحّدة لكن عرض نطاقها 256 GB/s فقط، فتناسب نماذج Mixture-of-Experts الكبيرة، بينما تولّد البطاقة المستقلة الرموز أسرع في النماذج التي تتّسع في VRAM الخاص بها.
المصادر
- وثائق GPU لدى Ollama: متطلب AMD ROCm v7 وبطاقات Radeon وRadeon AI PRO وRadeon PRO وRyzen AI وInstinct المدعومة وواجهة Vulkan
- إصدارات Ollama: v0.40.10، 23 أكتوبر 2026
- AMD ROCm على Radeon وRyzen — توافق Linux: بطاقات Radeon والتوزيعات المدعومة في ROCm 7.2.1
- إصدارات ROCm: ROCm 7.14.0، 16 يوليو 2026، وإصدارات الأطر
- وثائق بناء llama.cpp: واجهتا HIP وVulkan الخلفيتان
- مواصفات منتجات AMD: RX 7900 XTX وRX 9070 XT وRadeon AI PRO R9700
- لقطات الأسعار (الولايات المتحدة، سبتمبر–أكتوبر 2026): متتبعات أسعار GPU العامة ومراجعات أطراف ثالثة؛ وهي أسعار معروضة تتغير بسرعة
- تقدّم بطاقات AMD سرعات جيدة في الرموز في الثانية، لكن السرعة وحدها لا تحدد جودة الإجابة. ما تسأله للنموذج لا يقل أهمية عن سرعة استجابته: يوضح شرح نوافذ السياق كيف تنظّم الطلبات الأطول ضمن حدود ذاكرة GPU.