빠른 팩트
- 비교한 모델: Phi-4 Mini 3.8B, Gemma 3 4B, Gemma 3 1B, SmolLM 2 1.7B, Qwen3 1.7B, Llama 3.2 3B (모두 Q4_K_M GGUF).
- 기준 기기: iPhone 17 Pro (A19 Pro), iPhone 16 Pro (A18 Pro, 8 GB), Galaxy S25 Ultra (Snapdragon 8 Elite), Pixel 9 Pro (Tensor G4), OnePlus 13 (Snapdragon 8 Elite). 이 페이지의 속도 수치는 PromptQuorum이 측정한 값이 아니라 참고용 추정치이며, 실제 속도는 앱, 런타임, 양자화, 폰 온도, 설정에 따라 달라집니다.
- 추론 엔진: llama.cpp via PocketPal AI / LLM Farm (기본값), MLC LLM via MLC Chat (iPhone Metal 가속), Ollama via Termux (Android).
- 메모리 사용량 (Q4_K_M): Phi-4 Mini ~2.7 GB, Gemma 3 4B ~2.9 GB, Llama 3.2 3B ~2.2 GB, Qwen3 1.7B ~1.1 GB, SmolLM 2 1.7B ~1.1 GB, Gemma 3 1B ~720 MB.
- 최소 RAM (활성): 1.7B 모델은 6GB 폰; 3B–4B 모델은 8GB; Gemma 3 1B만 4GB 가능.
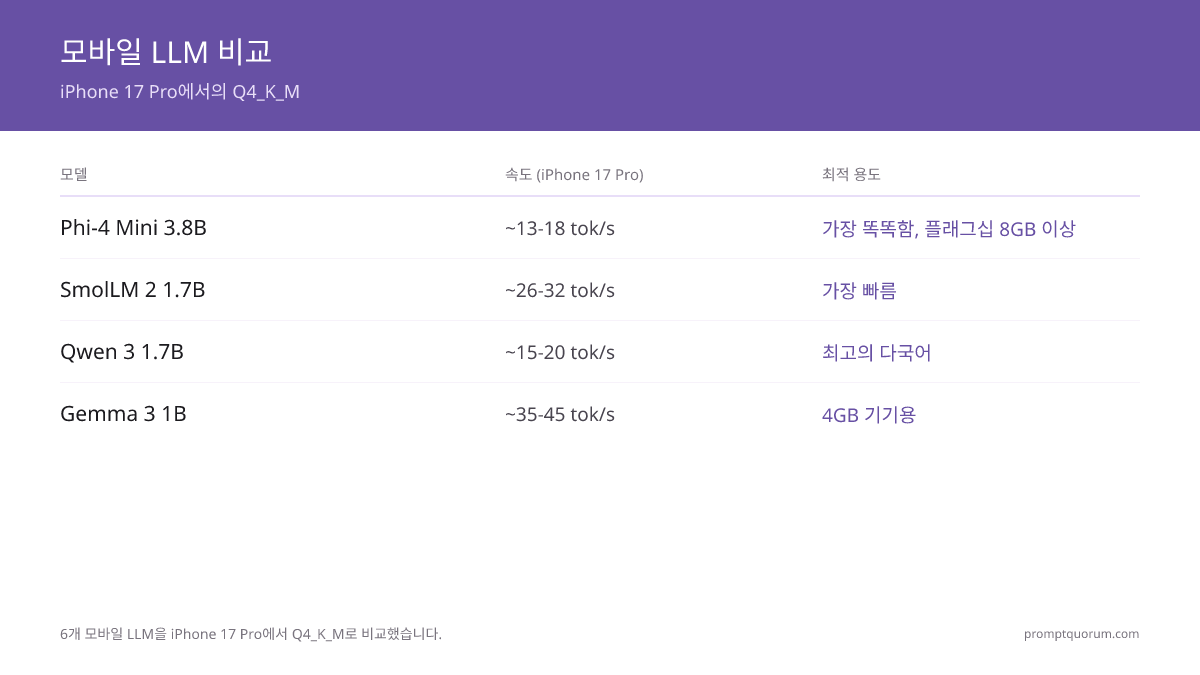
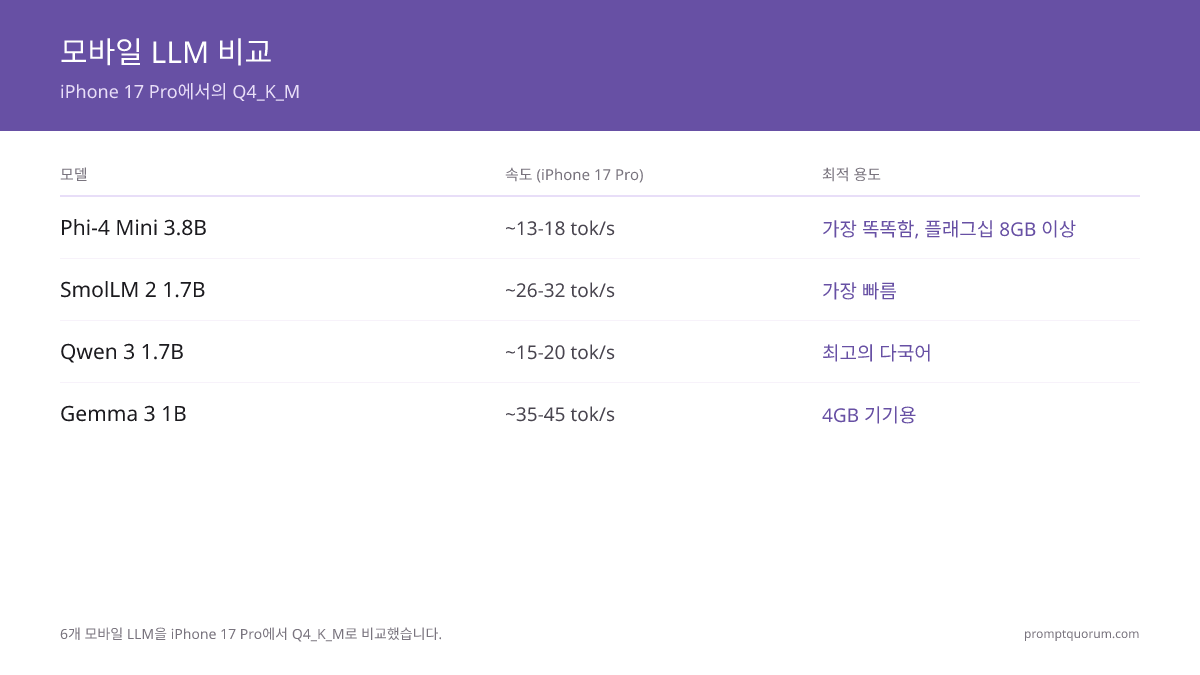
- iPhone 17 Pro 최고 토큰/초: Gemma 3 1B ~35–45, SmolLM 2 ~26–32, Qwen3 ~24–32, Llama 3.2 3B ~16–22, Phi-4 Mini ~13–18, Gemma 3 4B ~10–13.
- 양자화 소스: 6종 모두 Hugging Face에서 Q4_K_M GGUF로 제공되며 PocketPal AI / MLC Chat / LM Studio를 통해서도 사용 가능합니다.
- 다운로드 크기 (Q4_K_M, MB): Gemma 3 1B ~720, Qwen3 1.7B ~1,100, SmolLM 2 ~1,100, Llama 3.2 3B ~2,200, Phi-4 Mini ~2,700, Gemma 3 4B ~2,900 — 아래 크기 표를 참고하십시오.
- 속도 비교에 없는 최신 모델: SmolLM 3 (3B, Hugging Face, 2025년 7월)와 Gemma 3n (E2B / E4B, Google). 이미지 입력: 6종 중 Gemma 3 4B만 가능.
어떤 모바일 모델을 선택해야 합니까?
대부분의 고사양 폰(iPhone 16 Pro / 17 Pro, Galaxy S25 Ultra, OnePlus 13)에서는 Phi-4 Mini (3.8B Q4_K_M)를 선택하십시오. 4B 미만 중 가장 스마트한 모델이며 실용적인 대화 속도로 구동됩니다. 특정 필요에 해당하는 경우에만 다른 모델을 선택하십시오 — 속도(SmolLM 2), 다국어(Qwen3), 구형 폰 호환성(Gemma 3 1B).
📍 한 문장으로
8GB 이상 고사양에는 Phi-4 Mini(가장 스마트), 속도에는 SmolLM 2 1.7B, 다국어에는 Qwen3 1.7B, 4GB 폰에는 Gemma 3 1B, 도구 호출에는 Llama 3.2 3B, Phi-4 Mini를 사용할 수 없을 때 균형 선택으로 Gemma 3 4B를 사용하십시오.
💬 쉽게 말하면
모바일에서 단 하나의 최고 모델은 없습니다 — 올바른 선택은 폰과 사용 목적에 따라 다릅니다. 최근 2년 이내 폰이고 RAM이 8GB 이상이라면 Phi-4 Mini를 설치하십시오. 영어 외 언어로 주로 채팅한다면 Qwen 3를 설치하십시오. 품질을 약간 희생하더라도 가장 빠른 응답을 원한다면 SmolLM 2를 설치하십시오. 폰이 구형이거나 RAM이 4GB뿐이라면 Gemma 3 1B를 설치하십시오. 모델 간 차이는 실제로 존재하지만 어떤 모델이든 일관된 응답을 생성합니다.
결정: 어떤 모바일 모델을 선택합니까?
다음의 경우 로컬 LLM을 사용하십시오:
- •RAM 8GB 이상 고사양 폰 (iPhone 16 Pro/17 Pro, Galaxy S25 Ultra, OnePlus 13) → Phi-4 Mini 3.8B
- •모든 폰에서 가장 빠른 토큰/초가 필요한 경우 → SmolLM 2 1.7B
- •영어 외 언어 사용 (번역, 다국어 채팅) → Qwen3 1.7B
- •광범위한 앱 호환성, 도구 호출 또는 RAG가 필요한 경우 → Llama 3.2 3B
- •RAM 4GB 구형 폰 → Gemma 3 1B
- •앱에서 Phi-4 Mini를 사용할 수 없고 4B급 품질이 필요한 경우 → Gemma 3 4B
다음의 경우 클라우드 모델을 사용하십시오:
- •다단계 추론, 복잡한 코드 생성, 긴 문서 분석 → 클라우드 사용 또는 70B 이상 모델을 갖춘 홈 PC에 원격 연결
- •정밀한 OCR이나 정확도가 중요한 이미지 분석 → 클라우드 앱; 간단한 이미지 캡션은 Gemma 3 4B로 온디바이스 실행 가능 (아래 "폰에서의 멀티모달" 참고)
- •3,000 토큰 이상에서 일관성이 중요한 긴 창작 글쓰기 → 클라우드 또는 데스크톱의 8B 이상
빠른 결정:
- →대부분의 기본 선택: Phi-4 Mini 3.8B
- →모든 기기에서 가장 빠름: SmolLM 2 1.7B
- →최고의 다국어: Qwen3 1.7B

💡팁: 확실하지 않다면 고사양 폰에서는 Phi-4 Mini, 중급 폰에서는 SmolLM 2 1.7B로 시작하십시오 — 빠른 연결로 5분 이내에 다운로드할 수 있으며 되돌릴 수 있습니다. 실제로 중요한 작업으로 테스트해 보십시오. 품질이 수용 가능하다면 기본 모델이 결정됩니다. PocketPal AI나 LM Studio를 통해 30초 만에 변경할 수 있습니다.
모바일 모델 비교 표
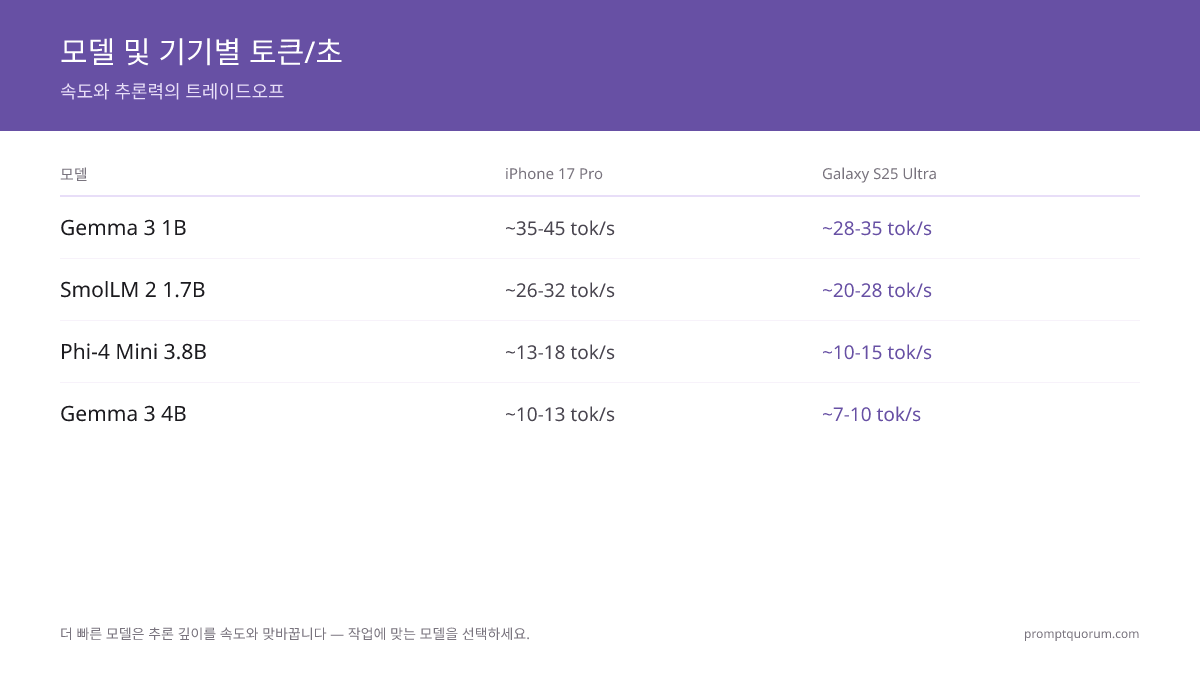
아래 4열 표는 빠른 선택을 위한 레이어입니다 — 기기 등급이나 사용 사례에 맞는 행을 하나 선택하십시오. 토큰/초 수치는 PromptQuorum이 측정한 값이 아닌 참고용 추정치이며, PocketPal AI (llama.cpp)로 iPhone 17 Pro에서 Q4_K_M 양자화를 사용하는 경우를 가정한 것입니다. iPhone 16 Pro에서는 15–25% 낮고, Galaxy S25 Ultra에서 MLC Chat 또는 Termux+Ollama 사용 시 약 10–20% 낮습니다.
📍 한 문장으로
Phi-4 Mini는 가장 스마트, SmolLM 2 1.7B는 가장 빠름, Qwen3 1.7B는 최고 다국어, Gemma 3 1B는 가장 작은 실용 모델, Llama 3.2 3B는 최고 만능 3B, Gemma 3 4B는 균형 잡힌 기본 선택입니다.
💬 쉽게 말하면
이 표를 위에서 아래로 크기 순으로 읽거나 기기 등급에 해당하는 행으로 바로 이동하십시오. 최적 용도 열은 모델이 최적화하는 것을 나타냅니다 — 가장 중요한 강점이 있는 행을 선택하고 나머지는 무시하십시오.
모델 | 크기 | 토큰/초 (17 Pro) | 최적 용도 |
|---|---|---|---|
| Phi-4 Mini | 3.8B | ~13–18 | 가장 스마트한 소형 모델 — 고사양 기본 선택 |
| Gemma 3 4B | 4B | ~10–13 | Phi-4 Mini를 사용할 수 없을 때 균형 선택 |
| Gemma 3 1B | 1B | ~35–45 | 구형 폰 (RAM 4GB) |
| SmolLM 2 | 1.7B | ~26–32 | 가장 빠른 토큰/초, 빠른 채팅 |
| Qwen3 | 1.7B | ~24–32 | 최고 다국어 (35개 이상 언어) |
| Llama 3.2 | 3B | ~16–22 | 최고의 만능 3B 선택, 도구 호출, RAG |
속도-품질 트레이드오프: 동일 칩에서 토큰/초는 파라미터 수에 반비례합니다. Microsoft 훈련 데이터 조합 덕분에 Phi-4 Mini (3.8B)의 추론 품질은 1.7B보다 7B 모델에 가깝습니다.
💡팁: iPhone 16 Pro의 토큰/초는 모든 모델에서 iPhone 17 Pro보다 약 15–25% 낮습니다. Galaxy S25 Ultra (Snapdragon 8 Elite)는 동일 Q4_K_M GGUF에서 iPhone 17 Pro보다 약 10–20% 낮습니다.
Phi-4 Mini: 가장 스마트한 소형 모델
Phi-4 Mini (파라미터 3.8B, Microsoft, 2024년 12월)는 최적화된 훈련 데이터 조합 덕분에 2026년 4B 미만 중 가장 스마트한 모델입니다. 비슷한 크기에도 불구하고 chain-of-thought 작업에서 Gemma 3 4B와 Llama 3.2 3B를 능가합니다. RAM 8GB 이상 모든 폰에서 기본 모델로 사용하십시오.
- 파라미터 및 훈련: 파라미터 3.8B; 고품질 웹 텍스트, 합성 추론 체인, 학술 콘텐츠로 구성된 Microsoft 큐레이션 조합으로 훈련됨. 아키텍처는 grouped-query attention을 갖춘 Transformer.
- 메모리 사용량: Q4_K_M에서 ~2.7 GB, Q5_K_M에서 ~3.5 GB. iPhone 16 Pro / 17 Pro (8 GB)와 Galaxy S25 Ultra (12 GB)에서 OS 여유 공간을 충분히 남기고 편안하게 구동됩니다.
- 속도 (토큰/초): iPhone 17 Pro ~13–18, iPhone 16 Pro ~10–15, Galaxy S25 Ultra ~10–15 (Termux+Ollama), iPhone 14 Pro ~6–10 (느리지만 작동 가능).
- 품질 강점: chain-of-thought 추론, 요약, 사실 기반 Q&A, 기본 코드 생성. 표준 벤치마크(MMLU, GSM8K)에서 비슷한 크기의 오픈소스 모델을 능가합니다.
- 품질 약점: Llama 3.2 3B보다 제한적인 세계 지식; Gemma 3 4B보다 짧은 자연스러운 창작 문체; 영어 외에서 Qwen3 1.7B보다 약한 다국어 성능.
- 최적 용도: 영어 채팅, 요약, 추론에서 최고의 단일 기본 모델을 원하는 고사양 폰 사용자.
💡팁: Phi-4 Mini는 단계별 추론을 명시적으로 요청하는 시스템 프롬프트의 이점을 받습니다. 훈련 데이터에 추론 체인이 많이 포함되어 있기 때문에 이러한 스타일의 지시를 사용하면 간결한 프롬프트보다 체계적으로 더 나은 응답이 나옵니다. 빠른 채팅에는 시스템 프롬프트가 필요하지 않습니다; 기본 동작이 이미 대화형입니다.
Gemma 3 4B: 균형 잡힌 선택
Gemma 3 4B (Google DeepMind, 2025)는 앱에서 Phi-4 Mini를 사용할 수 없거나 Google 훈련 데이터 조합을 선호할 때 균형 잡힌 기본 선택입니다. 동일 하드웨어에서 Phi-4 Mini보다 약간 느리지만 채팅과 요약에서 비슷한 성능을 보이며 더 넓은 자연어 범위를 갖습니다.
- 파라미터 및 훈련: 파라미터 4B; Google 큐레이션 웹 텍스트, 코드, 다국어 데이터 조합으로 훈련됨. 확장된 컨텍스트를 갖춘 Gemma 2와 같은 계열 아키텍처.
- 메모리 사용량: Q4_K_M에서 ~2.9 GB, Q5_K_M에서 ~3.7 GB. 8GB 이상 폰에 적합; 6GB 폰에서는 빠듯합니다.
- 속도 (토큰/초): iPhone 17 Pro ~10–13, iPhone 16 Pro ~7–10, Galaxy S25 Ultra ~7–10.
- 품질 강점: 자연스러운 대화 톤, 탄탄한 요약, Phi-4 Mini보다 넓은 세계 지식, 무난한 다국어 성능.
- 품질 약점: Phi-4 Mini보다 약한 chain-of-thought 추론; 동일 하드웨어에서 더 느린 토큰/초.
- 최적 용도: 일상 채팅, 요약, 단문 작성에서 Phi-4 Mini 대안으로 Google 훈련 모델을 원하는 고사양 사용자.
💡팁: Gemma 3 4B는 Phi-4 Mini와 다른 채팅 템플릿을 사용합니다 — 앱이 올바른 Gemma 템플릿(<start_of_turn> 마커 포함)을 사용하는지 확인하십시오. 잘못된 템플릿은 깨지거나 반복되는 출력을 생성합니다. PocketPal AI, MLC Chat, LM Studio는 자동으로 감지합니다; LLM Farm은 수동으로 선택해야 합니다.
Gemma 3 1B: 구형 폰용 경량 선택
Gemma 3 1B (Google DeepMind, 2025)는 2026년 가장 작은 실용적인 모바일 모델입니다 — Q4_K_M에서 ~720 MB이며 4GB 폰에서 구동됩니다. 품질은 짧고 일관된 응답(1–2문단)으로 제한되지만, 약한 하드웨어에서 실용적인 출력을 생성하는 1GB 미만 유일한 모델입니다.
- 파라미터 및 훈련: 파라미터 1B; 4B 모델과 같은 Gemma 3 계열 아키텍처. 엣지 기기에서의 효율적인 추론을 위해 훈련됨.
- 메모리 사용량: Q4_K_M에서 ~720 MB, Q5_K_M에서 ~900 MB. iPhone SE 3세대, iPhone 12/13, 구형 Android(최소 RAM 4GB)에서 작동합니다.
- 속도 (토큰/초): iPhone 17 Pro ~35–45, iPhone 16 Pro ~28–38, iPhone 14 ~20–28, 구형 Android (4 GB) ~10–15. 이 그룹에서 모든 기기에서 가장 빠른 모델.
- 품질 강점: 속도, 낮은 메모리 사용량, 짧고 일관된 응답, 낮은 배터리 소모.
- 품질 약점: 약한 다단계 추론, 특정 주제에서 빈번한 사실 오류, 긴 생성에서 반복, 얕은 대화 깊이.
- 최적 용도: RAM 6GB 임계값 이하 폰에서도 온디바이스 AI를 원하는 사용자, 또는 배터리 수명을 최적화하는 사용자.
💡팁: Gemma 3 1B는 짧고 집중된 작업에 사용하십시오 — 한 문장 요약, 한 문단 초안, 빠른 정의, 간단한 번역. 여러 문단 설명, 다단계 추론, 특정 사실의 정확도가 중요한 것은 피하십시오.
SmolLM 2 1.7B: 초당 토큰 수 최고
SmolLM 2 1.7B (Hugging Face, 2024)는 모든 기준 폰에서 이 그룹 내 초당 토큰 수가 가장 빠른 모바일 모델입니다. iPhone 17 Pro에서 ~26–32 토큰/초, Galaxy S25 Ultra에서 ~20–28 토큰/초. 응답 깊이보다 속도가 중요할 때 최적입니다.
- 파라미터 및 훈련: 파라미터 1.7B; 소형 모델 효율성에 최적화된 Hugging Face 큐레이션 조합으로 훈련됨. 소비자 하드웨어에서의 저지연 추론을 위해 조정됨.
- 메모리 사용량: Q4_K_M에서 ~1.1 GB. OS를 위한 충분한 여유 공간을 남기며 RAM 6GB 이상 모든 폰에 적합합니다.
- 속도 (토큰/초): iPhone 17 Pro ~26–32, iPhone 16 Pro ~22–28, Galaxy S25 Ultra ~20–28, iPhone 14 Pro ~15–22. 동일 칩에서 Phi-4 Mini보다 약 2배 빠릅니다.
- 품질 강점: 빠른 대화 응답, 간단한 Q&A, 자동완성 스타일 지속, 영어 작성.
- 품질 약점: Phi-4 Mini보다 약한 추론, Llama 3.2 3B보다 제한적인 세계 지식, Qwen3 1.7B보다 약한 다국어 성능.
- 최적 용도: 지연 시간이 중요한 중급 폰(텍스트 자동완성, 음성 어시스턴트 턴, 실시간 채팅).
💡팁: SmolLM 2 1.7B는 모바일 오프라인 음성 어시스턴트에 가장 적합한 조합입니다. 높은 토큰/초는 중급 하드웨어에서도 음성 응답 시간을 ~1.5초 지각 임계값 이하로 유지합니다.
Qwen3 1.7B: 최고의 모바일 다국어 모델
Qwen3 1.7B (Alibaba, 2024)는 2026년 최고의 모바일 다국어 모델입니다 — 중국어, 일본어, 한국어, 아랍어, 독일어, 프랑스어, 스페인어, 러시아어를 포함한 35개 이상 언어로 훈련되었습니다. 번역, 영어 외 언어 채팅, 대화 중간에 언어를 전환하는 여행 시 사용에 최적입니다.
- 파라미터 및 훈련: 파라미터 1.7B; CJK 언어, 아랍어, 주요 유럽 언어가 강력하게 대표되는 Alibaba 다국어 코퍼스로 훈련됨. 다국어 추론에 최적화된 아키텍처.
- 메모리 사용량: Q4_K_M에서 ~1.1 GB. RAM 6GB 이상 모든 폰에 적합합니다.
- 속도 (토큰/초): iPhone 17 Pro ~24–32, iPhone 16 Pro ~20–28, Galaxy S25 Ultra ~18–26, iPhone 14 Pro ~14–20. SmolLM 2와 비슷한 속도.
- 품질 강점: 35개 이상 언어에서 네이티브 수준 출력, 주요 언어 쌍 간 강력한 번역, 일관된 CJK 출력.
- 품질 약점: 영어만 사용 시 Phi-4 Mini보다 약간 약한 추론, Gemma 3 4B보다 짧은 자연스러운 창작 문체, Llama 3.2 3B보다 약한 도구 호출.
- 최적 용도: 비영어권 사용자(특히 중국어, 일본어, 독일어, 스페인어, 프랑스어 사용자), 오프라인 번역이 필요한 여행자, 모바일 다국어 기능을 개발하는 개발자.
💡팁: 특정 두 언어 쌍 간의 번역에서 Qwen3 1.7B는 번역을 부차 작업으로 실행하는 더 큰 영어 중심 모델을 종종 능가합니다. 한국어로 채팅하는 사용자의 경우 Qwen 3는 60% 더 작음에도 Phi-4 Mini보다 현저히 자연스러운 출력을 생성합니다.
Llama 3.2 3B: 믿을 만한 만능 3B 모델
Llama 3.2 3B (Meta, 2024)는 2026년 가장 폭넓게 지원되는 3B 모델입니다 — 더 넓은 앱 호환성, 6종 중 최고의 도구 호출 지원, 가장 큰 커뮤니티 파인튜닝 생태계. 순수 품질에서는 Phi-4 Mini에 약간 뒤지지만 엣지 케이스에서 더 안정적이고 모바일 앱 지원이 더 우수합니다.
- 파라미터 및 훈련: 파라미터 3B; 채팅 및 도구 사용을 위한 instruction-tuning이 적용된 Meta 대규모 사전훈련 코퍼스로 훈련됨. 8B 및 70B 모델과 같은 Llama 3 아키텍처.
- 메모리 사용량: Q4_K_M에서 ~2.2 GB, Q5_K_M에서 ~2.8 GB. 8GB 이상 폰에서 편안한 여유 공간을 남기며 구동.
- 속도 (토큰/초): iPhone 17 Pro ~16–22, iPhone 16 Pro ~12–18, Galaxy S25 Ultra ~12–18, iPhone 14 Pro ~7–11.
- 품질 강점: 넓은 세계 지식, 강력한 도구 호출 및 함수 호출 지원(4B 미만 모델 중 최고), 안정적인 채팅 동작, 성숙한 파인튜닝 생태계.
- 품질 약점: Phi-4 Mini보다 약한 chain-of-thought 추론, 비슷한 크기에서 약간 낮은 MMLU 점수, Gemma 3 4B보다 덜 자연스러운 대화 톤.
- 최적 용도: 도구 호출 또는 함수 호출이 필요한 모바일 앱(로컬 문서에 대한 RAG, 온디바이스 에이전트 워크플로우).
💡팁: Llama 3.2 3B는 이 그룹에서 온디바이스 에이전트 워크플로우에 충분히 안정적인 도구 호출 지원을 갖춘 유일한 모델입니다. Phi-4 Mini와 SmolLM 2도 기술적으로 도구 호출이 가능하지만 2026년 프로덕션 준비가 된 것은 Llama 3.2 3B뿐입니다.
SmolLM 3와 Gemma 3n: 새로운 소형 모델
SmolLM 3 (Hugging Face, 2025년 7월)와 Gemma 3n (Google)은 독자들이 가장 자주 묻는 두 가지 최신 소형 모델입니다. 두 모델 모두 게시 시점에 검증된 온디바이스 토큰/초 수치가 없어 위 6종 속도 비교에는 포함하지 않았습니다. 이 페이지의 마지막 업데이트 시점 기준으로 SmolLM 4는 없습니다. Hugging Face가 공개하지 않았으며, SmolLM 3가 SmolLM 계열의 최신 세대였습니다.
- SmolLM 3 (3B): 약 11조 토큰으로 훈련된 3B 파라미터 모델로, 사고(thinking) 모드와 비사고 모드를 지원합니다. 64k 컨텍스트로 훈련되었고, 추론 시 YaRN 외삽을 통해 최대 128k까지 처리할 수 있습니다. 공식 지원 언어는 영어, 프랑스어, 스페인어, 독일어, 이탈리아어, 포르투갈어입니다. Hugging Face는 베이스 모델 벤치마크에서 더 큰 Qwen3 4B 및 Gemma 3 4B와 경쟁력 있는 수준이라고 밝히면서, 전반적으로는 Qwen3 4B가 가장 높은 점수를 받는다고 설명합니다.
- 폰에서의 SmolLM 3: 3B 파라미터이므로 Llama 3.2 3B와 같은 크기급에 속합니다. Q4_K_M 파일은 약 2 GB, 등급별 표의 RAM 8GB 구간으로 예상하십시오. 이는 실측이 아니라 파라미터 수에서 추정한 값입니다.
- Gemma 3n (E2B와 E4B): “E”는 effective(유효) 파라미터를 뜻합니다. E2B는 원시 파라미터 50억 개 이상을 로드하지만, 파라미터 건너뛰기와 레이어별 임베딩 캐싱을 통해 메모리 부하를 20억 개 미만(1.91B)으로 줄여 구동할 수 있습니다. Gemma 3n은 텍스트, 이미지, 오디오 입력을 받고, 140개 이상 언어로 훈련되었으며, 컨텍스트 윈도우는 32K 토큰입니다.
- 어느 것을 선택할까: 영어나 주요 유럽 언어용 사고 모드 3B 모델을 원하면 SmolLM 3를, 앱이 이미지나 오디오 입력을 지원하면 Gemma 3n을 선택하십시오. 그렇지 않다면 위의 6종이 여전히 안정적인 기본 선택입니다.
💡팁: 새로운 소형 모델은 속도보다 RAM을 먼저 보고 판단하십시오. Q4_K_M 파일 크기를 확인하고 등급별 표와 대조한 다음에 벤치마크 주장을 읽으십시오. 앱 지원은 모델 출시보다 늦기도 합니다 — 앱의 큐레이션 목록에 모델이 없다면 Hugging Face에서 GGUF를 직접 설치(sideload)하십시오.
모바일 양자화: Q4_K_M 표준
Q4_K_M은 2026년 모바일 LLM 추론의 표준 양자화 방식입니다 — 파일 크기를 1/4로 줄이면서 원본 모델 품질의 ~95%를 유지합니다. Q5_K_M이나 Q6_K는 추가 메모리 여유가 실제로 있는 RAM 12GB 이상 폰에서만 사용하십시오.
📍 한 문장으로
Q4_K_M이 모바일 표준입니다 — 크기의 1/4로 품질 ~95% 유지. Q5_K_M / Q6_K는 RAM 12GB 이상 폰에서만 가치 있습니다.
💬 쉽게 말하면
Hugging Face의 모델은 전체 정밀도로 게시됩니다(각 파라미터는 16비트 숫자로 저장됨). 스마트폰에서는 각 파라미터가 4비트로 압축된 양자화 버전을 다운로드합니다 — 파일을 4배 작게 만들고 추론을 약 4배 빠르게 하며 품질 손실은 작습니다. Q4_K_M은 2026년 스마트폰에 올바른 균형으로 합의된 변형입니다. 더 높은 Q 숫자는 압축이 적고 품질이 더 좋지만 파일이 더 큽니다.
- Q4_K_M (권장 표준): K-퀀트와 혼합 정밀도 "M"을 갖춘 4비트 양자화. 원본 품질의 ~95%. 2026년 모바일 표준. 6종 모두 Hugging Face에서 이 형식으로 제공됩니다.
- Q5_K_M (RAM 12GB 이상 폰용): 5비트 양자화. 원본 품질의 ~98%. 파일 크기 ~25% 증가. iPhone 17 Pro Max (12 GB) 또는 Galaxy S25 Ultra (12 GB)에서 Phi-4 Mini와 Llama 3.2 3B에 가치 있음.
- Q6_K (드물게 필요): 6비트 양자화. 원본 품질의 ~99%. 파일 크기 ~50% 증가. 품질의 모든 퍼센트 포인트가 중요한 경우에만 사용.
- Q8_0 (모바일에서 피할 것): 8비트 양자화. Q4_K_M의 약 2배 크기. 폰에서 RAM 비용이 정당화되지 않음; 데스크톱/노트북용.
- Q3_K_M / Q2_K (매우 제한된 폰에서만): 품질이 ~85–90%로 떨어집니다. Q4_K_M에서도 Gemma 3 1B가 맞지 않는 경우에만 사용하십시오.

⚠️경고: 어느 것이 더 나은지 테스트하기 위해 같은 모델의 여러 양자화 변형을 다운로드하지 마십시오. Q4_K_M과 Q5_K_M의 품질 차이는 실재하지만 작으며, 중복 변형으로 5GB 이상의 공간을 낭비하게 됩니다. Q4_K_M을 선택하고 일주일간 실제 사용 후 필요한 경우에만 업그레이드하십시오.
모델 다운로드 크기 (MB)
Q4_K_M 기준으로 6종의 크기는 ~720 MB(Gemma 3 1B)부터 ~2,900 MB(Gemma 3 4B)까지입니다. 추론 오버헤드로 파일 크기에 더해 RAM을 약 500 MB 더 잡고, 보관할 3B–4B 모델 하나당 최소 3 GB의 여유 저장 공간을 확보하십시오.
📍 한 문장으로
Q4_K_M 파일 크기: Gemma 3 1B ~720 MB, Qwen3 1.7B와 SmolLM 2 ~1,100 MB, Llama 3.2 3B ~2,200 MB, Phi-4 Mini ~2,700 MB, Gemma 3 4B ~2,900 MB.
💬 쉽게 말하면
다운로드하는 파일 크기는 모델이 실행되는 동안 차지하는 RAM 용량과 대략 같고, 거기에 약간의 오버헤드가 더해집니다. 그래서 폰과 비교해야 할 숫자는 파라미터 수가 아니라 파일 크기입니다. 모델과 운영체제가 RAM에 함께 들어가지 않으면 폰이 답변 도중에 앱을 종료합니다.
모델 | Q4_K_M 크기 (MB) | 최소 폰 RAM | 크기 대비 품질 메모 |
|---|---|---|---|
| Gemma 3 1B | ~720 | 4 GB | 실용 가능한 가장 작은 모델; 짧은 답변 전용 |
| Qwen3 1.7B | ~1,100 | 6 GB | MB당 다국어 출력이 가장 우수 |
| SmolLM 2 1.7B | ~1,100 | 6 GB | MB당 속도가 가장 빠름; 가벼운 추론 |
| Llama 3.2 3B | ~2,200 | 8 GB (6 GB는 빠듯함) | 4B 모델보다 작음; 도구 호출이 가장 우수 |
| Phi-4 Mini | ~2,700 | 8 GB | 파라미터당 추론 능력이 가장 강함 |
| Gemma 3 4B | ~2,900 | 8 GB | 가장 큰 파일; 자연스러운 요약; 이미지 입력 가능 |
바이트당 정확도에 대하여: 이 글은 자체 정확도 벤치마크를 제시하지 않으므로 마지막 열은 정성적 가이드로 활용하십시오. 오프라인 요약에는 1.1 GB급 모델(Qwen3 1.7B, SmolLM 2)이 효율적인 중간 선택이며, 2.7 GB를 쓸 수 있다면 Phi-4 Mini가 품질의 상한선입니다.
등급별 판정: 고사양 vs 중급 vs 보급형
폰 등급이 모델 한계를 결정합니다 — 브랜드보다 칩 세대와 RAM이 더 중요합니다. 고사양 폰(RAM 8GB 이상, A18 Pro / A19 Pro / Snapdragon 8 Elite)은 3.8B–4B 모델을 편안하게 실행합니다; 중급(RAM 6–8GB)은 1.7B–3B; 보급형 또는 구형(RAM 4–6GB)은 1B–1.7B를 실행합니다.
📍 한 문장으로
고사양 (8GB 이상) → Phi-4 Mini 3.8B; 중급 (6–8GB) → SmolLM 2 1.7B 또는 Llama 3.2 3B; 보급형 또는 구형 (4–6GB) → Gemma 3 1B 또는 Qwen3 1.7B.
💬 쉽게 말하면
열망이 아닌 폰에 맞는 모델을 선택하십시오. 6GB 폰에서의 3.8B 모델은 좌절스러운 지연과 강제 종료를 일으킵니다. 고사양 기기에서 1B 모델은 가용 용량을 낭비합니다. OS와 다른 앱 하나가 열린 상태에서 폰이 편안하게 실행할 수 있는 가장 큰 모델을 선택하십시오.
폰 등급 | 예시 | 권장 모델 | 이유 |
|---|---|---|---|
| 고사양 (8–12 GB RAM) | iPhone 17 Pro / Pro Max, iPhone 16 Pro, Galaxy S25 Ultra, OnePlus 13 | Phi-4 Mini (3.8B Q4_K_M) | 칩이 실용적인 속도로 지원하는 가장 스마트한 모델 |
| 구형 고사양 (8 GB RAM) | iPhone 15 Pro, Galaxy S24 Ultra, Pixel 9 Pro | Llama 3.2 3B 또는 Phi-4 Mini | 도구 호출에는 Llama 3.2 3B; 순수 품질에는 Phi-4 Mini |
| 중급 (6–8 GB RAM) | iPhone 14 Pro, Pixel 9, Snapdragon 8 Gen 2 폰 | SmolLM 2 1.7B 또는 Qwen3 1.7B | 빠른 속도; OS를 위한 여유 공간 확보 |
| 보급형 / 구형 (4–6 GB RAM) | iPhone 14, Snapdragon 7 시리즈 중급, 구형 Android | Gemma 3 1B 또는 Qwen3 1.7B | 일관된 출력을 생성하는 가장 작은 실용 모델 |
| 매우 구형 (4 GB RAM) | iPhone SE 3세대, 구형 4GB Android | Gemma 3 1B | 맞는 유일한 모델; 제한적인 추론, 빠른 토큰/초 |
| 지원 불가 (4GB 미만) | iPhone SE 2세대, 구형 Android | 홈 PC에 원격 연결 | 온디바이스 LLM은 실용적이지 않음; 홈 Ollama 서버의 인터페이스로 태블릿/폰 사용 |

💡팁: 앱 부분에 대해서는 iPhone 및 Android 가이드를 참조하십시오. 앱 가용성이 모델 가용성보다 늦을 때가 있습니다. 앱의 큐레이션 목록에 모델이 없다면 대개 Hugging Face에서 GGUF로 로드할 수 있습니다.
로컬 LLM 실행에 적합한 폰
로컬 AI에 가장 좋은 폰은 RAM이 가장 많고 최신 플래그십 칩을 탑재한 폰입니다. 이 글의 참고용 수치에서는 iPhone 17 Pro (A19 Pro)가 가장 빠르고, 같은 Q4_K_M 파일 기준으로 Galaxy S25 Ultra (Snapdragon 8 Elite)는 약 10–20% 느립니다. RAM이 구동 가능한 모델을 결정하고, 칩이 실행 속도를 결정합니다.
📍 한 문장으로
3B–4B 모델에는 RAM 8GB 이상, Q5_K_M에는 12GB 폰을 고르십시오 — 이 글에서 사용한 폰은 iPhone 17 Pro / 17 Pro Max, iPhone 16 Pro, Galaxy S25 Ultra, OnePlus 13입니다.
💬 쉽게 말하면
무엇보다 먼저 폰의 RAM을 확인하십시오. RAM이 실행할 수 있는 가장 큰 모델을 정합니다. 칩 세대는 두 번째 요소이며 속도를 좌우합니다. 로컬 AI를 위해 새 폰을 살 필요는 없습니다. 이미 가진 폰에서도 1B–1.7B 모델은 전속력으로 돌아가며, 최신 플래그십이 필요한 것은 3B–4B 모델뿐입니다.
- RAM이 먼저: 4GB는 Gemma 3 1B만, 6GB는 1.7B 모델, 8GB는 3B–4B 모델을 실행합니다. 12GB(iPhone 17 Pro Max, Galaxy S25 Ultra)는 Q5_K_M까지 여유를 더해 줍니다. 일부 Android 모델은 RAM 사양이 여러 가지로 출시되므로, 폰의 사양표에서 RAM을 확인하십시오.
- 칩은 두 번째: 이 글의 속도 수치는 A19 Pro와 A18 Pro(iPhone), Snapdragon 8 Elite(Android 플래그십) 칩 기준입니다. 이전 세대 플래그십 칩도 같은 모델을 실행하지만 더 느릴 뿐입니다 — iPhone 14 Pro에서 Phi-4 Mini는 ~6–10 토큰/초로 구동됩니다.
- iPhone vs Android: 동일한 Q4_K_M 파일 기준으로 이 글의 수치에서는 iPhone이 10–20% 더 빠릅니다. 주된 이유는 MLC Chat이 Apple Metal을 활용하는 것과 달리, Android의 Termux+Ollama는 CPU만으로 구동되어 Snapdragon NPU를 사용하지 않기 때문입니다. 더 나은 Android 런타임이 이 격차를 줄이며, 하드웨어가 한계는 아닙니다.
- 발열과 배터리: 장시간 생성하면 칩에 부하가 계속 걸리고, 폰은 뜨거워지면 클럭 속도를 낮추기 때문에 긴 세션에서는 토큰/초가 떨어집니다. 이 글에는 스로틀링을 실측한 수치가 없습니다. 실용적인 대처법은 더 작은 모델을 쓰는 것(Gemma 3 1B는 응답당 2–3배 더 많은 에너지를 쓰는 3B–4B 모델보다 전력 소모가 훨씬 적음), 출력을 짧게 하는 것, 모델을 돌리는 동안 충전하지 않는 것입니다.
- 저장 공간: 3B–4B 모델은 각각 2.2–2.9 GB를 차지합니다. 변형 모델을 모아 두기보다 한두 개만 설치할 여유를 확보하십시오.
💡팁: 중급 Android 폰(Samsung Galaxy A 시리즈 등)을 쓰고 있습니까? 사용 중인 정확한 모델의 RAM 사양을 찾은 다음 등급별 표를 따르십시오: 8GB는 SmolLM 2 1.7B 또는 Llama 3.2 3B, 6GB는 1.7B 모델, 4GB는 Gemma 3 1B를 실행합니다. 칩보다 RAM 수치가 더 중요합니다.
폰에서의 멀티모달: 이미지 캡션과 대체 텍스트
핵심 6종 중 이미지를 입력받는 모델은 Gemma 3 4B뿐입니다. Gemma 3 1B, Phi-4 Mini, Llama 3.2 3B, Qwen3 1.7B, SmolLM 2는 텍스트 전용입니다. Google은 Gemma 3의 4B, 12B, 27B 모델을 비전 지원 모델로 명시하고 있습니다. Gemma 3n (E2B / E4B)은 이미지와 오디오 입력을 추가로 지원하며, Hugging Face의 SmolVLM2 계열(256M, 500M, 2.2B 파라미터)은 처음부터 비전과 영상을 위해 만들어졌습니다.
- 플래그십 폰에서 이미지 캡션용 최고 선택: Gemma 3 4B (Q4_K_M에서 ~2.9 GB, RAM 8GB 이상). 6종 중 사진을 읽고 캡션이나 대체 텍스트를 쓸 수 있는 유일한 모델입니다.
- 보급형 또는 CPU 전용 Android: SmolVLM2 256M 또는 500M은 Hugging Face 계열에서 가장 작은 비전 모델이며, 약한 하드웨어에서 현실적인 출발점입니다. 이 글에는 이 모델들의 검증된 속도 수치가 없습니다.
- 실제 한계는 앱 지원입니다: llama.cpp 기반 앱에서 이미지 입력을 쓰려면 모델 옆에 별도의 비전 프로젝터 파일이 필요합니다. 앱이 해당 모델의 이미지 입력을 지원하지 않으면, 비전 지원 모델도 텍스트로만 대화합니다. 다운로드하기 전에 앱을 확인하십시오.
- 대체 텍스트 작업 흐름: 보이는 내용을 한두 문장으로 평이하게 설명해 달라고 요청한 다음, 게시하기 전에 결과를 직접 읽어 보십시오. 소형 비전 모델은 이미지 속 글자를 잘못 읽거나 사람과 사물을 잘못 분류할 수 있으므로, 접근성이나 소셜 게시물용 결과물은 반드시 사람이 확인하십시오.
- 지연 시간 기대치: 이미지 인코딩 전의 토큰 생성만으로도 Phi-4 Mini는 토큰당 ~55–77 ms (13–18 토큰/초), Gemma 3 1B는 토큰당 ~22–29 ms (35–45 토큰/초)가 걸립니다. 따라서 폰에서 캡션 생성 시 100 ms 미만의 종단 간 응답은 현실적인 목표가 아닙니다.
💡팁: 작은 글자가 가득한 문서, 영수증, 스크린샷에는 클라우드 모델이나 데스크톱 비전 모델을 사용하십시오. 온디바이스 캡션 생성은 가끔 틀려도 수정 비용이 적은 사진의 짧은 설명에 가장 적합합니다.
흔한 실수
- 폰 RAM이 허용하는 것보다 큰 모델 선택. 6GB 폰에서 Phi-4 Mini는 3–5 토큰/초로 구동되며 강제 종료됩니다. 모델을 등급에 맞추십시오.
- 같은 모델의 여러 양자화 변형 다운로드. Q4_K_M을 선택하고 거기서 멈추십시오. 일상 채팅에서 품질 차이는 인지되지 않습니다.
- 다단계 추론에 SmolLM 2 1.7B 사용. 가장 빠른 모델이지만 가장 스마트한 모델이 아닙니다. 복잡한 추론에는 Phi-4 Mini를 사용하십시오. 품질 없는 속도는 그냥 더 빠른 오답일 뿐입니다.
- 다국어 프리픽스 없이 Phi-4 Mini에 다른 언어 출력 요청. CJK나 아랍어에서 불균일한 출력을 생성합니다. 다국어 사용 시 Qwen3 1.7B를 함께 설치하고 언어에 따라 전환하십시오.
- 이 모델들에서 클라우드 AI 수준의 품질 기대. 채팅 작업에서 GPT-5.5 용량의 약 60–80%입니다. 잘하는 것(비공개 채팅, 요약, 작성, 번역)에 사용하고 70B 이상이 필요한 것에는 클라우드를 사용하십시오.
- Phi-4 Mini (3.8B)를 구형 Phi-3 Mini (3.8B)와 혼동. 파라미터 수는 같지만 훈련 데이터와 채팅 템플릿이 다릅니다. GGUF 파일 이름에서 모델 식별자를 항상 확인하십시오.
출처
- Phi-4 Mini 기술 보고서 — Microsoft Research (2024년 12월).
- Gemma 3 기술 보고서 — Google DeepMind (2025).
- SmolLM 2 모델 카드 — Hugging Face (2024).
- Qwen3 기술 보고서 — Alibaba Cloud (2024).
- Llama 3.2 모델 카드 — Meta AI (2024).
- SmolLM3 발표 — Hugging Face blog (2025년 7월).
- Gemma 3n 모델 개요 — Google AI for Developers.
- Gemma 3 비전 지원 (4B, 12B, 27B) — Google blog.
- SmolLM 및 SmolVLM2 모델 계열 — Hugging Face TB organization.
- Q4_K_M 양자화 참조 — llama.cpp 문서.
자주 묻는 질문
iPhone에서 가장 빠른 모바일 모델은 무엇입니까?
Gemma 3 1B는 iPhone 17 Pro에서 ~35–45 토큰/초로 절대적으로 가장 빠릅니다. 1.7B 모델 중에서는 SmolLM 2 1.7B가 ~26–32 토큰/초로 가장 빠릅니다. 고품질 출력을 생성하는 모델 중에서는 Phi-4 Mini가 ~13–18 토큰/초로 가장 빠른 "스마트" 선택입니다.
Gemma 3 2B나 Gemma 3 7B 모델이 있나요?
아니요. Gemma 3는 공식적으로 270M, 1B, 4B, 12B, 27B의 다섯 가지 크기로만 출시되었습니다 — Gemma 3 2B나 Gemma 3 7B는 존재하지 않습니다. 이런 혼동은 보통 Gemma 2에서 비롯되는데, Gemma 2에는 실제로 2B 모델(Google DeepMind, 2024년 7월)이 9B, 27B와 함께 존재했습니다. "Gemma 3 2B"에 가장 가까운 것을 찾는다면, 실제로 존재하는 두 옵션은 Gemma 3 1B(더 작고 빠름)와 Gemma 3 4B(더 크고 똑똑함)이며, 둘 다 이 글에서 비교합니다. 2026년 4월에는 Google이 Gemma 4도 출시했는데, 다른 크기 라인업(Effective 2B, Effective 4B, 그리고 26B MoE 및 31B dense 변형)을 갖추고 있습니다. Gemma 4는 Gemma 3와는 별개의 모델 계열이며, 이번 업데이트 시점에는 실기기 tokens/sec 검증 수치가 없어 이 모바일 속도 비교에는 아직 포함되지 않았습니다.
이 모델들은 GPU가 필요한가요, 아니면 CPU만으로 동작하나요?
여섯 모델 모두 전용 GPU 없이 동작합니다. iPhone에서는 MLC Chat이 Apple의 Metal API를 사용해 Neural Engine/GPU에서 추론을 가속하지만, PocketPal AI와 LLM Farm(llama.cpp)은 주로 CPU에서 동작합니다. Android에서는 Termux+Ollama가 현재 CPU만으로 동작하며 — 아직 Snapdragon Hexagon NPU를 활용하지 않기 때문에, 동일한 Q4_K_M 파일 기준으로 Android의 tokens/sec가 iPhone보다 약 10~20% 낮습니다(위 비교 표 참고). 실제로 Galaxy S25 Ultra에서 Phi-4 Mini는 CPU만으로 약 10~15 tokens/sec로 동작하며, 이 목록의 어떤 모델도 사용 가능한 출력을 내기 위해 전용 GPU가 필요하지 않습니다.
Phi-4 Mini가 정말 폰에서 7B 모델을 능가합니까?
구형 7B 모델보다는 표준 벤치마크에서 능가합니다. 최신 7B 모델보다는 원시 용량에서 여전히 뒤집니다. Phi-4 Mini가 크기 이상의 성능을 내는 이유는 Microsoft의 훈련 데이터 조합입니다. 폰에서 7B 모델은 어차피 실용적이지 않을 정도로 느리기 때문에 Phi-4 Mini가 기본적으로 승리합니다.
SmolLM 2가 4년 된 폰에서 구동됩니까?
네, 대부분의 4년 된 고사양 폰에서 구동됩니다. Q4_K_M의 SmolLM 2 1.7B는 모델에 ~1.1 GB RAM이 필요합니다 — iPhone 13 (6 GB), iPhone 12 Pro Max (6 GB), 동급 Android (6 GB 이상)에 맞습니다. 2021년 4GB 폰에서는 불안정합니다; 대신 Gemma 3 1B를 사용하십시오.
모바일에서 번역에 가장 적합한 모델은 무엇입니까?
중국어, 일본어, 한국어, 아랍어, 독일어, 프랑스어, 스페인어 또는 러시아어가 포함된 모든 언어 쌍에는 Qwen3 1.7B. 유럽 언어 쌍만의 경우 Gemma 3 4B가 두 번째 선택입니다. 일회성 번역에는 설치된 번역 앱이 종종 로컬 LLM보다 낫습니다 — 로컬 모델은 같은 대화에서 번역과 채팅을 결합해야 할 때 빛납니다.
잘 사용하려면 고사양 폰이 필요합니까?
아니요, 더 큰 모델에만 해당됩니다. RAM 6–8GB의 중급 폰은 SmolLM 2 1.7B와 Qwen3 1.7B를 전속력으로 실행합니다(~20–28 토큰/초). RAM 4–6GB의 보급형 폰은 Gemma 3 1B를 ~15–25 토큰/초로 실행합니다.
배터리를 가장 적게 소모하는 모델은 무엇입니까?
Gemma 3 1B가 압도적으로 적습니다. SmolLM 2 1.7B와 Qwen3 1.7B가 그 뒤를 따릅니다. 3B–4B 모델은 응답당 2–3배 더 많은 에너지를 소비합니다. 배터리가 가장 중요하다면 Gemma 3 1B가 올바른 선택입니다.
모바일 모델이 다회전 대화를 처리할 수 있습니까?
네, 짧은 대화(5–10 턴)에는 가능하며 이후 품질이 저하됩니다. 6종 모두 4,000–8,000 토큰의 컨텍스트 윈도우를 가지고 있습니다. 대부분의 모바일 앱(PocketPal AI, Private LLM)이 대화 요약을 자동으로 수행합니다.
이 모델들이 음성 입력과 함께 작동합니까?
네, Whisper 음성-텍스트 레이어와 결합할 때 작동합니다. 2026년 모바일 오프라인 음성 표준 스택은: Whisper (small 또는 tiny 모델) 음성-텍스트 → Phi-4 Mini 또는 SmolLM 2 응답 생성 → Apple TTS 또는 Android TTS 음성 합성. SmolLM 2 1.7B는 높은 토큰/초로 음성 턴을 ~1.5초 임계값 이하로 유지하기 때문에 음성용 LLM으로 최고 선택입니다.
여행 시 오프라인 사용에 가장 좋은 모델은 무엇입니까?
언어를 전환하고 번역이 필요한 여행에는 Qwen3 1.7B. 영어 참조가 주로 필요한 여행에는 고사양 폰에서 Phi-4 Mini, 중급 폰에서 SmolLM 2 1.7B. 여행은 로컬 AI의 가장 강력한 사용 사례입니다 — 로밍 데이터가 필요 없고, 클라우드 API 비용이 없습니다.
로컬 LLM을 돌리기에 가장 좋은 폰은 무엇입니까?
RAM이 가장 많고 최신 플래그십 칩을 탑재한 폰입니다. 이 글의 참고용 수치에서는 iPhone 17 Pro (A19 Pro)가 가장 빠르고, 같은 Q4_K_M 파일 기준으로 Galaxy S25 Ultra (Snapdragon 8 Elite)는 약 10–20% 느립니다. Phi-4 Mini 같은 3B–4B 모델에는 RAM 8GB 이상이 필요하며, RAM 12GB(iPhone 17 Pro Max, Galaxy S25 Ultra)는 Q5_K_M까지 여유를 더해 줍니다. 이미 RAM 6GB 폰을 갖고 있다면 1.7B 모델을 전속력으로 실행할 수 있으니, 로컬 AI만을 위해 새 폰을 살 필요는 없습니다.
로컬 LLM을 돌리면 폰이 과열됩니까?
장시간 생성하면 칩에 높은 부하가 계속 걸리므로 폰이 따뜻해지고 클럭 속도가 낮아질 수 있으며, 그 결과 긴 세션에서 토큰/초가 떨어집니다. 이 글에는 스로틀링을 실측한 수치가 없습니다. 온도를 낮추려면 더 작은 모델을 쓰고(Gemma 3 1B는 응답당 2–3배 더 많은 전력을 쓰는 3B–4B 모델보다 전력 소모가 훨씬 적음), 답변을 짧게 유지하고, 모델을 돌리는 동안에는 충전하지 마십시오.
중급 Samsung Galaxy나 다른 Android 폰에서도 이 모델들을 돌릴 수 있습니까?
RAM이 충분하다면 가능합니다. 사용 중인 정확한 모델의 RAM 사양을 찾아 맞춰 보십시오: 8GB는 SmolLM 2 1.7B 또는 Llama 3.2 3B, 6GB는 Qwen3 1.7B 또는 SmolLM 2 1.7B, 4GB는 Gemma 3 1B만 실행합니다. 칩보다 RAM이 더 중요하며, 칩은 주로 속도를 바꿉니다. 이 글의 수치에서 Android의 토큰/초는 같은 파일 기준으로 iPhone보다 약 10–20% 낮습니다.
이 모델들은 용량이 몇 메가바이트입니까?
Q4_K_M 기준으로 Gemma 3 1B ~720 MB, Qwen3 1.7B ~1,100 MB, SmolLM 2 1.7B ~1,100 MB, Llama 3.2 3B ~2,200 MB, Phi-4 Mini ~2,700 MB, Gemma 3 4B ~2,900 MB입니다. 파일 크기는 모델이 실행되는 동안 차지하는 RAM과 대략 같고, 거기에 추론 오버헤드 약 500 MB가 더해집니다. Q5_K_M 파일은 약 25% 더 큽니다.
SmolLM 3나 SmolLM 4가 있습니까?
SmolLM 3는 존재합니다. Hugging Face가 2025년 7월에 3B 파라미터 모델로 공개했으며, 사고 모드와 비사고 모드, 64k 훈련 컨텍스트(YaRN으로 최대 128k), 영어·프랑스어·스페인어·독일어·이탈리아어·포르투갈어 지원을 갖추고 있습니다. 이 페이지의 마지막 업데이트 시점 기준으로 SmolLM 4는 없습니다. Hugging Face가 공개하지 않았습니다. SmolLM 3는 검증된 온디바이스 수치가 없어 이 글의 속도 비교에는 포함하지 않았지만, 3B이므로 Llama 3.2 3B와 같은 크기급에 속합니다.
Gemma 3n은 무엇이며 폰에서는 Gemma 3보다 낫습니까?
Gemma 3n은 온디바이스 사용을 위해 만든 Google 모델 계열로, E2B와 E4B 크기가 있습니다. “E”는 effective(유효) 파라미터를 뜻합니다. E2B는 원시 파라미터 50억 개 이상을 로드하지만 메모리 부하를 20억 개 미만(1.91B)으로 줄여 구동할 수 있습니다. 텍스트, 이미지, 오디오 입력을 받고 140개 이상 언어를 지원합니다. Gemma 3 4B와는 다른 트레이드오프이며 단순한 상위 호환이 아닙니다. 검증된 수치가 아직 없어 이 글의 속도 비교에는 포함하지 않았습니다.
폰 LLM으로 이미지 캡션과 대체 텍스트를 쓸 수 있습니까?
비전을 지원하는 모델이어야만 가능합니다. 여기 소개한 6종 중 이미지를 입력받는 모델은 Gemma 3 4B뿐이고, 나머지 다섯 종은 텍스트 전용입니다. Gemma 3n과 SmolVLM2(256M, 500M, 2.2B)도 이미지를 처리합니다. llama.cpp 기반 앱은 별도의 비전 프로젝터 파일이 필요하므로, 앱이 해당 모델의 이미지 입력을 지원해야 합니다. 소형 비전 모델은 글자를 잘못 읽거나 사물을 잘못 분류할 수 있으니, 게시하기 전에 모든 캡션을 검토하십시오.
폰용 2.5B 파라미터 모델이 있습니까?
여기서 다룬 주요 폰용 모델 중에는 없습니다. 가장 가까운 크기는 1.7B급(SmolLM 2, Qwen3)과 3B급(Llama 3.2 3B, SmolLM 3)입니다. 취지가 가장 비슷한 것은 Gemma 3n E2B로, 원시 파라미터 50억 개 이상을 로드하지만 유효 메모리 부하는 20억 개 미만으로 구동됩니다.
오프라인 요약에서 메가바이트당 정확도가 가장 좋은 모델은 무엇입니까?
이 글은 자체 정확도 벤치마크를 제시하지 않으므로 답은 정성적입니다. 짧은 요약에는 1.1 GB급 모델(Qwen3 1.7B, SmolLM 2 1.7B)이 효율적인 중간 선택이며, 영어 외 텍스트에는 Qwen3가 낫습니다. 메모리를 쓸 수 있다면 Phi-4 Mini (~2.7 GB)가 6종 중 품질의 상한선이고, Gemma 3 1B (~720 MB)는 일관된 짧은 요약을 만들 수 있는 가장 작은 모델입니다.
폰 LLM이 100밀리초 안에 응답할 수 있습니까?
완전한 답변은 불가능합니다. iPhone 17 Pro에서 토큰 생성만으로도 Phi-4 Mini는 토큰당 ~55–77 ms (13–18 토큰/초), Gemma 3 1B는 토큰당 ~22–29 ms (35–45 토큰/초)가 걸리므로, 가장 빠른 모델로도 20토큰짜리 답변에 약 0.5초가 듭니다. 100 ms 미만은 아주 짧은 분류 출력처럼 몇 개 안 되는 토큰에서만 현실적이며, 채팅이나 캡션 생성에는 해당하지 않습니다.
모바일 모델이 2027년에도 유용하겠습니까?
네, 하지만 특정 모델 이름은 바뀔 것입니다. 소형 LLM의 최전선은 약 6–9개월마다 이동합니다. 카테고리는 구식이 되지 않습니다; 특정 추천이 바뀝니다. 다음 업데이트는 2027-04-19에 확인하십시오.