クイックファクト
- 比較したモデル: Phi-4 Mini 3.8B、Gemma 3 4B、Gemma 3 1B、SmolLM 2 1.7B、Qwen3 1.7B、Llama 3.2 3B(すべてQ4_K_M GGUF)。
- 基準端末: iPhone 17 Pro(A19 Pro)、iPhone 16 Pro(A18 Pro、8GB)、Galaxy S25 Ultra(Snapdragon 8 Elite)、Pixel 9 Pro(Tensor G4)、OnePlus 13(Snapdragon 8 Elite)。本ページの速度の数値は目安となる推定値であり、PromptQuorumが測定したものではありません。実際の速度はアプリ、ランタイム、量子化、端末温度、設定によって変わります。
- 推論エンジン: PocketPal AI / LLM Farm経由のllama.cpp(デフォルト)、MLC Chat経由のMLC LLM(iPhoneでMetal加速)、Termux経由のOllama(Android)。
- メモリ使用量(Q4_K_M): Phi-4 Mini ~2.7 GB、Gemma 3 4B ~2.9 GB、Llama 3.2 3B ~2.2 GB、Qwen3 1.7B ~1.1 GB、SmolLM 2 1.7B ~1.1 GB、Gemma 3 1B ~720 MB。
- 最小RAM(アクティブ時): 1.7B〜1.7Bモデルは6GB端末;3B〜4Bモデルは8GB端末;Gemma 3 1Bのみ4GB端末。
- iPhone 17 Proでの最速tokens/sec: Gemma 3 1B ~35〜45、SmolLM 2 ~26〜32、Qwen3 ~24〜32、Llama 3.2 3B ~16〜22、Phi-4 Mini ~13〜18、Gemma 3 4B ~10〜13。
- 量子化ソース: Hugging FaceおよびPocketPal AI / MLC Chat / LM Studio経由で6つすべてQ4_K_M GGUFで入手可能。
- ダウンロードサイズ(Q4_K_M、MB): Gemma 3 1B ~720、Qwen3 1.7B ~1,100、SmolLM 2 ~1,100、Llama 3.2 3B ~2,200、Phi-4 Mini ~2,700、Gemma 3 4B ~2,900 — 下のサイズ表を参照。
- 速度比較に含めていない新しいモデル: SmolLM 3(3B、Hugging Face、2025年7月)とGemma 3n(E2B / E4B、Google)。画像入力に対応するのは6モデル中Gemma 3 4Bのみ。
どのモバイルモデルを選ぶべきか?
ほとんどのハイエンドスマートフォン(iPhone 16 Pro / 17 Pro、Galaxy S25 Ultra、OnePlus 13)では、Phi-4 Mini(3.8B Q4_K_M)を選んでください。 4B未満で最も高精度なモデルであり、使用可能な会話速度で動作します。速度(SmolLM 2)、多言語対応(Qwen3)、旧端末互換性(Gemma 3 1B)など、特定のニーズがある場合のみ別のモデルを選択してください。
📍 一文で説明
RAM 8GB以上のハイエンド端末にはPhi-4 Mini(最高精度)、速度重視にはSmolLM 2 1.7B、多言語使用にはQwen3 1.7B、RAM 4GB端末にはGemma 3 1B、tool callingにはLlama 3.2 3B、Phi-4 Miniが利用できない場合のバランス型デフォルトにはGemma 3 4B。
💬 簡潔に説明
単一のベストモバイルモデルは存在しません — 正しい選択はあなたの端末と使用目的によります。スマートフォンが過去2年以内のモデルでRAM 8GB以上あれば、Phi-4 Miniをインストールしてください。主に英語以外の言語でチャットする場合はQwen 3を、品質を多少犠牲にしても最速の返答が欲しい場合はSmolLM 2を、端末が古いかRAM 4GBのみの場合はGemma 3 1Bをインストールしてください。
どのモバイルモデルを選ぶか
ローカルLLMを使うべき場合:
- •RAM 8GB以上のハイエンド端末(iPhone 16 Pro/17 Pro、Galaxy S25 Ultra、OnePlus 13)→ Phi-4 Mini 3.8B
- •あらゆる端末で最速のtokens/secが必要 → SmolLM 2 1.7B
- •非英語使用(翻訳、多言語チャット) → Qwen3 1.7B
- •幅広いアプリ互換性、tool calling、またはRAGが必要 → Llama 3.2 3B
- •RAM 4GBの旧端末 → Gemma 3 1B
- •アプリでPhi-4 Miniが利用不可、4Bクラスの品質が必要 → Gemma 3 4B
クラウドモデルを使うべき場合:
- •多段階推論、複雑なコード生成、長文書分析 → クラウドまたは70B以上を搭載したホームマシンへのリモート接続
- •高密度なOCRや精度が重要な画像分析 → クラウドアプリ;簡単な画像キャプションならGemma 3 4Bでオンデバイスでも動作可能(下の「スマートフォンのマルチモーダル」を参照)
- •3,000トークン以上の一貫性が必要な長文クリエイティブライティング → クラウドまたはデスクトップの8B以上
クイック判断:
- →ほとんどのユーザーのデフォルト:Phi-4 Mini 3.8B
- →すべての端末で最速:SmolLM 2 1.7B
- →最良の多言語対応:Qwen3 1.7B

💡ヒント: 迷った場合は、ハイエンド端末ではPhi-4 Mini、ミッドレンジ端末ではSmolLM 2 1.7Bから始めてみてください — 両方とも高速接続で5分以内にダウンロードでき、元に戻すことも可能です。実際に重要な作業(要約したいメール、答えを知りたい質問など)でテストしてみてください。品質が許容できれば、それがあなたのデフォルトです。そうでなければ、PocketPal AIやLM Studioで30秒以内に別のモデルに切り替えられます。
モバイルモデル比較表
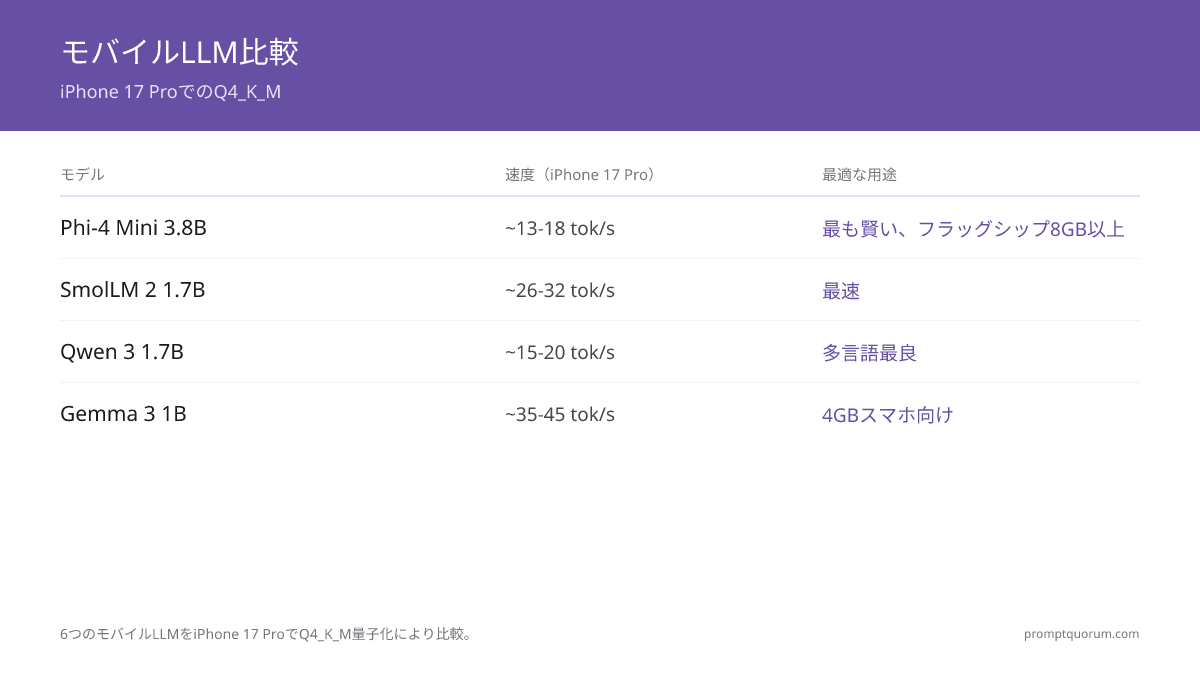
以下の4列の表は素早く選択するための概要です — 端末クラスや用途に応じて行を選んでください。 Tokens/secの値は、iPhone 17 ProでPocketPal AI(llama.cpp)を使用したQ4_K_M量子化を前提とした目安の推定値です(PromptQuorumの測定値ではありません)。iPhone 16 Proでは15〜25%低く、Galaxy S25 UltraでMLC ChatまたはTermux+Ollamaを使用した場合は約10〜20%低くなります。
📍 一文で説明
Phi-4 Miniが最高精度、SmolLM 2 1.7Bが最速、Qwen3 1.7Bが多言語最強、Gemma 3 1Bが最小の実用モデル、Llama 3.2 3Bが最強の3B汎用モデル、Gemma 3 4Bがバランス型デフォルト。
💬 簡潔に説明
この表をサイズ順に上から下に読むか、お使いの端末クラスに該当する行に直接ジャンプしてください。「最適用途」列は各モデルが最適化されている点を示しています — 最も重要な強みを持つ行を選んでください。
モデル | サイズ | tokens/sec(17 Pro) | 最適用途 |
|---|---|---|---|
| Phi-4 Mini | 3.8B | ~13〜18 | 最高精度の小型モデル — ハイエンドのデフォルト |
| Gemma 3 4B | 4B | ~10〜13 | Phi-4 Mini未対応時のバランス型デフォルト |
| Gemma 3 1B | 1B | ~35〜45 | 旧端末(RAM 4GB)向け |
| SmolLM 2 | 1.7B | ~26〜32 | 最速tokens/sec、高速チャット |
| Qwen3 | 1.7B | ~24〜32 | 最強の多言語対応(35以上の言語) |
| Llama 3.2 | 3B | ~16〜22 | 最強の3Bオプション、tool calling、RAG |
速度と品質のトレードオフについて: 同一チップ上では、パラメータ数に反比例してtokens/secが変化します — 1Bモデルは同じハードウェアの3.8Bモデルより約3〜4倍速いです。品質はパラメータ数とともに向上しますが線形ではありません:Phi-4 Mini(3.8B)の推論品質は、Microsoftの学習データミックスのおかげで1.7Bモデルよりも7Bモデルに近いです。

💡ヒント: iPhone 16 Proのtokens/secはこの表のすべてのモデルでiPhone 17 Proより約15〜25%低くなります — A18 ProとA19 ProのNeural Engineの差です。Galaxy S25 Ultra(Snapdragon 8 Elite)は同じQ4_K_M GGUFでiPhone 17 Proより約10〜20%低く、主にTermux+OllamaがAndroidでSnapdragon HexagonのNPUをMLC ChatがApple Metalを活用するほど利用できていないためです。
Phi-4 Mini:最も高精度な小型モデル
Phi-4 Mini(3.8Bパラメータ、Microsoft、2024年12月)は、推論に最適化された学習データミックスにより、2026年における4B未満で最も高精度なモデルです。 同程度のサイズにもかかわらず、chain-of-thoughtタスクでGemma 3 4BとLlama 3.2 3Bを上回ります。RAM 8GB以上のスマートフォンでのデフォルトとして使用してください。
- パラメータと学習: 3.8Bパラメータ;高品質なウェブテキスト、合成推論チェーン、学術コンテンツのMicoftキュレーションミックスで学習。アーキテクチャはgrouped-query attentionを持つTransformer。
- メモリ使用量: Q4_K_Mで~2.7 GB、Q5_K_Mで~3.5 GB。iPhone 16 Pro / 17 Pro(8 GB)とGalaxy S25 Ultra(12 GB)でOSの余裕を持って快適に動作。
- 速度(tokens/sec): iPhone 17 Pro ~13〜18、iPhone 16 Pro ~10〜15、Galaxy S25 Ultra ~10〜15(Termux+Ollama)、iPhone 14 Pro ~6〜10(低速だが機能的)。
- 品質の強み: chain-of-thought推論、要約、ファクトQ&A、基本的なコード生成。MMLU、GSM8Kなどの標準ベンチマークで同サイズのオープンソースモデルを上回ります。
- 品質の弱み: Llama 3.2 3Bより世界知識が狭い(Common Crawlの露出が少ない);Gemma 3 4Bより自然なクリエイティブライティングが短い;英語以外ではQwen3 1.7Bより多言語対応が弱い。
- 最適用途: 英語のチャット、要約、推論に最も高精度な単一モデルのデフォルトを求めるハイエンドスマートフォンユーザー。
💡ヒント: Phi-4 Miniはステップバイステップの推論を明示的に呼び出すシステムプロンプト(「回答する前にこれを慎重に考えてください」)から恩恵を受けます。学習データが推論チェーンで豊富であるため、このスタイルのプロンプトは簡潔な指示よりも一貫して良い回答を生成します。素早いチャットにはシステムプロンプトは不要です。
Gemma 3 4B:バランス型デフォルト
Gemma 3 4B(Google DeepMind、2025年)は、アプリでPhi-4 Miniが利用できない場合や、Googleの学習データミックスを好む場合のバランス型デフォルトです。 同じハードウェアでPhi-4 Miniよりわずかに遅いですが、チャットと要約では同等の品質で、より幅広い自然言語カバレッジを持ちます。
- パラメータと学習: 4Bパラメータ;ウェブテキスト、コード、多言語データのGoogleキュレーションミックスで学習。拡張コンテキストを持つGemma 2と同じアーキテクチャファミリー。
- メモリ使用量: Q4_K_Mで~2.9 GB、Q5_K_Mで~3.7 GB。8GB以上の端末に対応;6GB端末では厳しい(代わりにPhi-4 Miniまたは小型モデルを使用)。
- 速度(tokens/sec): iPhone 17 Pro ~10〜13、iPhone 16 Pro ~7〜10、Galaxy S25 Ultra ~7〜10(アーキテクチャの違いにより、同サイズにもかかわらずPhi-4 Miniよりわずかに遅い)。
- 品質の強み: 自然な会話トーン、強力な要約、Phi-4 Miniより広い世界知識(Common Crawlの露出)、まずまずの多言語対応。
- 品質の弱み: Phi-4 Miniよりchain-of-thought推論が弱い;同じハードウェアでtokens/secが遅い;モバイルアプリへの追加が常に最初ではない。
- 最適用途: 日常のチャット、要約、短文作成にPhi-4 Miniの代替としてGoogleのモデルを求めるハイエンドユーザー。
💡ヒント: Gemma 3 4BはPhi-4 Miniとは異なるchat templateを使用しています — アプリが正しいGemmaテンプレート(<start_of_turn>マーカー付き)を使用していることを確認してください。間違ったテンプレートは壊れた出力や繰り返しの出力を生成します。PocketPal AI、MLC Chat、LM Studioは自動的にこれを検出します;LLM FarmではモデルSettings下でGemmaテンプレートを手動で選択する必要があります。
Gemma 3 1B:旧端末向け軽量モデル
Gemma 3 1B(Google DeepMind、2025年)は2026年で最小の実用的なモバイルモデルです — Q4_K_Mで~720 MBでRAM 4GB端末で動作します。 品質は短い一貫した回答(1〜2段落)に限られますが、1 GB未満で弱いハードウェアで使用可能な出力を生成できる唯一のオプションです。
- パラメータと学習: 1Bパラメータ;4Bモデルと同じGemma 3ファミリーアーキテクチャだが、学習コンピュートを削減。エッジデバイスでの効率的な推論のために学習。
- メモリ使用量: Q4_K_Mで~720 MB、Q5_K_Mで~900 MB。iPhone SE 第3世代、iPhone 12/13、旧Android(最低RAM 4GB)で動作。
- 速度(tokens/sec): iPhone 17 Pro ~35〜45、iPhone 16 Pro ~28〜38、iPhone 14 ~20〜28、旧Android(4GB)~10〜15。このラインナップで最速のモデル。
- 品質の強み: 速度、低メモリ使用量、一貫した短文回答、低バッテリー消費。
- 品質の弱み: 多段階推論が弱い、ニッチなトピックでの事実誤りが頻繁、長い生成(500トークン以上)での繰り返し、会話の深さが浅い。
- 最適用途: RAM 6GBのしきい値を下回る端末でオンデバイスAIを使いたいユーザー、または長距離フライトや低電力シナリオでバッテリー寿命を最適化したいユーザー。
💡ヒント: Gemma 3 1Bは短く焦点を絞ったタスクに使用してください — 一文要約、一段落の下書き、簡単な定義、主要言語ペア間の簡単な翻訳。多段落の説明、多段階推論、またはニッチな事実の正確さが重要なタスクは避けてください。「簡潔に」というプロンプトがこのモデルの強みを活かします。
SmolLM 2 1.7B:最速tokens/sec
SmolLM 2 1.7B(Hugging Face、2024年)は、すべての基準端末でこのラインナップ中最速のtokens/secを記録するモバイルモデルです。 iPhone 17 Proで~26〜32 tok/sec、Galaxy S25 Ultraで~20〜28。回答の深さよりも応答速度が重要な場合に最適です。
- パラメータと学習: 1.7Bパラメータ;小型モデルの効率性に最適化されたHugging Faceキュレーションミックスで学習。コンシューマーハードウェアでの低レイテンシ推論のためのアーキテクチャ。
- メモリ使用量: Q4_K_Mで~1.1 GB。RAM 6GB以上のすべての端末にOSの大きな余裕を持って収まります。
- 速度(tokens/sec): iPhone 17 Pro ~26〜32、iPhone 16 Pro ~22〜28、Galaxy S25 Ultra ~20〜28、iPhone 14 Pro ~15〜22。同じチップでPhi-4 Miniの約2倍速い。
- 品質の強み: 素早い会話応答、シンプルなQ&A、オートコンプリートスタイルの続き、英語の文章作成。
- 品質の弱み: Phi-4 Miniより推論が弱い、Llama 3.2 3Bより世界知識が狭い、Qwen3 1.7Bより多言語対応が弱い、事実クエリでの時折の幻覚。
- 最適用途: レイテンシが重要なミッドレンジ端末(テキスト入力オートコンプリート、音声アシスタントターン、リアルタイムチャット)、または大型モデルが重く感じられる旧ハイエンド端末。

💡ヒント: SmolLM 2 1.7Bはモバイルでのオフライン音声アシスタントスタック向けに最適です — Whisper + LLM + TTS パイプラインについてはスマートフォンでローカル音声アシスタントを構築するを参照してください。高いtokens/secにより、ミッドレンジハードウェアでも音声ターンテイキングが~1.5秒の知覚しきい値を下回ります。
Qwen3 1.7B:最強の多言語モバイルモデル
Qwen3 1.7B(Alibaba、2024年)は2026年で最強の多言語モバイルモデルです — 中国語、日本語、韓国語、アラビア語、ドイツ語、フランス語、スペイン語、ロシア語を含む35以上の言語で学習されています。 翻訳、非英語チャット、会話の途中で言語を切り替えるような旅行での使用に最適です。
- パラメータと学習: 1.7Bパラメータ;CJK言語、アラビア語、主要欧州言語が強く表現されたAlibabaの多言語コーパスで学習。多言語推論に最適化されたアーキテクチャ。
- メモリ使用量: Q4_K_Mで~1.0 GB。RAM 6GB以上のすべての端末に収まります。
- 速度(tokens/sec): iPhone 17 Pro ~24〜32、iPhone 16 Pro ~20〜28、Galaxy S25 Ultra ~18〜26、iPhone 14 Pro ~14〜20。SmolLM 2と同等の速度。
- 品質の強み: 35以上の言語でネイティブ品質の出力(ほとんどの小型モデルは英語中心で多言語フォールバックが弱い)、主要言語ペア間の強力な翻訳、Phi-4 MiniとLlama 3.2が文字化けを生成するCJK出力が一貫している。
- 品質の弱み: 英語のみの推論がPhi-4 Miniよりわずかに弱い、Gemma 3 4Bより自然なクリエイティブライティングが短い、Llama 3.2 3Bよりtool callingが弱い。
- 最適用途: 非英語ユーザー(特に中国語、日本語、ドイツ語、スペイン語、フランス語話者)、オフライン翻訳が必要な旅行者、多言語モバイル機能を構築するデベロッパー。
💡ヒント: 特定の2言語ペア間の1回限りの翻訳では、Qwen3 1.7Bはサブタスクとして翻訳を実行する大型英語中心モデルを通常上回ります。日本語でチャットする日本語ユーザーにとって、Qwen 3は60%小さいにもかかわらずPhi-4 Miniよりも顕著に自然な出力を生成します。基本的なルール:最もパラメータが多いモデルではなく、あなたの主要言語のために学習されたモデルを選んでください。
Llama 3.2 3B:信頼性の高い3B汎用モデル
Llama 3.2 3B(Meta、2024年)は2026年で最も広くサポートされている3Bモデルです — 最広のアプリ互換性、6モデル中最強のtool calling対応、最大のコミュニティfine-tuneエコシステム。 品質ではPhi-4 Miniにわずかに劣りますが、エッジケースでより信頼性が高く、モバイルアプリのサポートが充実しています。
- パラメータと学習: 3Bパラメータ;チャットとツール使用のためのinstruction-tuningを持つMetaの大規模事前学習コーパスで学習。8Bおよび70B版と同じLlama 3アーキテクチャ。
- メモリ使用量: Q4_K_Mで~2.2 GB、Q5_K_Mで~2.8 GB。8GB以上の端末にOS余裕を持って収まる;他のアプリを閉じれば6GB端末でも動作。
- 速度(tokens/sec): iPhone 17 Pro ~16〜22、iPhone 16 Pro ~12〜18、Galaxy S25 Ultra ~12〜18、iPhone 14 Pro ~7〜11。
- 品質の強み: 幅広い世界知識、堅牢なtool callingおよびfunction calling対応(4B未満のモデル中クラス最高)、信頼性の高いチャット動作、特定タスク(医療、法律、コーディング)向けのfine-tuneの成熟したエコシステム。
- 品質の弱み: Phi-4 Miniよりchain-of-thought推論が弱い、同サイズでわずかに低いMMULスコア、Gemma 3 4Bより自然な会話トーンが少ない。
- 最適用途: tool callingまたはfunction callingが必要なモバイルアプリ(ローカル文書上のRAG、オンデバイスエージェントワークフロー)、または最大のコミュニティfine-tuneライブラリを持つモデルを求めるユーザー。
💡ヒント: Llama 3.2 3Bはこのラインナップで唯一、オンデバイスエージェントワークフローに十分信頼性の高いtool callingをサポートするモデルです — ローカルAIエージェントとMCP 2026を参照してください。Phi-4 MiniとSmolLM 2は技術的にtool callが可能ですが、Llama 3.2 3Bのみが2026年で本番運用可能です。
SmolLM 3とGemma 3n:新しい小型モデル
SmolLM 3(Hugging Face、2025年7月)とGemma 3n(Google)は、読者から最もよく質問される2つの新しい小型モデルです。どちらも、公開時点で実機で検証されたtokens/secの数値がないため、上記の6モデルの速度比較には含まれていません。 このページの最終更新時点でSmolLM 4は存在しません:Hugging Faceは公開しておらず、SmolLM 3がSmolLMファミリーの最新世代でした。
- SmolLM 3(3B): 約11兆トークンで学習された3Bパラメータのモデルで、思考モードと非思考モードを備えています。学習時のコンテキストは64kで、推論時にはYaRNによる外挿で最大128kまで扱えます。公式の対応言語は英語、フランス語、スペイン語、ドイツ語、イタリア語、ポルトガル語です。Hugging Faceは、ベースモデルのベンチマークでより大きなQwen3 4BやGemma 3 4Bと競合する性能だと報告しつつ、Qwen3 4Bが総じて最高スコアだとも述べています。
- スマートフォンでのSmolLM 3: 3BパラメータはLlama 3.2 3Bと同じサイズクラスなので、Q4_K_Mのファイルは約2 GB、クラス別表の8GB RAM帯が目安になります。これはパラメータ数からの推定であり、実測値ではありません。
- Gemma 3n(E2BとE4B): 「E」はeffective parameters(実効パラメータ)を表します。E2Bは50億を超える生のパラメータを読み込みますが、パラメータのスキップとper-layer-embeddingのキャッシュにより、メモリ負荷が20億弱(1.91B)で動作できます。Gemma 3nはテキスト、画像、音声の入力に対応し、140以上の言語で学習され、コンテキストウィンドウは32Kトークンです。
- どちらを選ぶか: 英語または主要なヨーロッパ言語で、思考モードのある3Bモデルが欲しいならSmolLM 3。アプリが画像や音声の入力に対応しているならGemma 3n。それ以外は、上記の6モデルが引き続き定番のデフォルトです。
💡ヒント: 新しい小型モデルは、速度より先にRAMで判断してください。まずQ4_K_Mのファイルサイズを調べ、クラス別表と照らし合わせてから、ベンチマークの主張を読みます。アプリの対応はモデルの公開に遅れることもあります — アプリのキュレーションリストにモデルがない場合は、Hugging FaceからGGUFをサイドロードしてください。
モバイル向け量子化:Q4_K_Mがデフォルト
Q4_K_Mは2026年のモバイルLLM推論の標準量子化です — ファイルサイズを4分の1にしながら元のモデル品質の~95%を保持します。 Q5_K_MまたはQ6_Kは、RAM 12GB以上の端末(iPhone 17 Pro Max、Galaxy S25 Ultra)で余分なメモリが本当に空いている場合のみ使用してください。
📍 一文で説明
Q4_K_Mがモバイルのデフォルト — 4分の1のサイズで~95%の品質。Q5_K_M / Q6_KはRAM 12GB以上の端末でのみ価値があります。
💬 簡潔に説明
Hugging Faceのモデルはフル精度で公開されています(各パラメータが16ビット数として保存)。スマートフォンでは量子化バージョンをダウンロードします。各パラメータが4ビットに圧縮され、ファイルが4倍小さくなり推論が約4倍速くなり、わずかな品質コストが発生します。Q4_K_Mは2026年にスマートフォンのための適切なバランスとしてコミュニティが定着した変種です。Q数値が高いほど(Q5、Q6、Q8)圧縮が少なく品質が高いですが、ファイルが大きくなります;Q4がスマートフォンの制約に対するスイートスポットです。
- Q4_K_M(推奨デフォルト): K-quantsと「M」混合精度を持つ4ビット量子化。元の品質の~95%。2026年のモバイル標準。6つすべてのモデルがHugging FaceでこのフォーマットでAvailable。
- Q5_K_M(RAM 12GB以上の端末向け): 5ビット量子化。元の品質の~98%。ファイルが~25%大きい。iPhone 17 Pro Max(12 GB)またはGalaxy S25 Ultra(12 GB)でPhi-4 MiniとLlama 3.2 3Bに価値がある;8GB端末ではRAMコストに見合わない。
- Q6_K(めったに必要ない): 6ビット量子化。元の品質の~99%。ファイルが~50%大きい。品質がどうしても重要なモデルを実行するメモリが豊富な端末のみ(例:長文の下書きで各品質ポイントが重要な場合)。
- Q8_0(モバイルでは避ける): 8ビット量子化。元の品質の~99.5%。Q4_K_Mの約2倍のサイズ。スマートフォンではRAMコストに見合わない;デスクトップ/ラップトップ用に。
- Q3_K_M / Q2_K(非常に制約された端末のみ): 3ビットおよび2ビット量子化。品質が~85〜90%に低下。Q4_K_MのGemma 3 1Bでも収まらない場合のみ使用(2026年ではまれ)。

⚠️注意: 「どちらが良いかテストする」ために同じモデルを複数の量子化でダウンロードしないでください。Q4_K_MとQ5_K_Mの品質差は実在しますが小さく、256GBのスマートフォンに5GB以上の冗長な変種を保存することになります。Q4_K_Mを選び、1週間実際に使用してから、品質が不十分だという具体的な証拠がある場合のみQ5_K_Mにアップグレードしてください。
モデルのダウンロードサイズ(MB)
Q4_K_Mでは、6モデルのサイズは~720 MB(Gemma 3 1B)から~2,900 MB(Gemma 3 4B)までです。 推論のオーバーヘッドとして、ファイルサイズに加えて約500 MBの余分なRAMを見込み、保存する3B〜4Bモデル1つにつき最低3 GBの空きストレージを確保してください。
📍 一文で説明
Q4_K_Mのファイルサイズ:Gemma 3 1B ~720 MB、Qwen3 1.7BとSmolLM 2 ~1,100 MB、Llama 3.2 3B ~2,200 MB、Phi-4 Mini ~2,700 MB、Gemma 3 4B ~2,900 MB。
💬 簡潔に説明
ダウンロードするファイルのサイズは、モデルの実行中に占有するRAMの量とほぼ同じで、そこに少しのオーバーヘッドが加わります。だからこそ、端末と照らし合わせるべき数値はパラメータ数ではなくファイルサイズです。モデルとOSを合わせてRAMに収まらないと、回答の途中で端末がアプリを終了させてしまいます。
モデル | Q4_K_Mサイズ(MB) | 最小スマホRAM | サイズと品質のメモ |
|---|---|---|---|
| Gemma 3 1B | ~720 | 4 GB | 実用になる最小のモデル;短い回答向け |
| Qwen3 1.7B | ~1,100 | 6 GB | MBあたりの多言語出力が最良 |
| SmolLM 2 1.7B | ~1,100 | 6 GB | MBあたりの速度が最速;軽い推論向け |
| Llama 3.2 3B | ~2,200 | 8 GB(6 GBはぎりぎり) | 4Bモデルより小さい;tool callingが最良 |
| Phi-4 Mini | ~2,700 | 8 GB | パラメータあたりの推論能力が最強 |
| Gemma 3 4B | ~2,900 | 8 GB | 最大のファイル;自然な要約;画像入力に対応 |
バイトあたりの精度について: この記事には独自の精度ベンチマークがないため、最後の列は定性的な目安として扱ってください。オフラインの要約では、1.1 GBのモデル(Qwen3 1.7B、SmolLM 2)が効率の良い中間点で、2.7 GBを割けるならPhi-4 Miniが品質の上限です。
クラス別判定:ハイエンド vs ミッドレンジ vs エントリー
端末クラスがモデルの上限を決定します — チップの世代とRAMはブランドより重要です。 ハイエンドスマートフォン(RAM 8GB以上、A18 Pro / A19 Pro / Snapdragon 8 Elite)は3.8B〜4Bモデルを快適に動作させます;ミッドレンジ(RAM 6〜8GB、旧ハイエンドチップ)は1.7B〜3B;バジェットまたは旧端末(RAM 4〜6GB)は1B〜1.7Bです。
📍 一文で説明
ハイエンド端末(8GB以上)→ Phi-4 Mini 3.8B;ミッドレンジ(6〜8GB)→ SmolLM 2 1.7BまたはLlama 3.2 3B;バジェットまたは旧端末(4〜6GB)→ Gemma 3 1BまたはQwen3 1.7B。
💬 簡潔に説明
願望ではなく端末にモデルを合わせてください。6GB端末の3.8Bモデルは他のアプリがメモリを必要とするときに3秒のポーズとクラッシュを引き起こします。ハイエンド端末の1Bモデルは能力を無駄にします。OSと少なくとも1つの他のアプリを開いた状態で快適に動作する最大のモデルを選んでください。
端末クラス | 代表機種 | 推奨モデル | 理由 |
|---|---|---|---|
| ハイエンド(RAM 8〜12GB) | iPhone 17 Pro / Pro Max、iPhone 16 Pro、Galaxy S25 Ultra、OnePlus 13 | Phi-4 Mini(3.8B Q4_K_M) | 使用可能な速度でチップが維持できる最も高精度なモデル |
| 旧ハイエンド(RAM 8GB) | iPhone 15 Pro、Galaxy S24 Ultra、Pixel 9 Pro | Llama 3.2 3BまたはPhi-4 Mini | tool calling向けにLlama 3.2 3B;品質向けにPhi-4 Mini |
| ミッドレンジ(RAM 6〜8GB) | iPhone 14 Pro、Pixel 9、Snapdragon 8 Gen 2端末 | SmolLM 2 1.7BまたはQwen3 1.7B | 素早い速度;OSの余裕を持って収まる |
| バジェット / 旧端末(RAM 4〜6GB) | iPhone 14、Snapdragon 7シリーズ中位、旧Android | Gemma 3 1BまたはQwen3 1.7B | 一貫した出力を生成する最小の実用モデル |
| 非常に古い(RAM 4GB) | iPhone SE 第3世代、旧4GB Android | Gemma 3 1B | 収まる唯一のモデル;推論は限られるが tokens/sec は速い |
| 非対応(4GB未満) | iPhone SE 第2世代、旧Android | 代わりにホームマシンへのリモート接続 | オンデバイスLLMは実用的でない;ホームOllamaサーバーのUIとしてタブレット/スマートフォンを使用 |

💡ヒント: アプリ側については、iPhoneとAndroidの姉妹ガイドを参照してください — 各プラットフォームでこれらのモデルを実際に公開しているアプリを紹介しています。アプリの可用性がモデルの可用性に遅れる場合があります。モデルがアプリのキュレーションリストにない場合、Hugging FaceからGGUFとしてサイドロードできることが多いです。
ローカルLLMに向くスマートフォン
ローカルAIに最適なスマートフォンは、RAMが最も多く、最新のフラッグシップチップを搭載した端末です。 この記事の目安の数値では、iPhone 17 Pro(A19 Pro)が最速で、Galaxy S25 Ultra(Snapdragon 8 Elite)は同じQ4_K_Mファイルでおよそ10〜20%遅くなります。RAMが収まるモデルを決め、チップがその速さを決めます。
📍 一文で説明
3B〜4Bモデルには8GB以上のRAM、Q5_K_Mには12GBを備えた端末を選んでください — この記事で使用した端末は、iPhone 17 Pro / 17 Pro Max、iPhone 16 Pro、Galaxy S25 Ultra、OnePlus 13です。
💬 簡潔に説明
まず端末のRAMを確認してください。それが動かせる最大のモデルを決めます。次に重要なのがチップの世代で、こちらは速度を左右します。ローカルAIのために新しい端末を買う必要はありません:今お持ちの端末でも1B〜1.7Bのモデルはフル速度で動き、最近のフラッグシップが必要になるのは3B〜4Bモデルだけです。
- まずRAM: 4GBで動くのはGemma 3 1Bのみ;6GBで1.7Bモデル;8GBで3B〜4Bモデル;12GB(iPhone 17 Pro Max、Galaxy S25 Ultra)ならQ5_K_Mにも余裕があります。Androidには同じ機種でRAMの異なるモデルが複数あるため、端末の仕様でRAMを確認してください。
- 次にチップ: この記事の速度の元になっているのは、A19 ProとA18 Pro(iPhone)、Snapdragon 8 Elite(Androidのフラッグシップ)です。古いフラッグシップのチップでも同じモデルは動きますが、速度は落ちます — iPhone 14 ProでのPhi-4 Miniは~6〜10 tok/secです。
- iPhoneとAndroidの違い: 同じQ4_K_Mファイルでは、この記事の数値でiPhoneが10〜20%速くなります。主な理由は、MLC ChatがApple Metalを使うのに対し、Android上のTermux+OllamaはCPUのみで動作し、Snapdragon NPUを使わないことです。より良いAndroid向けランタイムがあればこの差は縮まります;限界はハードウェアではありません。
- 発熱とバッテリー: 生成を続けるとチップに負荷がかかり続け、端末は熱を持つとクロック速度を下げるため、長いセッションではtokens/secが低下します。この記事には、スロットリングの実測値はありません。現実的な対策は、より小さなモデルを使うこと(Gemma 3 1Bは消費電力が3B〜4Bモデルよりはるかに少なく、3B〜4Bモデルは回答あたり2〜3倍の電力を消費します)、出力を短くすること、モデルの実行中は充電しないことです。
- ストレージ: 3B〜4Bモデルは1つあたり2.2〜2.9 GBを占めます。バリアントを大量に並べるのではなく、1〜2モデル分の空きを確保してください。
💡ヒント: ミッドレンジのAndroid端末(Samsung Galaxy Aシリーズなど)をお使いですか? お使いの機種のRAMバリアントを調べ、クラス別表を参照してください:8GBならSmolLM 2 1.7BまたはLlama 3.2 3B、6GBなら1.7Bモデル、4GBならGemma 3 1Bが動きます。チップよりRAMの数値のほうが重要です。
スマートフォンのマルチモーダル:画像キャプションと代替テキスト
6つの主要モデルのうち、画像を扱えるのはGemma 3 4Bだけです;Gemma 3 1B、Phi-4 Mini、Llama 3.2 3B、Qwen3 1.7B、SmolLM 2はテキスト専用です。 Googleは、Gemma 3の4B、12B、27Bをビジョン対応としています。Gemma 3n(E2B / E4B)は画像と音声の入力に対応し、Hugging FaceのSmolVLM2ファミリー(256M、500M、2.2Bパラメータ)は最初からビジョンと動画向けに作られています。
- フラッグシップ端末での画像キャプションのおすすめ: Gemma 3 4B(Q4_K_Mで~2.9 GB、RAM 8GB以上)。6つのうち、写真を読み取ってキャプションや代替テキストを書けるのはこれだけです。
- エントリー端末またはCPUのみのAndroid: SmolVLM2 256Mまたは500Mは、Hugging Faceファミリーで最小のビジョンモデルであり、非力なハードウェアでの現実的な出発点です。この記事には、これらの検証済みの速度データはありません。
- 本当の制約はアプリの対応: llama.cppベースのアプリでは、画像入力にモデルとは別のビジョンプロジェクターファイルが必要です。アプリがそのモデルの画像入力を提供していなければ、ビジョン対応モデルでもテキストでしかチャットできません。ダウンロードする前にアプリを確認してください。
- 代替テキストのワークフロー: 見えているものを1〜2文の平易な文章で説明するよう依頼し、公開する前に結果を読んで確認してください。小型のビジョンモデルは画像内の文字を読み間違えたり、人物や物を誤ってラベル付けしたりすることがあるため、アクセシビリティやSNS投稿向けのものには必ず人の目によるチェックを入れてください。
- レイテンシの目安: 画像のエンコードを含める前の、トークン生成だけで、Phi-4 Miniは1トークンあたり~55〜77 ms(13〜18 tok/sec)、Gemma 3 1Bは1トークンあたり~22〜29 ms(35〜45 tok/sec)かかります。したがって、スマートフォンでのキャプション生成で100 ms未満のエンドツーエンド応答を目指すのは現実的ではありません。
💡ヒント: 細かい文字だらけの文書、レシート、スクリーンショットには、クラウドモデルかデスクトップのビジョンモデルを使ってください。オンデバイスのキャプションは、たまに外しても直しやすい写真の短い説明に最適です。
よくある失敗
- スマートフォンのRAMが許容する以上に大きいモデルを選ぶ。 6GB端末のPhi-4 Miniは3〜5 tok/secで動作し、iOS/Androidが他のアプリのためにメモリを回収するとクラッシュします。クラス別表に従ってモデルを端末クラスに合わせてください。
- 同じモデルの複数の量子化バリアントをダウンロードする。 Q4_K_Mを選んで止めてください。256GBのスマートフォンに5GB以上の冗長なQ5/Q6バリアントは無駄なストレージであり、品質の差は日常のチャットでは知覚できません。
- 多段階推論にSmolLM 2 1.7Bを使用する。 最速のモデルですが、最も賢いわけではありません。chain-of-thoughtタスク(数学、計画、複雑な推論)では、遅いtokens/secが気になっても、Phi-4 Miniを使用してください。品質のない速度はただ速い間違いの答えです。
- 多言語プロンプトプレフィックスなしでPhi-4 Miniに英語以外の出力を求める。 Phi-4 Miniは一般的なヨーロッパ言語を適切に処理しますが、CJKやアラビア語では不均一な出力を生成します。多言語使用にはPhi-4 Miniと並行してQwen3 1.7Bをインストールし、言語に応じて切り替えてください。
- これらのモデルにクラウドAI品質を期待する。 6つすべてが1B〜4Bであり、チャットタスクでGPT-5.5の能力の約60〜80%、複雑な推論ではそれよりはるかに少ないです。得意なこと(プライベートチャット、要約、下書き、翻訳)に使用し、70B以上のモデルが必要なことにはクラウドまたはリモート接続を使用してください。
- Phi-4 Mini(3.8B)を古いPhi-3 Mini(3.8B)と混同する。 パラメータ数は共有していますが、Phi-4 Miniの学習データとchat templateは異なります。GGUFファイル名のモデル識別子を常に確認してください —
phi-3-mini-4k-instructではなくphi-4-mini-instruct。
情報源
- Phi-4 Mini技術レポート — Microsoft Research(2024年12月)。
- Gemma 3技術レポート — Google DeepMind(2025年)。
- SmolLM 2モデルカード — Hugging Face(2024年)。
- Qwen 3技術レポート — Alibaba Cloud(2024年)。
- Llama 3.2モデルカード — Meta AI(2024年)。
- SmolLM3の発表 — Hugging Face blog(2025年7月)。
- Gemma 3nのモデル概要 — Google AI for Developers。
- Gemma 3のビジョン対応(4B、12B、27B) — Google blog。
- SmolLMとSmolVLM2のモデルファミリー — Hugging Face TB organization。
- Q4_K_M量子化リファレンス — llama.cppドキュメント。
よくある質問
iPhoneで最速のモバイルモデルはどれですか?
Gemma 3 1BはiPhone 17 Proで~35〜45 tokens/secと絶対的に最速ですが、このラインナップで最小のモデルです。1.7B〜1.7Bモデル(速度と品質のバランスが取れている)の中では、SmolLM 2 1.7Bが~26〜32 tokens/secで最速です。ハイエンド品質の出力を生成するモデルの中では、Phi-4 Miniが~13〜18 tokens/secで最速の「賢い」オプションです。用途に応じて選んでください:応答速度が深さより重要ならSmolLM 2;深さが重要ならPhi-4 Mini。
Gemma 3 2BやGemma 3 7Bというモデルは存在しますか?
いいえ。Gemma 3は公式に270M、1B、4B、12B、27Bの5サイズで提供されており、Gemma 3 2BやGemma 3 7Bは存在しません。この混同はGemma 2に由来することが多く、Gemma 2には実際に2Bモデル(Google DeepMind、2024年7月)が9B・27Bと共に存在していました。「Gemma 3 2B」に最も近いものを探しているなら、実在する選択肢はGemma 3 1B(より小型・高速)とGemma 3 4B(より大型・高精度)の2つで、どちらも本記事で比較しています。2026年4月にはGoogleがGemma 4も発表しており、こちらは異なるサイズ構成(Effective 2BとEffective 4B、26B MoEおよび31B denseバリアント)を採用しています。Gemma 4はGemma 3とは別のモデルファミリーであり、この更新時点では実機でのtokens/sec検証データが存在しないため、本記事のモバイル速度比較にはまだ含まれていません。
これらのモデルはGPUが必要ですか、それともCPUのみで動作しますか?
6つのモデルすべてが専用GPUなしで動作します。iPhoneではMLC ChatがAppleのMetal APIを使ってNeural Engine/GPU上で推論を高速化しますが、PocketPal AIとLLM Farm(llama.cpp)は主にCPU上で動作します。AndroidではTermux+Ollamaは現在CPUのみで動作しており、Snapdragon Hexagon NPUをまだ活用していません。これが同じQ4_K_MファイルでもAndroidのtokens/secがiPhoneよりおよそ10〜20%低い理由です(上記の比較表を参照)。実際には、Galaxy S25 Ultra上のPhi-4 MiniはCPUのみで約10〜15 tokens/secで動作しており、このラインナップのどのモデルも実用的な出力を得るために専用GPUを必要としません。
Phi-4 MiniはiPhone上で7Bモデルを本当に上回りますか?
半分のサイズにもかかわらず、MMULや推論タスクなどの標準ベンチマークで古い7Bモデル(Llama 3.3 7B、Mistral Small v0.1)を上回ります。現在の7Bモデル(Llama 3.3 7B、Mistral Small v0.3)の生の能力は上回りません — それらはまだ広い知識と複雑な推論でリードしています。Phi-4 Miniが重量以上に戦える理由はMicrosoftの学習データミックス(合成推論チェーンと高品質テキストに豊富)です。スマートフォンでは7Bモデルは通常実用的には遅すぎるため、Phi-4 Miniがデフォルトで勝ちます。
SmolLM 2は4年前のスマートフォンで動作しますか?
はい、ほとんどの4年前のハイエンド端末で動作します。SmolLM 2 1.7BのQ4_K_Mにはモデル用に~1.1 GB RAMと推論オーバーヘッドに~500 MBが必要です — iPhone 13(6 GB)、iPhone 12 Pro Max(6 GB)、同等のAndroid(6 GB以上)に収まります。2021年の4GB端末(iPhone 12、Androidベース)では技術的にはロードしますが、他のメモリ負荷の下で不安定です;代わりにGemma 3 1Bを使用してください。
モバイルで翻訳に最適なモデルはどれですか?
中国語、日本語、韓国語、アラビア語、ドイツ語、フランス語、スペイン語、ロシア語を含むペアにはQwen3 1.7B。強力な多言語表現で学習されており、英語中心のモデル(Phi-4 Mini、Llama 3.2 3B)が不自然または壊れた結果を生成するところでネイティブ品質の出力を生成します。ヨーロッパ言語ペアのみにはGemma 3 4Bが実用的な第2の選択肢です。英語と特定の言語間の一回限りの翻訳には、インストールされた翻訳アプリ(Google翻訳、DeepL)の方がローカルLLMより優れていることが多いです — ローカルモデルは翻訳を同じ会話内のチャットや要約と組み合わせる必要がある場合に輝きます。
これらのモデルをうまく使うにはハイエンドスマートフォンが必要ですか?
いいえ、最大のモデル(Phi-4 Mini 3.8B、Gemma 3 4B、Llama 3.2 3B)のみです。RAM 6〜8GBのミッドレンジ端末はSmolLM 2 1.7BとQwen3 1.7Bをフル速度(~20〜28 tokens/sec)で動作させます。RAM 4〜6GBのバジェット端末はGemma 3 1Bを~15〜25 tokens/secで動作させます。正直な答え:まだハイエンド端末を持っていない場合、ローカルAIのために購入しないでください — 既存端末の小型モデルはほとんどの用途で十分です。
バッテリー消費が最も少ないモデルはどれですか?
Gemma 3 1Bが圧倒的に少なく — 最小のモデルはトークンあたりの計算が最少であり、CPU/GPU負荷が低く消費電力が低いことを意味します。SmolLM 2 1.7BとQwen3 1.7Bが続きます。3B〜4Bモデル(Phi-4 Mini、Llama 3.2 3B、Gemma 3 4B)は回答あたり2〜3倍の電力を消費します。バッテリーが最も重要な長距離フライトや長時間オフグリッド使用では、品質コストにもかかわらずGemma 3 1Bが正しい選択です。
モバイルモデルはマルチターンの会話に対応できますか?
短い会話(5〜10ターン)にはYes、その後は品質が低下します。6つすべてのモデルに4,000〜8,000トークンのコンテキストウィンドウがあります;長い会話はウィンドウを超え、モデルは以前のターンを見失います。セッションを超えたメモリが必要な継続的なチャットのための実用的なパターンは:定期的に会話を要約し、要約を保存し、コンテキストとして返すことです。ほとんどのモバイルアプリ(PocketPal AI、Private LLM)はこれを自動的に行います;LLM Farmは手動設定が必要です。
これらのモデルは音声入力で使えますか?
はい、Whisperの音声テキスト変換レイヤーと組み合わせると使えます。2026年のモバイル向け標準オフライン音声スタックは:Whisper(smallまたはtinyモデル)による音声テキスト変換 → Phi-4 MiniまたはSmolLM 2による回答生成 → Apple TTSまたはAndroid TTSによる音声合成です。SmolLM 2 1.7Bは高いtokens/secにより音声ターンテイキングの応答性を維持するため、音声の最良のLLM選択です — 完全なパイプラインについてはスマートフォンでローカル音声アシスタントを構築するを参照してください。
旅行でのオフライン使用に最適なモデルはどれですか?
言語を切り替えて翻訳が必要な旅行には:Qwen3 1.7B。主に英語のリファレンスが必要な旅行(質問、旅行書類の要約、メールの下書き)には:ハイエンド端末のPhi-4 Mini、ミッドレンジ端末のSmolLM 2 1.7B。旅行はローカルAIの最強のユースケース全体です — ローミングデータ不要、クラウドAPIコスト不要、低接続エリアでのクラウド依存のリスクなし。旅行前にモデルをダウンロードしてください;適度な使用で1回の充電でフライト全体を通じて動作します。
ローカルLLMを動かすのに最適なスマートフォンは何ですか?
RAMが最も多く、最新のフラッグシップチップを搭載した端末です。この記事の目安の数値では、iPhone 17 Pro(A19 Pro)が最速で、Galaxy S25 Ultra(Snapdragon 8 Elite)は同じQ4_K_Mファイルでおよそ10〜20%遅くなります。Phi-4 Miniのような3B〜4Bモデルには8GB以上のRAMが必要で、12GB(iPhone 17 Pro Max、Galaxy S25 Ultra)ならQ5_K_Mにも余裕があります。すでにRAM 6GBの端末をお持ちなら、1.7Bモデルをフル速度で動かせるので、ローカルAIのためだけに新しい端末を買う必要はありません。
ローカルLLMを動かすとスマートフォンは熱くなりますか?
生成を続けるとチップに高い負荷がかかり続けるため、端末が温まり、クロック速度が下がることがあります。その場合、長いセッションではtokens/secが低下します。この記事には、スロットリングの実測値はありません。温度を抑えるには、より小さなモデルを使い(Gemma 3 1Bは消費電力が3B〜4Bモデルよりはるかに少なく、3B〜4Bモデルは回答あたり2〜3倍の電力を消費します)、回答を短くし、モデルの実行中は充電しないようにしてください。
ミッドレンジのSamsung Galaxyなど、Android端末でもこれらのモデルは動きますか?
RAMが足りていれば動きます。お使いの機種のRAMバリアントを調べ、次のように照らし合わせてください:8GBならSmolLM 2 1.7BまたはLlama 3.2 3B、6GBならQwen3 1.7BまたはSmolLM 2 1.7B、4GBならGemma 3 1Bのみです。チップよりRAMのほうが重要で、チップが主に変えるのは速度です。この記事の目安の数値では、同じファイルでのAndroidのtokens/secはiPhoneより約10〜20%低くなります。
これらのモデルは何メガバイトありますか?
Q4_K_Mでは、Gemma 3 1B ~720 MB、Qwen3 1.7B ~1,100 MB、SmolLM 2 1.7B ~1,100 MB、Llama 3.2 3B ~2,200 MB、Phi-4 Mini ~2,700 MB、Gemma 3 4B ~2,900 MBです。ファイルのサイズは、モデルが実行中に占有するRAMにもほぼ等しく、そこに推論のオーバーヘッドとして約500 MBが加わります。Q5_K_Mのファイルは約25%大きくなります。
SmolLM 3やSmolLM 4はありますか?
SmolLM 3は存在します:Hugging Faceが2025年7月に公開した3Bパラメータのモデルで、思考モードと非思考モード、64kの学習コンテキスト(YaRNで最大128k)、英語・フランス語・スペイン語・ドイツ語・イタリア語・ポルトガル語への対応を備えています。このページの最終更新時点ではSmolLM 4は存在せず、Hugging Faceは公開していませんでした。SmolLM 3は、実機で検証された数値がないため、この記事の速度比較には含まれていませんが、3BなのでLlama 3.2 3Bと同じサイズクラスに入ります。
Gemma 3nとは何ですか? スマートフォンではGemma 3より優れていますか?
Gemma 3nは、E2BとE4Bのサイズで提供される、オンデバイス利用のために作られたGoogleのモデルファミリーです。「E」はeffective parameters(実効パラメータ)を意味し、E2Bは50億を超える生のパラメータを読み込みますが、メモリ負荷が20億弱(1.91B)で動作できます。テキスト、画像、音声の入力に対応し、140以上の言語をカバーします。Gemma 3 4Bとはトレードオフが異なり、単純な上位互換ではありません。また、検証済みの数値がまだないため、この記事の速度比較には含まれていません。
スマートフォンのLLMで画像キャプションや代替テキストは書けますか?
ビジョン対応のモデルであれば可能です。ここで扱う6モデルのうち、画像を扱えるのはGemma 3 4Bだけで、残りの5つはテキスト専用です。Gemma 3nとSmolVLM2(256M、500M、2.2B)も画像を扱えます。llama.cppベースのアプリは別のビジョンプロジェクターファイルを必要とするため、アプリがそのモデルの画像入力を提供している必要があります。小型のビジョンモデルは文字を読み間違えたり物を誤ってラベル付けしたりすることがあるので、公開する前にすべてのキャプションを確認してください。
スマートフォン向けに2.5Bパラメータのモデルはありますか?
ここで扱う主流のスマートフォン向けモデルにはありません。最も近いサイズは、1.7Bクラス(SmolLM 2、Qwen3)と3Bクラス(Llama 3.2 3B、SmolLM 3)です。Gemma 3n E2Bが考え方として最も近く、50億を超える生のパラメータを読み込みますが、実効的なメモリ負荷は20億弱で動作します。
オフラインの要約で、MBあたりの精度が最も高いモデルはどれですか?
この記事には独自の精度ベンチマークがないため、答えは定性的なものになります。短い要約では、1.1 GBのモデル(Qwen3 1.7B、SmolLM 2 1.7B)が効率の良い中間点で、英語以外の文章ならQwen3です。メモリを割けるなら、6モデルのうち品質の上限はPhi-4 Mini(~2.7 GB)で、Gemma 3 1B(~720 MB)は、まとまった短い要約を作れる最小のモデルです。
スマートフォンのLLMは100ミリ秒未満で応答できますか?
完全な回答では無理です。iPhone 17 Proでは、トークン生成だけでPhi-4 Miniは1トークンあたり~55〜77 ms(13〜18 tok/sec)、Gemma 3 1Bは~22〜29 ms(35〜45 tok/sec)かかるため、最速のモデルでも20トークンの返答におよそ0.5秒かかります。100 ms未満が現実的なのは、非常に短い分類出力のようなごく数トークンの場合だけで、チャットやキャプション生成では実現できません。
モバイルモデルは2027年でもまだ有用ですか?
はい、ただし具体的なモデル名は変わります。モバイルの小型LLMフロンティアは約6〜9ヶ月ごとに動きます — 2026年Q4には新しい~3Bモデルが登場してPhi-4 Miniを上回る可能性が高く、2027年半ばには1B〜2Bクラスが今日の3B〜4Bモデルがすることをするようになるでしょう。このカテゴリーは廃れません;具体的な選択が変わります。次世代のラインナップについては(次回更新予定:2027-04-19)このArticleを再確認してください。