Kurzfakten
- Verglichene Modelle: Phi-4 Mini 3.8B, Gemma 3 4B, Gemma 3 1B, SmolLM 2 1.7B, Qwen3 1.7B, Llama 3.2 3B (alle Q4_K_M GGUF).
- Referenzgeräte: iPhone 17 Pro (A19 Pro), iPhone 16 Pro (A18 Pro, 8 GB), Galaxy S25 Ultra (Snapdragon 8 Elite), Pixel 9 Pro (Tensor G4), OnePlus 13 (Snapdragon 8 Elite). Die Geschwindigkeitsangaben auf dieser Seite sind indikative Schätzwerte, keine Messungen von PromptQuorum; die tatsächliche Geschwindigkeit hängt von App, Runtime, Quantisierung, Gerätetemperatur und Einstellungen ab.
- Inferenz-Engines: llama.cpp über PocketPal AI / LLM Farm (Standard), MLC LLM über MLC Chat (Metal-beschleunigt auf iPhone), Ollama über Termux (Android).
- Speicherbedarf (Q4_K_M): Phi-4 Mini ~2,7 GB, Gemma 3 4B ~2,9 GB, Llama 3.2 3B ~2,2 GB, Qwen3 1.7B ~1,1 GB, SmolLM 2 1.7B ~1,1 GB, Gemma 3 1B ~720 MB.
- Mindest-RAM (aktiv): 6-GB-Gerät für 1,7B-Modelle; 8-GB-Gerät für 3B–4B-Modelle; 4-GB-Gerät nur für Gemma 3 1B.
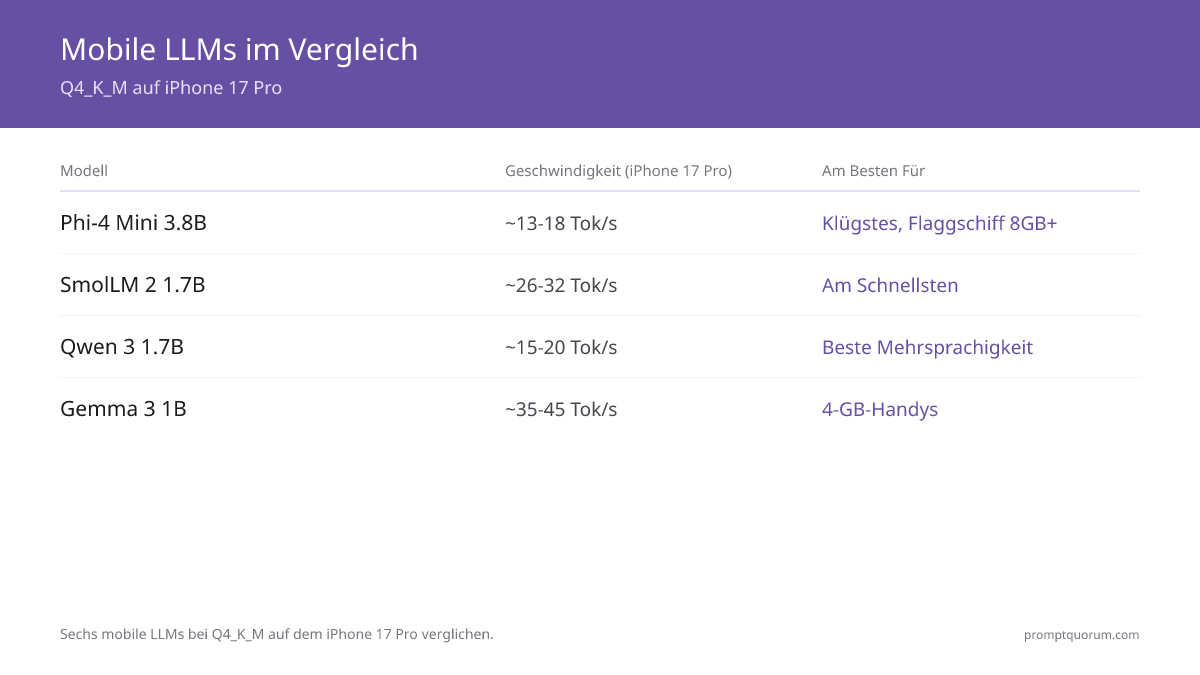
- Schnellste Tokens/Sek. auf iPhone 17 Pro: Gemma 3 1B ~35–45, SmolLM 2 ~26–32, Qwen3 ~24–32, Llama 3.2 3B ~16–22, Phi-4 Mini ~13–18, Gemma 3 4B ~10–13.
- Quelle der Quantisierung: alle sechs als Q4_K_M GGUF auf Hugging Face und über PocketPal AI / MLC Chat / LM Studio verfügbar.
- Download-Größe (Q4_K_M, MB): Gemma 3 1B ~720, Qwen3 1.7B ~1.100, SmolLM 2 ~1.100, Llama 3.2 3B ~2.200, Phi-4 Mini ~2.700, Gemma 3 4B ~2.900 – siehe Größentabelle weiter unten.
- Neuere Modelle, nicht im Geschwindigkeitsvergleich: SmolLM 3 (3B, Hugging Face, Juli 2025) und Gemma 3n (E2B / E4B, Google). Bildeingabe: unter den sechs nur Gemma 3 4B.
Welches mobile Modell sollten Sie wählen?
Für die meisten Flaggschiff-Smartphones (iPhone 16 Pro / 17 Pro, Galaxy S25 Ultra, OnePlus 13) empfehlen wir Phi-4 Mini (3.8B Q4_K_M). Es ist das klügste Modell unter 4B und läuft mit nutzbarer Gesprächsgeschwindigkeit. Wählen Sie ein anderes Modell nur, wenn Sie einen spezifischen Bedarf haben, den es nicht abdeckt – Geschwindigkeit (SmolLM 2), Mehrsprachigkeit (Qwen3) oder Kompatibilität mit älteren Geräten (Gemma 3 1B).
📍 In einem Satz
Phi-4 Mini für Flaggschiff-Smartphones mit 8 GB+ RAM (klügster), SmolLM 2 1.7B für Geschwindigkeit, Qwen3 1.7B für mehrsprachige Nutzung, Gemma 3 1B für 4-GB-Geräte, Llama 3.2 3B für Tool Calling und Gemma 3 4B als ausgewogener Standard, wenn Phi-4 Mini nicht verfügbar ist.
💬 In einfachen Worten
Es gibt kein einzelnes bestes Mobilmodell – die richtige Wahl hängt von Ihrem Gerät und Ihrer Nutzung ab. Wenn Ihr Smartphone aus den letzten zwei Jahren stammt und 8 GB oder mehr RAM hat, installieren Sie Phi-4 Mini. Wenn Sie hauptsächlich in einer anderen Sprache als Englisch chatten, installieren Sie Qwen3. Wenn Sie die schnellsten Antworten wünschen, auch auf Kosten von etwas Qualität, installieren Sie SmolLM 2. Wenn Ihr Gerät älter ist oder nur 4 GB RAM hat, installieren Sie Gemma 3 1B. Die Unterschiede sind real, aber klein genug, dass jedes dieser Modelle kohärente Antworten liefert – keines erreicht Cloud-Qualität.
Entscheidung: Welches Mobilmodell?
Lokales LLM nutzen, wenn:
- •Flaggschiff-Smartphone mit 8 GB+ RAM (iPhone 16 Pro/17 Pro, Galaxy S25 Ultra, OnePlus 13) → Phi-4 Mini 3.8B
- •Schnellste Tokens/Sek. auf jedem Gerät benötigt → SmolLM 2 1.7B
- •Nicht-englische Nutzung (Übersetzung, mehrsprachiger Chat) → Qwen3 1.7B
- •Breite App-Kompatibilität, Tool Calling oder RAG benötigt → Llama 3.2 3B
- •Älteres Gerät mit 4 GB RAM → Gemma 3 1B
- •Phi-4 Mini in Ihrer App nicht verfügbar, 4B-Klasse-Qualität benötigt → Gemma 3 4B
Cloud-Modell nutzen, wenn:
- •Mehrstufige Schlussfolgerung, komplexe Code-Generierung oder Langdokumentenanalyse → Cloud oder Remote-Verbindung zu einem Heimrechner mit 70B+
- •Dichte OCR oder genauigkeitskritische Bildanalyse → Cloud-Apps; einfache Bildbeschreibungen laufen mit Gemma 3 4B auch on-device (siehe „Multimodal auf Smartphones“ weiter unten)
- •Längeres kreatives Schreiben, bei dem die Kohärenz über 3.000+ Token wichtig ist → Cloud oder 8B+ auf einem Desktop
Schnelle Entscheidung:
- →Standard für die meisten Nutzer: Phi-4 Mini 3.8B
- →Schnellstes auf jedem Gerät: SmolLM 2 1.7B
- →Beste Mehrsprachigkeit: Qwen3 1.7B

💡Tipp: Wenn Sie unsicher sind, beginnen Sie mit Phi-4 Mini auf einem Flaggschiff-Gerät oder SmolLM 2 1.7B auf einem Mittelklassegerät – beide sind in unter 5 Minuten bei schneller Verbindung heruntergeladen und können rückgängig gemacht werden. Testen Sie eine Aufgabe, die Ihnen wirklich wichtig ist (eine echte E-Mail zum Zusammenfassen, eine echte Frage zu beantworten). Wenn die Qualität akzeptabel ist, haben Sie Ihren Standard. Falls nicht, wechseln Sie in 30 Sekunden über PocketPal AI oder LM Studio zum nächsten Modell.
Vergleichstabelle mobiler Modelle
Die folgende Vier-Spalten-Tabelle ist die schnelle Übersicht – wählen Sie eine Zeile nach Ihrer Geräteklasse oder Ihrem Anwendungsfall. Die Tokens/Sek.-Werte sind indikative Schätzwerte (keine Messungen von PromptQuorum) und gehen von Q4_K_M-Quantisierung auf dem iPhone 17 Pro mit PocketPal AI (llama.cpp) aus. Auf dem iPhone 16 Pro liegen die Werte um 15–25 % und auf dem Galaxy S25 Ultra (mit MLC Chat oder Termux+Ollama) um ca. 10–20 % niedriger.
📍 In einem Satz
Phi-4 Mini ist das klügste, SmolLM 2 1.7B das schnellste, Qwen3 1.7B das beste für Mehrsprachigkeit, Gemma 3 1B das kleinste brauchbare, Llama 3.2 3B der stärkste 3B-Allrounder und Gemma 3 4B der ausgewogene Standard.
💬 In einfachen Worten
Lesen Sie die Tabelle von oben nach unten nach Größenordnung oder springen Sie direkt zur Zeile, die Ihrer Geräteklasse entspricht. Die Spalte „Geeignet für" zeigt, worauf das Modell optimiert ist – wählen Sie die Zeile, deren Stärke für Sie am wichtigsten ist, und ignorieren Sie die anderen.
Modell | Größe | Tokens/Sek. (17 Pro) | Geeignet für |
|---|---|---|---|
| Phi-4 Mini | 3,8B | ~13–18 | Klügstes kleines Modell – Standard für Flaggschiffgeräte |
| Gemma 3 4B | 4B | ~10–13 | Ausgewogener Standard, wenn Phi-4 Mini nicht verfügbar |
| Gemma 3 1B | 1B | ~35–45 | Ältere Geräte (4 GB RAM) |
| SmolLM 2 | 1,7B | ~26–32 | Schnellste Tokens/Sek., reaktionsschneller Chat |
| Qwen3 | 1,7B | ~24–32 | Beste Mehrsprachigkeit (35+ Sprachen) |
| Llama 3.2 | 3B | ~16–22 | Stärkste 3B-Option, Tool Calling, RAG |
Hinweis zum Geschwindigkeit-Qualität-Kompromiss: Tokens/Sek. skaliert umgekehrt proportional zur Parameteranzahl auf demselben Chip – ein 1B-Modell ist auf gleicher Hardware ca. 3–4× schneller als ein 3,8B-Modell. Qualität skaliert mit Parametern, aber nicht linear: Phi-4 Mini (3.8B) Schlussfolgerungsqualität liegt näher an einem 7B-Modell als an einem 1,7B-Modell dank Microsofts Trainings-Datenmix. Nutzen Sie die Tabelle für die Abwägung: schnelleres Modell = schnellere Antwort, klügeres Modell = bessere Antwort bei schwierigen Fragen.

💡Tipp: Auf dem iPhone 16 Pro sind die Tokens/Sek.-Werte für jedes Modell in dieser Tabelle ca. 15–25 % niedriger als auf dem iPhone 17 Pro – Unterschied zwischen A18 Pro und A19 Pro Neural Engine. Das Galaxy S25 Ultra (Snapdragon 8 Elite) liegt ca. 10–20 % unter dem iPhone 17 Pro für dasselbe Q4_K_M GGUF, hauptsächlich weil Termux+Ollama auf Android den Snapdragon Hexagon NPU noch nicht so nutzt wie MLC Chat Apple Metal.
Phi-4 Mini: Intelligentestes kleines Modell
Phi-4 Mini (3,8B Parameter, Microsoft, Dezember 2024) ist dank eines auf Schlussfolgerung optimierten Trainings-Datenmixes das klügste Modell unter 4B in 2026. Es übertrifft Gemma 3 4B und Llama 3.2 3B bei Chain-of-Thought-Aufgaben, obwohl es ähnlich groß ist. Verwenden Sie es als Standard auf jedem Smartphone mit 8 GB+ RAM.
- Parameter und Training: 3,8B Parameter; trainiert auf einem von Microsoft kuratierten Mix aus hochwertigen Webtexten, synthetischen Schlussfolgerungsketten und akademischen Inhalten. Architektur ist ein Transformer mit Grouped-Query Attention.
- Speicherbedarf: ~2,7 GB bei Q4_K_M, ~3,5 GB bei Q5_K_M. Passt problemlos auf iPhone 16 Pro / 17 Pro (8 GB) und Galaxy S25 Ultra (12 GB) mit Platz für das Betriebssystem.
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~13–18, iPhone 16 Pro ~10–15, Galaxy S25 Ultra ~10–15 (Termux+Ollama), iPhone 14 Pro ~6–10 (langsam, aber funktional).
- Qualitätsstärken: Chain-of-Thought-Schlussfolgerung, Zusammenfassung, faktisches Fragen-Antworten, einfache Code-Generierung. Übertrifft ähnlich große Open-Source-Modelle auf Standardbenchmarks (MMLU, GSM8K).
- Qualitätsschwächen: geringeres Weltwissen als Llama 3.2 3B (weniger Common-Crawl-Exposition); kürzere natürliche kreative Texte als Gemma 3 4B; schwächer mehrsprachig als Qwen3 1.7B außerhalb des Englischen.
- Optimal für: Nutzerinnen und Nutzer mit Flaggschiff-Smartphone, die den klügsten Einzel-Modell-Standard für englischsprachigen Chat, Zusammenfassung und Schlussfolgerung wünschen.
💡Tipp: Phi-4 Mini profitiert von einem System-Prompt, der schrittweises Schlussfolgern explizit einfordert („Denken Sie dies sorgfältig durch, bevor Sie antworten"). Die Trainingsdaten waren reich an Schlussfolgerungsketten, weshalb ein entsprechend formulierter Prompt konsistent bessere Antworten liefert als knappe Anweisungen. Für schnellen Chat ist kein System-Prompt erforderlich; das Standardverhalten ist bereits konversationell.
Gemma 3 4B: Ausgewogener Standard
Gemma 3 4B (Google DeepMind, 2025) ist der ausgewogene Standard, wenn Phi-4 Mini in Ihrer App nicht verfügbar ist oder Sie Googles Trainings-Datenmix bevorzugen. Auf gleicher Hardware etwas langsamer als Phi-4 Mini, aber bei Chat und Zusammenfassung gleichwertig, mit breiterer natürlichsprachlicher Abdeckung.
- Parameter und Training: 4B Parameter; trainiert auf Googles kuratierten Mix aus Webtexten, Code und mehrsprachigen Daten. Gleiche Architekturfamilie wie Gemma 2 mit erweitertem Kontext.
- Speicherbedarf: ~2,9 GB bei Q4_K_M, ~3,7 GB bei Q5_K_M. Passt auf 8-GB-Geräte; auf 6-GB-Geräten eng (stattdessen Phi-4 Mini oder kleineres Modell verwenden).
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~10–13, iPhone 16 Pro ~7–10, Galaxy S25 Ultra ~7–10 (etwas langsamer als Phi-4 Mini trotz ähnlicher Größe aufgrund von Architekturunterschieden).
- Qualitätsstärken: natürlicher Gesprächston, starke Zusammenfassung, breiteres Weltwissen als Phi-4 Mini (Common-Crawl-Exposition), ordentliche Mehrsprachigkeit.
- Qualitätsschwächen: schwächere Chain-of-Thought-Schlussfolgerung als Phi-4 Mini; langsamere Tokens/Sek. auf gleicher Hardware; nicht immer das erste Modell in mobilen Apps (zeitlicher Rückstand gegenüber Phi-4 Mini in PocketPal AI).
- Optimal für: Flaggschiff-Nutzerinnen und -Nutzer, die ein von Google trainiertes Modell als Phi-4-Mini-Alternative wünschen, insbesondere für alltäglichen Chat, Zusammenfassung und kurzes Verfassen.
💡Tipp: Gemma 3 4B verwendet ein anderes Chat-Template als Phi-4 Mini – stellen Sie sicher, dass Ihre App das korrekte Gemma-Template verwendet (mit <start_of_turn>-Markierungen). Ein falsches Template erzeugt fehlerhafte oder sich wiederholende Ausgabe. PocketPal AI, MLC Chat und LM Studio erkennen dies automatisch; LLM Farm erfordert die manuelle Auswahl des Gemma-Templates unter „Modelleinstellungen".
Gemma 3 1B: Leichtgewicht für ältere Geräte
Gemma 3 1B (Google DeepMind, 2025) ist das kleinste brauchbare Mobilmodell in 2026 – ~720 MB bei Q4_K_M und läuft auf 4-GB-Geräten. Die Qualität ist auf kurze kohärente Antworten (1–2 Absätze) beschränkt, aber es ist die einzige Option unter 1 GB, die auf schwacher Hardware brauchbare Ausgabe erzeugt.
- Parameter und Training: 1B Parameter; gleiche Gemma-3-Familienarchitektur wie das 4B-Modell, aber mit reduziertem Trainingsaufwand. Für effiziente Inferenz auf Edge-Geräten trainiert.
- Speicherbedarf: ~720 MB bei Q4_K_M, ~900 MB bei Q5_K_M. Läuft auf iPhone SE 3. Generation, iPhone 12 / 13, älterem Android (mindestens 4 GB RAM).
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~35–45, iPhone 16 Pro ~28–38, iPhone 14 ~20–28, älteres Android (4 GB) ~10–15. Schnellstes Modell in diesem Vergleich auf jedem Gerät.
- Qualitätsstärken: Geschwindigkeit, geringer Speicherbedarf, kohärente Kurzantworten, niedriger Akkuverbrauch.
- Qualitätsschwächen: schwache mehrstufige Schlussfolgerung, häufige Faktenfehler bei Nischenthemen, Wiederholungen bei langen Generierungen (>500 Token), geringe Gesprächstiefe.
- Optimal für: Nutzerinnen und Nutzer mit Geräten unter der 6-GB-RAM-Schwelle, die dennoch On-Device-KI wünschen, oder alle, die bei langen Flügen oder in akkuarmen Szenarien auf die Akkulaufzeit optimieren.
💡Tipp: Verwenden Sie Gemma 3 1B für kurze, fokussierte Aufgaben – einzeilige Zusammenfassungen, Einabsatz-Entwürfe, schnelle Definitionen, einfache Übersetzungen zwischen gängigen Sprachpaaren. Vermeiden Sie mehrseitige Erklärungen, mehrstufige Schlussfolgerungen oder Aufgaben, bei denen die Genauigkeit bei Nischenfakten wichtig ist. Das Modell kennt seine Grenzen; der Prompt „Sei prägnant" spielt seinen Stärken in die Hände.
SmolLM 2 1,7B: Schnellste Tokens pro Sekunde
SmolLM 2 1.7B (Hugging Face, 2024) ist das schnellste Mobilmodell (Tokens pro Sekunde) in diesem Vergleich auf jedem Referenz-Smartphone. ~26–32 Tok/Sek. auf dem iPhone 17 Pro und ~20–28 auf dem Galaxy S25 Ultra. Optimal, wenn Reaktionsschnelligkeit wichtiger ist als Antworttiefe.
- Parameter und Training: 1,7B Parameter; trainiert auf einem von Hugging Face kuratierten Mix, der auf Effizienz kleiner Modelle optimiert ist. Architektur auf niedrige Inferenzlatenz auf Consumer-Hardware ausgelegt.
- Speicherbedarf: ~1,1 GB bei Q4_K_M. Passt auf jedes Gerät mit 6 GB+ RAM mit erheblichem Betriebssystem-Spielraum.
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~26–32, iPhone 16 Pro ~22–28, Galaxy S25 Ultra ~20–28, iPhone 14 Pro ~15–22. Ca. 2× schneller als Phi-4 Mini auf demselben Chip.
- Qualitätsstärken: reaktionsschnelle Gesprächsantworten, einfaches Fragen-Antworten, Autovervollständigungs-Fortsetzung, englischsprachiges Verfassen.
- Qualitätsschwächen: schwächere Schlussfolgerung als Phi-4 Mini, geringeres Weltwissen als Llama 3.2 3B, schwächere Mehrsprachigkeit als Qwen3 1.7B, gelegentliche Halluzinationen bei Faktenabfragen.
- Optimal für: Mittelklassegeräte, bei denen Latenz wichtig ist (Texteingabe-Autovervollständigung, Sprachassistent-Turns, Echtzeit-Chat), oder ältere Flaggschiffe, bei denen größere Modelle sich träge anfühlen.

💡Tipp: SmolLM 2 1.7B ist die beste Kombination für einen Offline-Sprachassistenten auf dem Smartphone – weitere Informationen finden Sie unter Lokalen Sprachassistenten auf dem Smartphone erstellen für die Whisper-+-LLM-+-TTS-Pipeline. Die hohen Tokens/Sek. halten die Sprachgesprächs-Wartezeit unter der ~1,5-Sekunden-Wahrnehmungsschwelle, selbst auf Mittelklasse-Hardware.
Qwen3 1,7B: Stärkstes mehrsprachiges Mobilmodell
Qwen3 1.7B (Alibaba, 2024) ist das stärkste mehrsprachige Mobilmodell in 2026 – trainiert auf 35+ Sprachen, darunter Chinesisch, Japanisch, Koreanisch, Arabisch, Deutsch, Französisch, Spanisch und Russisch. Beste Wahl für Übersetzung, nicht-englischsprachigen Chat und Reisenutzung, bei der die Nutzerinnen und Nutzer mitten im Gespräch die Sprache wechseln.
- Parameter und Training: 1,7B Parameter; trainiert auf Alibabas mehrsprachigem Korpus mit starker Repräsentation von CJK-Sprachen, Arabisch und den wichtigsten europäischen Sprachen. Architektur für mehrsprachiges Schlussfolgern optimiert.
- Speicherbedarf: ~1,1 GB bei Q4_K_M. Passt auf jedes Gerät mit 6 GB+ RAM.
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~24–32, iPhone 16 Pro ~20–28, Galaxy S25 Ultra ~18–26, iPhone 14 Pro ~14–20. Vergleichbare Geschwindigkeit wie SmolLM 2.
- Qualitätsstärken: muttersprachliche Ausgabequalität in 35+ Sprachen (die meisten kleinen Modelle sind englischzentriert mit schwachem mehrsprachigem Fallback), starke Übersetzung zwischen wichtigen Sprachpaaren, kohärente CJK-Ausgabe, bei der Phi-4 Mini und Llama 3.2 unleserliche Zeichen produzieren.
- Qualitätsschwächen: rein englische Schlussfolgerung etwas schwächer als Phi-4 Mini, kürzere natürliche kreative Texte als Gemma 3 4B, schwächeres Tool Calling als Llama 3.2 3B.
- Optimal für: nicht-englischsprachige Nutzerinnen und Nutzer (insbesondere Chinesisch-, Japanisch-, Deutsch-, Spanisch- und Französischsprechende), Reisende, die Offline-Übersetzung benötigen, oder Entwicklerinnen und Entwickler, die mehrsprachige mobile Funktionen erstellen.
💡Tipp: Für die einmalige Übersetzung zwischen zwei bestimmten Sprachpaaren übertrifft Qwen3 1.7B in der Regel ein größeres englischzentriertes Modell, das Übersetzung als Nebenaufgabe ausführt. Für eine deutschsprachige Nutzerin oder einen deutschsprachigen Nutzer, der auf Deutsch chattet, erzeugt Qwen3 merklich natürlichere Ausgabe als Phi-4 Mini, obwohl es 60 % kleiner ist. Die einfache Regel: Wählen Sie das Modell, das für Ihre Hauptsprache trainiert wurde, nicht das Modell mit den meisten Parametern.
Llama 3.2 3B: Zuverlässiger 3B-Allrounder
Llama 3.2 3B (Meta, 2024) ist das am weitesten unterstützte 3B-Modell in 2026 – breiteste App-Kompatibilität, stärkste Tool-Calling-Unterstützung unter den sechs Modellen und das größte Community-Fine-Tune-Ökosystem. Etwas hinter Phi-4 Mini bei der Rohqualität, aber zuverlässiger in Grenzfällen und besser von mobilen Apps unterstützt.
- Parameter und Training: 3B Parameter; trainiert auf Metas großem Pretraining-Korpus mit Instruction-Tuning für Chat und Tool-Nutzung. Gleiche Llama-3-Architektur wie die 8B- und 70B-Geschwister.
- Speicherbedarf: ~2,2 GB bei Q4_K_M, ~2,8 GB bei Q5_K_M. Passt auf 8-GB-Geräte mit ausreichend Betriebssystem-Spielraum; funktioniert auf engen 6-GB-Geräten, wenn andere Apps geschlossen sind.
- Geschwindigkeit (Tokens/Sek.): iPhone 17 Pro ~16–22, iPhone 16 Pro ~12–18, Galaxy S25 Ultra ~12–18, iPhone 14 Pro ~7–11.
- Qualitätsstärken: breites Weltwissen, robuste Tool-Calling- und Function-Calling-Unterstützung (beste in seiner Klasse unter Modellen unter 4B), zuverlässiges Chat-Verhalten, reifes Ökosystem an Fine-Tunes für spezifische Aufgaben (Medizin, Recht, Code).
- Qualitätsschwächen: schwächere Chain-of-Thought-Schlussfolgerung als Phi-4 Mini, etwas niedrigere MMLU-Werte bei ähnlicher Größe, weniger natürlicher Gesprächston als Gemma 3 4B.
- Optimal für: mobile Apps, die Tool Calling oder Function Calling benötigen (RAG über lokale Dokumente, On-Device-Agent-Workflows), oder Nutzerinnen und Nutzer, die das Modell mit der größten Community-Fine-Tune-Bibliothek wünschen.
💡Tipp: Llama 3.2 3B ist das einzige Modell in diesem Vergleich mit breiter Tool-Calling-Unterstützung, die für On-Device-Agent-Workflows zuverlässig genug ist – weitere Informationen unter Lokale KI-Agenten mit MCP 2026. Phi-4 Mini und SmolLM 2 können technisch Tool Calls ausführen, aber Llama 3.2 3B ist 2026 das einzige produktionsreife Modell dafür.
SmolLM 3 und Gemma 3n: Neuere kleine Modelle
SmolLM 3 (Hugging Face, Juli 2025) und Gemma 3n (Google) sind die beiden neueren kleinen Modelle, nach denen Leserinnen und Leser am häufigsten fragen. Keines von beiden steckt im Sechs-Modelle-Geschwindigkeitsvergleich oben, weil zum Zeitpunkt der Veröffentlichung keine verifizierten On-Device-Werte für Tokens/Sek. vorliegen. Stand der letzten Aktualisierung dieser Seite gibt es kein SmolLM 4: Hugging Face hatte keines veröffentlicht, und SmolLM 3 war die neueste Generation der SmolLM-Familie.
- SmolLM 3 (3B): ein Modell mit 3B Parametern, trainiert auf etwa 11 Billionen Tokens, mit Thinking- und Non-Thinking-Modus. Es wurde mit 64k Kontext trainiert und kann bei der Inferenz per YaRN-Extrapolation bis zu 128k verarbeiten. Offiziell unterstützte Sprachen: Englisch, Französisch, Spanisch, Deutsch, Italienisch und Portugiesisch. Hugging Face beschreibt es bei den Base-Model-Benchmarks als konkurrenzfähig zu den größeren Modellen Qwen3 4B und Gemma 3 4B und weist darauf hin, dass Qwen3 4B insgesamt am besten abschneidet.
- SmolLM 3 auf dem Smartphone: mit 3B Parametern liegt es in der Größenklasse von Llama 3.2 3B – erwarten Sie eine Q4_K_M-Datei von grob 2 GB und die 8-GB-RAM-Stufe aus der Tabelle nach Geräteklasse. Das ist eine Schätzung anhand der Parameterzahl, keine Messung.
- Gemma 3n (E2B und E4B): das „E“ steht für effektive Parameter. E2B lädt über 5 Milliarden Roh-Parameter, kann aber dank Parameter-Skipping und Per-Layer-Embedding-Caching mit einer Speicherlast von knapp unter 2 Milliarden (1,91B) laufen. Gemma 3n nimmt Text-, Bild- und Audioeingabe entgegen, wurde auf über 140 Sprachen trainiert und hat ein Kontextfenster von 32K Tokens.
- Welches wählen: SmolLM 3, wenn Sie ein 3B-Modell mit Thinking-Modus für Englisch oder eine große europäische Sprache wollen. Gemma 3n, wenn Ihre App Bild- oder Audioeingabe unterstützt. Ansonsten bleiben die sechs Modelle oben der Standard dieses Vergleichs.
💡Tipp: Bewerten Sie jedes neue kleine Modell zuerst nach RAM, dann nach Geschwindigkeit. Suchen Sie die Dateigröße der Q4_K_M-Variante, ordnen Sie sie der Tabelle nach Geräteklasse zu und lesen Sie erst danach die Benchmark-Angaben. Die App-Unterstützung hinkt Modellveröffentlichungen außerdem hinterher – fehlt ein Modell in der kuratierten Liste Ihrer App, laden Sie das GGUF per Sideloading von Hugging Face.
Quantisierung für Mobilgeräte: Q4_K_M als Standard
Q4_K_M ist die Standard-Quantisierung für mobile LLM-Inferenz in 2026 – erhält ~95 % der ursprünglichen Modellqualität bei einem Viertel der Dateigröße. Verwenden Sie Q5_K_M oder Q6_K nur auf Geräten mit 12 GB+ RAM (iPhone 17 Pro Max, Galaxy S25 Ultra), wo der zusätzliche Speicher tatsächlich frei verfügbar ist.
📍 In einem Satz
Q4_K_M ist der mobile Standard – ~95 % Qualität bei einem Viertel der Größe. Q5_K_M / Q6_K lohnen sich nur auf Geräten mit 12 GB+ RAM.
💬 In einfachen Worten
Modelle auf Hugging Face werden in voller Präzision veröffentlicht (jeder Parameter als 16-Bit-Zahl gespeichert). Auf Smartphones laden Sie eine quantisierte Version herunter, bei der jeder Parameter auf 4 Bit komprimiert wird – die Datei wird viermal kleiner und die Inferenz ca. viermal schneller, bei leichtem Qualitätsverlust. Q4_K_M ist die Variante, auf die sich alle 2026 als richtige Balance für Smartphones geeinigt haben. Höhere Q-Zahlen (Q5, Q6, Q8) bedeuten weniger Komprimierung und bessere Qualität, aber größere Dateien; Q4 ist der Sweet Spot für Smartphone-Beschränkungen.
- Q4_K_M (empfohlener Standard): 4-Bit-Quantisierung mit K-Quants und gemischter „M"-Präzision. ~95 % der ursprünglichen Qualität. Standard für Mobilgeräte in 2026. Alle sechs Modelle in diesem Format auf Hugging Face verfügbar.
- Q5_K_M (für Geräte mit 12 GB+ RAM): 5-Bit-Quantisierung. ~98 % der ursprünglichen Qualität. ~25 % größere Dateien. Lohnt sich auf iPhone 17 Pro Max (12 GB) oder Galaxy S25 Ultra (12 GB) für Phi-4 Mini und Llama 3.2 3B; der RAM-Aufpreis ist auf 8-GB-Geräten nicht gerechtfertigt.
- Q6_K (selten benötigt): 6-Bit-Quantisierung. ~99 % der ursprünglichen Qualität. ~50 % größere Dateien. Lohnt sich nur für speicherreiche Smartphones mit Modellen, bei denen Qualität wirklich wichtig ist (z. B. langer Textentwurf, bei dem jeder Qualitätsprozentpunkt zählt).
- Q8_0 (auf Mobilgeräten vermeiden): 8-Bit-Quantisierung. ~99,5 % der ursprünglichen Qualität. Ca. 2× die Größe von Q4_K_M. Der RAM-Aufpreis auf Smartphones lohnt sich nicht; für Desktop-/Laptop-Nutzung reservieren.
- Q3_K_M / Q2_K (nur für sehr eingeschränkte Geräte): 3-Bit- und 2-Bit-Quantisierung. Qualität sinkt auf ~85–90 %. Nur verwenden, wenn Gemma 3 1B bei Q4_K_M immer noch nicht passt (in 2026 selten).

⚠️Warnung: Laden Sie nicht dasselbe Modell in mehreren Quantisierungen herunter, um zu „testen, welche besser ist". Die Qualitätsunterschiede zwischen Q4_K_M und Q5_K_M sind real, aber gering, und Sie verbrauchen 5+ GB Smartphone-Speicher für redundante Varianten. Wählen Sie Q4_K_M, nutzen Sie es eine Woche lang real, und steigen Sie auf Q5_K_M nur um, wenn Sie konkrete Hinweise haben, dass die Qualität unzureichend ist.
Download-Größen der Modelle in MB
Bei Q4_K_M reichen die sechs Modelle von ~720 MB (Gemma 3 1B) bis ~2.900 MB (Gemma 3 4B). Rechnen Sie zusätzlich zur Dateigröße mit etwa 500 MB RAM Overhead für die Inferenz und halten Sie pro 3B–4B-Modell, das Sie behalten möchten, mindestens 3 GB freien Speicher bereit.
📍 In einem Satz
Dateigrößen bei Q4_K_M: Gemma 3 1B ~720 MB, Qwen3 1.7B und SmolLM 2 ~1.100 MB, Llama 3.2 3B ~2.200 MB, Phi-4 Mini ~2.700 MB, Gemma 3 4B ~2.900 MB.
💬 In einfachen Worten
Die heruntergeladene Datei entspricht grob dem Arbeitsspeicher, den das Modell beim Laufen belegt, plus etwas Overhead. Deshalb ist die Dateigröße – nicht die Parameterzahl – der Wert, den Sie mit Ihrem Smartphone abgleichen sollten. Passen Modell und Betriebssystem zusammen nicht in Ihren RAM, beendet das Smartphone das Modell mitten in der Antwort.
Modell | Größe Q4_K_M (MB) | Mindest-RAM des Smartphones | Hinweis zu Größe und Qualität |
|---|---|---|---|
| Gemma 3 1B | ~720 | 4 GB | Kleinstes brauchbares Modell; nur kurze Antworten |
| Qwen3 1.7B | ~1.100 | 6 GB | Beste mehrsprachige Ausgabe pro MB |
| SmolLM 2 1.7B | ~1.100 | 6 GB | Schnellstes Modell pro MB; einfache Schlussfolgerung |
| Llama 3.2 3B | ~2.200 | 8 GB (6 GB sind knapp) | Kleiner als die 4B-Modelle; bestes Tool Calling |
| Phi-4 Mini | ~2.700 | 8 GB | Stärkste Schlussfolgerung pro Parameter |
| Gemma 3 4B | ~2.900 | 8 GB | Größte Datei; natürliche Zusammenfassungen; nimmt Bilder entgegen |
Zur Genauigkeit pro Byte: Dieser Artikel enthält keinen eigenen Genauigkeits-Benchmark – verstehen Sie die letzte Spalte daher als qualitative Orientierung. Für Offline-Zusammenfassungen sind die 1,1-GB-Modelle (Qwen3 1.7B, SmolLM 2) die effiziente Mitte; Phi-4 Mini ist die Qualitätsobergrenze, wenn Sie 2,7 GB entbehren können.
Urteil nach Geräteklasse: Flaggschiff vs. Mittelklasse vs. Budget
Die Geräteklasse bestimmt die Modellobergrenze – Chip-Generation und RAM sind wichtiger als die Marke. Ein Flaggschiff-Smartphone (8 GB+ RAM, A18 Pro / A19 Pro / Snapdragon 8 Elite) läuft mit 3,8B–4B-Modellen komfortabel; ein Mittelklassegerät (6–8 GB RAM, älterer Flaggschiff-Chip) mit 1,7B–3B; ein Budget- oder älteres Gerät (4–6 GB RAM) mit 1B–1,7B.
📍 In einem Satz
Flaggschiff-Smartphones (8 GB+) → Phi-4 Mini 3.8B; Mittelklasse (6–8 GB) → SmolLM 2 1.7B oder Llama 3.2 3B; Budget oder älter (4–6 GB) → Gemma 3 1B oder Qwen3 1.7B.
💬 In einfachen Worten
Passen Sie das Modell an Ihr Gerät an, nicht an Ihre Wünsche. Ein 3,8B-Modell auf einem 6-GB-Gerät führt zu frustrierenden 3-Sekunden-Pausen und Abstürzen, wenn andere Apps Speicher benötigen. Ein 1B-Modell auf einem Flaggschiff verschenkt Leistungspotenzial. Wählen Sie das größte Modell, das Ihr Gerät komfortabel mit dem Betriebssystem und mindestens einer weiteren offenen App ausführen kann.
Geräteklasse | Beispiele | Empfohlenes Modell | Warum |
|---|---|---|---|
| Flaggschiff (8–12 GB RAM) | iPhone 17 Pro / Pro Max, iPhone 16 Pro, Galaxy S25 Ultra, OnePlus 13 | Phi-4 Mini (3.8B Q4_K_M) | Klügstes Modell, das der Chip mit nutzbarer Geschwindigkeit unterstützt |
| Älteres Flaggschiff (8 GB RAM) | iPhone 15 Pro, Galaxy S24 Ultra, Pixel 9 Pro | Llama 3.2 3B oder Phi-4 Mini | Llama 3.2 3B für Tool Calling; Phi-4 Mini für Rohqualität |
| Mittelklasse (6–8 GB RAM) | iPhone 14 Pro, Pixel 9, Snapdragon-8-Gen-2-Geräte | SmolLM 2 1.7B oder Qwen3 1.7B | Reaktionsschnelle Geschwindigkeit; passt mit Betriebssystem-Spielraum |
| Budget / älter (4–6 GB RAM) | iPhone 14, mittlere Snapdragon-7-Serie, älteres Android | Gemma 3 1B oder Qwen3 1.7B | Kleinste brauchbare Modelle, die noch kohärente Ausgabe liefern |
| Sehr alt (4 GB RAM) | iPhone SE 3. Gen, älteres 4-GB-Android | Gemma 3 1B | Einziges passendes Modell; begrenzte Schlussfolgerung, schnelle Tokens/Sek. |
| Nicht unterstützt (<4 GB) | iPhone SE 2. Gen, altes Android | Stattdessen Remote-Verbindung zum Heimrechner | On-Device-LLM nicht praktikabel; Tablet/Smartphone als UI für einen Heimserver mit Ollama verwenden |

💡Tipp: Für die App-Seite lesen Sie die iPhone- und Android-Parallelführer – sie zeigen, welche Apps diese Modelle auf welcher Plattform tatsächlich anbieten. App-Verfügbarkeit hinkt der Modellverfügbarkeit manchmal hinterher: Gemma 3 4B war sechs Monate vor PocketPal AIs Ein-Tap-Downloader auf Hugging Face verfügbar. Wenn ein Modell nicht in der kuratierten Liste Ihrer App aufgeführt ist, kann es in der Regel als GGUF von Hugging Face sideloadet werden.
Beste Smartphones für lokale LLMs
Das beste Smartphone für lokale KI ist das mit dem meisten RAM und dem neuesten Flaggschiff-Chip. In den indikativen Werten dieses Artikels ist das iPhone 17 Pro (A19 Pro) am schnellsten; das Galaxy S25 Ultra (Snapdragon 8 Elite) ist bei denselben Q4_K_M-Dateien etwa 10–20 % langsamer. Der RAM entscheidet, welche Modelle passen; der Chip, wie schnell sie laufen.
📍 In einem Satz
Wählen Sie ein Smartphone mit 8 GB+ RAM für 3B–4B-Modelle und 12 GB für Q5_K_M – iPhone 17 Pro / 17 Pro Max, iPhone 16 Pro, Galaxy S25 Ultra und OnePlus 13 sind die in diesem Artikel verwendeten Geräte.
💬 In einfachen Worten
Prüfen Sie zuerst den RAM Ihres Smartphones; er bestimmt das größte Modell, das Sie ausführen können. Die Chip-Generation ist der zweite Faktor und bestimmt die Geschwindigkeit. Für lokale KI müssen Sie kein neues Smartphone kaufen: Ein Gerät, das Sie bereits besitzen, führt die 1B–1,7B-Modelle mit voller Geschwindigkeit aus, und nur die 3B–4B-Modelle brauchen ein aktuelles Flaggschiff.
- Zuerst der RAM: 4 GB reichen nur für Gemma 3 1B; 6 GB für die 1,7B-Modelle; 8 GB für die 3B–4B-Modelle; 12 GB (iPhone 17 Pro Max, Galaxy S25 Ultra) bieten zusätzlichen Spielraum für Q5_K_M. Den RAM finden Sie in den technischen Daten des Geräts, denn manche Android-Modelle gibt es in mehreren RAM-Varianten.
- Dann der Chip: A19 Pro und A18 Pro (iPhone) sowie Snapdragon 8 Elite (Android-Flaggschiffe) sind die Chips hinter den Geschwindigkeiten in diesem Artikel. Ältere Flaggschiff-Chips führen dieselben Modelle aus, nur langsamer – das iPhone 14 Pro schafft mit Phi-4 Mini ~6–10 Tok/Sek.
- iPhone vs. Android: Bei identischen Q4_K_M-Dateien ist das iPhone in den Werten dieses Artikels 10–20 % schneller, vor allem weil Termux+Ollama unter Android nur die CPU nutzt und die Snapdragon-NPU nicht so einsetzt, wie MLC Chat Apple Metal nutzt. Eine bessere Android-Runtime schließt diese Lücke; die Hardware ist nicht die Grenze.
- Hitze und Akku: Dauerhaftes Generieren hält den Chip unter Last, und Smartphones senken bei Hitze die Taktrate – die Tokens/Sek. sinken daher in langen Sitzungen. Dieser Artikel enthält keine gemessenen Drosselungswerte. Praktische Stellschrauben sind ein kleineres Modell (Gemma 3 1B verbraucht deutlich weniger Strom als die 3B–4B-Modelle, die pro Antwort 2–3× mehr benötigen), kürzere Ausgaben und kein Laden, während das Modell läuft.
- Speicherplatz: Jedes 3B–4B-Modell belegt 2,2–2,9 GB; planen Sie Platz für ein oder zwei Modelle ein, nicht für eine Bibliothek aus Varianten.
💡Tipp: Mittelklasse-Android-Smartphone (Samsung Galaxy A-Serie und ähnliche)? Suchen Sie die RAM-Variante Ihres genauen Modells heraus und nutzen Sie dann die Tabelle nach Geräteklasse: 8 GB führen SmolLM 2 1.7B oder Llama 3.2 3B aus, 6 GB die 1,7B-Modelle, 4 GB Gemma 3 1B. Der Chip spielt eine kleinere Rolle als der RAM-Wert.
Multimodal auf Smartphones: Bildbeschreibungen und Alt-Texte
Von den sechs Kernmodellen nimmt nur Gemma 3 4B Bilder entgegen; Gemma 3 1B, Phi-4 Mini, Llama 3.2 3B, Qwen3 1.7B und SmolLM 2 sind reine Textmodelle. Google führt die Gemma-3-Modelle mit 4B, 12B und 27B als vision-fähig auf. Gemma 3n (E2B / E4B) ergänzt Bild- und Audioeingabe, und die SmolVLM2-Familie von Hugging Face (256M, 500M und 2.2B Parameter) ist von Grund auf für Bild und Video gebaut.
- Beste Wahl für Bildbeschreibungen auf einem Flaggschiff-Smartphone: Gemma 3 4B (~2,9 GB bei Q4_K_M, 8 GB+ RAM). Es ist das einzige der sechs Modelle, das ein Foto lesen und eine Beschreibung oder einen Alt-Text schreiben kann.
- Budget- oder reine CPU-Android-Geräte: SmolVLM2 256M oder 500M sind die kleinsten Vision-Modelle der Hugging-Face-Familie und der realistische Ausgangspunkt für schwache Hardware. Für sie liegen in diesem Artikel keine verifizierten Geschwindigkeitswerte vor.
- Die App-Unterstützung ist die eigentliche Grenze: In llama.cpp-basierten Apps braucht die Bildeingabe eine separate Vision-Projector-Datei neben dem Modell. Stellt Ihre App für das Modell keine Bildeingabe bereit, chattet auch ein vision-fähiges Modell nur mit Text. Prüfen Sie die App, bevor Sie herunterladen.
- Alt-Text-Workflow: Bitten Sie um ein bis zwei schlichte Sätze, die beschreiben, was zu sehen ist, und lesen Sie das Ergebnis, bevor Sie es veröffentlichen. Kleine Vision-Modelle können Text in Bildern falsch lesen und Personen oder Objekte falsch benennen – behalten Sie daher bei allem, was für Barrierefreiheit oder Social-Media-Beiträge gedacht ist, eine menschliche Kontrolle.
- Latenz-Erwartungen: Allein die Token-Generierung dauert ~55–77 ms pro Token bei Phi-4 Mini (13–18 Tok/Sek.) und ~22–29 ms pro Token bei Gemma 3 1B (35–45 Tok/Sek.) – noch vor jeder Bildkodierung. Antworten unter 100 ms Ende-zu-Ende sind für Bildbeschreibungen auf dem Smartphone daher kein realistisches Ziel.
💡Tipp: Für dichte Dokumente, Belege oder Screenshots voller kleiner Schrift nutzen Sie stattdessen ein Cloud-Modell oder ein Desktop-Vision-Modell. On-Device-Bildbeschreibungen eignen sich am besten für kurze Beschreibungen von Fotos, bei denen ein gelegentlicher Fehler leicht zu korrigieren ist.
Häufige Fehler
- Ein Modell wählen, das größer ist als der Smartphone-RAM erlaubt. Phi-4 Mini auf einem 6-GB-Gerät läuft mit 3–5 Tok/Sek. und stürzt ab, wenn iOS / Android Speicher für eine andere App zurückfordert. Passen Sie das Modell an Ihre Geräteklasse an (siehe Urteilstabelle oben).
- Mehrere Quantisierungsvarianten desselben Modells herunterladen. Wählen Sie Q4_K_M und hören Sie auf. Fünf GB redundanter Q5/Q6-Varianten auf einem 256-GB-Smartphone sind verschwendeter Speicherplatz, und die Qualitätsunterschiede sind im alltäglichen Chat nicht wahrnehmbar.
- SmolLM 2 1.7B für mehrstufige Schlussfolgerung verwenden. Es ist das schnellste Modell, aber nicht das klügste. Für Chain-of-Thought-Aufgaben (Mathematik, Planung, komplexe Schlussfolgerung) verwenden Sie Phi-4 Mini, auch wenn die langsameren Tokens/Sek. frustrierend wirken. Geschwindigkeit ohne Qualität ist nur eine schnellere falsche Antwort.
- Phi-4 Mini für nicht-englische Ausgabe ohne mehrsprachigen Prompt-Präfix verwenden. Phi-4 Mini beherrscht gängige europäische Sprachen ausreichend, produziert aber ungleichmäßige Ausgabe bei CJK oder Arabisch. Für mehrsprachige Nutzung installieren Sie Qwen3 1.7B neben Phi-4 Mini und wechseln Sie je nach Sprache.
- Cloud-KI-Qualität von diesen Modellen erwarten. Alle sechs sind 1B–4B, was ca. 60–80 % der Fähigkeiten von GPT-5.5 bei Chat-Aufgaben bedeutet und weit weniger bei komplexer Schlussfolgerung. Nutzen Sie sie wofür sie geeignet sind (privater Chat, Zusammenfassung, Textentwurf, Übersetzung) und verwenden Sie Cloud oder Remote-Verbindung für alles, was ein 70B+-Modell erfordert.
- Phi-4 Mini (3.8B) mit dem älteren Phi-3 Mini (3.8B) verwechseln. Sie teilen sich eine Parameteranzahl, aber Phi-4 Minis Trainingsdaten und Chat-Template sind anders. Bestätigen Sie immer die Modell-ID im GGUF-Dateinamen –
phi-4-mini-instruct, nichtphi-3-mini-4k-instruct.
Quellen
- Technischer Bericht zu Phi-4 Mini – Microsoft Research (Dezember 2024).
- Technischer Bericht zu Gemma 3 – Google DeepMind (2025).
- Modellkarte SmolLM 2 – Hugging Face (2024).
- Technischer Bericht zu Qwen3 – Alibaba Cloud (2024).
- Modellkarte Llama 3.2 – Meta AI (2024).
- SmolLM3-Ankündigung – Hugging Face Blog (Juli 2025).
- Übersicht zu Gemma 3n – Google AI for Developers.
- Vision-Unterstützung von Gemma 3 (4B, 12B, 27B) – Google Blog.
- SmolLM- und SmolVLM2-Modellfamilien – Hugging Face TB organization.
- Q4_K_M-Quantisierungsreferenz – llama.cpp-Dokumentation.
Häufig gestellte Fragen
Welches Mobilmodell ist auf dem iPhone am schnellsten?
Gemma 3 1B ist das absolut schnellste mit ~35–45 Tokens/Sek. auf dem iPhone 17 Pro, ist aber das kleinste Modell in diesem Vergleich. Unter den 1,7B-Modellen (wo Geschwindigkeit und Qualität ausgewogen sind) ist SmolLM 2 1.7B mit ~26–32 Tokens/Sek. am schnellsten. Unter den Modellen, die Flaggschiff-Qualität liefern, ist Phi-4 Mini mit ~13–18 Tokens/Sek. die schnellste „kluge" Option. Wählen Sie nach Anwendungsfall: Wenn Reaktionsschnelligkeit wichtiger als Tiefe ist, SmolLM 2; wenn Tiefe wichtiger ist, Phi-4 Mini.
Gibt es ein Gemma 3 2B- oder Gemma 3 7B-Modell?
Nein. Gemma 3 erscheint offiziell in fünf Größen: 270M, 1B, 4B, 12B und 27B – ein Gemma 3 2B oder Gemma 3 7B gibt es nicht. Die Verwechslung kommt meist von Gemma 2, das tatsächlich ein 2B-Modell hatte (Google DeepMind, Juli 2024) neben 9B und 27B. Wer die nächstliegende Entsprechung zu „Gemma 3 2B" sucht: Die beiden echten Optionen sind Gemma 3 1B (kleiner, schneller) und Gemma 3 4B (größer, klüger) – beide werden in diesem Artikel verglichen. Im April 2026 hat Google außerdem Gemma 4 veröffentlicht, mit einer anderen Größenreihe (Effective 2B und Effective 4B sowie 26B-MoE- und 31B-Dense-Varianten). Gemma 4 ist eine eigene Modellfamilie getrennt von Gemma 3 und wird in diesem mobilen Vergleich noch nicht behandelt, da zum Zeitpunkt dieser Aktualisierung keine verifizierten On-Device-Tokens/Sek.-Zahlen vorliegen.
Brauchen diese Modelle eine GPU, oder laufen sie nur mit CPU?
Alle sechs Modelle laufen ohne dedizierte GPU. Auf dem iPhone nutzt MLC Chat Apples Metal-API, um die Inferenz auf Neural Engine/GPU zu beschleunigen, aber PocketPal AI und LLM Farm (llama.cpp) laufen primär auf der CPU. Auf Android läuft Termux+Ollama heute nur auf der CPU – es nutzt die Snapdragon-Hexagon-NPU noch nicht, weshalb die Tokens/Sek.-Werte auf Android bei identischen Q4_K_M-Dateien etwa 10–20 % unter denen des iPhone liegen (siehe Vergleichstabelle oben). In der Praxis: Phi-4 Mini läuft auf dem Galaxy S25 Ultra CPU-only mit ~10–15 Tokens/Sek., und kein Modell in dieser Übersicht benötigt eine dedizierte GPU für brauchbare Ergebnisse.
Übertrifft Phi-4 Mini wirklich 7B-Modelle auf dem Smartphone?
Es übertrifft ältere 7B-Modelle (Llama 3.3 7B, Mistral Small v0.1) auf Standardbenchmarks wie MMLU und Schlussfolgerungsaufgaben trotz seiner halben Größe. Es übertrifft NICHT aktuelle 7B-Modelle (Llama 3.3 7B, Mistral Small v0.3) bei der Rohleistung – diese führen noch bei breitem Wissen und komplexer Schlussfolgerung. Der Grund, warum Phi-4 Mini über seinen Gewicht kämpft, ist Microsofts Trainings-Datenmix (reich an synthetischen Schlussfolgerungsketten und hochwertigem Text). Auf Smartphones sind 7B-Modelle meist zu langsam für die Praxis, sodass Phi-4 Mini standardmäßig gewinnt.
Läuft SmolLM 2 auf einem 4 Jahre alten Smartphone?
Ja, auf den meisten 4 Jahre alten Flaggschiff-Geräten. SmolLM 2 1.7B bei Q4_K_M benötigt ~1,1 GB RAM für das Modell plus ~500 MB Inferenz-Overhead – passt auf iPhone 13 (6 GB), iPhone 12 Pro Max (6 GB) und gleichwertiges Android (6 GB+). Auf 4-GB-Geräten von 2021 (iPhone 12, Android-Basismodell) lädt es technisch, ist aber unter Speicherdruck instabil; verwenden Sie stattdessen Gemma 3 1B.
Welches Modell eignet sich am besten für Übersetzung auf dem Smartphone?
Qwen3 1.7B für alle Sprachpaare mit Chinesisch, Japanisch, Koreanisch, Arabisch, Deutsch, Französisch, Spanisch oder Russisch. Es wurde mit starker mehrsprachiger Repräsentation trainiert und liefert muttersprachliche Qualität, wo englischzentrierte Modelle (Phi-4 Mini, Llama 3.2 3B) steife oder fehlerhafte Ergebnisse liefern. Nur für europäische Sprachpaare ist Gemma 3 4B eine praktikable zweite Wahl. Für einmalige Übersetzungen zwischen Englisch und einer bestimmten Sprache ist eine installierte Übersetzungs-App (Google Translate, DeepL) oft besser als jedes lokale LLM – lokale Modelle glänzen, wenn Übersetzung mit Chat oder Zusammenfassung in derselben Konversation verknüpft wird.
Brauche ich ein Flaggschiff-Smartphone, um diese Modelle gut zu nutzen?
Nein, nur für die größten Modelle (Phi-4 Mini 3.8B, Gemma 3 4B, Llama 3.2 3B). Mittelklassegeräte mit 6–8 GB RAM laufen SmolLM 2 1.7B und Qwen3 1.7B mit voller Geschwindigkeit (~20–28 Tokens/Sek.). Budget-Smartphones mit 4–6 GB RAM laufen Gemma 3 1B mit ~15–25 Tokens/Sek. Die ehrliche Antwort: Wenn Sie noch kein Flaggschiff-Gerät besitzen, kaufen Sie es nicht für lokale KI – die kleineren Modelle auf Ihrem vorhandenen Gerät sind für die meisten Anwendungsfälle gut genug.
Welches Modell verbraucht am wenigsten Akku?
Gemma 3 1B mit großem Abstand – kleinste Modell bedeutet wenigste Berechnungen pro Token, was niedrigere CPU/GPU-Last und niedrigeren Stromverbrauch bedeutet. SmolLM 2 1.7B und Qwen3 1.7B folgen. Die 3B–4B-Modelle (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) verbrauchen 2–3× mehr Strom pro Antwort. Für lange Flüge oder ausgedehnte Offline-Nutzung, wo der Akku am wichtigsten ist, ist Gemma 3 1B die richtige Wahl trotz des Qualitätsabstrichs.
Können Mobilmodelle mehrstufige Gespräche führen?
Ja für kurze Gespräche (5–10 Turns), mit abnehmender Qualität danach. Alle sechs Modelle haben Kontextfenster von 4.000–8.000 Token; längere Gespräche überschreiten das Fenster und das Modell verliert frühere Turns aus dem Blick. Für laufende Chats, die Speicher über eine Sitzung hinaus benötigen, ist das praktische Muster: Gespräch periodisch zusammenfassen, die Zusammenfassung speichern und als Kontext zurückgeben. Die meisten mobilen Apps (PocketPal AI, Private LLM) machen dies automatisch; LLM Farm erfordert manuelle Konfiguration.
Funktionieren diese Modelle mit Spracheingabe?
Ja, in Kombination mit einer Whisper-Sprache-zu-Text-Schicht. Der Standard-Offline-Sprachassistent-Stack für Mobilgeräte in 2026 ist: Whisper (kleines oder winziges Modell) für Sprache-zu-Text → Phi-4 Mini oder SmolLM 2 für Antwortgenerierung → Apple TTS oder Android TTS für Sprachsynthese. SmolLM 2 1.7B ist die beste LLM-Wahl für Sprachassistenz, weil die hohen Tokens/Sek. die Sprach-Turn-Wartezeit reaktionsschnell halten – siehe Lokalen Sprachassistenten auf dem Smartphone erstellen für die vollständige Pipeline.
Welches ist am besten für die Offline-Nutzung auf Reisen?
Für Reisen, bei denen Sie die Sprache wechseln und Übersetzung benötigen: Qwen3 1.7B. Für Reisen, bei denen Sie hauptsächlich englischsprachige Referenz benötigen (Fragen, Reisedokumente zusammenfassen, E-Mails verfassen): Phi-4 Mini auf einem Flaggschiff-Gerät, SmolLM 2 1.7B auf einem Mittelklassegerät. Reisen ist der stärkste Anwendungsfall für lokale KI insgesamt – keine Roaming-Daten nötig, keine Cloud-API-Kosten und kein Risiko, dass Cloud-Abhängigkeiten in Bereichen mit schlechter Verbindung versagen. Laden Sie das Modell vor der Reise herunter; es funktioniert bei moderatem Einsatz die gesamte Reise auf einer einzigen Ladung.
Welches ist das beste Smartphone, um ein lokales LLM auszuführen?
Das Smartphone mit dem meisten RAM und dem neuesten Flaggschiff-Chip. In den indikativen Werten dieses Artikels ist das iPhone 17 Pro (A19 Pro) am schnellsten, und das Galaxy S25 Ultra (Snapdragon 8 Elite) ist bei denselben Q4_K_M-Dateien etwa 10–20 % langsamer. Für 3B–4B-Modelle wie Phi-4 Mini brauchen Sie 8 GB RAM oder mehr; 12 GB (iPhone 17 Pro Max, Galaxy S25 Ultra) bieten zusätzlichen Spielraum für Q5_K_M. Besitzen Sie bereits ein Smartphone mit 6 GB RAM, führt es die 1,7B-Modelle mit voller Geschwindigkeit aus – kaufen Sie also nicht allein für lokale KI ein neues Gerät.
Überhitzt mein Smartphone, wenn ich ein lokales LLM ausführe?
Dauerhaftes Generieren hält den Chip unter hoher Last, sodass sich das Smartphone erwärmt und womöglich die Taktrate senkt, was die Tokens/Sek. in langen Sitzungen verringert. Dieser Artikel enthält keine gemessenen Drosselungswerte. Um die Temperatur niedrig zu halten, nutzen Sie ein kleineres Modell (Gemma 3 1B verbraucht deutlich weniger Strom als die 3B–4B-Modelle, die pro Antwort 2–3× mehr Strom benötigen), halten Sie die Antworten kurz und laden Sie das Gerät nicht, während das Modell läuft.
Kann ein Samsung Galaxy der Mittelklasse oder ein anderes Android-Smartphone diese Modelle ausführen?
Ja, wenn der RAM ausreicht. Suchen Sie die RAM-Variante Ihres genauen Modells heraus und ordnen Sie sie zu: 8 GB führen SmolLM 2 1.7B oder Llama 3.2 3B aus, 6 GB Qwen3 1.7B oder SmolLM 2 1.7B, 4 GB nur Gemma 3 1B. Der RAM ist wichtiger als der Chip; der Chip verändert vor allem die Geschwindigkeit. Die Tokens/Sek. unter Android liegen in den Werten dieses Artikels bei derselben Datei etwa 10–20 % unter dem iPhone.
Wie groß sind diese Modelle in Megabyte?
Bei Q4_K_M: Gemma 3 1B ~720 MB, Qwen3 1.7B ~1.100 MB, SmolLM 2 1.7B ~1.100 MB, Llama 3.2 3B ~2.200 MB, Phi-4 Mini ~2.700 MB und Gemma 3 4B ~2.900 MB. Die Datei entspricht außerdem grob dem RAM, den das Modell beim Laufen belegt, plus etwa 500 MB Inferenz-Overhead. Q5_K_M-Dateien sind etwa 25 % größer.
Gibt es SmolLM 3 oder SmolLM 4?
SmolLM 3 gibt es: Hugging Face hat es im Juli 2025 als Modell mit 3B Parametern veröffentlicht, mit Thinking- und Non-Thinking-Modus, 64k Trainingskontext (bis zu 128k mit YaRN) und Unterstützung für Englisch, Französisch, Spanisch, Deutsch, Italienisch und Portugiesisch. Stand der letzten Aktualisierung dieser Seite gibt es kein SmolLM 4; Hugging Face hatte keines veröffentlicht. SmolLM 3 fehlt im Geschwindigkeitsvergleich dieses Artikels, weil keine verifizierten On-Device-Werte vorliegen, liegt mit 3B aber in der Größenklasse von Llama 3.2 3B.
Was ist Gemma 3n, und ist es für Smartphones besser als Gemma 3?
Gemma 3n ist eine Modellfamilie von Google für den On-Device-Einsatz in den Größen E2B und E4B. Das „E“ steht für effektive Parameter: E2B lädt über 5 Milliarden Roh-Parameter, kann aber mit einer Speicherlast von knapp unter 2 Milliarden (1,91B) laufen. Es nimmt Text-, Bild- und Audioeingabe entgegen und deckt über 140 Sprachen ab. Es ist ein anderer Kompromiss als Gemma 3 4B, kein direktes Upgrade, und fehlt im Geschwindigkeitsvergleich dieses Artikels, weil noch keine verifizierten Werte vorliegen.
Kann ein Smartphone-LLM Bildbeschreibungen und Alt-Texte schreiben?
Nur mit einem vision-fähigen Modell. Von den sechs Modellen hier nimmt nur Gemma 3 4B Bilder entgegen; die anderen fünf sind reine Textmodelle. Auch Gemma 3n und SmolVLM2 (256M, 500M, 2.2B) verarbeiten Bilder. Ihre App muss die Bildeingabe für das Modell bereitstellen, denn llama.cpp-basierte Apps brauchen eine separate Vision-Projector-Datei. Prüfen Sie jede Beschreibung vor der Veröffentlichung – kleine Vision-Modelle können Text falsch lesen und Objekte falsch benennen.
Gibt es ein Modell mit 2,5B Parametern für Smartphones?
Nicht unter den hier behandelten gängigen Smartphone-Modellen. Die nächstliegenden Größen sind die 1,7B-Klasse (SmolLM 2, Qwen3) und die 3B-Klasse (Llama 3.2 3B, SmolLM 3). Gemma 3n E2B kommt dem im Geiste am nächsten: Es lädt über 5 Milliarden Roh-Parameter, läuft aber mit einer effektiven Speicherlast von knapp unter 2 Milliarden.
Welches Modell bietet die beste Genauigkeit pro Megabyte für Offline-Zusammenfassungen?
Dieser Artikel enthält keinen eigenen Genauigkeits-Benchmark, die Antwort ist daher qualitativ. Die 1,1-GB-Modelle (Qwen3 1.7B, SmolLM 2 1.7B) sind die effiziente Mitte für kurze Zusammenfassungen, Qwen3 für nicht-englische Texte. Phi-4 Mini (~2,7 GB) ist unter den sechs die Qualitätsobergrenze, wenn Sie den Speicher entbehren können, und Gemma 3 1B (~720 MB) ist das kleinste Modell, das noch kohärente kurze Zusammenfassungen liefert.
Kann ein Smartphone-LLM in unter 100 Millisekunden antworten?
Nicht für eine vollständige Antwort. Allein die Token-Generierung dauert auf dem iPhone 17 Pro ~55–77 ms pro Token bei Phi-4 Mini (13–18 Tok/Sek.) und ~22–29 ms pro Token bei Gemma 3 1B (35–45 Tok/Sek.) – selbst eine Antwort mit 20 Tokens braucht mit dem schnellsten Modell also rund eine halbe Sekunde. Unter 100 ms ist nur bei einer Handvoll Tokens realistisch, etwa bei einer sehr kurzen Klassifikationsausgabe, nicht für Chat oder Bildbeschreibungen.
Sind Mobilmodelle in 2027 noch nützlich?
Ja, aber die spezifischen Modellnamen werden sich ändern. Die mobile Small-LLM-Frontier bewegt sich ca. alle 6–9 Monate – bis Q4 2026 werden voraussichtlich neue ~3B-Modelle verfügbar sein, die Phi-4 Mini übertreffen, und bis Mitte 2027 wird die 1B–2B-Klasse wahrscheinlich das leisten, was 3B–4B-Modelle heute tun. Die Kategorie veraltet nicht; die spezifischen Empfehlungen wechseln. Überprüfen Sie diesen Artikel (Refresh fällig 2027-04-19) für die nächste Modellgeneration.
Muss ich bei der Nutzung lokaler LLM-Modelle auf dem Smartphone die DSGVO beachten?
Für private Nutzung ohne Verarbeitung personenbezogener Daten Dritter bestehen keine DSGVO-Pflichten. Da alle sechs Modelle vollständig On-Device laufen und keinerlei Daten an externe Server senden, ist das Risiko einer DSGVO-Verletzung minimal. Für gewerbliche oder berufliche Anwendungen – etwa wenn Sie Kundendaten oder Mitarbeiterdokumente durch das Modell verarbeiten – gilt DSGVO-Artikel 28 (Auftragsverarbeitung). Da die Inferenz lokal stattfindet, entfällt die Pflicht zu einem Auftragsverarbeitungsvertrag mit einem Cloud-Anbieter, was lokale LLMs gegenüber Cloud-Alternativen datenschutzrechtlich bevorzugt. BSI-Grundschutz-Kataloge empfehlen für unternehmenskritische Anwendungen die Nutzung lokaler Inferenz, um Datenabfluss zu verhindern.
Sind diese mobilen KI-Modelle für den deutschen Mittelstand geeignet?
Ja, insbesondere für Anwendungsfälle, bei denen Datenschutz, Offline-Verfügbarkeit und Unabhängigkeit von Cloud-Diensten wichtig sind. Mittelständische Unternehmen in Deutschland, die mit sensiblen Kundendaten, Betriebsgeheimnissen oder branchenspezifischen Vorschriften (z. B. im Gesundheitswesen oder bei Rechtsanwaltskanzleien) arbeiten, profitieren davon, dass die Inferenz vollständig On-Device stattfindet. Phi-4 Mini eignet sich für interne Zusammenfassungen und Chat-Anwendungen auf Firmen-Smartphones; Qwen3 1.7B deckt den mehrsprachigen Bedarf im internationalen Mittelstand ab. Für IT-Sicherheitsverantwortliche: Die BSI-Grundschutz-Empfehlungen zur Minimierung von Cloud-Abhängigkeiten sprechen für den Einsatz lokaler Modelle in sicherheitskritischen Umgebungen.