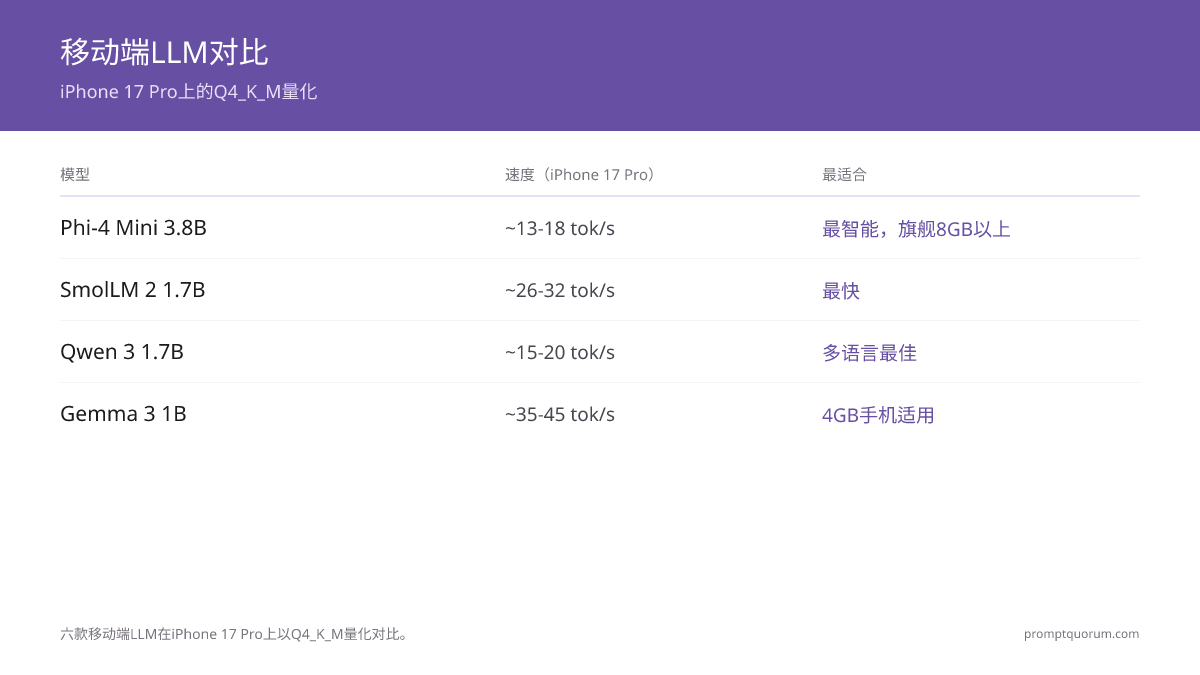
快速事实
- 对比模型: Phi-4 Mini 3.8B、Gemma 3 4B、Gemma 3 1B、SmolLM 2 1.7B、Qwen3 1.7B、Llama 3.2 3B(均为Q4_K_M GGUF)。
- 参考设备: iPhone 17 Pro(A19 Pro)、iPhone 16 Pro(A18 Pro,8GB)、Galaxy S25 Ultra(Snapdragon 8 Elite)、Pixel 9 Pro(Tensor G4)、OnePlus 13(Snapdragon 8 Elite)。本页的速度数据为参考估算,并非PromptQuorum实测;实际速度会因应用、运行时、量化方式、手机温度和设置而异。
- 推理引擎: PocketPal AI / LLM Farm的llama.cpp(默认)、MLC Chat的MLC LLM(iPhone上Metal加速)、Termux的Ollama(Android)。
- 内存占用(Q4_K_M): Phi-4 Mini约2.7 GB、Gemma 3 4B约2.9 GB、Llama 3.2 3B约2.2 GB、Qwen3 1.7B约1.1 GB、SmolLM 2 1.7B约1.1 GB、Gemma 3 1B约720 MB。
- 最低RAM(运行时): 1.7B模型需6GB设备;3B–4B模型需8GB设备;仅Gemma 3 1B可在4GB设备上运行。
- iPhone 17 Pro最快tokens/sec: Gemma 3 1B约35–45、SmolLM 2约26–32、Qwen 3约24–32、Llama 3.2 3B约16–22、Phi-4 Mini约13–18、Gemma 3 4B约10–13。
- 量化来源: 六款模型均可在Hugging Face以及PocketPal AI / MLC Chat / LM Studio上获取Q4_K_M GGUF格式。
- 下载大小(Q4_K_M,MB): Gemma 3 1B约720、Qwen3 1.7B约1,100、SmolLM 2约1,100、Llama 3.2 3B约2,200、Phi-4 Mini约2,700、Gemma 3 4B约2,900——见下方大小对照表。
- 未纳入速度对比的较新模型: SmolLM 3(3B,Hugging Face,2025年7月)和Gemma 3n(E2B / E4B,Google)。图像输入:六款模型中仅Gemma 3 4B支持。
如何选择移动端模型?
对于大多数旗舰手机(iPhone 16 Pro / 17 Pro、Galaxy S25 Ultra、OnePlus 13),选择Phi-4 Mini(3.8B Q4_K_M)。 它是4B以下最智能的模型,以可用的对话速度运行。仅在有特定需求时选择其他模型——速度(SmolLM 2)、多语言(Qwen3)或旧机型兼容(Gemma 3 1B)。
📍 简单一句话
旗舰机(RAM 8GB以上)选Phi-4 Mini(最智能),速度优先选SmolLM 2 1.7B,多语言选Qwen3 1.7B,4GB旧机选Gemma 3 1B,tool calling选Llama 3.2 3B,Phi-4 Mini不可用时的均衡默认选Gemma 3 4B。
💬 简单来说
没有单一的最佳移动模型——正确的选择取决于你的设备和使用场景。如果手机是近两年的机型且有8GB以上RAM,安装Phi-4 Mini。如果主要用非英语聊天,安装Qwen3。如果想要最快的回复速度哪怕牺牲一些质量,安装SmolLM 2。如果手机较旧或只有4GB RAM,安装Gemma 3 1B。六款模型的差异真实存在,但足够小,任何一款都能给出连贯的回答——没有一款达到云端质量。
如何选择移动端模型
以下情况使用本地LLM:
- •RAM 8GB以上旗舰机(iPhone 16 Pro/17 Pro、Galaxy S25 Ultra、OnePlus 13)→ Phi-4 Mini 3.8B
- •需要在任何设备上最快的tokens/sec → SmolLM 2 1.7B
- •非英语使用(翻译、多语言聊天)→ Qwen3 1.7B
- •需要广泛应用兼容性、tool calling或RAG → Llama 3.2 3B
- •RAM 4GB的旧机型 → Gemma 3 1B
- •Phi-4 Mini在你的应用中不可用,需要4B级质量 → Gemma 3 4B
以下情况使用云端模型:
- •多步推理、复杂代码生成或长文档分析 → 使用云端或远程连接到运行70B以上模型的本地机器
- •密集文档OCR或对准确度要求高的图像分析 → 云端应用;简单的图像描述可在端侧用Gemma 3 4B完成(见下文手机端多模态一节)
- •需要3000+token连贯性的长篇创意写作 → 云端或桌面端8B以上模型
快速决策:
- →大多数用户的默认选择:Phi-4 Mini 3.8B
- →所有设备上最快:SmolLM 2 1.7B
- →最佳多语言:Qwen3 1.7B

💡提示: 如果不确定,在旗舰机上先用Phi-4 Mini,在中端机上先用SmolLM 2 1.7B——两款都能在快速连接下5分钟内下载完成且可随时切换。用你真正关心的任务测试(一封需要摘要的真实邮件、一个真正想得到答案的问题)。如果质量可以接受,就定下来。如果不满意,通过PocketPal AI或LM Studio在30秒内切换到其他模型。
移动端模型对比表
下方四列表格是快速筛选层——按机型档次或使用场景选择对应行。 Tokens/sec数据为参考估算(非PromptQuorum实测),假设在iPhone 17 Pro上使用PocketPal AI(llama.cpp)运行Q4_K_M量化。iPhone 16 Pro上数据约低15–25%,Galaxy S25 Ultra上使用MLC Chat或Termux+Ollama约低10–20%。
📍 简单一句话
Phi-4 Mini最智能、SmolLM 2 1.7B最快、Qwen3 1.7B多语言最强、Gemma 3 1B最小可用、Llama 3.2 3B最强3B全能、Gemma 3 4B均衡默认。
💬 简单来说
按大小从上到下阅读此表,或直接跳到与你机型档次对应的行。"适用场景"列显示该模型的优化方向——选择对你最重要的优势对应的行,忽略其他行。
模型 | 参数量 | tokens/sec(17 Pro) | 适用场景 |
|---|---|---|---|
| Phi-4 Mini | 3.8B | 约13–18 | 最智能小型模型——旗舰机默认 |
| Gemma 3 4B | 4B | 约10–13 | Phi-4 Mini不可用时的均衡默认 |
| Gemma 3 1B | 1B | 约35–45 | 旧机型(RAM 4GB) |
| SmolLM 2 | 1.7B | 约26–32 | 最快tokens/sec,高响应聊天 |
| Qwen3 | 1.7B | 约24–32 | 最佳多语言(35+种语言) |
| Llama 3.2 | 3B | 约16–22 | 最强3B选项、tool calling、RAG |
速度与质量权衡说明: 在同一芯片上,tokens/sec与参数量成反比——1B模型在相同硬件上比3.8B模型快约3–4倍。质量随参数量提升但非线性:得益于微软的训练数据组合,Phi-4 Mini(3.8B)的推理质量更接近7B模型而非1.7B模型。用此表做权衡:模型越快=回复越快,模型越智能=难题回答越好。

💡提示: iPhone 16 Pro的tokens/sec比此表中iPhone 17 Pro的数据约低15–25%——A18 Pro与A19 Pro Neural Engine的差距。Galaxy S25 Ultra(Snapdragon 8 Elite)在相同Q4_K_M GGUF下比iPhone 17 Pro约低10–20%,主要因为Termux+Ollama在Android上还未能像MLC Chat利用Apple Metal那样充分利用Snapdragon Hexagon NPU。
Phi-4 Mini:最智能的小型模型
Phi-4 Mini(3.8B参数,微软,2024年12月)凭借针对推理优化的训练数据组合,成为2026年4B以下最智能的模型。 尽管体量相似,在chain-of-thought任务上超越Gemma 3 4B和Llama 3.2 3B。在任何RAM 8GB以上手机上将其作为默认模型使用。
- 参数与训练: 3.8B参数;在微软精心策划的高质量网络文本、合成推理链和学术内容混合数据上训练。架构为带grouped-query attention的Transformer。
- 内存占用: Q4_K_M约2.7 GB,Q5_K_M约3.5 GB。在iPhone 16 Pro / 17 Pro(8 GB)和Galaxy S25 Ultra(12 GB)上留有足够系统空间。
- 速度(tokens/sec): iPhone 17 Pro约13–18,iPhone 16 Pro约10–15,Galaxy S25 Ultra约10–15(Termux+Ollama),iPhone 14 Pro约6–10(慢但可用)。
- 质量优势: chain-of-thought推理、摘要、事实问答、基础代码生成。在MMLU、GSM8K等标准基准测试中超越同等大小的开源模型。
- 质量短板: 世界知识不如Llama 3.2 3B(Common Crawl数据较少);创意写作不如Gemma 3 4B自然;英语以外的多语言不如Qwen3 1.7B。
- 最适合: 希望在英语聊天、摘要和推理上使用最智能单一默认模型的旗舰机用户。
💡提示: Phi-4 Mini从明确调用逐步推理的系统提示词中受益("在回答之前请仔细思考")。训练数据中推理链丰富,因此这种风格的提示词始终产生比简短指令更好的回答。对于快速聊天,不需要系统提示词;默认行为已经是对话式的。
Gemma 3 4B:均衡默认选择
当应用中Phi-4 Mini不可用或偏好Google训练数据组合时,Gemma 3 4B(Google DeepMind,2025年)是均衡的默认选择。 在相同硬件上比Phi-4 Mini略慢,但在聊天和摘要上质量相当,自然语言覆盖更广。
- 参数与训练: 4B参数;在Google精心策划的网络文本、代码和多语言数据混合上训练。与Gemma 2同一架构系列,支持更长上下文。
- 内存占用: Q4_K_M约2.9 GB,Q5_K_M约3.7 GB。适合8GB以上手机;6GB手机上较紧张(改用Phi-4 Mini或更小模型)。
- 速度(tokens/sec): iPhone 17 Pro约10–13,iPhone 16 Pro约7–10,Galaxy S25 Ultra约7–10(架构差异导致尽管大小相近,但比Phi-4 Mini略慢)。
- 质量优势: 自然的对话语气、强大的摘要能力、比Phi-4 Mini更广的世界知识(Common Crawl数据)、不错的多语言能力。
- 质量短板: chain-of-thought推理弱于Phi-4 Mini;相同硬件上tokens/sec更慢;不总是移动应用中最先支持的模型。
- 最适合: 希望以Phi-4 Mini替代选择使用Google训练模型的旗舰机用户,特别适合日常聊天、摘要和短文写作。
💡提示: Gemma 3 4B使用与Phi-4 Mini不同的chat template——确认你的应用使用正确的Gemma模板(带<start_of_turn>标记)。错误的模板会产生混乱或重复的输出。PocketPal AI、MLC Chat和LM Studio会自动检测;LLM Farm需要在模型设置中手动选择Gemma模板。
Gemma 3 1B:旧机型轻量选择
Gemma 3 1B(Google DeepMind,2025年)是2026年最小的可用移动模型——Q4_K_M约720 MB,可在4GB RAM设备上运行。 质量限于短篇连贯回答(1–2段),但它是1 GB以下能在弱硬件上产生可用输出的唯一选择。
- 参数与训练: 1B参数;与4B模型相同的Gemma 3家族架构,但训练计算量更少。为边缘设备高效推理而训练。
- 内存占用: Q4_K_M约720 MB,Q5_K_M约900 MB。可在iPhone SE第3代、iPhone 12/13、旧款Android(最低4GB RAM)上运行。
- 速度(tokens/sec): iPhone 17 Pro约35–45,iPhone 16 Pro约28–38,iPhone 14约20–28,旧款Android(4GB)约10–15。此列表中所有设备上最快的模型。
- 质量优势: 速度快、内存占用低、短篇回答连贯、耗电少。
- 质量短板: 多步推理弱、偏僻主题频繁出现事实错误、长篇生成(500+ tokens)重复、对话深度浅。
- 最适合: 拥有低于6GB RAM门槛设备但仍想使用端侧AI的用户,或在长途飞行或低电量场景下优化续航的用户。
💡提示: 将Gemma 3 1B用于短小精准的任务——单句摘要、一段式草稿、快速释义、主要语言对之间的简单翻译。避免要求它进行多段解释、多步推理或对偏僻事实精确度有要求的任务。提示词中加"简洁"二字能发挥它的优势。
SmolLM 2 1.7B:tokens/sec最快
SmolLM 2 1.7B(Hugging Face,2024年)是此列表中所有参考手机上tokens/sec最快的移动模型。 iPhone 17 Pro约26–32 tok/sec,Galaxy S25 Ultra约20–28。当响应速度比回答深度更重要时是最佳选择。
- 参数与训练: 1.7B参数;在Hugging Face精心策划的针对小模型效率优化的混合数据上训练。架构专为消费级硬件低延迟推理调优。
- 内存占用: Q4_K_M约1.1 GB。在任何6GB以上RAM设备上运行,为系统留出充足空间。
- 速度(tokens/sec): iPhone 17 Pro约26–32,iPhone 16 Pro约22–28,Galaxy S25 Ultra约20–28,iPhone 14 Pro约15–22。在同一芯片上比Phi-4 Mini快约2倍。
- 质量优势: 快速对话回复、简单问答、自动补全风格的续写、英文写作。
- 质量短板: 推理弱于Phi-4 Mini,世界知识不如Llama 3.2 3B,多语言弱于Qwen3 1.7B,事实查询偶有幻觉。
- 最适合: 延迟敏感的中端设备(文本输入自动补全、语音助手轮换、实时聊天),或大型模型体验迟缓的旧旗舰机。

💡提示: SmolLM 2 1.7B是手机端离线语音助手的最佳搭档——Whisper + LLM + TTS完整流程请参考在手机上构建本地语音助手。高tokens/sec让语音对话响应保持在约1.5秒的感知门槛以下,即便在中端硬件上也如此。
Qwen3 1.7B:最强多语言移动模型
Qwen3 1.7B(阿里巴巴,2024年)是2026年最强的多语言移动模型——在35+种语言上训练,包括中文、日文、韩文、阿拉伯文、德文、法文、西班牙文和俄文。 翻译、非英语聊天和对话途中切换语言的旅行场景的最佳选择。
- 参数与训练: 1.7B参数;在阿里巴巴多语言语料库上训练,CJK语言、阿拉伯语和主要欧洲语言占比高。架构针对多语言推理优化。
- 内存占用: Q4_K_M约1.1 GB。适合任何6GB以上RAM设备。
- 速度(tokens/sec): iPhone 17 Pro约24–32,iPhone 16 Pro约20–28,Galaxy S25 Ultra约18–26,iPhone 14 Pro约14–20。速度与SmolLM 2相当。
- 质量优势: 35+种语言母语级输出(大多数小模型以英语为中心,多语言回退质量差)、主要语言对之间翻译能力强、Phi-4 Mini和Llama 3.2产生乱码的CJK输出连贯。
- 质量短板: 纯英语推理略弱于Phi-4 Mini,创意写作不如Gemma 3 4B自然,tool calling弱于Llama 3.2 3B。
- 最适合: 非英语用户(尤其是中文、日文、德文、西班牙文、法文使用者)、需要离线翻译的旅行者、构建多语言移动功能的开发者。
💡提示: 对于两种特定语言之间的单次翻译,Qwen3 1.7B通常优于以翻译作为次要任务运行的更大英语优先模型。对于用中文聊天的中文用户,Qwen 3尽管小60%,但产生的输出比Phi-4 Mini自然得多。基本规则:选择针对你主要语言训练的模型,而非参数最多的模型。
Llama 3.2 3B:可靠的3B全能模型
Llama 3.2 3B(Meta,2024年)是2026年应用支持最广泛的3B模型——应用兼容性最广、六款模型中tool calling支持最强、社区微调生态最丰富。 在原始质量上略逊于Phi-4 Mini,但在边缘情况下更可靠,移动应用支持更好。
- 参数与训练: 3B参数;在Meta大规模预训练语料库上训练,并经过聊天和工具使用的instruction-tuning。与8B和70B版本相同的Llama 3架构。
- 内存占用: Q4_K_M约2.2 GB,Q5_K_M约2.8 GB。在8GB以上手机上运行留有系统空间;关闭其他应用后可在紧张的6GB手机上工作。
- 速度(tokens/sec): iPhone 17 Pro约16–22,iPhone 16 Pro约12–18,Galaxy S25 Ultra约12–18,iPhone 14 Pro约7–11。
- 质量优势: 广泛的世界知识、强大的tool calling和function calling支持(4B以下模型中同类最强)、稳定的聊天行为、特定任务(医疗、法律、编程)微调的成熟生态。
- 质量短板: chain-of-thought推理弱于Phi-4 Mini,相似大小下MMLU分数略低,对话语气不如Gemma 3 4B自然。
- 最适合: 需要tool calling或function calling的移动应用(本地文档RAG、端侧Agent工作流),或希望使用社区微调库最丰富模型的用户。
💡提示: Llama 3.2 3B是此列表中唯一tool calling支持足够可靠,能用于端侧Agent工作流的模型——参考本地AI Agent与MCP 2026。Phi-4 Mini和SmolLM 2在技术上可以进行tool call,但Llama 3.2 3B是2026年唯一达到生产可用水平的。
SmolLM 3与Gemma 3n:较新的小型模型
SmolLM 3(Hugging Face,2025年7月)和Gemma 3n(Google)是读者最常问到的两款较新小型模型。两者都不在上述六模型速度对比中,因为截至发稿时尚无经过验证的端侧tokens/sec数据。 截至本页最近一次更新,尚无SmolLM 4:Hugging Face当时尚未发布,SmolLM 3是SmolLM系列的最新一代。
- SmolLM 3(3B): 3B参数模型,在约11万亿tokens上训练,具备思考与非思考两种模式。训练上下文为64k,推理时借助YaRN外推可处理最长128k。官方支持语言:英语、法语、西班牙语、德语、意大利语和葡萄牙语。Hugging Face称其在基础模型基准测试中可与更大的Qwen3 4B和Gemma 3 4B相竞争,同时指出Qwen3 4B整体得分通常最高。
- SmolLM 3在手机上: 3B参数与Llama 3.2 3B属同一体量,因此Q4_K_M文件预计约2 GB,对应档次表中的8GB RAM档。这是根据参数量做出的估算,并非实测。
- Gemma 3n(E2B和E4B): "E"代表有效参数(effective parameters)。E2B加载超过50亿原始参数,但借助参数跳过和逐层嵌入缓存,内存占用可低于20亿(1.91B)。Gemma 3n支持文本、图像和音频输入,训练覆盖140多种语言,上下文窗口为32K tokens。
- 如何选择: 想要用于英语或主要欧洲语言的思考模式3B模型,选SmolLM 3;应用支持图像或音频输入,选Gemma 3n。否则,上述六款模型仍是稳妥的默认选择。
💡提示: 评判任何新的小型模型,先看RAM,再看速度。先找到它的Q4_K_M文件大小,对照档次表,最后再看基准测试宣传。应用支持也往往滞后于模型发布——如果模型不在应用的精选列表中,可以从Hugging Face旁加载GGUF。
移动端量化:Q4_K_M是默认标准
Q4_K_M是2026年移动LLM推理的标准量化——以四分之一的文件大小保留约95%的原始模型质量。 仅在RAM 12GB以上手机(iPhone 17 Pro Max、Galaxy S25 Ultra)上有真正可用的额外内存时才使用Q5_K_M或Q6_K。
📍 简单一句话
Q4_K_M是移动端默认——四分之一大小保留约95%质量。Q5_K_M / Q6_K仅在RAM 12GB以上手机上值得使用。
💬 简单来说
Hugging Face上的模型以全精度发布(每个参数以16位数存储)。在手机上下载量化版本,每个参数压缩到4位——文件缩小四倍,推理速度约快四倍,质量损失轻微。Q4_K_M是2026年社区公认的手机端最佳平衡方案。Q数字越高(Q5、Q6、Q8)压缩越少、质量越高,但文件越大;Q4是手机限制下的最优解。
- Q4_K_M(推荐默认): 带K-quants和"M"混合精度的4位量化。约95%原始质量。2026年移动标准。六款模型均在Hugging Face上提供此格式。
- Q5_K_M(RAM 12GB以上设备): 5位量化。约98%原始质量。文件约大25%。在iPhone 17 Pro Max(12 GB)或Galaxy S25 Ultra(12 GB)上对Phi-4 Mini和Llama 3.2 3B值得使用;8GB手机上RAM代价不值得。
- Q6_K(很少需要): 6位量化。约99%原始质量。文件约大50%。仅适合内存充裕且对模型质量要求极高的手机(如长篇写作每个百分点都重要的场景)。
- Q8_0(移动端避免使用): 8位量化。约99.5%原始质量。约为Q4_K_M的2倍大小。手机上RAM代价不值得;留给桌面端/笔记本使用。
- Q3_K_M / Q2_K(仅极度受限设备): 3位和2位量化。质量降至约85–90%。仅在Q4_K_M的Gemma 3 1B仍然无法运行时使用(2026年罕见)。

⚠️警告: 不要以"测试哪个更好"为由下载同一模型的多个量化版本。Q4_K_M和Q5_K_M之间的质量差异真实存在但很小,却会消耗256GB手机5GB以上的冗余存储。选择Q4_K_M,使用一周,只有在有具体证据证明质量不足时才升级到Q5_K_M。
模型下载大小(MB)
在Q4_K_M下,六款模型的大小从约720 MB(Gemma 3 1B)到约2,900 MB(Gemma 3 4B)不等。 除文件大小外,推理还需预留约500 MB额外RAM,并且每个打算保留的3B–4B模型至少留出3 GB可用存储空间。
📍 简单一句话
Q4_K_M文件大小:Gemma 3 1B约720 MB,Qwen3 1.7B和SmolLM 2约1,100 MB,Llama 3.2 3B约2,200 MB,Phi-4 Mini约2,700 MB,Gemma 3 4B约2,900 MB。
💬 简单来说
下载的文件大小,大致也就是模型运行时占用的RAM,再加一点开销。因此要对照手机的是文件大小,而不是参数量。如果模型加操作系统超出了你的RAM,手机会在回答中途把它关掉。
模型 | Q4_K_M大小(MB) | 手机最低RAM | 大小与质量说明 |
|---|---|---|---|
| Gemma 3 1B | 约720 | 4GB | 最小的可用模型;仅适合简短回答 |
| Qwen3 1.7B | 约1,100 | 6GB | 每MB多语言输出最佳 |
| SmolLM 2 1.7B | 约1,100 | 6GB | 每MB速度最快;轻度推理 |
| Llama 3.2 3B | 约2,200 | 8GB(6GB较紧张) | 比4B模型小;tool calling最佳 |
| Phi-4 Mini | 约2,700 | 8GB | 每参数推理能力最强 |
| Gemma 3 4B | 约2,900 | 8GB | 文件最大;摘要自然;支持图像输入 |
关于每字节的准确度: 本文没有自己的准确度基准测试,因此请将最后一列仅视为定性参考。对于离线摘要,1.1 GB的模型(Qwen3 1.7B、SmolLM 2)是高效的中间选择;如果能腾出2.7 GB,Phi-4 Mini是质量上限。
档次判断:旗舰 vs 中端 vs 入门
手机档次决定模型上限——芯片代次和RAM比品牌更重要。 旗舰手机(RAM 8GB以上,A18 Pro / A19 Pro / Snapdragon 8 Elite)可轻松运行3.8B–4B模型;中端手机(6–8GB RAM,旧旗舰芯片)运行1.7B–3B;入门或旧款手机(4–6GB RAM)运行1B–1.7B。
📍 简单一句话
旗舰机(8GB以上)→ Phi-4 Mini 3.8B;中端机(6–8GB)→ SmolLM 2 1.7B或Llama 3.2 3B;入门或旧款(4–6GB)→ Gemma 3 1B或Qwen3 1.7B。
💬 简单来说
让模型匹配你的设备,而非你的期望。6GB手机上的3.8B模型在其他应用需要内存时会产生令人沮丧的3秒停顿和崩溃。旗舰机上的1B模型浪费了硬件能力。选择在系统和至少另一个应用同时打开的情况下能舒适运行的最大模型。
手机档次 | 代表机型 | 推荐模型 | 原因 |
|---|---|---|---|
| 旗舰(RAM 8–12GB) | iPhone 17 Pro / Pro Max、iPhone 16 Pro、Galaxy S25 Ultra、OnePlus 13 | Phi-4 Mini(3.8B Q4_K_M) | 芯片以可用速度支持的最智能模型 |
| 旧款旗舰(RAM 8GB) | iPhone 15 Pro、Galaxy S24 Ultra、Pixel 9 Pro | Llama 3.2 3B或Phi-4 Mini | tool calling用Llama 3.2 3B;原始质量用Phi-4 Mini |
| 中端(RAM 6–8GB) | iPhone 14 Pro、Pixel 9、Snapdragon 8 Gen 2手机 | SmolLM 2 1.7B或Qwen3 1.7B | 速度响应快;为系统留有余量 |
| 入门/旧款(RAM 4–6GB) | iPhone 14、Snapdragon 7系列中端、旧款Android | Gemma 3 1B或Qwen3 1.7B | 仍能产生连贯输出的最小可用模型 |
| 非常旧(RAM 4GB) | iPhone SE第3代、旧款4GB Android | Gemma 3 1B | 唯一能放下的模型;推理有限但tokens/sec快 |
| 不支持(<4GB) | iPhone SE第2代、旧款Android | 改为远程连接到本地机器 | 端侧LLM不实际;将平板/手机作为家用Ollama服务器的UI使用 |

💡提示: 关于应用侧,请查阅iPhone和Android姐妹指南——它们介绍了哪些应用实际上在每个平台上支持这些模型。应用可用性有时滞后于模型可用性:Gemma 3 4B在PocketPal AI添加一键下载器的六个月前就已上线Hugging Face。如果模型不在应用的精选列表中,通常可以从Hugging Face以GGUF格式旁加载。
适合运行本地LLM的手机
适合跑本地AI的最佳手机,就是RAM最大、芯片最新的旗舰机。 按本文的参考数据,iPhone 17 Pro(A19 Pro)最快,Galaxy S25 Ultra(Snapdragon 8 Elite)在相同Q4_K_M文件下约慢10–20%。RAM决定能放下哪些模型,芯片决定跑得多快。
📍 简单一句话
3B–4B模型选RAM 8GB以上的手机,Q5_K_M则需12GB——iPhone 17 Pro / 17 Pro Max、iPhone 16 Pro、Galaxy S25 Ultra和OnePlus 13就是本文使用的机型。
💬 简单来说
先查手机的RAM,它决定你能运行的最大模型。芯片代次是第二因素,决定速度。跑本地AI不必换新手机:现有手机即可全速运行1B–1.7B模型,只有3B–4B模型才需要近年的旗舰机。
- 先看RAM: 4GB只能运行Gemma 3 1B;6GB可运行1.7B模型;8GB可运行3B–4B模型;12GB(iPhone 17 Pro Max、Galaxy S25 Ultra)可为Q5_K_M留出余量。请在手机规格中查看RAM,因为部分Android机型有多种RAM版本。
- 再看芯片: A19 Pro和A18 Pro(iPhone)以及Snapdragon 8 Elite(Android旗舰)是本文各项速度数据背后的芯片。更老的旗舰芯片同样能运行这些模型,只是更慢——iPhone 14 Pro运行Phi-4 Mini约6–10 tok/sec。
- iPhone与Android: 在相同Q4_K_M文件下,按本文数据iPhone快10–20%,主要因为Android上的Termux+Ollama仅靠CPU运行,没有像MLC Chat利用Apple Metal那样利用Snapdragon NPU。更好的Android运行时可以缩小这一差距;硬件本身并不是瓶颈。
- 发热与电池: 持续生成会让芯片长时间处于负载下,手机过热时会降低时钟频率,因此长时间使用时tokens/sec会下降。本文没有实测的降频数据。实用的办法是换更小的模型(Gemma 3 1B的功耗远低于3B–4B模型,后者每次回答耗电约多2–3倍)、缩短输出,以及模型运行时不要充电。
- 存储: 每个3B–4B模型占用2.2–2.9 GB;留出一两个模型的空间即可,不要囤积各种版本。
💡提示: 使用中端Android手机(三星Galaxy A系列等)?先查清你具体机型的RAM版本,再对照档次表:8GB可运行SmolLM 2 1.7B或Llama 3.2 3B,6GB可运行1.7B模型,4GB可运行Gemma 3 1B。RAM数据比芯片更重要。
手机端多模态:图像描述与替代文本
六款核心模型中,只有Gemma 3 4B支持图像输入;Gemma 3 1B、Phi-4 Mini、Llama 3.2 3B、Qwen3 1.7B和SmolLM 2均为纯文本模型。 Google将Gemma 3的4B、12B和27B模型列为具备视觉能力。Gemma 3n(E2B / E4B)增加了图像和音频输入,Hugging Face的SmolVLM2系列(256M、500M和2.2B参数)则从一开始就是为视觉和视频而设计的。
- 旗舰手机上生成图像描述的最佳选择: Gemma 3 4B(Q4_K_M约2.9 GB,RAM 8GB以上)。它是六款模型中唯一能读取照片并撰写描述或替代文本的模型。
- 入门机型或仅CPU的Android: SmolVLM2 256M或500M是Hugging Face系列中最小的视觉模型,也是弱硬件上现实的起点。本文没有它们经过验证的速度数据。
- 应用支持才是真正的限制: 在基于llama.cpp的应用中,图像输入需要在模型旁放置单独的视觉投影器(vision projector)文件。如果应用没有为该模型开放图像输入,具备视觉能力的模型也只能以文本聊天。下载前请先确认应用支持。
- 替代文本工作流: 让模型用一两句平实的话描述可见内容,发布前先自己读一遍。小型视觉模型可能误读图像中的文字,并错误标注人物或物体,因此凡是用于无障碍或社交媒体发布的内容,都要保留人工检查。
- 延迟预期: 仅token生成,Phi-4 Mini每token约55–77 ms(13–18 tok/sec),Gemma 3 1B每token约22–29 ms(35–45 tok/sec),这还不包括任何图像编码。因此在手机上为图像描述实现100 ms以内的端到端响应并不现实。
💡提示: 对于密集文档、收据或满是小字的截图,请改用云端模型或桌面端视觉模型。端侧图像描述最适合照片的简短描述,偶尔出错也容易纠正。
常见误区
- 选择超出手机RAM限制的更大模型。 6GB手机上的Phi-4 Mini以3–5 tok/sec运行,当iOS / Android为其他应用回收内存时会崩溃。按档次表匹配模型和设备。
- 下载同一模型的多个量化版本。 选择Q4_K_M就停手。256GB手机上5GB以上的冗余Q5/Q6版本是浪费空间,日常聊天中质量差异根本感知不到。
- 用SmolLM 2 1.7B进行多步推理。 它是最快的模型,但不是最智能的。对于chain-of-thought任务(数学、规划、复杂推理),即使较慢的tokens/sec让人沮丧也要使用Phi-4 Mini。没有质量的速度只是更快地给出错误答案。
- 不加多语言提示前缀就让Phi-4 Mini输出非英语内容。 Phi-4 Mini能勉强处理常见欧洲语言,但在CJK或阿拉伯语上输出参差不齐。多语言使用时,在Phi-4 Mini旁边安装Qwen3 1.7B,按语言切换。
- 期望这些模型达到云端AI质量。 六款模型都是1B–4B,在聊天任务上大约是GPT-5.5能力的60–80%,复杂推理上差距更大。将它们用于擅长的场景(私人聊天、摘要、写作、翻译),需要70B以上模型的任务使用云端或远程连接。
- 将Phi-4 Mini(3.8B)与旧款Phi-3 Mini(3.8B)混淆。 两者参数量相同,但Phi-4 Mini的训练数据和chat template不同。始终确认GGUF文件名中的模型标识符——是
phi-4-mini-instruct而非phi-3-mini-4k-instruct。
参考来源
- Phi-4 Mini技术报告 — Microsoft Research(2024年12月)。
- Gemma 3技术报告 — Google DeepMind(2025年)。
- SmolLM 2模型卡 — Hugging Face(2024年)。
- Qwen 3技术报告 — Alibaba Cloud(2024年)。
- Llama 3.2模型卡 — Meta AI(2024年)。
- SmolLM3发布公告 — Hugging Face blog(2025年7月)。
- Gemma 3n模型概览 — Google AI for Developers。
- Gemma 3视觉支持(4B、12B、27B)— Google blog。
- SmolLM与SmolVLM2模型系列 — Hugging Face TB organization。
- Q4_K_M量化参考 — llama.cpp文档。
常见问题
iPhone上哪款移动模型最快?
Gemma 3 1B在iPhone 17 Pro上约35–45 tokens/sec,绝对最快,但是此列表中最小的模型。在1.7B模型(速度与质量平衡)中,SmolLM 2 1.7B以约26–32 tokens/sec最快。在产生旗舰级输出质量的模型中,Phi-4 Mini约13–18 tokens/sec是最快的"智能"选项。按使用场景选择:如果响应速度比深度更重要,选SmolLM 2;如果深度更重要,选Phi-4 Mini。
有Gemma 3 2B或Gemma 3 7B模型吗?
没有。Gemma 3官方提供五种规模:270M、1B、4B、12B和27B——不存在Gemma 3 2B或Gemma 3 7B。这种混淆通常源于Gemma 2,它确实有一个2B模型(Google DeepMind,2024年7月发布),与9B和27B并列。如果你想找最接近"Gemma 3 2B"的选择,真正存在的两个选项是Gemma 3 1B(更小、更快)和Gemma 3 4B(更大、更智能)——本文对两者都做了对比。2026年4月,谷歌还发布了Gemma 4,尺寸阵容不同(Effective 2B和Effective 4B,以及26B MoE和31B密集型变体)。Gemma 4是与Gemma 3不同的独立模型系列,由于截至本次更新尚无经过验证的端侧tokens/sec数据,本移动端对比暂未涵盖。
这些模型需要GPU吗,还是仅靠CPU运行?
六款模型均可在没有独立GPU的情况下运行。在iPhone上,MLC Chat使用苹果的Metal API在Neural Engine/GPU上加速推理,但PocketPal AI和LLM Farm(llama.cpp)主要在CPU上运行。在Android上,Termux+Ollama目前仅靠CPU运行——尚未利用骁龙Hexagon NPU,这就是为什么在相同Q4_K_M文件下Android的tokens/sec比iPhone低约10–20%(见上方对比表)。实际情况是:Phi-4 Mini在三星Galaxy S25 Ultra上仅靠CPU运行,速度约10–15 tokens/sec,本榜单中没有任何模型需要独立GPU才能产生可用输出。
Phi-4 Mini真的能在手机上超越7B模型吗?
它在MMLU和推理任务等标准基准测试上超越旧款7B模型(Llama 3.3 7B、Mistral Small v0.1),尽管只有一半大小。它不能超越当前7B模型(Llama 3.3 7B、Mistral Small v0.3)的原始能力——后者在广泛知识和复杂推理上仍然领先。Phi-4 Mini能超重发挥的原因是微软的训练数据组合(富含合成推理链和高质量文本)。在手机上,7B模型通常太慢而不实用,所以Phi-4 Mini默认胜出。
SmolLM 2能在4年前的手机上运行吗?
可以,在大多数4年前的旗舰机上可以。SmolLM 2 1.7B在Q4_K_M下需要约1.1 GB RAM用于模型加约500 MB推理开销——适合iPhone 13(6 GB)、iPhone 12 Pro Max(6 GB)和同等Android(6 GB以上)。在2021年的4GB设备(iPhone 12、基础款Android)上技术上能加载,但在其他内存压力下不稳定;改用Gemma 3 1B。
手机上翻译哪款模型最好?
涉及中文、日文、韩文、阿拉伯文、德文、法文、西班牙文或俄文的语言对选Qwen3 1.7B。它以强大的多语言表示训练,在英语优先模型(Phi-4 Mini、Llama 3.2 3B)产生生硬或混乱结果的地方提供母语级质量。仅欧洲语言对可以考虑Gemma 3 4B作为次选。英语与特定语言之间的一次性翻译,安装的翻译应用(Google翻译、DeepL)通常优于任何本地LLM——本地模型在同一对话中需要将翻译与聊天或摘要结合时才真正发光。
使用这些模型需要旗舰手机吗?
不需要,只有最大的模型(Phi-4 Mini 3.8B、Gemma 3 4B、Llama 3.2 3B)才需要。6–8GB RAM的中端手机以全速(约20–28 tokens/sec)运行SmolLM 2 1.7B和Qwen3 1.7B。4–6GB RAM的入门手机以约15–25 tokens/sec运行Gemma 3 1B。诚实的回答:如果还没有旗舰机,不要为了本地AI去买——现有手机上的小型模型对大多数使用场景已经足够。
哪款模型耗电最少?
Gemma 3 1B遥遥领先——最小的模型意味着每个token计算最少,CPU/GPU负载更低,功耗更低。SmolLM 2 1.7B和Qwen3 1.7B次之。3B–4B模型(Phi-4 Mini、Llama 3.2 3B、Gemma 3 4B)每次回答耗电约多2–3倍。在电量最为重要的长途飞行或长时间离网使用中,尽管有质量代价,Gemma 3 1B是正确选择。
移动模型能处理多轮对话吗?
短对话(5–10轮)可以,之后质量下降。六款模型的上下文窗口均为4,000–8,000 tokens;更长的对话超出窗口后模型会丢失早期轮次。对于需要跨会话记忆的持续聊天,实用的做法是:定期摘要对话,保存摘要,然后作为上下文输入回去。大多数移动应用(PocketPal AI、Private LLM)会自动完成此操作;LLM Farm需要手动配置。
这些模型支持语音输入吗?
支持,与Whisper语音转文字层结合使用。2026年移动端标准离线语音方案是:Whisper(small或tiny模型)语音转文字 → Phi-4 Mini或SmolLM 2生成回答 → Apple TTS或Android TTS语音合成。SmolLM 2 1.7B是语音的最佳LLM选择,因为高tokens/sec使语音对话响应保持在约1.5秒感知门槛以下——完整流程请参考在手机上构建本地语音助手。
旅行离线使用哪款最好?
需要切换语言和翻译的旅行:Qwen3 1.7B。主要需要英语参考(问问题、摘要旅行文件、起草邮件)的旅行:旗舰机用Phi-4 Mini,中端机用SmolLM 2 1.7B。旅行是本地AI最强的整体使用场景——无需漫游数据、无云端API费用,也不用担心网络差的地区云依赖失效。旅行前下载模型;适度使用可以在单次充电下撑过整段旅程。
适合运行本地LLM的最佳手机是哪款?
RAM最大、芯片最新的旗舰机。按本文的参考数据,iPhone 17 Pro(A19 Pro)最快,Galaxy S25 Ultra(Snapdragon 8 Elite)在相同Q4_K_M文件下约慢10–20%。运行Phi-4 Mini这类3B–4B模型需要8GB以上RAM;12GB(iPhone 17 Pro Max、Galaxy S25 Ultra)可为Q5_K_M留出余量。如果你已有6GB RAM的手机,就能全速运行1.7B模型,因此不必只为本地AI去买新手机。
运行本地LLM会让手机过热吗?
持续生成会让芯片长时间处于高负载,手机会发热并可能降低时钟频率,从而使长时间使用时的tokens/sec下降。本文没有实测的降频数据。要控制温度,可以换更小的模型(Gemma 3 1B的功耗远低于3B–4B模型,后者每次回答耗电约多2–3倍)、让回答保持简短,并避免在模型运行时充电。
中端三星Galaxy或其他Android手机能运行这些模型吗?
可以,只要RAM足够。先查清你具体机型的RAM版本,再对照:8GB可运行SmolLM 2 1.7B或Llama 3.2 3B,6GB可运行Qwen3 1.7B或SmolLM 2 1.7B,4GB只能运行Gemma 3 1B。RAM比芯片更重要;芯片主要影响速度。按本文的数据,在相同文件下Android的tokens/sec约比iPhone低10–20%。
这些模型的体积是多少MB?
Q4_K_M下:Gemma 3 1B约720 MB,Qwen3 1.7B约1,100 MB,SmolLM 2 1.7B约1,100 MB,Llama 3.2 3B约2,200 MB,Phi-4 Mini约2,700 MB,Gemma 3 4B约2,900 MB。文件大小也大致相当于模型运行时占用的RAM,另加约500 MB推理开销。Q5_K_M文件约大25%。
有SmolLM 3或SmolLM 4吗?
SmolLM 3存在:Hugging Face于2025年7月发布,是一款3B参数模型,具备思考与非思考模式、64k训练上下文(借助YaRN最高可达128k),支持英语、法语、西班牙语、德语、意大利语和葡萄牙语。截至本页最近一次更新,尚无SmolLM 4;Hugging Face当时尚未发布。由于没有经过验证的端侧数据,SmolLM 3未纳入本文的速度对比,但3B参数使它与Llama 3.2 3B属同一体量。
Gemma 3n是什么?它比Gemma 3更适合手机吗?
Gemma 3n是Google为端侧使用打造的模型系列,分E2B和E4B两种规格。"E"表示有效参数:E2B加载超过50亿原始参数,但内存占用可低于20亿(1.91B)。它支持文本、图像和音频输入,覆盖140多种语言。它与Gemma 3 4B是不同的取舍,而不是直接替代的升级版;由于目前尚无经过验证的数据,本文的速度对比也未涵盖它。
手机端LLM能生成图像描述和替代文本吗?
只有具备视觉能力的模型才行。本文的六款模型中,只有Gemma 3 4B支持图像输入,其余五款均为纯文本模型。Gemma 3n和SmolVLM2(256M、500M、2.2B)同样可处理图像。你的应用必须为该模型开放图像输入,因为基于llama.cpp的应用需要单独的视觉投影器文件。发布前务必检查每条描述——小型视觉模型可能误读文字、错误标注物体。
有适合手机的2.5B参数模型吗?
本文涵盖的主流手机模型中没有。最接近的规格是1.7B档(SmolLM 2、Qwen3)和3B档(Llama 3.2 3B、SmolLM 3)。Gemma 3n E2B在思路上最接近:它加载超过50亿原始参数,但有效内存占用低于20亿。
离线摘要场景下,哪款模型的每MB准确度最高?
本文没有自己的准确度基准测试,因此答案只是定性的。1.1 GB的模型(Qwen3 1.7B、SmolLM 2 1.7B)是短摘要的高效中间选择,非英语文本用Qwen3。如果能腾出内存,Phi-4 Mini(约2.7 GB)是六款中的质量上限;Gemma 3 1B(约720 MB)则是仍能生成连贯短摘要的最小模型。
手机LLM的响应能在100毫秒以内吗?
完整回答做不到。在iPhone 17 Pro上,仅token生成,Phi-4 Mini每token约55–77 ms(13–18 tok/sec),Gemma 3 1B每token约22–29 ms(35–45 tok/sec),因此即使用最快的模型,一条20个token的回复也要约半秒。100 ms以内只对寥寥几个token现实可行,例如极短的分类输出,不适用于聊天或图像描述。
移动端模型在2027年还有用吗?
有用,但具体型号名称会变化。移动小型LLM前沿大约每6–9个月移动一次——到2026年Q4可能出现超越Phi-4 Mini的新~3B模型,到2027年中期1B–2B类可能达到今天3B–4B模型的水平。这个类别不会过时;具体推荐会更新。查阅此文章(下次更新预计:2027-04-19)了解下一代阵容。