快速事实
- 测试设备: Samsung Galaxy S25 Ultra(Snapdragon 8 Elite,12 GB RAM)、Google Pixel 9 Pro(Tensor G5,16 GB RAM)、OnePlus 13(Snapdragon 8 Elite,16 GB RAM)。
- 测试的芯片组系列: Snapdragon 8 Elite(Hexagon NPU)、Tensor G5(NPU 不向第三方应用开放)、MediaTek Dimensity 9400(涵盖 APU 规格,非测试设备)。
- 12 GB 安卓的最佳模型: Phi-4 Mini(3.8B,Q4_K_M 约2.7 GB)——6款应用在全部3部测试手机上都能运行。
- 8 GB 安卓的最佳模型: Qwen3 1.7B 或 SmolLM2 1.7B——所有应用都能运行;内存非常受限的设备用 Gemma 3 1B。
- 运行 3B 模型的最低 RAM: 6 GB 设备内存。低于 6 GB 时,请使用 1.7B 模型。
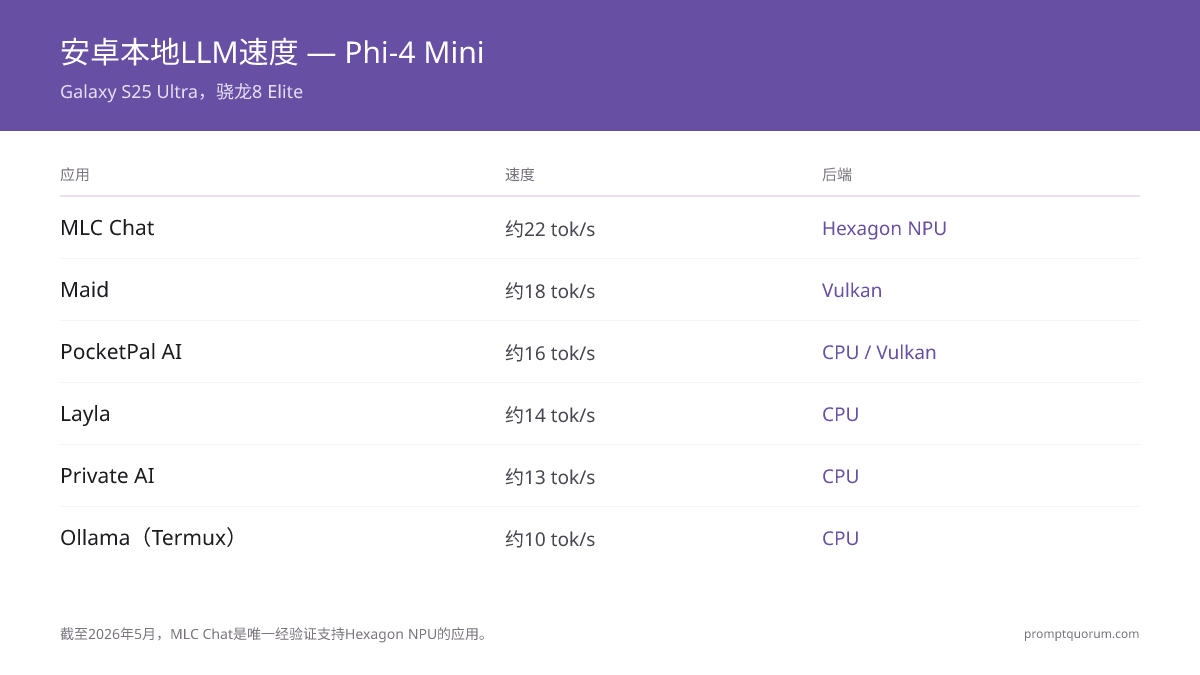
- S25 Ultra 上的 token/秒(Phi-4 Mini): MLC Chat 约22 token/秒(NPU)、PocketPal AI 约16 token/秒(CPU/Vulkan)、Maid 约18 token/秒(Vulkan)、Layla 约14 token/秒(CPU)、Private AI 约13 token/秒(CPU)、Ollama Termux 约10 token/秒(CPU)。
- Play Store vs F-Droid: MLC Chat、Layla、PocketPal AI 和 Private AI 在 Google Play 上架。Maid 主要在 F-Droid。Ollama via Termux 需要从 F-Droid 安装 Termux。
- 分享菜单集成(安卓): 只有 PocketPal AI 和 Layla 原生支持接收安卓分享菜单的文本。
- 只想快速知道该装哪款应用? 请看安卓本地LLM快速推荐——不含基准测试,直接对比 MLC Chat、Pocketpal 和 Termux + Ollama。
对比表
Token 速度在 Samsung Galaxy S25 Ultra(Snapdragon 8 Elite,12 GB RAM)上测得,运行 Q4_K_M 量化的 Phi-4 Mini。 NPU 利用情况因应用而异——MLC Chat 是唯一经过验证支持 Hexagon NPU 的应用。
📍 简单一句话
2026年,MLC Chat 凭借 Snapdragon Hexagon NPU 支持在安卓本地LLM速度上领先:在 Galaxy S25 Ultra 上运行 Phi-4 Mini 约22 token/秒、运行 Qwen3 1.7B 约40 token/秒——比同一硬件上仅用 CPU 的方案快2–3倍。
应用 | Phi-4 Mini 速度(S25 Ultra) | NPU 支持 | 最适合 |
|---|---|---|---|
| MLC Chat | 约22 token/秒(NPU 路径) | 是——Snapdragon 8 Elite 的 Hexagon NPU | Snapdragon 手机上速度优先的用户 |
| Maid | 约18 token/秒(Vulkan GPU) | 部分——Vulkan GPU,无专用 NPU 路径 | 开源 / F-Droid 用户,完整 GGUF 访问 |
| Layla | 约14 token/秒(CPU) | 否 | 初学者,精选模型下载 |
| Ollama via Termux | 约10 token/秒(CPU) | 否(标准 Termux 版本仅用 CPU) | 高级用户,API 访问,工具调用 |
| Private AI | 约13 token/秒(CPU) | 否 | 隐私优先用户,权限最少 |
| PocketPal AI | 约16 token/秒(CPU/Vulkan) | 部分——兼容设备上用 Vulkan GPU | 多数用户——最佳界面 + 完整 GGUF 生态 |
| MemoryAI | 未测量 | 未测试 | 文档、可编辑记忆、儿童模式(基准测试之后加入) |
| Laria | 未测量 | 未测试 | 本地模型加云端接口(付费应用) |
| Mobile LM Server | 未测量 | 未测试 | 手机上的本地 API 服务器(含广告和应用内购买) |
| On Device LLM | 未测量 | 未测试 | 内置模型的简单离线聊天(新应用) |
💡提示: 在 Pixel 9 Pro(Tensor G5)上,请把 MLC Chat 从榜首拿掉——6款应用在那里都只能用 CPU 运行,PocketPal AI 和 Maid 凭界面质量胜出。对第三方推理应用来说,NPU 优势在 Tensor G5 上完全消失。
⚠️警告: Layla 和 Private AI 的 token/秒数据是 Phi-4 Mini Q4_K_M 的 CPU 路径估算值。实际速度会随发热状态变化——手机发热后持续推理,速度可能比冷启动时下降20–30%。
应该选择哪款应用?
合适的应用取决于您的设备芯片组,以及您更看重定制能力还是简单易用。 安卓用户明显分为两派:想要精致原生体验的(PocketPal AI、Layla),和想要最大控制权的(Ollama via Termux、Maid)。与 iPhone 不同,安卓两种都允许。想深入了解不同设备上模型大小与 RAM 需求的对应关系,请参阅显存需求指南 →。
💬 简单来说
如果您有 Snapdragon 8 Elite 手机并想要最快的推理,选 MLC Chat。想要模型支持最广、界面最精致的综合最佳应用,选 PocketPal AI。想在手机上拥有完整的本地 AI API 且习惯使用终端,选 Ollama via Termux。想要完全开源、通过 F-Droid 分发且不依赖 Google 的方案,选 Maid。刚接触本地AI、想要精选模型下载,选 Layla。把数据隐私和最少权限放在首位,选 Private AI。
- Snapdragon 8 Elite 手机(S25 Ultra、OnePlus 13): 从 MLC Chat 开始。如果您需要 MLC Chat 模型库中没有的模型,再加装 PocketPal AI 作为第二款应用——它通过 Vulkan 加速推理,涵盖完整的 GGUF 生态。
- Pixel 9 Pro(Tensor G5): NPU 优势消失——PocketPal AI 在界面质量和模型广度上是首选。MLC Chat 在 Tensor G5 上退回仅用 CPU,失去速度优势。
- 任意安卓手机,定制优先: Ollama via Termux + 聊天前端(Alpaca,或在 Chrome 中使用 Open WebUI)是功能最强的组合。需要约30分钟的终端操作,但可获得兼容 OpenAI 的 API、工具调用,以及完整的 Ollama 模型库。
- 去 Google 化 / 隐私手机: 从 F-Droid 安装 Maid。可在 GrapheneOS、CalyxOS 及其他去 Google 化的系统上运行,不依赖 Play Services。
- 文档、可编辑记忆,或孩子使用手机: MemoryAI(基准测试之后加入,此处未实测)。免费、可离线,带 PIN 锁定的儿童模式;应用商店标注需要 4 GB 以上内存。
- 一款付费应用里同时有本地模型和云端接口: Laria(基准测试之后加入,此处未实测)。请先阅读其内容和年龄分级说明。
- 手机上的 OpenAI 或 Ollama 风格本地 API: Mobile LM Server(基准测试之后加入,此处未实测)。会有广告和应用内购买。
- 内置模型的简单免费离线聊天: On Device LLM(基准测试之后加入,此处未实测)。这是一款较新的 1.0 版应用。
- 8 GB RAM 手机: 6款应用中的任何一款,搭配 Qwen3 1.7B 或 SmolLM2 1.7B。在内存受限的设备上,PocketPal AI 的模型存储处理最为妥帖。
- Samsung Galaxy(任何型号): 请留意 Samsung 激进的后台查杀。把 AI 应用锁定在最近任务列表中,并在“设备维护 → 电池 → 休眠应用”中将其加入白名单,避免推理中途被终止。
💡提示: 如果您有 Snapdragon 手机,主要用于离线聊天,可以同时安装 MLC Chat(短会话中追求速度)和 PocketPal AI(使用 MLC Chat 模型库没有的模型做较长内容的工作)。两者可以共存,且使用各自独立的模型存储。
芯片组对比:Snapdragon vs MediaTek vs Tensor
Snapdragon 8 Elite 是2026年安卓上本地LLM推理能力最强的芯片组——它的 Hexagon NPU 是 MLC Chat 中唯一经过验证支持的移动端 NPU。 Tensor G5 和 MediaTek Dimensity 9400 运行这6款应用时,只能使用 CPU 或 Vulkan GPU 模式。
📍 简单一句话
2026年,Snapdragon 8 Elite 的 Hexagon NPU 在安卓上的推理速度比仅用 CPU 快2–3倍,但只有 MLC Chat 利用了这一优势——其他应用在所有芯片组上都退回 CPU 或 Vulkan GPU。
芯片组 | 搭载机型 | 第三方应用 NPU | 最佳推理路径 | Phi-4 Mini 速度(估算) |
|---|---|---|---|---|
| Snapdragon 8 Elite | Galaxy S25 系列、OnePlus 13、Xiaomi 15 Pro | 是——通过 MLCC 使用 Hexagon NPU(仅 MLC Chat) | Hexagon NPU(MLC Chat)或 Vulkan GPU(Maid、PocketPal) | 约22 token/秒(NPU)/ 约16–18 token/秒(Vulkan) |
| Google Tensor G5 | Pixel 9 系列 | 否——Google 将 NPU 保留给自家应用 | CPU(所有应用仅用 CPU 运行) | 约12–15 token/秒(CPU) |
| MediaTek Dimensity 9400 | Xiaomi 15 Ultra、Oppo Find X8 Pro、Vivo X200 Pro | 有限——通过实验性 NNAPI 路径访问 MediaTek APU | Vulkan GPU(最佳第三方选项);NNAPI 为实验性 | 约14–18 token/秒(Vulkan)/ 约12 token/秒(CPU) |
| Snapdragon 8 Gen 3 | Galaxy S24 系列、OnePlus 12 | 部分——Hexagon 为较旧一代,MLC Chat 支持有限 | Vulkan GPU 或 CPU | 约12–15 token/秒(Vulkan) |
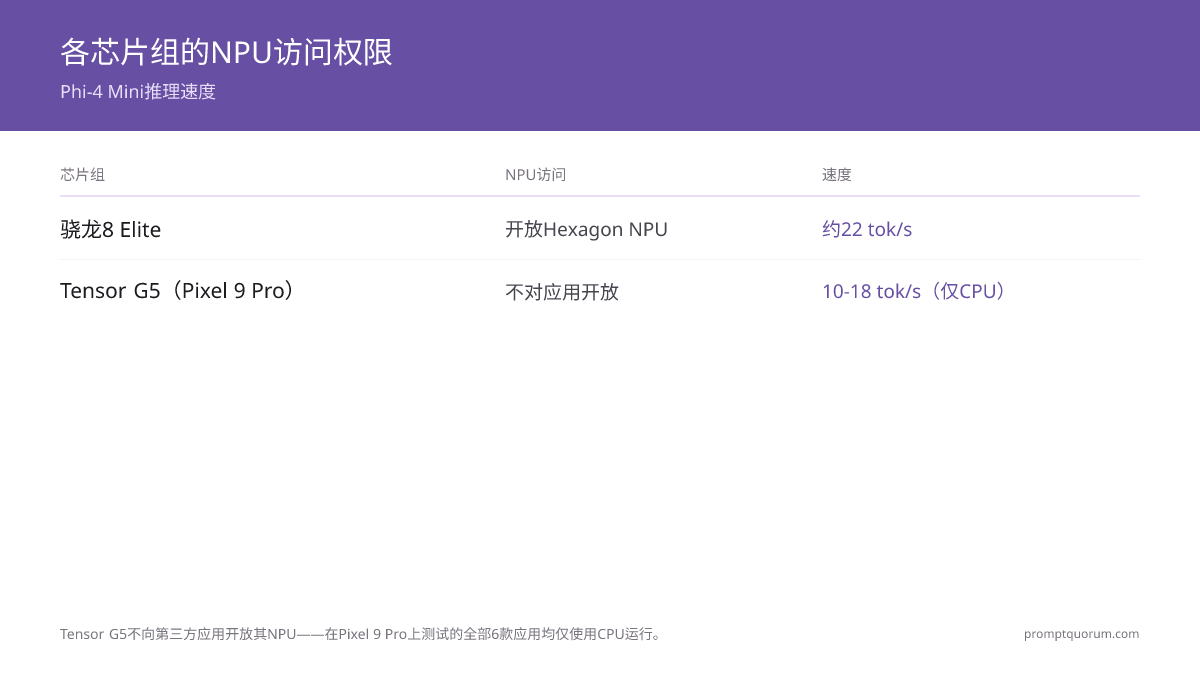
⚠️警告: 不要以为 Google Tensor G5 的 NPU 能让本地LLM应用受益。Google 的 NPU 保留给自家的机器学习服务(Google 翻译、录音机、照片处理)。包括本指南中全部6款在内的第三方推理应用,在每一部 Pixel 手机上都只能用 CPU 运行。Pixel 9 Pro 真正的优势是16 GB RAM——能容纳更大的模型,而不是推理更快。
💡提示: MediaTek Dimensity 9400 手机可受益于 Maid 和 PocketPal AI 中的 Vulkan GPU 支持。如果您使用 Xiaomi 15 Ultra 或 Oppo Find X8 Pro,请在应用设置中启用 Vulkan,速度比 CPU 路径提升30–40%。
MLC Chat
MLC Chat(Machine Learning Compilation Chat)是2026年 Snapdragon 8 Elite 设备上最快的安卓本地LLM应用。 它由 MLC AI 团队开发,使用 MLCC 框架编译模型,可直接调用 Snapdragon Hexagon NPU——这是使用 llama.cpp 或通用 Vulkan 后端的应用无法走的优化路径。
- 模型库: 精选——MLC Chat 自带一组为移动端优化的预编译模型(Qwen3 1.7B、Phi-4 Mini、Gemma 3 1B、Llama 3.2 1B)。可以导入自定义模型,但需要 MLC 编译工具链——不是随手一点就能完成的过程。
- NPU 利用: 在 Snapdragon 8 Elite(Galaxy S25 Ultra、OnePlus 13)上经过验证的 Hexagon NPU 支持。在 S25 Ultra 上测得 Qwen3 1.7B 约40 token/秒、Phi-4 Mini 约22 token/秒——同一硬件上仅用 CPU 为约12–16 token/秒。
- 界面质量: 简洁、实用、极简。只有聊天界面——没有系统提示词编辑器、角色卡或多模型切换。适合专注的聊天任务,而不是高级用户的深度配置。
- 安卓分享菜单: 不支持。无法通过标准分享菜单接收其他应用的文本。
- 离线可靠性: 优秀。模型编译并缓存后,MLC Chat 运行时零网络调用。与部分基于 llama.cpp 的应用相比,后台进程更稳定。
- 存储: MLC Chat 把编译后的模型权重存放在其私有应用目录中(为 Snapdragon 编译的 Phi-4 Mini 约3 GB)。这些文件无法移植到其他应用——这是相对基于 GGUF 的应用的一项局限。
- 安装途径: Google Play 商店。源代码见 github.com/mlc-ai/mlc-llm。
⚠️警告: MLC Chat 的模型库是精选并经过编译的。如果您需要官方库之外的模型(例如微调过的 Mistral Small 或特定领域模型),MLC Chat 帮不上忙——请用 PocketPal AI 或 Maid 来支持任意 GGUF。MLC Chat 是速度工具,不是灵活性工具。
Maid
Maid 是完全开源、F-Droid 优先的安卓本地LLM应用——基于 Flutter 构建,以 llama.cpp 作为推理后端,分发时不依赖 Google Play。 它支持从文件管理器直接导入 GGUF,在兼容设备上支持 Vulkan GPU 加速,并可在去 Google 化的安卓系统(GrapheneOS、CalyxOS)上运行。
- 模型库: 不设限。任何 GGUF 模型文件都可以通过安卓文件管理器导入,或通过 URL 下载。这包括不在 Hugging Face 上、或不在精选应用库中的模型。
- NPU 利用: 在兼容设备上走 Vulkan GPU 路径——不是专用 NPU。在 Snapdragon 8 Elite 上,Vulkan 运行 Phi-4 Mini 约18 token/秒,而 MLC Chat 的 NPU 路径约22 token/秒。无法使用 Hexagon NPU。
- 界面质量: 实用,但不如 PocketPal AI 或 Layla 精致。具备系统提示词编辑器、温度控制和基础的聊天记录管理。对角色卡的支持有限。
- 安卓分享菜单: 不支持。
- 离线可靠性: 优秀——基于 llama.cpp 的推理很稳定。OEM 系统(Samsung、OnePlus)的后台限制依然适用。
- 存储: 模型存放在应用私有目录或用户指定的路径。GGUF 文件如果放在共享的可访问存储中,可在 Maid 和 PocketPal AI 之间通用。
- 安装途径: F-Droid(主要)、GitHub Releases。源代码见 github.com/Mobile-Artificial-Intelligence/maid。不在 Google Play 上架。
💡提示: 如果您使用 GrapheneOS 或去 Google 化的安卓系统,Maid 是当前最佳选择——它不依赖 Google Play Services。可通过 F-Droid 客户端安装,也可从 GitHub Releases 页面下载 APK,再用 ADB 侧载。
Layla
Layla 是对初学者最友好的安卓本地LLM应用——它把模型管理藏在精选的下载流程之后,无需终端,聊天界面精致,且不会把推理设置摆到您面前。 代价是模型选择较少,且只能用 CPU 推理。
- 模型库: 精选,规模较小。Layla 提供托管式下载体验——在应用内模型库中选一个模型,它会自动下载并配置。自定义 GGUF 导入不是主要功能。
- NPU 利用: 仅走 CPU 路径——不支持 Vulkan GPU 或 Hexagon NPU。这使 Layla 在 Snapdragon 8 Elite 上成为6款应用中最慢的(Phi-4 Mini 约14 token/秒),但在所有安卓芯片组上表现一致。
- 界面质量: 对首次使用者来说是6款应用中最好的。以聊天为中心,对话管理清晰,没有繁杂的设置,模型切换流畅。
- 安卓分享菜单: 支持——Layla 可以通过安卓分享菜单接收其他应用的文本,是本指南中仅有的两款融入标准安卓分享流程的应用之一。
- 离线可靠性: 良好。模型下载后完全离线。由于不运行本地服务器进程(与 Ollama via Termux 不同),较不容易被后台查杀。
- 存储: Layla 在内部管理模型存储,无需手动管理文件。
- 安装途径: Google Play 商店。
💡提示: Layla 的分享菜单支持让它在安卓工作流中格外有用:在任意应用中选中文本 → 分享 → Layla → 针对这段文本提问。这种无需切换应用的即时 AI 辅助,正是 Layla 胜过本列表中其他所有应用的地方。
Ollama via Termux
Ollama via Termux 是安卓上获得完整的、兼容 OpenAI 的本地 API 的唯一途径——包括工具调用、函数调用,以及让第三方安卓应用连接到本地运行的模型。 配置需要20–30分钟,并要求习惯使用终端,但最终得到的是桌面用户在 Mac 和 Linux 上运行的同一套 Ollama 生态,现在就在手机上。
- 模型库: 无限制——完整的 Ollama 模型库都可通过 `ollama pull [model-name]` 获取。这是本指南所有应用中模型访问范围最广的。
- NPU 利用: 标准 Ollama ARM64 版本仅用 CPU。标准 Termux 配置下不支持 Vulkan GPU 或 Hexagon NPU。这使 Ollama 的原始 token/秒最慢(在 S25 Ultra 上运行 Phi-4 Mini 约10 token/秒)。
- 工具调用与函数调用: 支持——Ollama 在安卓上处理工具调用的方式与桌面端相同。可将任何支持工具调用的前端连接到 localhost:11434。
- 安卓分享菜单: 不直接支持。变通办法:使用 Termux:Widget 快捷方式,把剪贴板内容通过管道传给 `ollama run [model]`。
- 后台可靠性: 在 Samsung 和 OnePlus 上,若不加入电池优化白名单就会出问题。为
ollama serve创建一个 Termux:Widget 快捷方式,并在最近任务列表中锁定 Termux。Samsung One UI 需要明确关闭 Termux 的“休眠应用”设置。 - 安装途径: 从 F-Droid 安装 Termux,然后通过 curl 运行 Ollama 安装脚本。
- 1从 F-Droid 安装 Termux(不要用 Play Store 版本——Play Store 版本已过时,会导致 Ollama 安装失败)。
- 2在 Termux 中运行:
pkg update && pkg install curl - 3安装 Ollama:
curl -fsSL https://ollama.com/install.sh | sh——它会检测安卓 ARM64 环境并安装正确的二进制文件。 - 4拉取模型:
ollama pull qwen3:1.7b或ollama pull phi4-mini。 - 5启动服务:
ollama serve(让它在 Termux 会话中持续运行,或使用后台小组件)。 - 6通过 Termux 交互:
ollama run phi4-mini——或将任何支持兼容 OpenAI 端点的应用连接到http://localhost:11434。
⚠️警告: 手机上的 Ollama via Termux 会明显慢于桌面端的 Ollama——在 S25 Ultra 上运行 Phi-4 Mini 约10 token/秒,而 RTX 4090 上超过60 token/秒。请把它用于便利场景(离线的口袋 API、离开办公桌时的快速查询),而不是追求性能。如果想在手机上获得大模型的质量,更好的办法仍然是在 Chrome 中通过 Open WebUI 远程连接家中运行 Ollama 的主机。
💡提示: 安装 Termux:Widget 插件,创建一个运行 ollama serve 的一键快捷方式。这样无需打开 Termux,就能从安卓主屏幕小组件启动 Ollama 服务器。服务启动后,任何配置为使用 localhost:11434 的应用都会自动连接。
Private AI
Private AI 是隐私优先的安卓本地LLM应用——为希望所有推理都留在设备上的用户设计,权限最少、没有网络遥测,配置简单、无需技术背景。 它请求的权限比本指南中任何其他应用都少,并且在初次下载模型后不会再访问外部服务器。
- 模型库: 精选且经过隐私筛选的模型集。下载来源可验证。无法访问任意 Hugging Face 仓库——用灵活性换取可控、可审计的模型供应。
- NPU 利用: 仅走 CPU 路径。在所有芯片组上表现一致,Phi-4 Mini 约13 token/秒(S25 Ultra)。
- 界面质量: 简洁、极简。以聊天为中心,支持导出对话,没有使用遥测。缺少高级配置选项(temperature、top-p、系统提示词)——这是有意简化。
- 安卓分享菜单: 不支持。
- 离线可靠性: 同类最佳。设计上完全离线运行。没有后台网络调用、没有同步、没有分析统计。
- 权限: 极少——请求存储访问和麦克风(用于语音输入,可选)。不请求通讯录、位置或广告 ID。
- 安装途径: Google Play 商店。
💡提示: 如果您的使用场景涉及敏感的专业文本——法律草稿、医疗笔记、机密商业内容——Private AI 的最少权限和可审计的无遥测架构就很有意义。对一般的生产力用途,PocketPal AI 是更好的综合选择,但 Private AI 的信任模型更强。
PocketPal AI
PocketPal AI 是2026年多数用户的最佳全能安卓本地LLM应用。 它兼具完整的 GGUF 模型生态(Hugging Face 上的任何模型)、Vulkan GPU 加速、6款应用中最精致的原生移动界面、对安卓分享菜单的直接支持,以及对安卓存储的正确处理——本指南中没有任何其他单一应用能同时做到这些。
- 模型库: 完整的 GGUF 生态——可在应用内直接浏览并下载 Hugging Face 上的模型,或导入本地 GGUF 文件。覆盖范围与 Maid 相当,同时增加了精选的发现界面。
- NPU 利用: 在兼容设备上走 Vulkan GPU 路径。在 Snapdragon 8 Elite 上运行 Phi-4 Mini 约16 token/秒——落后于 MLC Chat 的 NPU 路径(约22 token/秒),但领先于同一设备上所有仅用 CPU 的应用。
- 界面质量: 6款应用中最好的原生移动界面。手势导航、对话管理、系统提示词编辑器、模型基准测试,以及按模型划分的设置面板。基于 React Native + llama.rn 构建。
- 安卓分享菜单: 支持——PocketPal AI 和 Layla 是本指南中仅有的两款融入安卓分享菜单的应用。在任意应用中选中文本 → 分享 → PocketPal AI。
- 离线可靠性: 优秀。没有后台服务器进程(与 Ollama via Termux 不同)——推理在进程内运行,避免了影响服务器式方案的安卓后台查杀问题。
- 存储: 默认把 GGUF 文件存放在应用私有存储中,也可选择指向外部存储。模型文件如果移到安卓共享存储,可在 Maid 中通用。
- 安装途径: Google Play 商店。源代码见 github.com/a-ghorbani/pocketpal-ai。
💡提示: PocketPal AI 的应用内模型基准测试工具(运行一段简短提示词并测量 token/秒)很适合在您自己的手机上比较不同大小的模型。在正式选定日常使用的模型之前,不妨分别用 Phi-4 Mini、Qwen3 1.7B 和 Qwen3 4B 跑一遍,找出设备的实际速度上限。
MemoryAI:带可编辑记忆的离线聊天(未实测)
MemoryAI 是一款面向 Android 的免费离线聊天应用,支持文档问答、可在设备上编辑的记忆,以及带 PIN 锁的儿童模式。 它是在主要对比之后加入的,因此不在对比表中,也不属于我们的测试范围。
- 模型库: 模型在应用内下载(每个 0.3–4 GB),也可以从 Hugging Face 导入自定义 GGUF 文件。它使用两种推理引擎:llama.cpp 和 Google 的 LiteRT。
- 功能: 文档问答、可打开、编辑和删除的智能体记忆、免提语音(设备端语音输入和朗读)、借助视觉模型的图像理解,以及锁在家长 PIN 之后的儿童模式。
- 要求与价格: Android 9 及以上,至少 4 GB 内存。免费,无广告、无订阅、无应用内购买。
- 隐私与许可: 模型下载完成后,聊天、文档和记忆都留在设备上。应用会发送使用事件和崩溃报告(据开发者称不含聊天内容),并且是闭源的。
- 安装方式: Google Play 商店(下载量 1000+)。2026 年 3 月 30 日首次发布,所以还是一款较新的应用。Google Play 列出的版本为 1.0.60(2026 年 10 月 25 日更新);据其更新说明,首个模型的下载会在 Wi-Fi 下自动开始,模型按设备能否运行分组,被中断的下载会继续。
💡提示: 以上信息来自应用商店页面、隐私政策以及审阅过我们文章的开发者;我们没有在自己的测试手机上对 MemoryAI 计时。完整说明见MemoryAI 评测。
Laria:同时支持本地与云端模型的付费助手(未实测)
Laria 是一款付费的 Android 助手,将可下载的本地模型与可选的云端接口结合在一起。 它是在主要对比之后加入的,因此不在速度数据中。
- 模型与接口: 可下载本地模型(据开发者称包括 Gemma、Granite、Qwen、Phi、SmolLM、Mistral 等,提供 LiteRT、ONNX 和 GGUF 版本),也可连接 OpenAI、Anthropic、Gemini、OpenRouter、Ollama 和 LM Studio 等云端和服务器接口,因此并非所有内容都留在手机上。
- 功能: 支持图片输入和语音的聊天。开发者页面上的模型评分来自其自己的基准测试,而非我们的测试。
- 价格与更新: 付费安装(美国 Play 商店 4.99 美元;其他地区按当地定价)。最近更新于 2026 年 10 月 23 日,下载量 1000+。未公布版本号。
- 隐私与内容: 开发者的隐私声明称使用本地模型时不收集任何数据,但 Play 的数据安全卡片同时把位置列为可能共享。闭源。开发者模型页面上的示例回复包含带有性暗示的陪伴式文字,Play 显示的年龄分级为 Teen。
- 安装方式: Google Play 商店。
💡提示: 以上信息来自 Play 页面和开发者的页面;我们没有在自己的测试手机上打开过 Laria。完整说明见Laria 评测。
Mobile LM Server:手机上的本地 API 服务器(未实测)
Mobile LM Server(Play 标题为“Mobile LM Server - Local AI”)在手机上运行模型,并提供兼容 OpenAI 和 Ollama 的 API 服务器。 它是在主要对比之后加入的,因此不在速度数据中。
- 引擎与 API: 据页面所述,使用 LiteRT-LM 和 llama.cpp(GGUF)引擎,提供兼容 OpenAI 和 Ollama 的 API 服务器,并可选择混合路由到云端。
- 费用与广告: 免费安装,但 Play 标注“含广告”和“应用内购买”;购买内容能解锁什么并无说明。
- 更新与使用情况: 版本 1.1.10,2026 年 10 月 22 日更新,需要 Android 7.0 及以上,下载量 1000+,45 条评分平均 3.8。
- 隐私与许可: 隐私政策称提示词和回复从不上传,但列出了启动和模型事件、崩溃日志以及用于投放广告的大致位置;数据安全卡片写着“未收集数据”,同时又把位置列为可能共享。闭源。“Chaterminal”只是开发者名称,与同名的 GitHub 终端工具无关。
- 安装方式: Google Play 商店。
💡提示: 以上信息来自 Play 页面和开发者的隐私政策;我们没有在自己的测试手机上打开过 Mobile LM Server。完整说明见Mobile LM Server 评测。
On Device LLM:内置模型的简单离线聊天(未实测)
On Device LLM(Play 标题为“Local LLM”,开发方 Feather AI)是一款免费的 Android 聊天应用,内置七个模型,并带有可选的本地 API。 它是在主要对比之后加入的,因此不在速度数据中。
- 模型: 内置七个模型,也可粘贴 GGUF 链接;下载默认来自 Hugging Face。未说明推理引擎。
- 本地 API: 可选的兼容 OpenAI 的 API,端口 11434,默认关闭且无认证。
- 价格与更新: 免费安装,据描述无广告。版本 1.0,2026 年 9 月 11 日更新,需要 Android 7.0 及以上(64 位),安装量 100+。
- 隐私与许可: Play 的数据安全卡片写着“未收集数据”,但隐私政策称 Firebase Analytics 会记录匿名事件,且其联系邮箱是占位符(SUPPORT@EXAMPLE.COM)。闭源。
- 安装方式: Google Play 商店。
💡提示: 以上信息来自 Play 页面和开发者的页面;我们没有在自己的测试手机上打开过 On Device LLM。完整说明见On Device LLM 评测。
安卓碎片化:存储、RAM 与后台限制
安卓碎片化给本地LLM应用带来三个实际问题:存储分区冲突、RAM 分配不一致,以及 OEM 激进的后台查杀策略。 这三点在 Samsung、OnePlus、Pixel 和其他安卓 OEM 设备上都会影响模型的可靠性,而在 iOS 上不会出现这些情况。
💬 简单来说
安卓碎片化意味着,一款在 Pixel 9 Pro 上运行完美的本地LLM应用,可能在 Galaxy S25 Ultra 上推理到一半就崩溃——原因不在应用或模型,而是 Samsung 的后台查杀策略为了省电而终止了进程。每家安卓 OEM 对这些策略的定制各不相同——Pixel 最接近 AOSP 标准;Samsung、OnePlus 和 Xiaomi 默认的后台查杀都更激进。
- 存储分区: 安卓的
/data/user/0/(应用私有存储)和/sdcard/(共享存储)是相互独立的分区。多数本地LLM应用把模型存放在私有应用存储中,不获取 root 权限就无法在文件管理器中浏览。如果想在 Maid 和 PocketPal AI 之间共享 GGUF 文件,必须先把它复制到共享位置。 - RAM 分配: 安卓不会给第三方应用保证的内存配额。系统需要内存时,会结束后台进程——包括推理进程。在12 GB RAM 的设备上(S25 Ultra 的默认配置),正常使用时很少出现这个问题。在8 GB RAM 的手机上,推理期间启动任何其他应用都可能将其打断。
- Samsung One UI 后台查杀: 主流安卓 OEM 中最激进的。进入“设置 → 设备维护 → 电池 → 后台使用限制 → 休眠应用”,手动把所有LLM应用从该列表中移除。同时点击应用图标,在最近任务列表中锁定它。
- OnePlus OxygenOS 后台查杀: 与 Samsung 类似。进入“设置 → 电池 → 电池优化”,找到该LLM应用并设为“不优化”。另外,在最近任务概览中锁定该应用。
- Pixel(最接近 AOSP): 后台行为最可预测。请求
FOREGROUND_SERVICE权限的应用(PocketPal AI 和 Maid 都会这样做)在 Pixel 上活跃推理时运行可靠。对于很长的会话,仍建议将其排除在电池优化之外。 - Xiaomi MIUI/HyperOS: 后台查杀激进程度仅次于 Samsung。“省电模式”功能可能在生成中途终止推理。进入“设置 → 应用 → 应用管理 → [应用] → 省电策略 → 无限制”。
⚠️警告: 不要依赖安卓的默认后台行为来运行任何本地LLM应用。在 Samsung 和 OnePlus 设备上,除非您在电池优化设置中明确将应用加入白名单,否则默认策略会打断长时间的推理会话(超过2分钟)。这是本指南中每款应用出现“应用在回答中途停止”反馈的头号原因。
侧载与 Termux 路径:安卓的优势
安卓的侧载和 Termux 生态让安卓用户能用到 iOS 上不存在的本地AI工具。 这是2026年安卓与 iPhone 在本地AI使用上最鲜明的实际差异。
📍 简单一句话
2026年,Ollama via Termux——在手机上运行完整的本地LLM API 服务器——是安卓独有的能力:苹果 iOS 的沙盒机制使 iPhone 上无法实现同等配置,因此对需要在设备上使用兼容 OpenAI 的本地 API 的用户来说,安卓是唯一的移动平台。
- Termux: 安卓应用中的 Linux 环境。请通过 F-Droid 安装(不要用 Play Store)。可运行 bash、Python、curl 以及几乎所有 Linux ARM64 二进制文件——包括 Ollama。iOS 上没有 Termux;其对应物 iSH 缺少对外提供本地 API 所需的网络能力。
- F-Droid 侧载: 不通过 Google Play 安装应用——适用于 Maid、Termux 和其他开源本地AI工具。下载 F-Droid 客户端 APK,在安卓安全设置中启用“安装未知来源应用”,安装 F-Droid,然后无需 Google 账户即可安装 F-Droid 收录的任何应用。
- ADB 侧载: 高级用户可通过安卓调试桥(`adb install [app.apk]`)直接侧载 APK。这样可以安装在 Play Store 上有地区限制或已被下架的应用。
- 自定义 ROM 的优势: LineageOS、GrapheneOS 和 CalyxOS 用户可以完全停用 Google Play,把 F-Droid + ADB 作为唯一的应用安装途径。Maid 和 Termux 在这些平台上完全可用。iOS 上没有对应物。
- 通过 Termux 使用 llama.cpp 服务器模式: 除了 Ollama,llama.cpp 本身也可以在 Termux 中编译并以服务器模式运行——提供另一种本地 API,部分用户更喜欢它,因为内存开销比 Ollama 更低。
💡提示: Termux + Ollama 的配置也可以作为同一部手机上其他应用的本地 API 服务器。例如,Obsidian(配合 Local REST API 插件)或自定义的快捷指令式自动化,可以查询 localhost:11434/api/generate,在无网络的情况下运行 AI 任务——这是一种真正实用的主屏幕自动化模式。
常见错误
安卓本地LLM应用的多数故障,都来自四个本可避免的错误。
- 从 Play Store 安装 Termux。 Play Store 版本的 Termux 已经过时(Termux 在2020年停止更新该版本)。目前维护中的版本在 F-Droid。
pkg install curl和 Ollama 安装脚本在 Play Store 版 Termux 上都会失败。 - 在 Pixel 手机上期待 NPU 速度。 Google Tensor G5 的 NPU 无法被第三方应用访问。6款应用在每一款 Pixel 机型上都只能用 CPU 运行。MLC Chat 的 NPU 优势只适用于 Snapdragon 8 Elite,无法迁移到 Pixel。
- 在 Samsung 上跳过电池优化白名单。 Galaxy 手机会积极结束后台进程。除非明确将 Termux 或LLM应用加入白名单,否则超过90秒的生成很可能被后台查杀策略打断。
- 下载对设备来说过大的模型。 7B Q4_K_M 模型(约4.7 GB)需要约6 GB 可用 RAM。在12 GB 手机上,再加上系统开销,已经很紧张。在8 GB 手机上,应用会在生成中途因内存不足被结束。8–10 GB 的设备请使用 Phi-4 Mini(3.8B,约2.7 GB),更低配置请使用 Qwen3 1.7B(约1.1 GB)。
- 以为存放在“下载”文件夹的模型可以被访问。 多数本地LLM应用把模型文件存放在私有应用存储中(`/data/user/0/[app-package]/`),不获取 root 权限就无法从文件管理器浏览。如果您把 GGUF 下载到“下载”文件夹并指望应用自己找到,它是找不到的——请使用应用内置的导入功能,或在设置中指向正确的路径。
- 同时运行两个推理应用。 每个应用都会把模型加载到内存中。12 GB 手机上两个 3B 模型只给系统留下约5 GB,会触发查杀。如果您同时使用 MLC Chat 和 PocketPal AI,请先关闭其中一个再打开另一个。
来源
- MLC Chat GitHub 与文档——github.com/mlc-ai/mlc-llm
- Maid GitHub(Mobile Artificial Intelligence)——github.com/Mobile-Artificial-Intelligence/maid
- PocketPal AI GitHub——github.com/a-ghorbani/pocketpal-ai
- Ollama 官方文档——ollama.com
- Termux 官方文档——wiki.termux.com
- Snapdragon 8 Elite Hexagon NPU 技术文档——Qualcomm 开发者网络
- MediaTek Dimensity 9400 APU 规格——MediaTek 产品页面
- Google Tensor G5 芯片概览——Google 硬件文档
- 安卓电池优化与后台进程限制——Android 开发者文档
常见问题
Pixel 9 Pro 能运行 7B 模型吗?
可以,Pixel 9 Pro 有16 GB RAM——足以运行 7B Q4_K_M 模型(模型权重约4.7 GB),且系统内存仍有余量。该规模下速度约为8–10 token/秒(Tensor G5 仅用 CPU)。这种用法请用 PocketPal AI 或 Maid 搭配 7B GGUF。若想要实时对话的速度,在 Pixel 9 Pro 上请坚持使用 Phi-4 Mini(3.8B,约14 token/秒)。
这些应用会使用 Snapdragon NPU 吗?
只有 MLC Chat 使用 Snapdragon Hexagon NPU,且仅限 Snapdragon 8 Elite 设备(Galaxy S25 系列、OnePlus 13)。其他5款应用使用 CPU 或 Vulkan GPU。在 MLC Chat 中,Hexagon NPU 的推理速度比同一设备上的 CPU 路径快2–3倍。
我能在 Samsung Galaxy S22 上运行本地AI吗?
可以,8 GB RAM 版本即可。Galaxy S22 搭载 Snapdragon 8 Gen 1(部分地区为 Exynos 2200)。PocketPal AI 和 Maid 搭配 Qwen3 1.7B 或 SmolLM2 1.7B 可达约8–12 token/秒。Phi-4 Mini(3.8B)可行,但在 8 GB RAM 上比较吃紧——请先关闭所有其他应用。MLC Chat 的 NPU 路径在 Snapdragon 8 Gen 1 上未经验证。
运行本地AI需要给手机 root 吗?
不需要。本指南中的6款应用都能在未 root 的安卓手机上运行。Termux 需要为 F-Droid 的 APK 启用“安装未知来源应用”,但这不等于 root。root 只与从文件管理器访问应用私有存储目录有关——推理本身并不需要。
这些应用可以和 Termux 一起使用吗?
Ollama via Termux 是一套独立完整的配置——您在 Termux 中安装 Ollama,并通过 Termux 终端交互。其余5款应用(MLC Chat、Maid、Layla、Private AI、PocketPal AI)都是独立的安卓应用,不与 Termux 交互。高级用户两者并用:用 Termux 中的 Ollama 提供 API 访问,用 PocketPal AI 获得精致的聊天界面。
它们如何应对安卓的后台限制?
后台限制是安卓本地LLM应用最大的可靠性问题。PocketPal AI 和 Maid 会请求 FOREGROUND_SERVICE 权限,因此更能抵抗后台查杀。除非在电池优化设置中明确将 Termux 加入白名单,否则 Ollama via Termux 容易受到 Samsung 和 OnePlus 后台查杀策略的影响。在 Pixel 上,后台行为最可预测。在 Samsung One UI 上,请在“设备维护 → 电池 → 休眠应用”中手动将任何LLM应用加入白名单。
我能把本地AI的输出分享到其他应用吗?
可以,任何应用都行——复制 AI 的回复,粘贴到任何地方。反方向(把其他应用中的文本发给 AI)则只有 PocketPal AI 和 Layla 出现在安卓分享菜单中。
这些应用支持 Android Auto 吗?
不支持。6款应用都不支持 Android Auto。Android Auto 限制驾驶时可以运行的应用,而这些本地LLM应用都没有开发通过认证所需的 Auto 兼容界面。
哪款应用的模型存储处理得最好?
PocketPal AI 的模型存储处理最为妥帖——它直接集成 Hugging Face 以支持应用内下载,正确处理安卓存储分区的划分,并提供模型管理界面。想通过文件系统手动管理 GGUF 文件的用户,Maid 最合适。MLC Chat 使用专有的编译模型格式,无法移植到其他应用。
我能同时运行多个模型吗?
只有当您的设备有足够的 RAM 同时容纳两个模型和安卓系统开销时才行。在16 GB 的 Pixel 9 Pro 上:两个 Phi-4 Mini 模型(每个2.7 GB)给系统留下约10 GB——理论上可行,但非常吃紧。实际使用中,请先关闭一个应用再启动另一个。Ollama via Termux 通过单个 ollama serve 进程支持模型切换,一次加载一个模型。
这些应用中有能在 iPhone 上使用的吗?
部分可以。PocketPal AI、MLC Chat 和 Maid 也有 iOS 版本,但 Layla 仅支持安卓;通过 Termux 运行的本地 API 服务器(Ollama via Termux)由于苹果的应用沙盒机制,在 iOS 上无法实现。如果您使用 iPhone,请参阅2026年苹果最佳本地LLM应用,其中介绍了 PocketPal AI、Private LLM、Locally AI、MLC Chat 以及已从 App Store 下架的 LLM Farm。
MLC Chat 是官方应用吗?如何在 Play Store 上辨别山寨克隆应用?
官方 MLC Chat 应用由 MLC AI 团队发布,源代码在 github.com/mlc-ai/mlc-llm。在 Play Store 搜索本地LLM应用时,经常会出现名称相似但背后并无真正推理引擎的无关克隆应用。安装本指南中任何应用之前,请确认 Play Store 页面显示的开发者与项目相符,并且链接到本文引用的 GitHub 仓库——PocketPal AI 的源代码在 github.com/a-ghorbani/pocketpal-ai,Maid 的在 github.com/Mobile-Artificial-Intelligence/maid。