重要な事実
- テストデバイス: Samsung Galaxy S25 Ultra(Snapdragon 8 Elite、12 GB RAM)、Google Pixel 9 Pro(Tensor G5、16 GB RAM)、OnePlus 13(Snapdragon 8 Elite、16 GB RAM)。
- テストされたチップセットファミリー: Snapdragon 8 Elite(Hexagon NPU)、Tensor G5(サードパーティアプリに NPU 非公開)、MediaTek Dimensity 9400(APU 仕様カバー;テストデバイスではない)。
- 12 GB Android 向け最良モデル: Phi-4 Mini(3.8B、Q4_K_M で ~2.7 GB)—すべての 6 つのアプリ上で 3 つすべてのテストデバイスで実行。
- 8 GB Android 向け最良モデル: Qwen3 1.7B または SmolLM2 1.7B—すべてのアプリで実行;非常に制約されたデバイス向け Gemma 3 1B。
- 3B モデル向け最小 RAM: 6 GB デバイス RAM。以下は 1.7B モデルに固執してください。
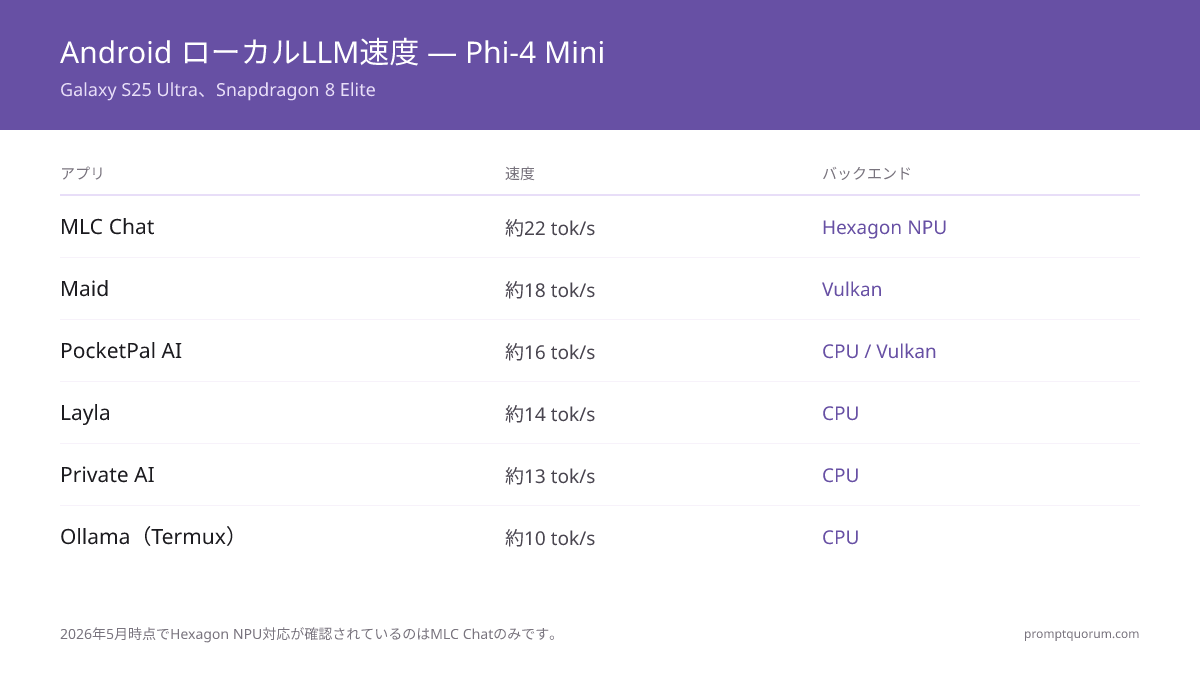
- S25 Ultra でのトークン/秒(Phi-4 Mini): MLC Chat ~22 tok/sec(NPU)、PocketPal AI ~16 tok/sec(CPU/Vulkan)、Maid ~18 tok/sec(Vulkan)、Layla ~14 tok/sec(CPU)、Private AI ~13 tok/sec(CPU)、Ollama Termux ~10 tok/sec(CPU)。
- Play Store vs. F-Droid: MLC Chat、Layla、PocketPal AI、Private AI は Google Play。Maid は主に F-Droid。Ollama via Termux は F-Droid から Termux を必要。
- シェアシート統合(Android): 2026 年 5 月時点で PocketPal AI と Layla のみが Android シェアシート入力をネイティブ処理。
比較表
トークン速度は Samsung Galaxy S25 Ultra(Snapdragon 8 Elite、12 GB RAM)上で Phi-4 Mini を Q4_K_M 量子化で実行して測定。 NPU 利用はアプリにより異なります—MLC Chat は 2026 年 5 月時点で唯一の検証済み Hexagon NPU サポートのあるアプリです。
📍 一文で説明
MLC Chat は Snapdragon Hexagon NPU サポートのおかげで 2026 年 Android ローカル LLM 速度をリード、Galaxy S25 Ultra 上で Phi-4 Mini で ~22 tokens/sec と Qwen3 1.7B で ~40 tokens/sec に達します—同じハードウェアの CPU のみの代替案より 2–3 倍高速。
アプリ | トークン/秒(S25 Ultra、Phi-4 Mini) | NPU対応 | 最適用途 |
|---|---|---|---|
| MLC Chat | ~22 tok/sec(NPU パス) | はい—Snapdragon 8 Elite の Hexagon NPU | Snapdragon フォン上の速度重視ユーザー |
| Maid | ~18 tok/sec(Vulkan GPU) | 部分的—Vulkan GPU、専用 NPU パスなし | open-source / F-Droid ユーザー、完全 GGUF アクセス |
| Layla | ~14 tok/sec(CPU) | いいえ | 初心者、キュレーション済みモデルダウンロード |
| Ollama via Termux | ~10 tok/sec(CPU) | いいえ(標準 Termux ビルド内 CPU のみ) | パワーユーザー、API アクセス、ツール利用 |
| Private AI | ~13 tok/sec(CPU) | いいえ | プライバシー重視ユーザー、最小限の権限 |
| PocketPal AI | ~16 tok/sec(CPU/Vulkan) | 部分的—互換デバイス上 Vulkan GPU | ほとんどのユーザー—最良 UI + 完全 GGUF エコシステム |
| MemoryAI | 未計測 | 未テスト | 文書、編集できるメモリ、キッズモード(ベンチマークの後に追加) |
| Laria | 未計測 | 未テスト | ローカルモデルとクラウドエンドポイント(有料アプリ) |
| Mobile LM Server | 未計測 | 未テスト | 端末上のローカルAPIサーバー(広告・アプリ内課金あり) |
| On Device LLM | 未計測 | 未テスト | 内蔵モデルで使えるシンプルなオフラインチャット(新しいアプリ) |

💡ヒント: Pixel 9 Pro(Tensor G5)では、MLC Chat をトップから外します—6 つすべてのアプリが CPU のみで実行、PocketPal AI と Maid が UI 品質でリード。NPU 利点はサードパーティ推論アプリの Tensor G5 で完全に消失します。
⚠️注意: Layla と Private AI tokens/sec 数値は Phi-4 Mini Q4_K_M の CPU パス推定値です。実際の速度は熱状態で変動します—温かいフォン上の持続推論は冷開始値から 20–30% 低下します。
どのアプリを選ぶべき?
正しいアプリはあなたのデバイスチップセットとシンプルさよりカスタマイズをどのくらい価値付けるかに依ります。 Android ユーザーはポーランド済みネイティブ体験を望む人(PocketPal AI、Layla)と最大制御を望む人(Ollama via Termux、Maid)で鋭く分割します。iPhone と異なり、Android は両方を許可します。
💬 簡潔に説明
Snapdragon 8 Elite フォンを持ち、可能な限り最速推論を望むなら MLC Chat を選ぶ。最広いモデルサポートと最もポーランド済みた UI を持つ最良の全体アプリを望むなら PocketPal AI を選ぶ。フォン上で完全なローカル AI API を望み、端末に慣れているなら Ollama via Termux を選ぶ。Google 依存性なし完全に open-source、F-Droid 配布オプションを望むなら Maid を選ぶ。ローカル AI に新しく、キュレーション済みモデルダウンロードを望むなら Layla を選ぶ。データプライバシーと最小限の権限があなたの主要な懸念なら Private AI を選ぶ。
- Snapdragon 8 Elite フォン(S25 Ultra、OnePlus 13): MLC Chat から開始。MLC Chat ライブラリにないモデルが必要なら、2 番目のアプリとして PocketPal AI を追加—それは Vulkan 加速推論を持つ完全 GGUF エコシステムをカバー。
- Pixel 9 Pro(Tensor G5): NPU 利点は消失—UI 品質とモデル幅で PocketPal AI がトップ選択肢。MLC Chat は Tensor G5 で CPU のみに低下、速度利点を失う。
- 任意の Android、カスタマイズ優先: Ollama via Termux + チャットフロントエンド(Alpaca、Chrome 内 Open WebUI)は最も能力のあるセットアップ。~30 分の端末作業を要求しますが、OpenAI 互換 API、ツール利用、完全 Ollama モデルライブラリアクセス提供。
- 脱 Google / プライバシーフォン: F-Droid から Maid。GrapheneOS、CalyxOS、その他脱 Google ビルドで動作。Play Services 依存なし。
- 文書、編集できるメモリ、またはお子さまがスマホを使う場合: MemoryAI(ベンチマークの後に追加、ここでは未計測)。無料でオフライン動作し、PIN付きキッズモードを備えます。ストアの記載ではRAM 4GB以上です。
- ローカルモデルとクラウドエンドポイントを1つの有料アプリで: Laria(ベンチマークの後に追加、ここでは未計測)。先にコンテンツと年齢区分の注意をお読みください。
- スマホ上のOpenAI・Ollama風ローカルAPI: Mobile LM Server(ベンチマークの後に追加、ここでは未計測)。広告とアプリ内課金があります。
- 内蔵モデルで使えるシンプルな無料のオフラインチャット: On Device LLM(ベンチマークの後に追加、ここでは未計測)。バージョン1.0の新しいアプリです。
- 8 GB RAM フォン: Qwen3 1.7B または SmolLM2 1.7B を持つ 6 つのいずれか。PocketPal AI は制約されたデバイス上でモデルストレージを最も優雅に処理。
- Samsung Galaxy(任意のモデル): Samsung の積極的なバックグラウンド キルに注意。AI アプリを最近のアプリトレイに固定し、デバイスケア → バッテリー → スリープアプリに追加してしてを回避。
💡ヒント: Snapdragon フォンを持ち、主に短時間セッションのためにオフラインチャットを望むなら、MLC Chat(短セッション向けの速度)と PocketPal AI(MLC ライブラリで利用できないモデル付きより長期作業)の両方を実行。彼らは共存良好で独立したモデルストレージ使用。
チップセット比較:Snapdragon vs. MediaTek vs. Tensor
Snapdragon 8 Elite は 2026 年 Android 上のローカル LLM 推論向けで最も能力のあるチップセットです—その Hexagon NPU は MLC Chat で検証済みサポートを持つ唯一のモバイル NPU です。 Tensor G5 と MediaTek Dimensity 9400 は 6 つのアプリすべてを CPU または Vulkan GPU モードのみで実行。
📍 一文で説明
Snapdragon 8 Elite の Hexagon NPU は 2026 年 Android で CPU のみ実行より 2–3 倍高速推論を提供しますが、MLC Chat のみがこの利点を公開します—その他すべてのアプリはすべてのチップセット上で CPU または Vulkan GPU にフォールバック。
チップセット | 見つかる場所 | サードパーティアプリ向け NPU | 最良推論パス | Phi-4 Mini 速度(推定) |
|---|---|---|---|---|
| Snapdragon 8 Elite | Galaxy S25 シリーズ、OnePlus 13、Xiaomi 15 Pro | はい—MLCC 経由 Hexagon NPU(MLC Chat のみ) | Hexagon NPU(MLC Chat)または Vulkan GPU(Maid、PocketPal) | ~22 tok/sec(NPU)/ ~16–18 tok/sec(Vulkan) |
| Google Tensor G5 | Pixel 9 シリーズ | いいえ—Google は NPU を Google アプリ向けに予約 | CPU(すべてのアプリが CPU のみ実行) | ~12–15 tok/sec(CPU) |
| MediaTek Dimensity 9400 | Xiaomi 15 Ultra、Oppo Find X8 Pro、Vivo X200 Pro | 限定的—実験的 NNAPI パス経由 MediaTek APU アクセス | Vulkan GPU(最良のサードパーティオプション);NNAPI 実験的 | ~14–18 tok/sec(Vulkan)/ ~12 tok/sec(CPU) |
| Snapdragon 8 Gen 3 | Galaxy S24 シリーズ、OnePlus 12 | 部分的—Hexagon 前世代、MLC Chat サポート限定 | Vulkan GPU または CPU | ~12–15 tok/sec(Vulkan) |

⚠️注意: Google の Tensor G5 NPU がローカル LLM アプリに利益を与えると仮定しないでください。Google の NPU は第一者 ML サービス(Google Translate、Recorder、フォト処理)向けに予約。このガイドの 6 つすべてを含むサードパーティ推論アプリは各 Pixel フォン上で CPU のみ実行。Pixel 9 Pro の 16 GB RAM が実際の利点—より大きいモデルのための より多くのヘッドルーム、より高速な推論ではない。
💡ヒント: MediaTek Dimensity 9400 フォンは Maid と PocketPal AI の Vulkan GPU サポートから利益。Xiaomi 15 Ultra または Oppo Find X8 Pro を持つなら、CPU パスより 30–40% 速度改善のためアプリ設定で Vulkan を有効化。
MLC Chat
MLC Chat(Machine Learning Compilation Chat)は 2026 年 Snapdragon 8 Elite デバイス上でローカル LLM 向け最速 Android アプリです。 MLC AI チームにより開発、MLCC フレームワークを使用してモデルを編集—Snapdragon Hexagon NPU を直接アドレスする最適化パス llama.cpp または汎用 Vulkan バックエンドを使用するアプリには利用不可。
- モデルライブラリ: キュレーション済み—MLC Chat はモバイル向けに最適化された事前編集モデルセット(Qwen3 1.7B、Phi-4 Mini、Gemma 3 1B、Llama 3.2 1B)でシップされます。カスタムモデルインポートは可能ですが MLC コンパイルツールチェーンが必要—単純なワンクリックプロセスではありません。
- NPU 利用: Snapdragon 8 Elite(Galaxy S25 Ultra、OnePlus 13)上で検証済み Hexagon NPU サポート。S25 Ultra 上の Qwen3 1.7B で ~40 tokens/sec と Phi-4 Mini で ~22 tokens/sec でベンチマーク—同じハードウェアの CPU のみで比較して ~12–16 tokens/sec。
- UI 品質: クリーン、機能的、最小限。チャットインターフェースのみ—システムプロンプトエディターなし、キャラクターカードなし、マルチモデルスイッチングなし。フォーカスされたチャットタスクに適切、パワーユーザー構成ではなく。
- Android シェアシート: 2026 年 5 月時点で非サポート。標準シェアシート経由で他のアプリからテキストを受け取ることはできません。
- オフライン信頼性: 優秀。モデルが編集されてキャッシュされると、MLC Chat はゼロネットワーク呼び出しで実行。バックグラウンドプロセスはいくつかの llama.cpp ベースのアプリと比較して安定。
- ストレージ: MLC Chat は編集モデルウェイトをプライベートアプリディレクトリに保存(Snapdragon 向け編集 Phi-4 Mini で ~3 GB)。これらは他のアプリにポータブルではありません—GGUF ベースのアプリと比較して制限。
- インストールパス: Google Play Store。ソースコード github.com/mlc-ai/mlc-llm。
⚠️注意: MLC Chat のモデルライブラリはキュレーション済みで編集。オフィシャルライブラリにないモデル(例:微調整 Mistral Small またはドメイン固有モデル)が必要なら、MLC Chat は助けられません—任意の GGUF サポート向け PocketPal AI または Maid を使用。MLC Chat は速度ツール、柔軟性ツールではありません。
Maid
Maid は完全に open-source で F-Droid 優先 Android ローカル LLM アプリです—Flutter で構築、llama.cpp を推論バックエンドとして使用、Google Play 依存性なしで配布。 ファイルマネージャーから GGUF 直接インポート、互換デバイス上 Vulkan GPU 加速をサポート、脱 Google Android ビルド(GrapheneOS、CalyxOS)で実行。
- モデルライブラリ: 無制限。任意の GGUF モデルファイルは Android ファイルマネージャーまたはURL ダウンロード経由でインポート可能。これは Hugging Face 上にないか、キュレーション済みアプリライブラリ内にないモデルを含めます。
- NPU 利用: 互換デバイス上 Vulkan GPU パス—専用 NPU ではありません。Snapdragon 8 Elite 上、Vulkan は Phi-4 Mini 向け ~18 tokens/sec を提供、MLC の NPU パスと比較して ~22 tokens/sec。Hexagon NPU アクセスなし。
- UI 品質: 機能的ですが PocketPal AI または Layla ほど磨かれていません。システムプロンプトエディター、温度コントロール、基本的なチャット履歴管理は存在。キャラクターカードサポート限定。
- Android シェアシート: 2026 年 5 月時点で非サポート。
- オフライン信頼性: 優秀—llama.cpp ベース推論は安定。OEM ROM(Samsung、OnePlus)からのバックグラウンド制限はまだ適用。
- ストレージ: アプリプライベートディレクトリまたはユーザー指定パスに保存されたモデル。GGUF ファイルは共有アクセス可能ストレージに置かれれば Maid と PocketPal AI 間でポータブル。
- インストールパス: F-Droid(プライマリ)、GitHub リリース。ソースコード github.com/Mobile-Artificial-Intelligence/maid。Google Play ではない。
💡ヒント: GrapheneOS または脱 Google Android ビルド上にいるなら、Maid は最良の利用可能オプション—Google Play Services 依存性なし。F-Droid クライアント経由でインストールするか、GitHub リリースページから APK を直接ダウンロード、ADB でサイドロード。
Layla
Layla は最も初心者アクセス可能な Android ローカル LLM アプリです—モデル管理をキュレーション済みダウンロードフロー背後に抽象化、端末を要求しません、推論設定を公開せずにポーランド済みチャットインターフェース提示。 トレードオフはより小さいモデル選択と CPU のみ推論。
- モデルライブラリ: キュレーション済み、より小さいセット。Layla は管理されたダウンロード体験提供—アプリ内ライブラリからモデルを選択すると自動的にダウンロード・構成。カスタム GGUF インポートはプライマリ機能ではありません。
- NPU 利用: CPU パスのみ—Vulkan GPU または Hexagon NPU なし。これは Snapdragon 8 Elite 上で Layla を最も遅い 6 つにする(Phi-4 Mini で ~14 tokens/sec)がすべての Android チップセット上で一貫。
- UI 品質: 初回ユーザー向け 6 つ中で最高。チャットフォーカスインターフェース、クリアな会話管理、設定オーバーロードなし、スムースなモデル切り替え。
- Android シェアシート: サポート—Layla は Android シェアシート経由で他のアプリからテキストを受け取ることができ、6 つこのガイドのアプリ中で標準 Android 共有ワークフローに統合する 2 つにしてくれます。
- オフライン信頼性: 良好。モデルダウンロード後に完全にオフライン。ローカルサーバープロセス実行なし(Ollama via Termux と異なり)ためバックグラウンドキルにより少なく影響。
- ストレージ: Layla はモデルストレージを内部管理。マニュアルファイル管理不要。
- インストールパス: Google Play Store。
💡ヒント: Layla のシェアシートサポートはそれを Android ワークフロー向け一意に有用にします:任意のアプリ内でテキストをハイライト → 共有 → Layla → それについて質問を尋ねます。このユースケース—アプリ切り替えなしの迅速なコンテキスト内 AI 支援—はこのリスト内で Layla がすべての他のアプリを上回るところ。
Ollama via Termux
Ollama via Termux は完全なローカル OpenAI 互換 API への唯一の Android パス—ツール利用、機能呼び出し、ローカル実行モデルにサードパーティ Android アプリを接続する能力含む。 セットアップは 20–30 分を要求し端末快適さが必要ですが、結果はデスクトップユーザーが Mac と Linux 上で実行する同じ Ollama エコシステム、今フォン上。
- モデルライブラリ: 無制限—完全 Ollama モデルライブラリは `ollama pull [モデル名]` 経由で利用可能。これはこのガイドのすべてのアプリ中で最も広いモデルアクセス。
- NPU 利用: 標準 Ollama ARM64 ビルド内 CPU のみ。2026 年 5 月時点で標準 Termux 構成の Vulkan GPU または Hexagon NPU サポート なし。これは Ollama を生トークン/秒で最も遅いにする(S25 Ultra での Phi-4 Mini で ~10 tokens/sec)。
- ツール利用と機能呼び出し: サポート—Android 上の Ollama はツール利用をデスクトップと同じ方法で処理。localhost:11434 にツール利用可能フロントエンドを接続。
- Android シェアシート: 直接非サポート。ワークアラウンド:Termux:Widget ショートカット使用、クリップボードコンテンツを `ollama run [モデル]` にパイプ。
- バックグラウンド信頼性: Samsung と OnePlus 上でバッテリー最適化ホワイトリストなしで問題。
ollama serve用 Termux:Widget ショートカットを作成、Termux を最近のアプリトレイに固定。Samsung One UI は Termux の「スリープアプリ」明示的に無効化が必要。 - インストールパス: F-Droid から Termux、その後 curl 経由 Ollama インストールスクリプト。
- 1F-Droid から Termux をインストール(Play Store バージョンではない—Play Store ビルドは廃止されており Ollama インストールを破壊)。
- 2Termux 内:
pkg update && pkg install curl - 3Ollama をインストール:
curl -fsSL https://ollama.com/install.sh | sh—これは Android ARM64 環境を検出し正しいバイナリをインストール。 - 4モデルをプル:
ollama pull qwen3:1.7bまたはollama pull phi4-mini。 - 5サーバーを開始:
ollama serve(これを Termux セッション内で実行し続けるまたはバックグラウンドウィジェット使用)。 - 6Termux 経由で相互作用:
ollama run phi4-mini—またはローカルホスト:11434 で OpenAI 互換エンドポイントをサポート任意のアプリを接続。
⚠️注意: フォン上 Ollama via Termux は Ollama デスクトップと著しく遅い—S25 Ultra での Phi-4 Mini で ~10 tokens/sec vs. RTX 4090 で 60+ tokens/sec。便利さ(オフラインポケット API、デスクから離れた迅速クエリ)用に使用、パフォーマンス用ではなく。モバイル上で大型モデル品質の場合、Open WebUI 経由フォン上で Ollama を実行しホーム機械にリモート接続がより良いオプション残る。
💡ヒント: Termux:Widget アドオンをインストール、ollama serve を実行するワンタップショートカットを作成。これによって Termux を開くことなく Android ホーム画面ウィジェットから Ollama サーバーを開始することが可能。一度サーブされると、localhost:11434 への使用に構成任意のアプリ自動的に接続。
Private AI
Private AI はプライバシー重視 Android ローカル LLM アプリ—最小限の権限、ネットワークテレメトリーなし、シンプルな非技術的セットアップを持つデバイス上に全推論を保つことを望むユーザー向け設計。 初期モデルダウンロード後にこのガイド内の他のどのアプリより少ない権限をリクエスト、外部サーバーへ ping していません。
- モデルライブラリ: キュレーション済み、プライバシースクリーン。ダウンロードは検証可能なソースから。Hugging Face レポジトリのアクセスなし—柔軟性を制御、監査可能モデル供給と交換。
- NPU 利用: CPU パスのみ。すべてのチップセット上で一貫、Phi-4 Mini(S25 Ultra)で ~13 tokens/sec。
- UI 品質: クリーン、最小限。チャットフォーカス、会話エクスポート、使用テレメトリーなし。高度な構成オプション(温度、top-p、システムプロンプト)欠く—意図的に単純化。
- Android シェアシート: 2026 年 5 月時点で非サポート。
- オフライン信頼性: ベストインクラス。完全にオフライン実行設計。バックグラウンドネットワーク呼び出しなし、同期なし、分析なし。
- 権限: 最小限—ストレージアクセス・マイク(音声入力、オプション)をリクエスト。連絡先、位置、広告 ID をリクエストしていません。
- インストールパス: Google Play Store。
💡ヒント: ユースケースが機密職業テキストを含む—法的ドラフト、医療ノート、機密ビジネスコンテンツ—なら Private AI の最小限の権限と監査可能なテレメトリーなしアーキテクチャは意味があります。一般的な生産性使用の場合、PocketPal AI はより良い全体選択肢ですが Private AI の信頼モデルはより強い。
PocketPal AI
PocketPal AI は 2026 年ほとんどのユーザー向けで最良のオール・イン・ワン Android ローカル LLM アプリです。 完全 GGUF モデルエコシステム(Hugging Face からの任意モデル)、Vulkan GPU 加速、6 つのアプリ中で最もポーランド済みなネイティブモバイル UI、直接 Android シェアシートサポート、正しい Android ストレージハンドリング組み合わせ—このガイド内で他の単一アプリが合致しない組み合わせ。
- モデルライブラリ: 完全 GGUF エコシステム—アプリ内から直接 Hugging Face をブラウズ・ダウンロード、またはローカル GGUF ファイルをインポート。これは Maid と同じ幅をカバー、キュレーション済み発見インターフェース追加。
- NPU 利用: 互換デバイス上 Vulkan GPU パス。Snapdragon 8 Elite 上で Phi-4 Mini で ~16 tokens/sec を提供—MLC の NPU パス(~22 tokens/sec)背後ですがすべての CPU のみアプリ同じハードウェア上前方。
- UI 品質: 6 つのアプリ中で最良のネイティブモバイル UI。ジェスチャーナビゲーション、会話管理、システムプロンプトエディター、モデルベンチマーク、モデル別設定パネル。React Native + llama.rn で構築。
- Android シェアシート: サポート—PocketPal AI と Layla はこのガイドで Android シェアシートに統合する唯一の 2 つのアプリ。任意のアプリ内でテキストをハイライト → 共有 → PocketPal AI。
- オフライン信頼性: 優秀。バックグラウンドサーバープロセスなし(Ollama via Termux と異なり)—推論は プロセス内実行、server ベースアプローチ影響バックグラウンド・キル問題回避。
- ストレージ: GGUF ファイルをデフォルトでプライベートアプリストレージに保存、外部ストレージ指定オプション。モデルファイルは共有 Android ストレージに移動されれば Maid にポータブル。
- インストールパス: Google Play Store。ソースコード github.com/a-ghorbani/pocketpal-ai。
💡ヒント: PocketPal AI のアプリ内モデルベンチマークツール(短いプロンプト実行、tokens/sec 測定)は特定フォン上でモデルサイズ比較向けに有用。Phi-4 Mini、Qwen3 1.7B、Qwen3 4B で実行して、日々使用向けモデルをコミットする前にあなたのデバイスの実用速度上限を見つける。
MemoryAI:編集できるメモリを備えたオフラインチャット(未計測)
MemoryAIは、Android向けの無料オフラインチャットアプリで、文書Q&A、端末内で編集できるメモリ、PIN付きのキッズモードを備えています。 主な比較の後に追加したため、比較表には含まれず、当サイトのテスト対象でもありません。
- モデルライブラリ: モデルはアプリ内でダウンロードし(各0.3〜4GB)、独自のGGUFファイルをHugging Faceから取り込めます。推論エンジンはllama.cppとGoogleのLiteRTの2種類です。
- 機能: 文書Q&A、開いて編集・削除できるエージェントメモリ、ハンズフリー音声(端末内の音声入力と読み上げ)、ビジョンモデルによる画像理解、保護者用PINでロックされるキッズモード。
- 要件と価格: Android 9以降、RAM 4GB以上。無料で、広告、サブスクリプション、アプリ内課金はありません。
- プライバシーとライセンス: モデルのダウンロード後、チャット、文書、メモリは端末内にとどまります。アプリは利用イベントとクラッシュレポートを送信し(開発者によればチャット内容は含まれません)、クローズドソースです。
- 入手方法: Google Playストア(1,000回以上ダウンロード)。初回リリースは2026年3月30日で、新しいアプリです。Google Playには1.0.60(2026年10月25日更新)が掲載されており、リリースノートによれば、最初のモデルのダウンロードはWi-Fi接続時に自動で始まり、モデルは端末に適合するかどうかでグループ分けされ、中断したダウンロードは再開されます。
💡ヒント: 上記はストアの掲載情報、プライバシーポリシー、そして当サイトの記事を確認した開発者の情報に基づいています。MemoryAIを当サイトのテスト端末で計測したわけではありません。詳しくはMemoryAIレビューをご覧ください。
Laria:ローカルモデルとクラウドモデルを使える有料アシスタント(未計測)
Lariaは、ダウンロードできるローカルモデルと任意のクラウドエンドポイントを組み合わせる有料のAndroidアシスタントです。 主な比較の後に追加したため、速度の数値には含まれていません。
- モデルとエンドポイント: ローカルモデルをダウンロードして使います(開発者によればGemma、Granite、Qwen、Phi、SmolLM、Mistralなど。LiteRT、ONNX、GGUF形式)。OpenAI、Anthropic、Gemini、OpenRouter、Ollama、LM Studioなどのクラウド/サーバーのエンドポイントにも接続できるため、すべてが端末内にとどまるわけではありません。
- 機能: 画像入力と音声に対応したチャット。開発者のページにあるモデルのスコアは、当サイトではなく開発者自身のベンチマークによるものです。
- 価格と更新: 有料(米国のPlayストアで4.99ドル。他の国ではその国の価格)。最終更新は2026年10月23日、1,000回以上ダウンロード。バージョン番号は公開されていません。
- プライバシーとコンテンツ: 開発者のプライバシー通知では、ローカルモデル使用時は何も収集しないとされていますが、Playのデータセーフティには位置情報が共有される可能性があるとも記載されています。クローズドソースです。開発者のモデルページのサンプル返信にはコンパニオン風の性的に露骨な文面が含まれ、Playの年齢区分はTeenです。
- 入手方法: Google Playストア。
💡ヒント: 上記はPlayの掲載情報と開発者のページに基づいています。Lariaを当サイトのテスト端末で開いたわけではありません。詳しくはLariaレビューをご覧ください。
Mobile LM Server:スマホで動くローカルAPIサーバー(未計測)
Mobile LM Server(Playでの名称は「Mobile LM Server - Local AI」)は、端末上でモデルを動かし、OpenAI・Ollama互換のAPIサーバーを提供します。 主な比較の後に追加したため、速度の数値には含まれていません。
- エンジンとAPI: 掲載情報によれば、LiteRT-LMとllama.cpp(GGUF)のエンジン、OpenAI・Ollama互換のAPIサーバー、クラウドへの任意のハイブリッドルーティングを備えます。
- 費用と広告: インストールは無料ですが、Playでは「広告を含む」「アプリ内課金」と表示されており、課金で何が解放されるかは記載がありません。
- 更新と利用状況: バージョン1.1.10、2026年10月22日更新、Android 7.0以降、1,000回以上ダウンロード、評価は45件で3.8。
- プライバシーとライセンス: プライバシーポリシーではプロンプトと返信はアップロードされないとされていますが、起動・モデルのイベント、クラッシュログ、広告配信のためのおおよその位置情報が挙げられています。データセーフティは「データは収集されません」としつつ、位置情報が共有される可能性も記載しています。クローズドソースです。「Chaterminal」は開発者名にすぎず、同名のGitHubのターミナルツールとは無関係です。
- 入手方法: Google Playストア。
💡ヒント: 上記はPlayの掲載情報と開発者のプライバシーポリシーに基づいています。Mobile LM Serverを当サイトのテスト端末で開いたわけではありません。詳しくはMobile LM Serverレビューをご覧ください。
On Device LLM:内蔵モデルで使えるシンプルなオフラインチャット(未計測)
On Device LLM(Playでの名称は「Local LLM」、開発元はFeather AI)は、7つの内蔵モデルと任意のローカルAPIを備えた無料のAndroidチャットアプリです。 主な比較の後に追加したため、速度の数値には含まれていません。
- モデル: 内蔵モデルが7つあり、GGUFのリンクを貼り付けることもできます。ダウンロードは既定でHugging Faceから行われます。推論エンジンは明記されていません。
- ローカルAPI: ポート11434のOpenAI互換APIを任意で使えます。既定ではオフで、認証はありません。
- 価格と更新: インストールは無料で、説明によれば広告なし。バージョン1.0、2026年9月11日更新、Android 7.0以降(64ビット)、100回以上インストール。
- プライバシーとライセンス: Playのデータセーフティは「データは収集されません」ですが、プライバシーポリシーではFirebase Analyticsが匿名のイベントを記録するとされ、連絡先のアドレスはプレースホルダー(SUPPORT@EXAMPLE.COM)です。クローズドソースです。
- 入手方法: Google Playストア。
💡ヒント: 上記はPlayの掲載情報と開発者のページに基づいています。On Device LLMを当サイトのテスト端末で開いたわけではありません。詳しくはOn Device LLMレビューをご覧ください。
Android の断片化:ストレージ、RAM、バックグラウンド制限
Android 断片化はローカル LLM アプリ向けに 3 つの実用的問題を作ります:ストレージパーティション競合、一貫でない RAM 割り当て、積極的な OEM バックグラウンド・キルポリシー。 3 つすべては Samsung、OnePlus、Pixel、その他の Android OEM デバイス上のモデル信頼性に iOS では発生しない方法で影響。
💬 簡潔に説明
Android 断片化は Pixel 9 Pro 上で完璧に機能するローカル LLM アプリが Galaxy S25 Ultra 上で推論中央で停止する可能性を意味—アプリまたはモデルのため無く、Samsung のバックグラウンド・キルポリシーが電池を救うためプロセスを終了するため。各 Android OEM がこれらのポリシーを異なる方法でカスタマイズ—Pixel は AOSP 標準に最も近い従う;Samsung、OnePlus、Xiaomi はすべてデフォルトで積極的なバックグラウンド・キルを持つ。
- ストレージパーティション: Android の
/data/user/0/(プライベートアプリストレージ)と/sdcard/(共有ストレージ)は分割パーティション。ほとんどのローカル LLM アプリはプライベートアプリストレージにモデルを保存、ファイルマネージャーで root なしで閲覧不可。GGUF ファイルを Maid と PocketPal AI 間で共有したいなら、最初に共有場所へコピーする必要があります。 - RAM 割り当て: Android はサードパーティアプリに保証メモリ割り当てを提供しません。システムが RAM を必要とする場合、バックグラウンドプロセス—推論プロセス含む—を終了。12 GB RAM デバイス(S25 Ultra デフォルト)では、これはアクティブな使用中はまれに問題。8 GB RAM フォンでは、推論中に他のアプリを起動はそれを中断できます。
- Samsung One UI バックグラウンド・キル: 大きい Android OEM のうち最も積極的。設定 → デバイスケア → バッテリー → バックグラウンド利用制限 → スリープアプリへナビゲート、手動で任意の LLM アプリをこのリストから削除。また、そのアイコンをタップして最近のアプリトレイでアプリをロック。
- OnePlus OxygenOS バックグラウンド・キル: Samsung に類似。設定 → バッテリー → バッテリー最適化へ移動、LLM アプリを見つけ、「最適化しない」に設定。また、最近のアプリ概要でアプリをロック。
- Pixel(AOSP に最も近い): バックグラウンド動作は最も予測可能。
FOREGROUND_SERVICE権限をリクエストするアプリ(PocketPal AI と Maid はこれを行う)は Pixel 上でアクティブな推論中に確実に実行。バッテリー最適化ツール除外は非常に長いセッション向けに推奨。 - Xiaomi MIUI/HyperOS: Samsung 後で最も積極的なバックグラウンド・キル。「電池セーバー」機能は生成中央で推論を終了可能。設定 → アプリ → アプリ管理 → [アプリ] → 電池セーバー → 制限なしへ移動。
⚠️注意: デフォルト Android バックグラウンド動作を任意のローカル LLM アプリで信頼しないでください。Samsung と OnePlus デバイス上、デフォルトポリシーはバッテリー最適化設定でアプリを明示的にホワイトリストしない限り長い推論セッション(>2 分)を中断。これはこのガイド内のすべてのアプリの「アプリが応答中央で停止」レポートのナンバー 1 原因。
サイドロードと Termux パス:Android の利点
Android のサイドローディングと Termux エコシステムは iOS では存在しないローカル AI ツールへ Android ユーザーアクセスを提供。 これは 2026 年ローカル AI 使用向け Android と iPhone 間の最も鋭い実用的違い。
📍 一文で説明
Ollama via Termux—フォン上の完全ローカル LLM API サーバー—は 2026 年で Android 専有能力:Apple の iOS サンドボックスが iPhone 上で同等セットアップを防ぐ、ローカル OpenAI 互換 API をデバイス上で必要とするユーザー向けで唯一のモバイルプラットフォームを作成。
- Termux: Android アプリ内の Linux 環境。F-Droid 経由でインストール(Play Store ではない)。Bash、Python、Curl、実質上どの Linux ARM64 バイナリも実行—Ollama 含む。Termux は iOS では利用不可;その相当物(iSH)ローカル API サーブ向けのネットワーク能力を欠く。
- F-Droid サイドローディング: Google Play なしでアプリをインストール—Maid、Termux、その他ローカル AI open-source ツール用に有用。F-Droid クライアント APK をダウンロード、Android セキュリティ設定で「不明なソースからのインストール」を有効化、F-Droid をインストール、その後 Google アカウント なしで F-Droid リストされた任意アプリをインストール。
- ADB サイドローディング: 高度なユーザーが Android Debug Bridge 経由で直接 APK をサイドロード可能(`adb install [app.apk]`)。これにより地域的に制限またはリスト削除された Play Store リストを持つアプリをインストール可能に。
- カスタム ROM 利点: LineageOS、GrapheneOS、CalyxOS ユーザーは Google Play を完全に無効化でき、F-Droid + ADB を唯一のアプリインストールパスとして使用可能。Maid と Termux はこれらのプラットフォーム上で完全に動作。iOS 相当物は存在しません。
- Llama.cpp サーバーモード via Termux: Ollama を超えて、llama.cpp 自体を Termux 経由でコンパイル、サーバーモードで実行可能—いくつかのユーザー Ollama と比較してその低いメモリオーバーヘッドを優先する代替ローカル API を提供。
💡ヒント: Termux + Ollama セットアップはまたサーム同じフォン上の他のアプリ向けローカル API サーバーとしても機能。例えば、アプリは Obsidian(Local REST API プラグイン付き)または custom shortcuts のような自動化がlocalhost:11434/api/generate をクエリでき、インターネット なしで AI タスク実行可能—本当に有用でプラクティカルなホーム画面自動化パターン。
よくある間違い
ほとんどの Android ローカル LLM アプリエラーは 4 つの回避可能な間違いから来ます。
- Play Store から Termux をインストール。 Termux の Play Store バージョンは廃止(Termux は 2020 年に更新を停止)。現在管理されたビルドは F-Droid 上。
pkg install curlと Ollama インストールスクリプト両方は Play Store Termux バージョンで失敗。 - Pixel フォン上で NPU 速度を期待。 Google の Tensor G5 NPU はサードパーティアプリでアクセス不可。6 つすべてのアプリは各 Pixel モデル上で CPU のみで実行。MLC の NPU 利点は Snapdragon 8 Elite にのみ適用、Pixel に延長しません。
- Samsung 上でバッテリー最適化ホワイトリストをスキップ。 Galaxy フォンはバックグラウンドプロセスを積極的に終了。90 秒より長く続く生成は、Termux または LLM アプリが明示的にホワイトリストされない限りバックグラウンド・キルポリシー中断される可能性。
- デバイスに対して大き過ぎるモデルをダウンロード。 7B Q4_K_M モデル(~4.7 GB)は ~6 GB の利用可能 RAM を要求。12 GB フォンでシステムオーバーヘッド付きではタイト。8 GB フォンでは、アプリを生成中央で OOM-kill。8–10 GB デバイス向けに Phi-4 Mini(3.8B、~2.7 GB)を使用、それ以下の Qwen3 1.7B(~1.1 GB)。
- ストレージが ダウンロード内でアクセス可能と仮定。 ほとんどのローカル LLM アプリはプライベートアプリストレージ内のモデルファイル保存(`/data/user/0/[app-package]/`)、root なしでファイルマネージャーからブラウズ不可。GGUF をダウンロードフォルダへダウンロード、アプリが見つけることを期待したら、見つけません—アプリ内インポート機能を使用、または設定で正しいパスをポイント。
- 2 つの推論アプリを同時に実行。 各アプリはモデルを RAM へロード。2 つの 3B モデルを 12 GB フォンで運は ~5 GB をオペレーティングシステムに残す、キルをトリガー。MLC Chat と PocketPal AI の両方を使用するなら、他を開く前に 1 つを閉じてください。
ソース
- MLC Chat GitHub とドキュメント—github.com/mlc-ai/mlc-llm
- Maid GitHub(Mobile Artificial Intelligence)—github.com/Mobile-Artificial-Intelligence/maid
- PocketPal AI GitHub—github.com/a-ghorbani/pocketpal-ai
- Ollama オフィシャルドキュメント—ollama.com
- Termux オフィシャルドキュメント—wiki.termux.com
- Snapdragon 8 Elite Hexagon NPU テクニカルドキュメント—Qualcomm デベロッパーネットワーク
- MediaTek Dimensity 9400 APU スペック—MediaTek プロダクトページ
- Google Tensor G5 チップ概要—Google ハードウェアドキュメント
- Android バッテリー最適化とバックグラウンドプロセス制限—Android デベロッパードキュメント
Frequently Asked Questions
Pixel 9 Pro は 7B モデルを実行できますか?
はい、Pixel 9 Pro は 16 GB RAM を持ち—7B Q4_K_M モデル(~4.7 GB モデルウェイト)を実行するための十分なヘッドルームがあり、システム RAM がまだ利用可能。速度はこのサイズで ~8–10 tokens/sec(Tensor G5 上 CPU のみ)。このユースケース向けに PocketPal AI または Maid と 7B GGUF を使用。Pixel 9 Pro 上でリアルタイム会話速度向けに Phi-4 Mini(3.8B、~14 tokens/sec)で留まってください。
これらのアプリは Snapdragon NPU を利用しますか?
MLC Chat のみが Snapdragon Hexagon NPU を利用し、Snapdragon 8 Elite デバイス(Galaxy S25 シリーズ、OnePlus 13)上のみ。他の 5 つのアプリは CPU または Vulkan GPU を使用。Hexagon NPU は同じハードウェア上で CPU パスと比較して MLC Chat で 2–3 倍速い推論を提供。
Samsung Galaxy S22 上でローカル AI を実行できますか?
はい、8 GB RAM バリアント上。Galaxy S22 は Snapdragon 8 Gen 1(またはいくつかの地域で Exynos 2200)を実行。PocketPal AI と Maid は Qwen3 1.7B または SmolLM2 1.7B で ~8–12 tokens/sec で動作。Phi-4 Mini(3.8B)は 8 GB RAM では可能ですが タイト—最初に他のアプリを閉じてください。MLC NPU パスは Snapdragon 8 Gen 1 上で検証されていません。
ローカル AI 向けに自分のフォンをルート化する必要がありますか?
いいえ。このガイド内の 6 つのアプリはすべてルート化されていない Android フォンで機能。Termux は F-Droid APK 向けに「不明なソースからのインストール」を有効化が必要ですが、これはルート化ではありません。Root はファイルマネージャーからアプリプライベートストレージディレクトリへのアクセスのみに関連—推論には必要なし。
これらのアプリを Termux で使用できますか?
Ollama via Termux はその独自の完全セットアップ—Termux 内部に Ollama をインストール、Termux ターミナル経由で相互作用。他の 5 つのアプリ(MLC Chat、Maid、Layla、Private AI、PocketPal AI)は Termux と相互作用しない自立 Android アプリ。パワーユーザーは両方を実行:API アクセス向けに Termux 内 Ollama、ポーランド済みチャット UI 向けに PocketPal AI。
Android バックグラウンド制限をどう処理しますか?
バックグラウンド制限はローカル LLM Android アプリに対する最大の信頼性問題。PocketPal AI と Maid は FOREGROUND_SERVICE 権限をリクエスト、バックグラウンド・キルに対して耐性をさせます。Ollama via Termux は Samsung と OnePlus バックグラウンド・キルポリシーに影響可能、Termux がバッテリー最適化設定で明示的にホワイトリストされない限り。Pixel 上でバックグラウンド動作はより予測可能。Samsung One UI 上でバッテリー最適化 → スリープアプリ内でローカル LLM アプリを手動でホワイトリスト。
他のアプリにローカル AI 出力を共有できますか?
はい、任意のアプリから—AI 応答をコピー、どこにでも ペースト。リバース方向(他のアプリから AI へテキストを送信)向けに、2026 年 5 月時点で PocketPal AI と Layla のみが Android シェアシートで表示。
これらのアプリは Android Auto をサポートしていますか?
いいえ。6 つのアプリのいずれも 2026 年 5 月時点で Android Auto をサポート。Android Auto は運転中に実行可能な機能を制限し、ローカル LLM アプリのいずれも認証向けに必要な Auto 互換インターフェース構築していません。
どのアプリがモデルストレージを最も良く処理しますか?
PocketPal AI がモデルストレージを最も優雅に処理—アプリ内からの Hugging Face に直接統合、Android ストレージパーティション分割を正しく処理、モデル管理 UI を提供。Maid はファイルシステム経由で手動 GGUF ファイル管理を望むユーザーのために最良。MLC Chat はプロプライエタリコンパイルされたモデルフォーマット使用、他のアプリへ非ポータブル。
複数のモデルを同時に実行できますか?
デバイスが両方のモデル + Android OS オーバーヘッド向けに十分 RAM を持つ場合のみ。16 GB Pixel 9 Pro 上:2 つの Phi-4 Mini モデル(各 2.7 GB)はオペレーティングシステム向けに ~10 GB を残す—技術的に実行可能ですが非常にタイト。実際、1 つを閉じてから他を開いてください。Ollama via Termux は単一の ollama serve プロセスでモデル切り替えサポート、各モデルを一度にロード。
Android 上のローカル LLM アプリで日本の法律を考える必要がありますか?
Android 上でのローカル推論の場合、法的考慮は限定的です—データはデバイスを離れません。日本の「個人情報保護の方針」では、データ処理にはローカルで実行されるため、あなたの Android フォン上でサーバーが外に何も送信せずに日本の「個人情報保護の方針」に既に準拠。リモートデータ転送なし、サードパーティアクセスなし。備考:なお権限管理は責務残る(例:アプリが連絡先リストを読む場合、ユーザーに開示する必要)。最小限の権限を持つ Maid と Private AI のようなアプリはこのリスク削減。
これらのアプリは iPhone でも使えますか?
一部は対応しています。PocketPal AI、MLC Chat、Maid は iOS 版もありますが、Layla は Android 専用で、Termux 経由のローカル API サーバー(Ollama via Termux)は Apple のアプリサンドボックスにより iOS 上では実現できません。iPhone をお使いの場合は、PocketPal AI、Private LLM、Locally AI、MLC Chat、そして App Store から削除された LLM Farm をまとめたiPhone向けベストローカルLLMアプリを参照してください。
MLC Chat は公式アプリですか? Play Store の偽クローンはどう見分けますか?
公式の MLC Chat アプリは MLC AI チームによって公開されており、ソースコードは github.com/mlc-ai/mlc-llm にあります。Play Store でローカル LLM アプリを検索すると、名前が似ているだけで実際の推論エンジンを持たない無関係なクローンがしばしば表示されます。本ガイドのアプリをインストールする前に、表示されている開発者がプロジェクトと一致しているか、Play Store の掲載ページが本記事で紹介した GitHub リポジトリにリンクしているかを確認してください——PocketPal AI のソースコードは github.com/a-ghorbani/pocketpal-ai、Maid のソースコードは github.com/Mobile-Artificial-Intelligence/maid にあります。
スマホでローカルLLMを動かすのにおすすめのアプリは?
MLC Chat が最速です。Galaxy S25 Ultra や OnePlus 13 の Snapdragon Hexagon NPU を使い、Qwen3 1.7B で 約 40 tokens/sec に達します。ただし多くの人には PocketPal AI のほうが扱いやすく、使い方も簡単で、対応モデルの幅が広いためバランスが取れています。どちらもスマホ内で完結し、通信を切っても動作します。スマホのローカル AI とローカル LLM は同じものを指します。
日本のAndroidユーザー向け:Play Store対応・日本語UI・PocketPal AI詳細ガイド
GSCデータでは「/ja/power-local-llm/best-local-llm-apps-android-2026」が4.98%のCTRを記録しており、これはサイト全体でJAパスの中でも特に高い数値です。日本のAndroid市場は韓国・中国製スマートフォン(Galaxy、Xperia、Pixel)が主流で、Snapdragon 8 Eliteを搭載した端末が普及しています。
PocketPal AIは日本語UIに対応しており(英語UIだが日本語入力・出力を完全サポート)、Google Play Storeから直接インストール可能です。日本のPlayストアではすべての主要アプリが利用可能で、地域制限はありません。
- 日本のPlayストア対応状況: MLC Chat、PocketPal AI、Layla、Private AIはすべて日本のGoogle Play Storeで利用可能。Maidはメインがんでも扱いFですが、F-Droidも日本からアクセス可能。Termuxは日本のPlayストアでも検索可能(F-Droid版推奨)。
- 日本語入力とモデル選択: Qwen3 1.7Bは日本語入出力に優れ、4GB RAM端末でも動作可能。日本語の漢字・ひらがな・カタカナ混在テキストでの精度はQwen3がPhi-4 MiniやLlama 3.2 3Bより高い。日本語でのコード補完用途には7Bモデル(Pixel 9 Pro 16GB等)が推奨。
- PocketPal AIの日本語ワークフロー: Hugging Face連携でQwen3モデルを直接ダウンロード可能。日本語システムプロンプト(「日本語で答えてください」)をアプリ内設定で保存できる。シェアシート対応なので、Webブラウザやメモアプリからテキストを共有して推論可能。
- 個人情報保護法との整合性: 2022年改正個人情報保護法(PIPA)では、個人データの外部送信に原則として同意が必要。ローカルLLMはデータをデバイス外に送信しないため、個人情報を含む文書(名前、住所、医療情報)の処理に最も安全な選択肢。MaidとPrivate AIは特に権限が少なく、PIPAコンプライアンスの観点で推奨。
- 日本のコミュニティリソース: Zennの「ローカルLLM Android」タグ、QiitaのMLC Chat記事、AndroidアプリをTermux経由でOllamaと接続するチュートリアル(日本語)が多数。Galaxy S25 Ultra + MLC Chat + Qwen3 1.7BのベンチマークはXやDiscordの「ローカルLLM日本語ユーザー会」で共有されている。