Faits rapides
- Modèles comparés : Phi-4 Mini 3.8B, Gemma 3 4B, Gemma 3 1B, SmolLM 2 1.7B, Qwen3 1.7B, Llama 3.2 3B (tous en Q4_K_M GGUF).
- Appareils de référence : iPhone 17 Pro (A19 Pro), iPhone 16 Pro (A18 Pro, 8 Go), Galaxy S25 Ultra (Snapdragon 8 Elite), Pixel 9 Pro (Tensor G4), OnePlus 13 (Snapdragon 8 Elite). Les chiffres de vitesse de cette page sont des estimations indicatives, pas des mesures réalisées par PromptQuorum ; la vitesse réelle varie selon l'application, le runtime, la quantisation, la température du téléphone et les réglages.
- Moteurs d'inférence : llama.cpp via PocketPal AI / LLM Farm (par défaut), MLC LLM via MLC Chat (accéléré Metal sur iPhone), Ollama via Termux (Android).
- Empreinte mémoire (Q4_K_M) : Phi-4 Mini ~2.7 Go, Gemma 3 4B ~2.9 Go, Llama 3.2 3B ~2.2 Go, Qwen3 1.7B ~1.1 Go, SmolLM 2 1.7B ~1.1 Go, Gemma 3 1B ~720 Mo.
- RAM minimale (active) : 6 Go pour les modèles 1.7B ; 8 Go pour les modèles 3B–4B ; 4 Go uniquement pour Gemma 3 1B.
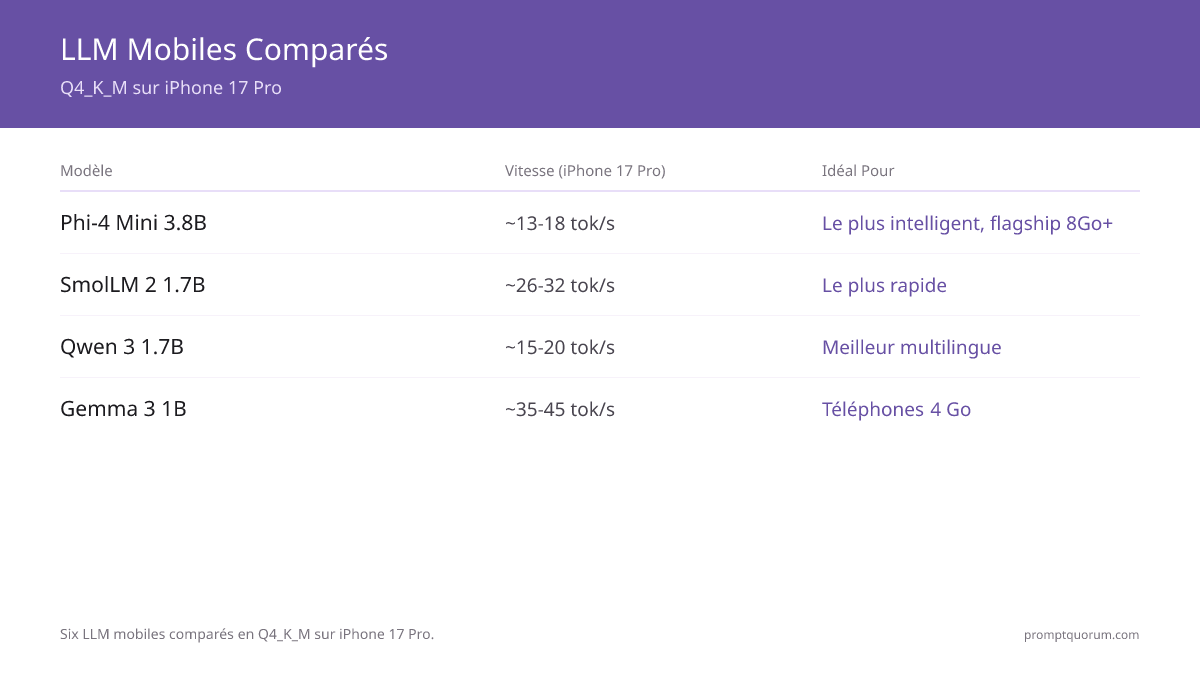
- Tokens/sec les plus rapides sur iPhone 17 Pro : Gemma 3 1B ~35–45, SmolLM 2 ~26–32, Qwen3 ~24–32, Llama 3.2 3B ~16–22, Phi-4 Mini ~13–18, Gemma 3 4B ~10–13.
- Source de quantisation : les six disponibles en Q4_K_M GGUF sur Hugging Face et via PocketPal AI / MLC Chat / LM Studio.
- Taille de téléchargement (Q4_K_M, Mo) : Gemma 3 1B ~720, Qwen3 1.7B ~1 100, SmolLM 2 ~1 100, Llama 3.2 3B ~2 200, Phi-4 Mini ~2 700, Gemma 3 4B ~2 900 — voir le tableau des tailles ci-dessous.
- Modèles récents hors du comparatif de vitesse : SmolLM 3 (3B, Hugging Face, juillet 2025) et Gemma 3n (E2B / E4B, Google). Entrée image : Gemma 3 4B uniquement parmi les six.
Quel modèle mobile choisir ?
Pour la plupart des téléphones haut de gamme (iPhone 16 Pro / 17 Pro, Galaxy S25 Ultra, OnePlus 13), choisissez Phi-4 Mini (3.8B Q4_K_M). C'est le modèle le plus intelligent sous 4B et il fonctionne à une vitesse conversationnelle utilisable. Optez pour un autre modèle uniquement si vous avez un besoin spécifique qu'il ne couvre pas — vitesse (SmolLM 2), multilingue (Qwen3) ou compatibilité avec un ancien téléphone (Gemma 3 1B).
📍 En une phrase
Phi-4 Mini pour les téléphones haut de gamme à 8 Go+ (le plus intelligent), SmolLM 2 1.7B pour la vitesse, Qwen3 1.7B pour le multilingue, Gemma 3 1B pour les téléphones à 4 Go, Llama 3.2 3B pour le tool calling, et Gemma 3 4B comme choix équilibré par défaut.
💬 En termes simples
Il n'existe pas de meilleur modèle mobile universel — le bon choix dépend de votre téléphone et de votre usage. Si votre smartphone date de moins de deux ans et dispose de 8 Go ou plus de RAM, installez Phi-4 Mini. Si vous chattez principalement dans une langue autre que l'anglais, installez Qwen3. Si vous voulez les réponses les plus rapides, même au prix d'un peu de qualité, installez SmolLM 2. Si votre téléphone est ancien ou ne dispose que de 4 Go de RAM, installez Gemma 3 1B.
Décision : quel modèle mobile ?
Utilisez un LLM local si :
- •Téléphone haut de gamme avec 8 Go+ de RAM (iPhone 16 Pro/17 Pro, Galaxy S25 Ultra, OnePlus 13) → Phi-4 Mini 3.8B
- •Besoin des tokens/sec les plus rapides sur n'importe quel appareil → SmolLM 2 1.7B
- •Usage non-anglophone (traduction, chat multilingue) → Qwen3 1.7B
- •Besoin de large compatibilité applicative, tool calling ou RAG → Llama 3.2 3B
- •Ancien téléphone avec 4 Go de RAM → Gemma 3 1B
- •Phi-4 Mini indisponible dans votre application, besoin de qualité 4B → Gemma 3 4B
Utilisez un modèle cloud si :
- •Raisonnement multi-étapes, génération de code complexe ou analyse de longs documents → cloud ou connexion distante à une machine domestique sous 70B+
- •OCR dense ou analyse d'images exigeant une grande précision → applications cloud ; les légendes d'images simples peuvent tourner sur l'appareil avec Gemma 3 4B (voir Multimodal sur téléphone ci-dessous)
- •Rédaction créative longue nécessitant une cohérence sur 3 000+ tokens → cloud ou 8B+ sur ordinateur de bureau
Décision rapide :
- →Choix par défaut pour la plupart : Phi-4 Mini 3.8B
- →Le plus rapide sur chaque téléphone de référence : SmolLM 2 1.7B
- →Meilleur multilingue : Qwen3 1.7B

💡Astuce: En cas de doute, commencez par Phi-4 Mini sur un téléphone haut de gamme ou SmolLM 2 1.7B sur un appareil milieu de gamme — les deux se téléchargent en moins de 5 minutes avec une connexion rapide et sont réversibles. Testez une invite réelle (un e-mail à résumer, une vraie question). Si la qualité est acceptable, vous avez votre modèle par défaut. Sinon, changez en 30 secondes via PocketPal AI ou LM Studio.
Tableau comparatif des modèles mobiles
Le tableau à quatre colonnes ci-dessous est la couche d'extraction rapide — choisissez une ligne par gamme d'appareil ou cas d'usage. Les chiffres de tokens/sec sont des estimations indicatives (pas des mesures de PromptQuorum) qui supposent une quantisation Q4_K_M sur iPhone 17 Pro avec PocketPal AI (llama.cpp). Ces valeurs sont 15–25 % inférieures sur iPhone 16 Pro et environ 10–20 % inférieures sur Galaxy S25 Ultra avec MLC Chat ou Termux+Ollama.
📍 En une phrase
Phi-4 Mini est le plus intelligent, SmolLM 2 1.7B le plus rapide, Qwen3 1.7B le meilleur multilingue, Gemma 3 1B le plus petit viable, Llama 3.2 3B le meilleur 3B polyvalent, et Gemma 3 4B le choix équilibré par défaut.
💬 En termes simples
Lisez ce tableau de haut en bas par ordre de taille, ou allez directement à la ligne correspondant à votre gamme d'appareil. La colonne « Idéal pour » indique ce que le modèle optimise — choisissez la ligne dont la force vous importe le plus.
Modèle | Taille | Tokens/sec (17 Pro) | Idéal pour |
|---|---|---|---|
| Phi-4 Mini | 3.8B | ~13–18 | Modèle compact le plus intelligent — choix par défaut haut de gamme |
| Gemma 3 4B | 4B | ~10–13 | Choix équilibré quand Phi-4 Mini est indisponible |
| Gemma 3 1B | 1B | ~35–45 | Anciens téléphones (4 Go de RAM) |
| SmolLM 2 | 1.7B | ~26–32 | Tokens/sec les plus rapides, chat réactif |
| Qwen3 | 1.7B | ~24–32 | Meilleur multilingue (35+ langues) |
| Llama 3.2 | 3B | ~16–22 | Meilleure option 3B, tool calling, RAG |
Note sur le compromis vitesse-qualité : les tokens/sec évoluent inversement au nombre de paramètres sur la même puce — un modèle 1B est environ 3–4× plus rapide qu'un modèle 3.8B sur matériel identique. La qualité augmente avec les paramètres mais pas linéairement : la qualité de raisonnement de Phi-4 Mini (3.8B) est plus proche d'un modèle 7B que d'un 1.7B grâce au mix de données d'entraînement de Microsoft.

💡Astuce: Les tokens/sec de l'iPhone 16 Pro sont environ 15–25 % inférieurs à ceux de l'iPhone 17 Pro pour chaque modèle — différence entre les Neural Engine A18 Pro et A19 Pro. Le Galaxy S25 Ultra (Snapdragon 8 Elite) est environ 10–20 % sous l'iPhone 17 Pro sur le même Q4_K_M GGUF, principalement parce que Termux+Ollama sur Android n'exploite pas encore le NPU Hexagon de Snapdragon comme MLC Chat exploite Apple Metal.
Phi-4 Mini : modèle le plus intelligent
Phi-4 Mini (3.8B paramètres, Microsoft, décembre 2024) est le modèle le plus intelligent sous 4B en 2026 grâce à un mix de données d'entraînement optimisé pour le raisonnement. Il surpasse Gemma 3 4B et Llama 3.2 3B sur les tâches chain-of-thought malgré une taille similaire. Utilisez-le par défaut sur tout téléphone disposant de 8 Go+ de RAM.
- Paramètres et entraînement : 3.8B paramètres ; entraîné sur un mix Microsoft combinant textes web de haute qualité, chaînes de raisonnement synthétiques et contenu académique. Architecture Transformer avec grouped-query attention.
- Empreinte mémoire : ~2.7 Go en Q4_K_M, ~3.5 Go en Q5_K_M. S'intègre confortablement sur iPhone 16 Pro / 17 Pro (8 Go) et Galaxy S25 Ultra (12 Go).
- Vitesse (tokens/sec) : iPhone 17 Pro ~13–18, iPhone 16 Pro ~10–15, Galaxy S25 Ultra ~10–15 (Termux+Ollama), iPhone 14 Pro ~6–10 (lent mais fonctionnel).
- Points forts qualité : raisonnement chain-of-thought, résumé, Q&A factuel, génération de code basique. Surpasse les modèles open source de taille similaire sur les benchmarks standard (MMLU, GSM8K).
- Points faibles qualité : connaissances du monde moins larges que Llama 3.2 3B ; rédaction créative plus courte que Gemma 3 4B ; multilingue plus faible que Qwen3 1.7B hors anglais.
- Idéal pour : utilisateurs disposant d'un téléphone haut de gamme qui souhaitent le meilleur modèle par défaut pour le chat, le résumé et le raisonnement en anglais.
💡Astuce: Phi-4 Mini bénéficie d'un prompt système invitant explicitement au raisonnement étape par étape (« Réfléchissez soigneusement avant de répondre »). Les données d'entraînement étant riches en chaînes de raisonnement, ce style de prompt produit systématiquement de meilleures réponses. Pour le chat rapide, aucun prompt système n'est nécessaire.
Gemma 3 4B : choix équilibré
Gemma 3 4B (Google DeepMind, 2025) est le choix équilibré par défaut quand Phi-4 Mini n'est pas disponible dans votre application ou si vous préférez le mix de données Google. Légèrement plus lent que Phi-4 Mini sur matériel identique, mais équivalent en chat et résumé, avec une couverture du langage naturel plus large.
- Paramètres et entraînement : 4B paramètres ; entraîné sur le mix Google de textes web, code et données multilingues. Même famille d'architecture que Gemma 2 avec un contexte étendu.
- Empreinte mémoire : ~2.9 Go en Q4_K_M, ~3.7 Go en Q5_K_M. Convient aux téléphones 8 Go+ ; à l'étroit sur les 6 Go.
- Vitesse (tokens/sec) : iPhone 17 Pro ~10–13, iPhone 16 Pro ~7–10, Galaxy S25 Ultra ~7–10 (légèrement plus lent que Phi-4 Mini malgré une taille similaire).
- Points forts qualité : ton conversationnel naturel, résumé solide, connaissances du monde plus larges que Phi-4 Mini, multilingue correct.
- Points faibles qualité : raisonnement chain-of-thought plus faible que Phi-4 Mini ; tokens/sec plus lents ; pas toujours le premier modèle ajouté aux applications mobiles.
- Idéal pour : utilisateurs haut de gamme souhaitant une alternative Google à Phi-4 Mini pour le chat quotidien, le résumé et la rédaction courte.
💡Astuce: Gemma 3 4B utilise un chat template différent de Phi-4 Mini — vérifiez que votre application utilise le bon template Gemma (avec les marqueurs <start_of_turn>). Un mauvais template produit une sortie cassée ou répétitive. PocketPal AI, MLC Chat et LM Studio le détectent automatiquement ; LLM Farm nécessite une sélection manuelle du template Gemma dans les paramètres du modèle.
Gemma 3 1B : option légère pour anciens téléphones
Gemma 3 1B (Google DeepMind, 2025) est le plus petit modèle mobile viable en 2026 — ~720 Mo en Q4_K_M et fonctionne sur les téléphones à 4 Go. La qualité se limite à des réponses courtes et cohérentes (1–2 paragraphes), mais c'est la seule option sous 1 Go produisant une sortie utilisable sur matériel faible.
- Paramètres et entraînement : 1B paramètres ; même architecture Gemma 3 que le 4B mais avec moins de compute d'entraînement. Conçu pour une inférence efficace sur appareils edge.
- Empreinte mémoire : ~720 Mo en Q4_K_M, ~900 Mo en Q5_K_M. Fonctionne sur iPhone SE 3e génération, iPhone 12/13, Android ancien (4 Go de RAM minimum).
- Vitesse (tokens/sec) : iPhone 17 Pro ~35–45, iPhone 16 Pro ~28–38, iPhone 14 ~20–28, ancien Android (4 Go) ~10–15. Modèle le plus rapide de cette sélection sur chaque appareil.
- Points forts qualité : vitesse, faible empreinte mémoire, réponses courtes cohérentes, faible consommation batterie.
- Points faibles qualité : raisonnement multi-étapes faible, erreurs factuelles fréquentes sur les sujets de niche, répétitions sur les longues générations (>500 tokens).
- Idéal pour : utilisateurs disposant de téléphones sous le seuil des 6 Go de RAM, ou toute personne optimisant pour l'autonomie sur de longs trajets.
💡Astuce: Utilisez Gemma 3 1B pour des tâches courtes et ciblées — résumés en une phrase, brouillons d'un paragraphe, définitions rapides, traduction simple entre paires de langues courantes. Évitez les explications multi-paragraphes et le raisonnement multi-étapes.
SmolLM 2 1.7B : le plus rapide en tokens par seconde
SmolLM 2 1.7B (Hugging Face, 2024) est le modèle mobile le plus rapide en tokens par seconde de cette sélection sur chaque téléphone de référence. ~26–32 tok/sec sur iPhone 17 Pro et ~20–28 sur Galaxy S25 Ultra. Idéal quand la réactivité prime sur la profondeur de réponse.
- Paramètres et entraînement : 1.7B paramètres ; entraîné sur un mix Hugging Face optimisé pour l'efficacité des petits modèles. Architecture conçue pour une inférence à faible latence.
- Empreinte mémoire : ~1.1 Go en Q4_K_M. Convient à tout téléphone avec 6 Go+ de RAM avec une large marge pour l'OS.
- Vitesse (tokens/sec) : iPhone 17 Pro ~26–32, iPhone 16 Pro ~22–28, Galaxy S25 Ultra ~20–28, iPhone 14 Pro ~15–22. Environ 2× plus rapide que Phi-4 Mini sur la même puce.
- Points forts qualité : réponses conversationnelles réactives, Q&A simple, continuation de type autocomplétion, rédaction en anglais.
- Points faibles qualité : raisonnement plus faible que Phi-4 Mini, connaissances plus limitées que Llama 3.2 3B, multilingue plus faible que Qwen3 1.7B, hallucinations occasionnelles.
- Idéal pour : appareils milieu de gamme où la latence importe (autocomplétion de saisie, assistant vocal, chat en temps réel), ou anciens flagships où les grands modèles semblent lents.

💡Astuce: SmolLM 2 1.7B est le meilleur choix pour un assistant vocal hors ligne sur mobile — voir Créer un assistant vocal local sur votre téléphone pour le pipeline Whisper + LLM + TTS. Les tokens/sec élevés maintiennent le temps de réponse vocale sous le seuil perceptif de ~1.5 seconde.
Qwen3 1.7B : meilleur modèle mobile multilingue
Qwen3 1.7B (Alibaba, 2024) est le meilleur modèle mobile multilingue en 2026 — entraîné sur 35+ langues dont le chinois, le japonais, le coréen, l'arabe, l'allemand, le français, l'espagnol et le russe. Premier choix pour la traduction, le chat non-anglophone et les usages de voyage.
- Paramètres et entraînement : 1.7B paramètres ; entraîné sur le corpus multilingue d'Alibaba avec une forte représentation des langues CJK, de l'arabe et des principales langues européennes.
- Empreinte mémoire : ~1.1 Go en Q4_K_M. Convient à tout téléphone avec 6 Go+ de RAM.
- Vitesse (tokens/sec) : iPhone 17 Pro ~24–32, iPhone 16 Pro ~20–28, Galaxy S25 Ultra ~18–26, iPhone 14 Pro ~14–20. Vitesse comparable à SmolLM 2.
- Points forts qualité : sortie de qualité native dans 35+ langues, traduction solide entre les paires de langues majeures, sortie CJK cohérente là où Phi-4 Mini et Llama 3.2 produisent des caractères cassés.
- Points faibles qualité : raisonnement en anglais seul légèrement plus faible que Phi-4 Mini, rédaction créative plus courte que Gemma 3 4B, tool calling plus faible que Llama 3.2 3B.
- Idéal pour : utilisateurs non-anglophones (notamment francophones, sinophones, japonophones, hispanophones), voyageurs nécessitant une traduction hors ligne, développeurs d'applications mobiles multilingues.
💡Astuce: Pour la traduction en une seule passe entre deux langues spécifiques, Qwen3 1.7B surpasse généralement un modèle plus grand centré sur l'anglais. Pour un utilisateur francophone chattant en français, Qwen3 produit une sortie notablement plus naturelle que Phi-4 Mini malgré une taille 60 % inférieure.
Llama 3.2 3B : modèle 3B fiable et polyvalent
Llama 3.2 3B (Meta, 2024) est le modèle 3B le plus largement pris en charge en 2026 — compatibilité applicative la plus large, meilleur support du tool calling parmi les six, et plus grand écosystème de fine-tunes communautaires. Légèrement derrière Phi-4 Mini en qualité brute mais plus fiable dans les cas limites.
- Paramètres et entraînement : 3B paramètres ; entraîné sur le large corpus de préentraînement de Meta avec instruction-tuning pour le chat et l'utilisation d'outils. Même architecture Llama 3 que les versions 8B et 70B.
- Empreinte mémoire : ~2.2 Go en Q4_K_M, ~2.8 Go en Q5_K_M. Convient aux téléphones 8 Go+ ; fonctionne sur les 6 Go si les autres applications sont fermées.
- Vitesse (tokens/sec) : iPhone 17 Pro ~16–22, iPhone 16 Pro ~12–18, Galaxy S25 Ultra ~12–18, iPhone 14 Pro ~7–11.
- Points forts qualité : connaissances larges, support robuste du tool calling et function calling (meilleur parmi les modèles sous 4B), comportement de chat fiable, écosystème mature de fine-tunes spécialisés.
- Points faibles qualité : raisonnement chain-of-thought plus faible que Phi-4 Mini, scores MMLU légèrement inférieurs à taille similaire, ton conversationnel moins naturel que Gemma 3 4B.
- Idéal pour : applications mobiles nécessitant du tool calling ou function calling (RAG sur documents locaux, workflows d'agents on-device), ou utilisateurs souhaitant la plus grande bibliothèque de fine-tunes.
💡Astuce: Llama 3.2 3B est le seul modèle de cette sélection avec un support du tool calling suffisamment fiable pour les workflows d'agents on-device — voir Agents IA locaux avec MCP 2026. Phi-4 Mini et SmolLM 2 peuvent techniquement faire du tool calling mais Llama 3.2 3B est le seul prêt pour la production en 2026.
SmolLM 3 et Gemma 3n : les nouveaux petits modèles
SmolLM 3 (Hugging Face, juillet 2025) et Gemma 3n (Google) sont les deux petits modèles récents sur lesquels les lecteurs posent le plus de questions. Aucun des deux ne figure dans le comparatif de vitesse des six modèles ci-dessus, car aucun chiffre vérifié de tokens/sec sur appareil n'existe pour eux à la date de publication. Il n'existe pas de SmolLM 4 à la date de dernière mise à jour de cette page : Hugging Face n'en avait pas publié, et SmolLM 3 était la génération la plus récente de la famille SmolLM.
- SmolLM 3 (3B) : un modèle de 3 milliards de paramètres entraîné sur environ 11 billions de tokens, avec un mode réflexion et un mode sans réflexion. Il a été entraîné avec un contexte de 64k et peut aller jusqu'à 128k à l'inférence grâce à l'extrapolation YaRN. Langues officiellement prises en charge : anglais, français, espagnol, allemand, italien et portugais. Hugging Face le présente comme compétitif face aux Qwen3 4B et Gemma 3 4B, plus grands, sur ses benchmarks de modèle de base, tout en précisant que Qwen3 4B obtient en général le meilleur score.
- SmolLM 3 sur téléphone : avec 3B paramètres, il appartient à la classe de taille de Llama 3.2 3B ; attendez-vous donc à un fichier Q4_K_M d'environ 2 Go et à la gamme à 8 Go de RAM du tableau par gamme. Il s'agit d'une estimation à partir du nombre de paramètres, pas d'une mesure.
- Gemma 3n (E2B et E4B) : le « E » signifie paramètres effectifs. E2B charge plus de 5 milliards de paramètres bruts mais, grâce au saut de paramètres et à la mise en cache des embeddings par couche, peut fonctionner avec une charge mémoire d'un peu moins de 2 milliards (1.91B). Gemma 3n accepte du texte, des images et de l'audio en entrée, a été entraîné sur plus de 140 langues et dispose d'une fenêtre de contexte de 32K tokens.
- Lequel choisir : SmolLM 3 si vous voulez un modèle 3B à mode réflexion pour l'anglais ou une grande langue européenne. Gemma 3n si votre application gère l'entrée image ou audio. Sinon, les six modèles ci-dessus restent le choix éprouvé par défaut.
💡Astuce: Jugez tout nouveau petit modèle d'abord à sa RAM, ensuite à sa vitesse. Trouvez la taille de son fichier Q4_K_M, comparez-la au tableau par gamme, et ne lisez les benchmarks qu'ensuite. Le support applicatif retarde aussi les sorties de modèles — si un modèle manque dans la liste de votre application, chargez manuellement le GGUF depuis Hugging Face.
Quantisation mobile : Q4_K_M comme standard
Q4_K_M est la quantisation standard pour l'inférence LLM mobile en 2026 — préserve ~95 % de la qualité originale à un quart de la taille du fichier. Utilisez Q5_K_M ou Q6_K uniquement sur les téléphones à 12 Go+ de RAM (iPhone 17 Pro Max, Galaxy S25 Ultra) où la mémoire supplémentaire est réellement disponible.
📍 En une phrase
Q4_K_M est le standard mobile — ~95 % de qualité à un quart de la taille. Q5_K_M / Q6_K ne valent le coup que sur les téléphones à 12 Go+ de RAM.
💬 En termes simples
Les modèles sur Hugging Face sont publiés en pleine précision (chaque paramètre stocké sur 16 bits). Sur téléphone, vous téléchargez une version quantisée où chaque paramètre est compressé sur 4 bits — le fichier est quatre fois plus petit et l'inférence environ quatre fois plus rapide, avec un léger coût en qualité. Q4_K_M est la variante sur laquelle la communauté s'est accordée en 2026 comme le bon équilibre pour smartphones.
- Q4_K_M (recommandé par défaut) : quantisation 4 bits avec K-quants et précision mixte « M ». ~95 % de la qualité originale. Standard mobile en 2026. Les six modèles disponibles dans ce format sur Hugging Face.
- Q5_K_M (pour téléphones 12 Go+) : quantisation 5 bits. ~98 % de la qualité originale. Fichiers ~25 % plus grands. Vaut le coup sur iPhone 17 Pro Max (12 Go) ou Galaxy S25 Ultra (12 Go) pour Phi-4 Mini et Llama 3.2 3B.
- Q6_K (rarement nécessaire) : quantisation 6 bits. ~99 % de la qualité originale. Fichiers ~50 % plus grands. Uniquement pour les téléphones riches en mémoire sur des modèles où chaque point de qualité compte.
- Q8_0 (à éviter sur mobile) : quantisation 8 bits. ~99.5 % de la qualité originale. Environ 2× la taille de Q4_K_M. Le surcoût en RAM ne se justifie pas sur smartphone.
- Q3_K_M / Q2_K (uniquement pour appareils très contraints) : quantisation 3 bits et 2 bits. La qualité chute à ~85–90 %. À utiliser seulement si Gemma 3 1B en Q4_K_M ne tient pas encore (rare en 2026).

⚠️Attention: Ne téléchargez pas le même modèle en plusieurs quantisations pour « tester laquelle est meilleure ». Les différences de qualité entre Q4_K_M et Q5_K_M sont réelles mais faibles, et vous gaspillerez 5+ Go de stockage. Choisissez Q4_K_M, utilisez-le une semaine en conditions réelles, et passez à Q5_K_M uniquement si vous avez des preuves concrètes que la qualité est insuffisante.
Tailles de téléchargement des modèles en Mo
En Q4_K_M, les six modèles vont de ~720 Mo (Gemma 3 1B) à ~2 900 Mo (Gemma 3 4B). Prévoyez environ 500 Mo de RAM supplémentaires pour le surcoût d'inférence en plus de la taille du fichier, et gardez au moins 3 Go de stockage libre par modèle 3B–4B que vous comptez conserver.
📍 En une phrase
Tailles des fichiers Q4_K_M : Gemma 3 1B ~720 Mo, Qwen3 1.7B et SmolLM 2 ~1 100 Mo, Llama 3.2 3B ~2 200 Mo, Phi-4 Mini ~2 700 Mo, Gemma 3 4B ~2 900 Mo.
💬 En termes simples
Le fichier que vous téléchargez correspond aussi à peu près à la RAM que le modèle occupe pendant son exécution, plus un petit surcoût. C'est pourquoi la taille du fichier, et non le nombre de paramètres, est le chiffre à comparer à votre téléphone. Si le modèle et le système d'exploitation ne tiennent pas ensemble dans votre RAM, le téléphone fermera le modèle en pleine réponse.
Modèle | Taille Q4_K_M (Mo) | RAM minimale du téléphone | Rapport taille/qualité |
|---|---|---|---|
| Gemma 3 1B | ~720 | 4 Go | Plus petit modèle viable ; réponses courtes uniquement |
| Qwen3 1.7B | ~1 100 | 6 Go | Meilleure sortie multilingue par Mo |
| SmolLM 2 1.7B | ~1 100 | 6 Go | Le plus rapide par Mo ; raisonnement léger |
| Llama 3.2 3B | ~2 200 | 8 Go (6 Go est juste) | Plus petit que les modèles 4B ; meilleur tool calling |
| Phi-4 Mini | ~2 700 | 8 Go | Meilleur raisonnement par paramètre |
| Gemma 3 4B | ~2 900 | 8 Go | Fichier le plus volumineux ; résumés naturels ; accepte les images |
Sur la précision par octet : cet article ne rapporte aucun benchmark de précision propre, donc considérez la dernière colonne comme un repère qualitatif. Pour le résumé hors ligne, les modèles de 1.1 Go (Qwen3 1.7B, SmolLM 2) constituent le juste milieu efficace ; Phi-4 Mini est le plafond de qualité si vous pouvez consacrer 2.7 Go.
Verdict par gamme : haut de gamme vs milieu de gamme vs entrée de gamme
La gamme du téléphone détermine le plafond de modèle — la génération de puce et la RAM comptent plus que la marque. Un téléphone haut de gamme (8 Go+ de RAM, A18 Pro / A19 Pro / Snapdragon 8 Elite) supporte confortablement des modèles 3.8B–4B ; un milieu de gamme (6–8 Go de RAM, ancienne puce haut de gamme) supporte 1.7B–3B ; un entrée de gamme ou ancien (4–6 Go de RAM) supporte 1B–1.7B.
📍 En une phrase
Téléphones haut de gamme (8 Go+) → Phi-4 Mini 3.8B ; milieu de gamme (6–8 Go) → SmolLM 2 1.7B ou Llama 3.2 3B ; entrée de gamme ou ancien (4–6 Go) → Gemma 3 1B ou Qwen3 1.7B.
💬 En termes simples
Adaptez le modèle à votre téléphone, pas à vos aspirations. Un modèle 3.8B sur un téléphone à 6 Go produit des pauses frustrantes de 3 secondes et des plantages. Un modèle 1B sur un haut de gamme laisse des capacités inexploitées. Choisissez le plus grand modèle que votre téléphone peut faire tourner confortablement avec l'OS et au moins une autre application ouverte.
Gamme | Exemples | Modèle recommandé | Pourquoi |
|---|---|---|---|
| Haut de gamme (8–12 Go RAM) | iPhone 17 Pro / Pro Max, iPhone 16 Pro, Galaxy S25 Ultra, OnePlus 13 | Phi-4 Mini (3.8B Q4_K_M) | Modèle le plus intelligent que la puce supporte à vitesse utilisable |
| Ancien haut de gamme (8 Go RAM) | iPhone 15 Pro, Galaxy S24 Ultra, Pixel 9 Pro | Llama 3.2 3B ou Phi-4 Mini | Llama 3.2 3B pour le tool calling ; Phi-4 Mini pour la qualité brute |
| Milieu de gamme (6–8 Go RAM) | iPhone 14 Pro, Pixel 9, téléphones Snapdragon 8 Gen 2 | SmolLM 2 1.7B ou Qwen3 1.7B | Vitesse réactive ; s'intègre avec marge pour l'OS |
| Entrée de gamme / ancien (4–6 Go RAM) | iPhone 14, Snapdragon série 7 milieu, ancien Android | Gemma 3 1B ou Qwen3 1.7B | Plus petits modèles viables produisant encore une sortie cohérente |
| Très ancien (4 Go RAM) | iPhone SE 3e génération, ancien Android 4 Go | Gemma 3 1B | Seul modèle qui tient ; raisonnement limité, tokens/sec rapides |
| Non supporté (<4 Go) | iPhone SE 2e génération, ancien Android | Connexion distante à une machine domestique | LLM on-device non pratique ; utiliser tablette/téléphone comme interface pour un serveur Ollama domestique |

💡Astuce: Pour le choix d'application, consultez les guides iPhone et Android — ils couvrent quelles applications exposent ces modèles sur chaque plateforme. La disponibilité applicative retarde parfois la disponibilité du modèle. Si un modèle est absent de la liste de votre application, il peut généralement être chargé manuellement en GGUF depuis Hugging Face.
Meilleurs téléphones pour faire tourner des LLM locaux
Le meilleur téléphone pour l'IA locale est celui qui offre le plus de RAM et la puce haut de gamme la plus récente. D'après les chiffres indicatifs de cet article, l'iPhone 17 Pro (A19 Pro) est le plus rapide, le Galaxy S25 Ultra (Snapdragon 8 Elite) étant environ 10–20 % plus lent sur les mêmes fichiers Q4_K_M. La RAM détermine quels modèles tiennent ; la puce détermine leur vitesse.
📍 En une phrase
Choisissez un téléphone avec 8 Go+ de RAM pour les modèles 3B–4B et 12 Go pour Q5_K_M — iPhone 17 Pro / 17 Pro Max, iPhone 16 Pro, Galaxy S25 Ultra et OnePlus 13 sont les téléphones utilisés dans cet article.
💬 En termes simples
Vérifiez d'abord la RAM de votre téléphone : elle fixe la taille maximale du modèle utilisable. La génération de la puce vient en second et détermine la vitesse. Inutile d'acheter un nouveau téléphone pour l'IA locale : un téléphone que vous possédez déjà fait tourner les modèles 1B–1.7B à pleine vitesse, et seuls les modèles 3B–4B demandent un haut de gamme récent.
- La RAM d'abord : 4 Go fait tourner Gemma 3 1B uniquement ; 6 Go les modèles 1.7B ; 8 Go les modèles 3B–4B ; 12 Go (iPhone 17 Pro Max, Galaxy S25 Ultra) ajoute de la marge pour Q5_K_M. Trouvez la RAM dans la fiche technique du téléphone, car certains modèles Android existent en plusieurs variantes de RAM.
- La puce ensuite : A19 Pro et A18 Pro (iPhone) et Snapdragon 8 Elite (Android haut de gamme) sont les puces derrière les vitesses de cet article. Les puces haut de gamme plus anciennes font tourner les mêmes modèles, simplement plus lentement — l'iPhone 14 Pro fait tourner Phi-4 Mini à ~6–10 tok/sec.
- iPhone vs Android : sur des fichiers Q4_K_M identiques, l'iPhone est 10–20 % plus rapide d'après les chiffres indicatifs de cet article, surtout parce que Termux+Ollama sur Android fonctionne uniquement sur CPU et n'utilise pas le NPU du Snapdragon comme MLC Chat utilise Apple Metal. Un meilleur runtime Android comble cet écart ; le matériel n'est pas la limite.
- Chaleur et batterie : une génération prolongée maintient la puce sous charge, et les téléphones réduisent leur fréquence quand ils chauffent, si bien que les tokens/sec baissent lors des longues sessions. Cet article ne contient aucun chiffre mesuré de limitation thermique. Les leviers pratiques sont un modèle plus petit (Gemma 3 1B consomme bien moins que les modèles 3B–4B, qui consomment 2–3× plus par réponse), des sorties plus courtes, et ne pas charger le téléphone pendant que le modèle tourne.
- Stockage : chaque modèle 3B–4B occupe 2.2–2.9 Go ; prévoyez la place pour un ou deux modèles, pas pour une bibliothèque de variantes.
💡Astuce: Un Android milieu de gamme (Samsung Galaxy série A et similaires) ? Cherchez la variante de RAM de votre modèle exact, puis appuyez-vous sur le tableau par gamme : 8 Go fait tourner SmolLM 2 1.7B ou Llama 3.2 3B, 6 Go les modèles 1.7B, 4 Go Gemma 3 1B. La puce compte moins que la RAM.
Multimodal sur téléphone : légendes d'images et texte alternatif
Parmi les six modèles de base, seul Gemma 3 4B accepte les images ; Gemma 3 1B, Phi-4 Mini, Llama 3.2 3B, Qwen3 1.7B et SmolLM 2 sont limités au texte. Google indique que les modèles Gemma 3 4B, 12B et 27B gèrent la vision. Gemma 3n (E2B / E4B) ajoute l'entrée image et audio, et la famille SmolVLM2 de Hugging Face (256M, 500M et 2.2B paramètres) est conçue dès l'origine pour la vision et la vidéo.
- Meilleur choix pour les légendes d'images sur un téléphone haut de gamme : Gemma 3 4B (~2.9 Go en Q4_K_M, 8 Go+ de RAM). C'est le seul des six capable de lire une photo et d'écrire une légende ou un texte alternatif.
- Android d'entrée de gamme ou CPU seul : SmolVLM2 256M ou 500M sont les plus petits modèles de vision de la famille Hugging Face et le point de départ réaliste pour un matériel faible. Cet article ne fournit aucun chiffre de vitesse vérifié pour eux.
- Le vrai facteur limitant est le support applicatif : dans les applications basées sur llama.cpp, l'entrée image nécessite un fichier de projecteur de vision distinct à côté du modèle. Si votre application n'expose pas l'entrée image pour le modèle, un modèle capable de vision ne fera que chatter en texte. Vérifiez l'application avant de télécharger.
- Workflow pour le texte alternatif : demandez une ou deux phrases simples décrivant ce qui est visible, puis relisez le résultat avant de le publier. Les petits modèles de vision peuvent mal lire le texte présent dans les images et mal étiqueter personnes ou objets : gardez donc une vérification humaine pour tout contenu destiné à l'accessibilité ou aux réseaux sociaux.
- Latence attendue : la seule génération de tokens prend ~55–77 ms par token pour Phi-4 Mini (13–18 tok/sec) et ~22–29 ms par token pour Gemma 3 1B (35–45 tok/sec), avant tout encodage d'image. Des réponses de bout en bout en moins de 100 ms ne sont donc pas un objectif réaliste pour la description d'images sur téléphone.
💡Astuce: Pour des documents denses, des reçus ou des captures d'écran remplies de petits caractères, utilisez plutôt un modèle cloud ou un modèle de vision sur ordinateur de bureau. La description d'images sur l'appareil convient surtout aux courtes descriptions de photos, où une erreur occasionnelle se corrige facilement.
Erreurs courantes
- Choisir un modèle plus grand que la RAM du téléphone ne le permet. Phi-4 Mini sur un téléphone à 6 Go tourne à 3–5 tok/sec et plante quand iOS/Android réclame de la mémoire pour une autre application. Adaptez le modèle à votre gamme (voir tableau ci-dessus).
- Télécharger plusieurs variantes de quantisation du même modèle. Choisissez Q4_K_M et arrêtez-vous là. Cinq Go de variantes Q5/Q6 redondantes sont du stockage gaspillé, et les différences de qualité sont imperceptibles en chat quotidien.
- Utiliser SmolLM 2 1.7B pour le raisonnement multi-étapes. C'est le modèle le plus rapide, pas le plus intelligent. Pour les tâches chain-of-thought (maths, planification, raisonnement complexe), utilisez Phi-4 Mini même si les tokens/sec plus lents semblent frustrants.
- Demander une sortie non-anglophone à Phi-4 Mini sans préfixe multilingue. Phi-4 Mini gère correctement les langues européennes courantes mais produit une sortie inégale en CJK ou en arabe. Pour un usage multilingue, installez Qwen3 1.7B aux côtés de Phi-4 Mini.
- Attendre une qualité cloud de ces modèles. Les six sont des modèles 1B–4B, soit environ 60–80 % des capacités de GPT-5.5 sur les tâches de chat. Utilisez-les pour ce qu'ils font bien (chat privé, résumé, rédaction, traduction) et le cloud pour ce qui nécessite un modèle 70B+.
- Confondre Phi-4 Mini (3.8B) avec l'ancien Phi-3 Mini (3.8B). Ils partagent un nombre de paramètres mais le mix de données et le chat template de Phi-4 Mini sont différents. Vérifiez toujours l'identifiant du modèle dans le nom de fichier GGUF —
phi-4-mini-instructet nonphi-3-mini-4k-instruct.
Sources
- Rapport technique Phi-4 Mini — Microsoft Research (décembre 2024).
- Rapport technique Gemma 3 — Google DeepMind (2025).
- Fiche modèle SmolLM 2 — Hugging Face (2024).
- Rapport technique Qwen3 — Alibaba Cloud (2024).
- Fiche modèle Llama 3.2 — Meta AI (2024).
- Annonce de SmolLM3 — blog Hugging Face (juillet 2025).
- Présentation du modèle Gemma 3n — Google AI for Developers.
- Prise en charge de la vision par Gemma 3 (4B, 12B, 27B) — blog Google.
- Familles de modèles SmolLM et SmolVLM2 — organisation Hugging Face TB.
- Référence quantisation Q4_K_M — documentation llama.cpp.
Questions fréquemment posées
Quel modèle mobile est le plus rapide sur iPhone ?
Gemma 3 1B est le plus rapide en absolu à ~35–45 tokens/sec sur iPhone 17 Pro, mais c'est le plus petit modèle de cette sélection. Parmi les modèles 1.7B (où vitesse et qualité sont équilibrées), SmolLM 2 1.7B est le plus rapide à ~26–32 tokens/sec. Parmi les modèles produisant une sortie de qualité haut de gamme, Phi-4 Mini à ~13–18 tokens/sec est l'option « intelligente » la plus rapide. Choisissez selon votre usage : si la réactivité prime sur la profondeur, SmolLM 2 ; si la profondeur prime, Phi-4 Mini.
Existe-t-il un modèle Gemma 3 2B ou Gemma 3 7B ?
Non. Gemma 3 est officiellement disponible en cinq tailles : 270M, 1B, 4B, 12B et 27B — il n'existe pas de Gemma 3 2B ni de Gemma 3 7B. La confusion vient généralement de Gemma 2, qui proposait bien un modèle 2B (Google DeepMind, juillet 2024) aux côtés des versions 9B et 27B. Si vous cherchez l'équivalent le plus proche d'un « Gemma 3 2B », les deux vraies options sont Gemma 3 1B (plus petit, plus rapide) et Gemma 3 4B (plus grand, plus intelligent) — tous deux comparés dans cet article. En avril 2026, Google a aussi lancé Gemma 4, avec une gamme de tailles différente (Effective 2B et Effective 4B, ainsi que des variantes 26B MoE et 31B dense). Gemma 4 est une famille de modèles distincte de Gemma 3 et n'est pas encore couverte dans ce comparatif mobile, faute de chiffres tokens/sec vérifiés sur appareil à la date de cette mise à jour.
Ces modèles ont-ils besoin d'un GPU, ou fonctionnent-ils uniquement sur CPU ?
Les six modèles fonctionnent sans GPU dédié. Sur iPhone, MLC Chat utilise l'API Metal d'Apple pour accélérer l'inférence sur le Neural Engine/GPU, mais PocketPal AI et LLM Farm (llama.cpp) tournent principalement sur CPU. Sur Android, Termux+Ollama fonctionne aujourd'hui uniquement sur CPU — il n'exploite pas encore le NPU Hexagon de Snapdragon, ce qui explique pourquoi les tokens/sec sur Android sont environ 10–20 % inférieurs à iPhone sur un même fichier Q4_K_M (voir le tableau comparatif ci-dessus). En pratique : Phi-4 Mini sur Galaxy S25 Ultra tourne uniquement sur CPU à ~10–15 tokens/sec, et aucun modèle de cette sélection n'a besoin d'un GPU dédié pour produire une sortie utilisable.
Phi-4 Mini surpasse-t-il vraiment les modèles 7B sur smartphone ?
Il surpasse les anciens modèles 7B (Llama 3.3 7B, Mistral Small v0.1) sur les benchmarks standard comme MMLU malgré sa taille deux fois inférieure. Il ne surpasse PAS les modèles 7B actuels (Llama 3.3 7B, Mistral Small v0.3) en capacité brute. La raison pour laquelle Phi-4 Mini se bat au-dessus de sa catégorie est le mix de données d'entraînement Microsoft, riche en chaînes de raisonnement synthétiques. Sur smartphone, les modèles 7B sont généralement trop lents pour être pratiques, donc Phi-4 Mini gagne par défaut.
SmolLM 2 peut-il tourner sur un téléphone de 4 ans ?
Oui, sur la plupart des anciens flagships. SmolLM 2 1.7B en Q4_K_M nécessite ~1.1 Go de RAM pour le modèle plus ~500 Mo d'overhead — convient à l'iPhone 13 (6 Go), l'iPhone 12 Pro Max (6 Go) et l'Android équivalent (6 Go+). Sur les téléphones à 4 Go de 2021 (iPhone 12, Android de base), il se charge techniquement mais est instable sous pression mémoire ; utilisez Gemma 3 1B à la place.
Quel modèle gère le mieux la traduction sur mobile ?
Qwen3 1.7B pour toute paire impliquant le chinois, le japonais, le coréen, l'arabe, l'allemand, le français, l'espagnol ou le russe. Il a été entraîné avec une forte représentation multilingue et produit une sortie de qualité native là où les modèles centrés sur l'anglais (Phi-4 Mini, Llama 3.2 3B) produisent des résultats approximatifs. Pour les paires de langues européennes uniquement, Gemma 3 4B est un deuxième choix viable. Pour des traductions ponctuelles entre l'anglais et une langue spécifique, une application de traduction dédiée (Google Traduction, DeepL) est souvent meilleure.
Faut-il un téléphone haut de gamme pour bien utiliser ces modèles ?
Non, uniquement pour les plus grands modèles (Phi-4 Mini 3.8B, Gemma 3 4B, Llama 3.2 3B). Les téléphones milieu de gamme avec 6–8 Go de RAM font tourner SmolLM 2 1.7B et Qwen3 1.7B à pleine vitesse (~20–28 tokens/sec). Les téléphones entrée de gamme avec 4–6 Go font tourner Gemma 3 1B à ~15–25 tokens/sec. La réponse honnête : si vous ne disposez pas déjà d'un haut de gamme, n'en achetez pas pour l'IA locale.
Quel modèle consomme le moins de batterie ?
Gemma 3 1B de loin — moins de paramètres signifie moins de calculs par token, donc une charge CPU/GPU plus faible. SmolLM 2 1.7B et Qwen3 1.7B suivent. Les modèles 3B–4B (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) consomment 2–3× plus d'énergie par réponse. Pour les longs trajets ou l'usage hors réseau prolongé, Gemma 3 1B est le bon choix malgré le coût en qualité.
Ces modèles gèrent-ils les conversations multi-tours ?
Oui pour les conversations courtes (5–10 tours), avec une qualité dégradée au-delà. Les six modèles ont des fenêtres de contexte de 4 000–8 000 tokens ; les conversations plus longues dépassent la fenêtre et le modèle perd le fil des tours précédents. Pour un chat continu nécessitant une mémoire entre sessions, le schéma pratique est : résumer périodiquement la conversation, stocker le résumé et le réinjecter comme contexte. La plupart des applications mobiles (PocketPal AI, Private LLM) font cela automatiquement.
Ces modèles fonctionnent-ils avec la saisie vocale ?
Oui, couplés à une couche Whisper de speech-to-text. La stack vocale hors ligne standard en 2026 est : Whisper (modèle small ou tiny) pour la transcription → Phi-4 Mini ou SmolLM 2 pour la génération de réponse → Apple TTS ou Android TTS pour la synthèse vocale. SmolLM 2 1.7B est le meilleur choix LLM pour la voix car les tokens/sec élevés maintiennent le temps de réponse réactif — voir Créer un assistant vocal local sur votre téléphone.
Quel modèle est le meilleur pour un usage hors ligne en voyage ?
Pour les voyages où vous changez de langue et avez besoin de traduction : Qwen3 1.7B. Pour les voyages où vous avez principalement besoin d'une référence en anglais (questions, résumé de documents de voyage, rédaction d'e-mails) : Phi-4 Mini sur un haut de gamme, SmolLM 2 1.7B sur un milieu de gamme. Le voyage est le cas d'usage le plus fort pour l'IA locale — pas de données en itinérance, pas de coûts API cloud, et pas de risque de dépendance cloud dans les zones à faible connectivité.
Quel est le meilleur téléphone pour faire tourner un LLM local ?
Celui qui offre le plus de RAM et la puce haut de gamme la plus récente. D'après les chiffres indicatifs de cet article, l'iPhone 17 Pro (A19 Pro) est le plus rapide, et le Galaxy S25 Ultra (Snapdragon 8 Elite) est environ 10–20 % plus lent sur les mêmes fichiers Q4_K_M. Pour les modèles 3B–4B comme Phi-4 Mini, il faut 8 Go de RAM ou plus ; 12 Go (iPhone 17 Pro Max, Galaxy S25 Ultra) ajoute de la marge pour Q5_K_M. Si vous possédez déjà un téléphone à 6 Go de RAM, vous pouvez faire tourner les modèles 1.7B à pleine vitesse : n'achetez donc pas un nouveau téléphone uniquement pour l'IA locale.
Un LLM local fait-il surchauffer mon téléphone ?
Une génération prolongée maintient la puce sous forte charge : le téléphone chauffe et peut réduire sa fréquence, ce qui diminue les tokens/sec lors des longues sessions. Cet article ne contient aucun chiffre mesuré de limitation thermique. Pour limiter la chauffe, utilisez un modèle plus petit (Gemma 3 1B consomme bien moins que les modèles 3B–4B, qui consomment 2–3× plus par réponse), gardez des réponses courtes et évitez de charger le téléphone pendant que le modèle tourne.
Un Samsung Galaxy milieu de gamme ou un autre Android peut-il faire tourner ces modèles ?
Oui, si la RAM suffit. Cherchez la variante de RAM de votre modèle exact, puis faites la correspondance : 8 Go fait tourner SmolLM 2 1.7B ou Llama 3.2 3B, 6 Go Qwen3 1.7B ou SmolLM 2 1.7B, 4 Go Gemma 3 1B uniquement. La RAM compte plus que la puce ; la puce change surtout la vitesse. Les tokens/sec sur Android sont environ 10–20 % inférieurs à ceux de l'iPhone sur le même fichier, d'après les chiffres indicatifs de cet article.
Quelle est la taille de ces modèles en mégaoctets ?
En Q4_K_M : Gemma 3 1B ~720 Mo, Qwen3 1.7B ~1 100 Mo, SmolLM 2 1.7B ~1 100 Mo, Llama 3.2 3B ~2 200 Mo, Phi-4 Mini ~2 700 Mo et Gemma 3 4B ~2 900 Mo. Le fichier correspond aussi à peu près à la RAM que le modèle occupe pendant son exécution, plus environ 500 Mo de surcoût d'inférence. Les fichiers Q5_K_M sont environ 25 % plus volumineux.
Existe-t-il un SmolLM 3 ou un SmolLM 4 ?
SmolLM 3 existe : Hugging Face l'a publié en juillet 2025 sous la forme d'un modèle de 3 milliards de paramètres avec modes réflexion et sans réflexion, un contexte d'entraînement de 64k (jusqu'à 128k avec YaRN) et la prise en charge de l'anglais, du français, de l'espagnol, de l'allemand, de l'italien et du portugais. À la date de dernière mise à jour de cette page, il n'existe pas de SmolLM 4 ; Hugging Face n'en avait pas publié. SmolLM 3 ne figure pas dans le comparatif de vitesse de cet article faute de chiffres vérifiés sur appareil, mais avec 3B il appartient à la classe de taille de Llama 3.2 3B.
Qu'est-ce que Gemma 3n, et est-il meilleur que Gemma 3 pour les téléphones ?
Gemma 3n est une famille de modèles Google conçue pour l'usage sur appareil, en tailles E2B et E4B. Le « E » signifie paramètres effectifs : E2B charge plus de 5 milliards de paramètres bruts mais peut fonctionner avec une charge mémoire d'un peu moins de 2 milliards (1.91B). Il accepte du texte, des images et de l'audio en entrée et couvre plus de 140 langues. C'est un compromis différent de Gemma 3 4B, pas une mise à niveau directe, et il ne figure pas dans le comparatif de vitesse de cet article faute de chiffres vérifiés.
Un LLM sur téléphone peut-il rédiger des légendes d'images et du texte alternatif ?
Uniquement avec un modèle capable de vision. Parmi les six modèles de cet article, seul Gemma 3 4B accepte les images ; les cinq autres sont limités au texte. Gemma 3n et SmolVLM2 (256M, 500M, 2.2B) gèrent aussi les images. Votre application doit exposer l'entrée image pour le modèle, car les applications basées sur llama.cpp ont besoin d'un fichier de projecteur de vision distinct. Relisez chaque légende avant publication — les petits modèles de vision peuvent mal lire le texte et mal étiqueter les objets.
Existe-t-il un modèle de 2.5 milliards de paramètres pour téléphone ?
Pas parmi les modèles mobiles courants traités ici. Les tailles les plus proches sont la classe 1.7B (SmolLM 2, Qwen3) et la classe 3B (Llama 3.2 3B, SmolLM 3). Gemma 3n E2B s'en rapproche le plus dans l'esprit : il charge plus de 5 milliards de paramètres bruts mais fonctionne avec une charge mémoire effective d'un peu moins de 2 milliards.
Quel modèle offre la meilleure précision par mégaoctet pour le résumé hors ligne ?
Cet article ne rapporte aucun benchmark de précision propre ; la réponse est donc qualitative. Les modèles de 1.1 Go (Qwen3 1.7B, SmolLM 2 1.7B) constituent le juste milieu efficace pour les résumés courts, Qwen3 pour les textes non anglophones. Phi-4 Mini (~2.7 Go) est le plafond de qualité parmi les six si vous pouvez consacrer la mémoire, et Gemma 3 1B (~720 Mo) est le plus petit modèle qui produit encore des résumés courts cohérents.
Un LLM sur téléphone peut-il répondre en moins de 100 millisecondes ?
Pas pour une réponse complète. La seule génération de tokens prend ~55–77 ms par token pour Phi-4 Mini (13–18 tok/sec) et ~22–29 ms par token pour Gemma 3 1B (35–45 tok/sec) sur iPhone 17 Pro ; même une réponse de 20 tokens prend donc environ une demi-seconde avec le modèle le plus rapide. Moins de 100 ms n'est réaliste que pour quelques tokens, comme une sortie de classification très courte, pas pour le chat ni la description d'images.
Les modèles mobiles seront-ils encore utiles en 2027 ?
Oui, mais les noms de modèles spécifiques changeront. La frontière des petits LLMs mobiles évolue environ tous les 6–9 mois — d'ici Q4 2026, il y aura probablement de nouveaux modèles ~3B surpassant Phi-4 Mini, et d'ici mi-2027, la classe 1B–2B fera probablement ce que font les 3B–4B aujourd'hui. La catégorie ne devient pas obsolète ; les recommandations spécifiques changent. Consultez cet article (rafraîchissement prévu le 2027-04-19) pour la prochaine génération.