Faits rapides
- Apps iPad : PocketPal AI (gratuit, MIT), Locally AI (gratuit + options payantes, MLX), Google AI Edge Gallery (gratuit, Apache 2.0). LLM Farm (gratuit, MIT, iOS uniquement) a été retiré de l'App Store en août 2025 et doit désormais être compilé depuis les sources.
- Approche Android : PocketPal AI ou Google AI Edge Gallery (apps, sans terminal), ou Termux + Ollama (CLI).
- Connexion à distance : tout navigateur tablette → Open WebUI ou interface chat à IP locale. C'est aussi ainsi que les utilisateurs iPad exécutent Ollama, celui-ci n'ayant pas de build iPadOS natif.
- Minimum on-device : iPad Air M4 (12 GB) pour 3B–4B ; iPad Pro M5 (12 GB / 16 GB) pour 7B–8B.
- Minimum Android : appareil 8 GB RAM (Galaxy Tab S10+, OnePlus Pad 2).
- Meilleur modèle on-device : Phi-4 Mini (3.8B, 2.7 GB) ; Qwen3 1.7B pour très limité.
- Vitesse connexion à distance : dépend qualité Wi-Fi et vitesse génération machine locale.
Deux modes : inférence locale vs. connexion à distance
La décision clé n'est pas quelle app utiliser — c'est d'exécuter inférence sur tablette ou machine plus puissante. Chaque mode a exigences matérielles et plafonds de performance distincts.
📍 En une phrase
IA sur tablette : deux modes — inférence locale (modèle sur processeur tablette, 3B–7B) ou connexion à distance (tablette navigateur affichant Mac/PC exécutant grands modèles via Ollama et Open WebUI).
💬 En termes simples
Mode on-device : modèle sur tablette, hors ligne. Limité petits modèles (3B, 7B haut de gamme). Mode distant : Mac/PC exécute Ollama + 70B, tablette affiche chat navigateur — qualité 70B complète à l'écran, machine doit être allumée même Wi-Fi. Choisissez distance sauf besoin hors ligne spécifique.
Facteur | Inférence locale | Connexion à distance |
|---|---|---|
| Limite modèle | 3B–8B (iPad Pro M5) ; 3B–4B (plupart) | Illimitée — machine exécute tout |
| Utilisation hors ligne | Oui — sans Wi-Fi | Non — demande Wi-Fi maison |
| Vitesse génération | Modérée (12–30 tok/sec iPad Pro M5) | Dépend machine (jusqu'à 40+ tok/sec) |
| Stockage tablette | 2–10 GB par modèle | Aucun — modèle sur machine |
| Complexité setup | Basse (app + fichier modèle) | Basse–modérée (Ollama + Open WebUI) |
| Idéal pour | Voyage, hors ligne, 3B | Qualité prioritaire, 70B, commodité |

💡Astuce: Si vous avez Mac ou PC pouvant exécuter Ollama, commencez par connexion à distance. Meilleure qualité immédiatement, sans stocker modèles tablette. Ajoutez on-device plus tard si besoin hors ligne.
iPad : inférence locale
iPad Pro M5 est l'iPad le mieux adapté aux modèles 7B–8B. Apple a porté la RAM de base du M5 iPad Pro à 12 GB (16 GB sur les paliers de stockage 1 TB/2 TB), contre 8 GB sur le M4 iPad Pro de base, et augmenté la bande passante mémoire de 120 GB/s à 153 GB/s — l'inférence LLM sur Apple Silicon étant limitée par la bande passante mémoire, cela se traduit directement par une génération plus rapide. iPad Air M4 (12 GB, contre 8 GB sur le M3 Air) exécute désormais les modèles 3B–4B confortablement, et non plus seulement correctement. L'iPad Air M3 (8 GB) et les autres iPad de 8 GB sont limités aux modèles 1B–3B en Q4. Un iPhone avec 8 GB de RAM exécute aussi de petits modèles via LLM Farm.
- PocketPal AI (gratuit, open-source MIT, iOS + Android) : exécute des modèles GGUF via llama.cpp, télécharge les modèles depuis Hugging Face dans l'app ou importe des fichiers, et inclut un benchmark intégré pour mesurer les tokens par seconde de votre propre tablette. Dernière mise à jour en amont : 19 octobre 2026 (2026-10-19). Voir l'avis sur PocketPal AI.
- Locally AI (gratuit avec options payantes, code fermé, iPhone/iPad/Mac) : exécute des modèles ouverts via le framework MLX d'Apple, conçu pour Apple Silicon. Dernière mise à jour App Store : 15 octobre 2026 (2026-10-15). Voir l'avis sur Locally AI.
- Google AI Edge Gallery (gratuit, Apache 2.0, iOS + Android) : l'app sur appareil de Google pour ses modèles Gemma, basée sur le runtime LiteRT-LM. Dernière mise à jour en amont : 23 octobre 2026 (2026-10-23). Voir l'avis sur Google AI Edge Gallery. Elle exécute aussi Gemma 4 (E2B et E4B), les petits modèles actuels de Google pour l'appareil.
- LLM Farm (gratuit, MIT, iOS uniquement) : Apple a retiré la fiche App Store en août 2025, et le README du projet indique que l'App Store et TestFlight sont tous deux « temporairement indisponibles » — la seule voie est de compiler depuis les sources dans Xcode. Dernière mise à jour en amont : 30 janvier 2026 (2026-01-30), il y a plus de 180 jours, le projet n'est donc peut-être plus maintenu ; vérifiez le dépôt avant de vous y fier. Voir l'avis sur LLM Farm.
- Importer des modèles : dans PocketPal AI, téléchargez un modèle GGUF depuis Hugging Face dans l'app, ou importez un fichier GGUF transféré via Fichiers d'Apple. Stockage local de l'app — pas iCloud.
- Gestion RAM iPad : iOS gère RAM aggressivement. Fermez autres apps avant 7B sur 12 GB — iOS supprimera si autre app demande mémoire. Sur 16 GB (paliers 1 TB/2 TB) rare.
- Estimations de vitesse de génération (approximatives, pas des benchmarks PromptQuorum — utilisez le benchmark intégré de PocketPal AI pour mesurer votre appareil) : iPad Pro M5 (12 GB / 16 GB) : Phi-4 Mini ~25 tok/sec, Llama 3.2 3B ~38 tok/sec, Gemma 3 4B ~23 tok/sec — environ 25–30 % plus rapide que la génération M4 précédente, conformément à l'augmentation de bande passante mémoire. iPad Air M4 (12 GB) : 3B–4B ~15–20 tok/sec ; 7B ~7–10 tok/sec (toujours lent pour chat temps réel).
- iPad d'entrée de gamme et iPad avec 8 GB de RAM ou moins : utilisez des modèles 1B–3B en Q4, ou considérez l'iPad comme un écran pour une connexion à distance. Si un modèle ne tient pas dans la RAM libre, iPadOS ferme l'app au lieu de ralentir progressivement.

⚠️Attention: Ne tentez pas 7B sur iPad Air 12 GB pour chat temps réel. À 7–10 tok/sec, chaque réponse prend encore 10–20 sec. Utilisez 3B–4B sur iPad Air ; passez au iPad Pro M5 16 GB ou connexion à distance pour 7B+.
Android : inférence locale
Inférence Android utilise Termux + Ollama — Termux émulateur Linux terminal exécutant Ollama nativement. Plus technique qu'app iPad mais accès complet écosystème Ollama.
- Alternatives plus simples à Termux : PocketPal AI (Google Play, gratuit, MIT ; dernière mise à jour en amont : 19 octobre 2026, soit 2026-10-19) et Google AI Edge Gallery (gratuit, Apache 2.0 ; dernière mise à jour en amont : 23 octobre 2026, soit 2026-10-23) exécutent des modèles sur appareil sans terminal. Commencez par l'une d'elles sauf si vous avez spécifiquement besoin d'Ollama. Voir l'avis sur PocketPal AI.
- Appareils compatibles 3B+ : 8 GB RAM min (Galaxy Tab S10+, OnePlus Pad 2, Xiaomi Pad 7 Pro). 6 GB : Qwen3 1.7B seulement.
- Pixel Tablet non recommandé : Tensor G2 beaucoup plus lent Snapdragon 8 Gen 3, ~4–7 tok/sec Phi-4 Mini (trop lent). Utilisateurs Pixel : connexion à distance.
- Snapdragon 8 Gen 3 et Dimensity 9300 puces Android les plus rapides 2026. ~15–25 tok/sec 1.7B ; ~8–12 tok/sec 3B.
- Stockage modèle : Android pas mémoire unifiée — RAM sans GPU plupart configs. GPU demande Termux:NVIDIA ou Vulkan spécifique.
- Apps alternatives : MNN LLM (Alibaba, gratuit, plus simple) sélection limitée. AI Runner, llamafile aussi disponibles. Il n'existe aucune version Android de LLM Farm — c'est une app iOS uniquement ; PocketPal AI est l'équivalent Android le plus proche.
- Autres marques (Huawei MatePad, Xiaomi Pad, Galaxy Tab série A) : la RAM et la puce décident, pas la marque. Vérifiez la RAM de la tablette dans Réglages : moins de 6 GB, restez sur des modèles 1B–1.7B ou utilisez la connexion à distance ; 8 GB ou plus, suivez la ligne 8 GB du tableau des modèles.
- Pour un guide de configuration Xperia spécifique au Japon avec tableau de compatibilité matérielle, consultez <a href="/fr/prompt-bites/run-local-llm-on-xperia-japan" class="text-primary hover:underline">comment exécuter un LLM local sur Xperia au Japon</a>.
- 1Installez Termux de F-Droid (pas Play Store — vieux, dépendances manquent).
- 2Dans Termux :
pkg update && pkg upgrade - 3Installez Ollama depuis le dépôt de paquets Termux :
pkg install ollama(les anciens guides compilent Ollama depuis les sources avec Go, ce qui n'est plus nécessaire). - 4Tirez modèle :
ollama pull phi4-miniouollama pull qwen3:1.7b. - 5Démarrez serveur :
ollama serve(gardez session active). - 6Chat Termux :
ollama run phi4-mini— ou navigateurhttp://localhost:11434. Installez app chat connectant endpoint local.

💡Astuce: Installez Termux:Widget, créez raccourci "ollama serve" — démarre serveur depuis écran d'accueil. Une fois actif, ouvrez app chat configurée localhost:11434.
Connexion à distance à un ordinateur local
Setup le plus simple : Ollama + Open WebUI sur Mac ou PC, accédez navigateur tablette même Wi-Fi. Tablette devient interface tactile machine plus puissante — voir guide laptop pour dimensionner machine.
📍 En une phrase
Connexion à distance machine Ollama + Open WebUI donne accès complet 70B via navigateur — aucun modèle tablette, aucune app, qualité complète.
💬 En termes simples
Sur Mac/PC : installez Ollama, tirez modèle, Open WebUI (Docker une ligne), exécutez lié IP locale. Sur tablette : Safari/Chrome, http://[IP]:3000, chat complet. Modèle sur Mac ; tablette affiche. Fonctionne tout appareil, OS, écran.
- 1Machine locale : Ollama (
brew install ollamamacOS, ollama.com Windows).ollama pull llama3.3:70b. Démarrez :OLLAMA_HOST=0.0.0.0:11434 ollama serve. - 2Open WebUI :
docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 --name open-webui ghcr.io/open-webui/open-webui:main. Disponible `http://[IP]:3000`. - 3Trouvez IP locale : macOS Réglages Système (System Settings) → Réseau → IP. Windows :
ipconfig→ IPv4. Notez (typiquement192.168.x.x). - 4Sur tablette : Safari/Chrome, `http://[IP]:3000`. Créez compte Open WebUI (local). Sélectionnez modèle. Chattez.
- 5Sécurité : local-only. N'exposez pas port 3000 sans auth (système compte admin). Plain HTTP — pas données sensibles Wi-Fi public.

💡Astuce: Ajoutez URL Open WebUI écran d'accueil tablette (Safari : Partage → Écran d'accueil ; Chrome : Menu → Écran d'accueil). Ressemble app native. iPad Safari fullscreen masque chrome navigateur.
Recommandations de modèles par appareil
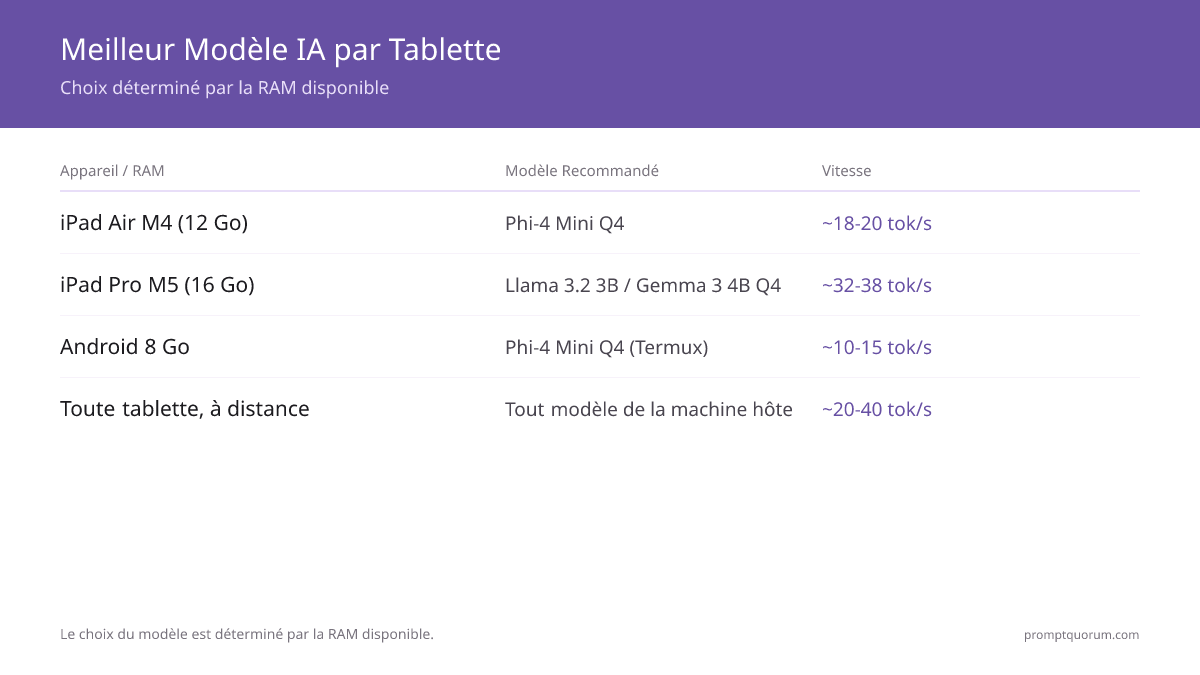
Choix modèle déterminé par RAM disponible. Tableau ci-dessous mappe RAM au plus gros modèle tournant temps réel (8+ tok/sec). Couche modèle : Best Mobile LLMs 2026. Paysage complet : Best LLMs 2026.
Appareil / RAM | Modèle recommandé | Vitesse | Idéal pour |
|---|---|---|---|
| iPad Air M4 (12 GB) | Phi-4 Mini Q4 / Llama 3.2 3B Q4 | ~18–20 tok/sec | Assistance écriture, résumé |
| iPad Air M3 / autres iPad 8 GB | Llama 3.2 3B Q4 / Qwen3 1.7B | ~10–18 tok/sec (est.) | Brouillons légers, résumés |
| iPad Pro M5 (12 GB / 16 GB) | Llama 3.2 3B / Gemma 3 4B Q4 | ~32–38 tok/sec / ~20–23 tok/sec | Station LLM réelle, RAG, fiction |
| Android 8 GB (Tab S10+) | Phi-4 Mini Q4 Termux+Ollama | ~10–15 tok/sec | Power users Termux |
| Android 6 GB | Qwen3 1.7B Q4 | ~15–20 tok/sec | Chat léger, traduction |
| Pixel Tablet (8 GB) | Connexion à distance seulement | N/A | Tensor G2 trop lent |
| iPad mini 7 (A17 Pro, 8 GB) | Llama 3.2 3B Q4 / Qwen3 1.7B | Non mesurée | Brouillons légers, résumés |
| iPad A16 (6 GB) / iPad 10e gén. (4 GB) | Qwen3 1.7B Q4 ou plus petit | Non mesurée | Questions courtes ; sinon à distance |
| Galaxy Tab S11 Ultra (12 GB / 16 GB) | Gemma 4 E4B / Phi-4 Mini Q4 | Non mesurée | Plus de multitâche (palier 16 GB) |
| Toute tablette à distance (iPad + Ollama) | Tout modèle machine locale | ~20–40 tok/sec | Qualité prioritaire, 70B, Ollama sur iPad |

💡Astuce: Tâches quotidiennes (brouillon, questions, résumé) : Phi-4 Mini (3.8B) tablette est adéquat. Échoue vs 70B : raisonnement multi-étapes, créativité nuancée, longs documents. Utilisez connexion à distance pour ces cas.
Interfaces avant pour IA locale
Interface chat que vous utilisez affecte significativement usabilité. Certains optimisés mobile ; d'autres desktop-first.
- Open WebUI (navigateur) : meilleure web UI réactive mobile. Fonctionne toute IP:port Safari/Chrome. S'adapte tablette. Recommandé connexion à distance.
- PocketPal AI (app iPad et Android) : gratuit, open-source, importe des modèles GGUF et inclut un benchmark intégré. L'option sur appareil la plus flexible sur les deux plateformes.
- Locally AI (app iPad) : interface propre de style Apple basée sur MLX ; la première prise en main la plus simple pour les utilisateurs non techniques sur iPad.
- Google AI Edge Gallery (app iPad et Android) : l'app de Google centrée sur Gemma ; le moyen le plus simple d'essayer les petits modèles de Google sur appareil.
- RisuAI (navigateur, réactif mobile) : meilleure expérience mobile jeu rôle. Se connecte Ollama distant. Fonctionne Safari near-app quality.
- SillyTavern (navigateur) : fonctionne Safari connecté Ollama distant. Pas mobile-optimisé mais fonctionnel. Extensions partiellement Safari mobile.
- Termux CLI (Android) : ligne commande seulement. Tâches scriptées ; pas pratique conversation sans app compagne.
💡Astuce: Jeu rôle iPad : RisuAI + Ollama distant Llama 3.3 70B combinaison solide en 2026. Interface RisuAI tactile ; 70B produit character voice bien meilleur que tout modèle tablette.
Considérations pour utilisateurs francophones
Pour utilisateurs en France, Belgique et Suisse romande : l'exécution IA locale sur tablette offre avantages conformité. La Commission Nationale de l'Informatique et des Libertés (CNIL) recommande l'inférence locale pour les données professionnelles sensibles — communications clients, documents confidentiels, données patients, dossiers légaux restent dans réseau local. Architectures iPad/tablette connectées Ollama maison satisfont RGPD sans solutions enterprise coûteuses.
- CNIL + RGPD : Si vous traitez données sensibles (communications clients, dossiers confidentiels, données patients) France, Belgique, Suisse — CNIL recommande inférence locale. Aucune transmission APIs cloud US sous RGPD.
- Mise en pratique : iPad Pro M5 ou tablette Android (8 GB) + Ollama distant Mac/PC foyer = architecture simplement conforme CNIL. Documentez setup (stockage données, modèles) auprès de votre DPO.
Erreurs courantes
- Chercher LLM Farm sur l'App Store. Apple l'a retiré en août 2025. Utilisez PocketPal AI ou Locally AI, ou compilez LLM Farm depuis les sources.
- Modèle 7B sur tablette 8 GB. À 5–8 tok/sec trop lent conversation. Utilisez 3B sur 8 GB ; connexion à distance pour 7B+.
- Termux Play Store Android. Version vieille, dépendances manquent. Installez toujours F-Droid.
- Open WebUI exposé internet sans auth. Aucun mot de passe défaut. Quiconque trouve URL accède modèle. Activez compte admin + firewall.
- Autres apps pas fermées avant on-device 8 GB iPad. iOS supprime RAM. Modèle 3B ~3.5 GB ; iOS le tue si autre app demande. Fermez tout avant inférence.
- Attendre UI desktop-quality navigateurs mobile. SillyTavern desktop-first. Mobile fonctionnel pas poli. Mobile-first : RisuAI ou Open WebUI.
- Saisir
ipad.localdans le navigateur. Safari doit recevoir l'adresse de l'ordinateur à la maison — son IP ou son nom d'hôte, par exemple192.168.1.20:3000oumon-mac.local:3000—, pas le nom de la tablette. Un nom commeipad.localdésigne une tablette, pas la machine qui exécute Ollama.
Sources
- LLM Farm (iOS) docs et GitHub — github.com/guinmoon
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai
- Locally AI — fiche App Store
- Google AI Edge Gallery — github.com/google-ai-edge/gallery
- Paquet Ollama pour Termux — Termux (installez Termux depuis F-Droid)
- Build ARM Ollama Termux — Docs Ollama
- Docs Open WebUI — docs.openwebui.com
- Spécifications puce M5 Apple iPad Pro, paliers RAM et bande passante mémoire — Apple Newsroom, octobre 2025
- Spécifications puce M4 Apple iPad Air et RAM — Apple Newsroom, mars 2026
- Présentation des modèles Gemma 4 et besoins en mémoire — Google AI for Developers
- Puce et paliers de RAM du Samsung Galaxy Tab S11 Ultra — GSMArena
Questions fréquemment posées
Pouvez-vous exécuter l'IA sur un iPad ?
Oui, sur iPad Pro M5 (12 GB de base / 16 GB sur les paliers 1 TB et 2 TB) et iPad Air M4 (12 GB). iPad Pro M5 exécute Phi-4 Mini et Llama 3.2 3B temps réel avec PocketPal AI ou Locally AI, environ 25–30 % plus rapide que l'iPad Pro M4 précédent grâce à une bande passante mémoire accrue (153 GB/s contre 120 GB/s). iPad Air M4 exécute 3B–4B confortablement. Pour 7B+ iPad, connexion à distance Mac ou PC Ollama recommandée — iPad affiche chat, machine exécute inférence.
Ollama fonctionne-t-il sur un iPad ?
Non — Ollama n'a pas de build iPadOS pris en charge, il ne peut donc pas être installé directement sur un iPad comme c'est possible sous Android via Termux. « Exécuter Ollama sur iPad » signifie faire tourner Ollama sur un Mac ou PC et s'y connecter depuis le navigateur de l'iPad (via Open WebUI à l'IP locale de la machine) — l'iPad est un affichage, pas le moteur d'inférence. Pour une véritable inférence sur l'appareil sur iPad, utilisez plutôt une app sur appareil comme PocketPal AI (modèles GGUF via llama.cpp) ou Locally AI (modèles MLX).
Pouvez-vous exécuter l'IA sur une tablette Android ?
Oui, sur les appareils 8 GB+ de RAM avec PocketPal AI ou Termux + Ollama. Galaxy Tab S10+ (12 GB) exécute Phi-4 Mini ~10–15 tok/sec. 6 GB exécute Qwen3 1.7B. Setup demande Termux F-Droid + commandes terminal. Connexion à distance machine locale est chemin plus facile plupart utilisateurs Android.
L'IA on-device tablette fonctionne hors ligne ?
Oui. Modèle téléchargé et app installée, inférence on-device iPad (PocketPal AI, Locally AI) et Android (Termux + Ollama) fonctionne sans internet. Avantage principal on-device — connexion à distance demande Wi-Fi maison.
Meilleure app IA iPad ?
On-device : PocketPal AI (open-source, importe tout modèle GGUF) ou Locally AI (UI la plus simple, MLX). LLM Farm n'est plus disponible sur l'App Store. Connexion distance Ollama : Open WebUI Safari (meilleur chat général), RisuAI Safari (meilleur jeu rôle). Choix dépend si vous voulez on-device, hors ligne, ou meilleure UI.
Termux + Ollama Android sûr ?
Oui. Termux émulateur terminal établi, millions développeurs. Ollama API locale seulement (localhost:11434 défaut) — pas accessible autres appareils réseau sauf bind explicite. Fichiers modèle stockage privé Termux, pas Android partagé.
Qualité ChatGPT locale tablette ?
Presque avec bon setup. La qualité des modèles cloud de pointe demande généralement 70B+. iPad Pro M5 (12 GB / 16 GB) pas 70B — 3B–8B seulement. À distance : GPU 24 GB (RTX 4090) ou unifié 64 GB (Mac M5 Max) exécute Llama 3.3 70B, tablette accède qualité Open WebUI. Plus proche qualité cloud tablette.
Garder serveur Ollama maison démarré lid fermé ?
macOS : Réglages Système (System Settings) → Batterie → désactiver "Power Nap" + Amphetamine prévenir sleep branché. Windows : Options énergie → "Jamais" sleep branché. Alternative : exécutez Ollama machine toujours-on (mini-PC, NAS) pas laptop primaire.
Batterie tablette IA épuisée rapide ?
Oui — l'inférence sur appareil sollicite fortement CPU/GPU et vide la batterie bien plus vite que la navigation web ; le rythme varie selon l'appareil et le modèle. Usage prolongé : gardez la tablette branchée. Connexion à distance vers une machine : beaucoup moins de batterie — la tablette affiche seulement une page web.
Throttling tablettes inférence IA ?
Oui, spécialement iPad Air M4 et Android sans refroidissement actif. iPad Pro M5 a plus de marge thermique que l'iPad Air, et de nombreuses tablettes Android ralentissent plus tôt en inférence soutenue. Mitigations : chunks 200–400 tokens, tablette surface dure, pas autres apps CPU.
Clavier meilleur usage IA tablette ?
Apple Magic Keyboard iPad Pro M5 (trackpad) setup poli — shortcuts Safari + Open WebUI, trackpad sélection texte. Logitech Combo Touch budget. Android : tout Bluetooth fonctionne Termux mais expérience plus rude. Prose : iPad Pro + Magic Keyboard station IA écriture.
Puis-je exécuter SillyTavern sur iPad ?
Oui, via une connexion à distance. SillyTavern tourne sur un Mac ou PC à la maison, et Safari sur iPad s'y connecte à l'IP locale. L'interface mobile est fonctionnelle mais peu soignée — certaines fonctions d'extension (outils regex, panneaux de chat de groupe) marchent mais paraissent à l'étroit. Pour le jeu de rôle en particulier, RisuAI a une meilleure interface mobile que SillyTavern ; les deux peuvent se connecter au même backend Ollama sur votre machine.
Une tablette peut-elle gérer du RAG sur de longs documents ?
Sur l'appareil, non — vectoriser plus de 1 000 documents sur une tablette n'est pas réaliste. Via une connexion à distance, oui — votre machine gère le pipeline RAG, la tablette affiche l'interface de chat. AnythingLLM exécuté sur une machine à la maison et consulté via le navigateur de la tablette gère des collections de documents de toute taille sans limite côté tablette. Pour les étudiants ou travailleurs du savoir qui veulent du RAG sur tablette, la connexion à distance est généralement l'option la plus pratique.
Puis-je utiliser des écrans externes avec l'IA sur tablette ?
Oui sur iPad Pro M5 (Stage Manager + écran externe donne une configuration multifenêtre ; Open WebUI sur le moniteur externe, notes et documents sources sur l'écran de l'iPad). La Galaxy Tab S10 Ultra prend en charge le mode DeX avec écran externe pour un flux de travail IA multi-écrans similaire. Les tablettes Android sans mode DeX se contentent de dupliquer l'écran — moins utile. iPad Pro + moniteur externe + Magic Keyboard est ce qui se rapproche le plus d'une vraie station de travail IA sur tablette en 2026.
Une tablette est-elle meilleure qu'un téléphone pour l'IA locale ?
Pour un usage orienté saisie (rédaction, RAG, longues conversations), oui — le clavier et la taille d'écran comptent. Pour un chat rapide, des requêtes vocales ou en déplacement, le téléphone que vous avez déjà est préférable. L'iPad Pro M5 est la tablette la plus susceptible de surpasser un téléphone haut de gamme pour l'IA locale ; les tablettes et téléphones milieu de gamme sont à peu près équivalents. La plupart des lecteurs ne devraient pas acheter une tablette spécifiquement pour l'IA locale — achetez-en une si vous la voulez pour d'autres raisons ; la capacité IA est un bonus.
Pourquoi l'IA locale est-elle si lente sur ma tablette ?
Généralement l'une de quatre causes : le modèle est trop grand pour la RAM libre (le système swappe ou ferme l'app), la génération est limitée par la bande passante mémoire plutôt que par la vitesse de la puce, la tablette ralentit pour raisons thermiques, ou des apps en arrière-plan consomment de la mémoire. Solutions : passer à un modèle plus petit ou à une quantification Q4, fermer les autres apps, garder la tablette au frais et branchée, et mesurer la vitesse réelle avec le benchmark intégré de PocketPal AI. Si un modèle 3B reste trop lent, utilisez la connexion à distance vers une machine à la maison.
Quelles tablettes peuvent exécuter un LLM local (iPad Air M3, iPad d'entrée de gamme, Galaxy Tab A, Huawei MatePad, Xiaomi Pad) ?
La RAM et la puce décident, pas la marque. L'iPad Air M3 (8 GB) gère les modèles 1B–3B ; les iPad d'entrée de gamme et les tablettes Android économiques avec moins de 6 GB de RAM ne tiennent que des modèles 1B–1.7B, donc la connexion à distance est le meilleur choix pour elles. Les Huawei MatePad et Xiaomi Pad avec 8 GB ou plus exécutent les mêmes apps que les autres tablettes Android, selon leur disponibilité dans les boutiques d'apps. Vérifiez la RAM de votre tablette dans ses réglages, puis suivez le tableau des modèles ci-dessus.
Existe-t-il une app Ollama pour iPad ?
Il n'existe pas d'app Ollama officielle pour iPadOS. Il existe des clients iPad tiers qui se connectent à un serveur Ollama sur votre Mac ou PC — par exemple GetOAI et LLLM — mais ils ne font qu'afficher le chat ; le modèle tourne toujours sur la machine à la maison. Vérifiez chaque fiche App Store avant l'installation. La voie navigateur (Open WebUI dans Safari) ne demande aucune app.
Puis-je exécuter un LLM local sur une tablette Android sans terminal ?
Oui. PocketPal AI (gratuit, open-source, sur Google Play) et Google AI Edge Gallery (gratuit, Apache 2.0) téléchargent et exécutent des modèles sur appareil sans Termux. Termux + Ollama n'est nécessaire que si vous voulez spécifiquement l'écosystème d'Ollama ou un point d'accès API local.
Un iPad ancien ou d'entrée de gamme (iPad 9e, 10e ou 11e génération, iPad mini, iPad Air 5) peut-il exécuter un LLM local ?
La RAM décide. Les iPad de 9e génération (3 GB) et de 10e génération (4 GB) ainsi que l'iPad mini 6 (4 GB) sont trop justes pour un chat utile sur l'appareil : passez par la connexion à distance. L'iPad de 11e génération (A16, 6 GB) accepte des modèles de 1B–1.7B en Q4. L'iPad mini 7 (A17 Pro, 8 GB), l'iPad Air 5 et l'iPad Air M3 (8 GB) acceptent des modèles de 3B en Q4, dans les limites des 8 GB décrites plus haut. Apple ne publie pas la RAM de tous ces modèles ; les chiffres sont ceux couramment rapportés, pas une confirmation d'Apple.
Le Galaxy Tab S11 Ultra ou le Galaxy Tab S9 FE peuvent-ils exécuter un LLM local ?
Le Galaxy Tab S11 Ultra (Dimensity 9400+, 12 GB ou 16 GB de RAM selon la configuration) dépasse le seuil de 8 GB et exécute les mêmes applications que le Tab S10+ — PocketPal AI, Google AI Edge Gallery ou Termux + Ollama — avec plus de marge pour les modèles de 3B–4B. Le Galaxy Tab S9 FE existe en 6 GB ou 8 GB : la version 6 GB ne convient qu'à Qwen3 1.7B, la version 8 GB suit la ligne 8 GB du tableau des modèles. L'Exynos 1380 est une puce de milieu de gamme ; attendez-vous à une vitesse inférieure à celle des tablettes haut de gamme.
Gemma 4 fonctionne-t-il sur une tablette ?
Oui, les petites variantes de Gemma 4. Google présente Gemma 4 E2B et E4B comme les tailles destinées à l'exécution sur l'appareil ; en quantification 4 bits, Google indique environ 2.9 GB (E2B) et 4.5 GB (E4B) de mémoire pour les poids. E2B est donc le choix le plus sûr sur une tablette de 8 GB, et E4B convient mieux à partir de 12 GB. L'application pour les exécuter sur iPad et Android est Google AI Edge Gallery ; voir l'avis sur Google AI Edge Gallery. PromptQuorum n'a pas mesuré la vitesse de Gemma 4 sur tablette.
Quelles applications gratuites exécutent un LLM local sur iPad ?
PocketPal AI (gratuit, MIT), Google AI Edge Gallery (gratuit, Apache 2.0) et Locally AI (gratuit, avec options payantes) exécutent des modèles sur l'appareil sans frais. Open WebUI dans Safari, relié à Ollama sur un Mac ou un PC, est aussi gratuit. LLM Farm est gratuit lui aussi, mais doit être compilé depuis les sources.
Peut-on encore installer LLM Farm sur iPad ?
Pas depuis l'App Store. Apple a retiré LLM Farm en août 2025, et le README du projet indique que l'App Store comme TestFlight sont temporairement indisponibles. La seule voie est de le compiler depuis les sources dans Xcode. Sa dernière mise à jour en amont date du 30 janvier 2026 ; il est peut-être abandonné. PocketPal AI et Locally AI sont les alternatives installables sur iPad.