حقائق سريعة
- تطبيقات iPad: PocketPal AI (مجاني، MIT)، وLocally AI (مجاني مع خيارات مدفوعة، MLX)، وGoogle AI Edge Gallery (مجاني، Apache 2.0). أما LLM Farm (مجاني، MIT، لنظام iOS فقط) فقد أُزيل من App Store في أغسطس 2025 ويجب الآن بناؤه من المصدر.
- طريقة Android: PocketPal AI أو Google AI Edge Gallery (تطبيقات دون طرفية)، أو Termux + Ollama (سطر الأوامر).
- الاتصال عن بُعد: متصفح أي لوحي ← Open WebUI أو واجهة دردشة بسيطة على عنوان IP المحلي لجهازك المنزلي. هذه أيضًا هي الطريقة التي يشغّل بها مستخدمو iPad برنامج Ollama، لأنه لا يملك إصدارًا أصليًا لـ iPadOS.
- الحد الأدنى للتشغيل على الجهاز: iPad Air M4 (12 جيجابايت) لنماذج 3B–4B؛ وiPad Pro M5 (12 جيجابايت / 16 جيجابايت) لنماذج 7B–8B.
- الحد الأدنى لـ Android للتشغيل على الجهاز: جهاز بذاكرة RAM 8 جيجابايت (Samsung Galaxy Tab S10+ أو OnePlus Pad 2).
- أفضل نموذج على الجهاز: Phi-4 Mini (3.8B، 2.7 جيجابايت) لمعظم الألواح؛ وQwen3 1.7B للأجهزة شديدة المحدودية.
- سرعة الاتصال عن بُعد: تعتمد على جودة Wi-Fi وسرعة توليد الجهاز المنزلي، لا على عتاد اللوحي.
وضعان: الاستدلال على الجهاز مقابل الاتصال عن بُعد
القرار الأهم ليس أي تطبيق تستخدم، بل هل تشغّل الاستدلال على اللوحي أم على جهاز أقوى في المنزل. لكل وضع متطلبات عتاد وسقف قدرات مختلفان.
📍 في جملة واحدة
لتشغيل الذكاء الاصطناعي على لوحي وضعان عمليان: الاستدلال على الجهاز (النموذج يعمل على شريحة اللوحي ومحدود بنماذج 3B–7B) أو الاتصال عن بُعد (اللوحي شاشة متصفح لجهاز Mac أو PC منزلي يشغّل نماذج أكبر عبر Ollama وOpen WebUI).
💬 بعبارات بسيطة
وضع الجهاز: النموذج موجود على لوحيك ويعمل دون إنترنت. هو محدود بالنماذج الصغيرة (3B، وربما 7B على iPad Pro عالي المواصفات) وأبطأ من الذكاء الاصطناعي السحابي. الوضع عن بُعد: يشغّل جهاز Mac أو PC المنزلي Ollama ونموذج 70B، ويعرض لوحيك الدردشة في المتصفح فقط — تحصل على جودة 70B الكاملة على شاشة اللوحي دون تخزين أي نموذج عليه، لكن يجب أن يكون الجهاز المنزلي قيد التشغيل وعلى شبكة Wi-Fi نفسها. اختر الاتصال عن بُعد ما لم تكن بحاجة تحديدًا إلى الاستخدام دون اتصال.
العامل | على الجهاز | الاتصال عن بُعد |
|---|---|---|
| حد حجم النموذج | 3B–8B (iPad Pro M5)؛ 3B–4B (معظم الألواح) | بلا حد — الجهاز المنزلي يشغّل أي نموذج |
| الاستخدام دون اتصال | نعم — يعمل دون Wi-Fi | لا — يتطلب Wi-Fi المنزل |
| سرعة التوليد | متوسطة (12–30 رمز/ثانية على iPad Pro M5) | حسب الجهاز المنزلي (حتى 40+ رمز/ثانية) |
| التخزين على اللوحي | 2–10 جيجابايت لكل نموذج | لا شيء — النموذج على الجهاز المنزلي |
| تعقيد الإعداد | منخفض (تنزيل تطبيق + ملف نموذج) | منخفض–متوسط (Ollama + Open WebUI منزليًا) |
| الأنسب لـ | السفر، والاستخدام دون اتصال، ومهام 3B | الجودة أولًا، ونماذج 70B، والراحة |
💡نصيحة: إذا كان لديك في المنزل جهاز Mac أو PC يستطيع تشغيل Ollama، فابدأ بالاتصال عن بُعد. ستحصل فورًا على جودة نموذج أفضل على لوحيك دون تخزين ملفات النماذج عليه ودون التعامل مع قيود تطبيقات الجوّال. يمكنك إضافة القدرة على التشغيل على الجهاز لاحقًا إذا احتجت إلى الاستخدام دون اتصال.
iPad: الاستدلال على الجهاز
iPad Pro M5 هو جهاز iPad الأنسب لنماذج 7B–8B. رفعت Apple ذاكرة RAM الأساسية في iPad Pro M5 إلى 12 جيجابايت (16 جيجابايت في فئتَي التخزين 1 تيرابايت/2 تيرابايت)، مقارنة بـ 8 جيجابايت في iPad Pro M4 الأساسي، ورفعت سرعة نقل البيانات في الذاكرة إلى 153 جيجابايت/ثانية من 120 — والاستدلال على Apple Silicon محكوم بسرعة نقل الذاكرة، لذا ينعكس ذلك مباشرةً على سرعة التوليد. أما iPad Air M4 (12 جيجابايت، مقارنة بـ 8 جيجابايت في Air M3) فيشغّل الآن نماذج 3B–4B بسلاسة بدلًا من أداء مقبول فحسب. ويقتصر iPad Air M3 (8 جيجابايت) وأجهزة iPad الأخرى بذاكرة 8 جيجابايت على نماذج 1B–3B بتكميم Q4. يشغّل iPhone بذاكرة 8 جيجابايت أيضًا نماذج صغيرة عبر LLM Farm.
- PocketPal AI (مجاني، مفتوح المصدر MIT، iOS + Android): يشغّل نماذج GGUF عبر llama.cpp، وينزّل النماذج من Hugging Face داخل التطبيق أو يستورد الملفات، ويتضمن اختبار أداء مدمجًا لتقيس بنفسك عدد الرموز في الثانية على لوحيك. آخر تحديث رسمي: 19 أكتوبر 2026 (2026-10-19). اطّلع على مراجعة PocketPal AI.
- Locally AI (مجاني مع خيارات مدفوعة، مغلق المصدر، iPhone/iPad/Mac): يشغّل نماذج مفتوحة عبر إطار MLX من Apple المصمم لـ Apple Silicon. آخر تحديث على App Store: 15 أكتوبر 2026 (2026-10-15). اطّلع على مراجعة Locally AI.
- Google AI Edge Gallery (مجاني، Apache 2.0، iOS + Android): تطبيق Google للتشغيل على الجهاز لنماذج Gemma، ويعمل على بيئة LiteRT-LM. آخر تحديث رسمي: 23 أكتوبر 2026 (2026-10-23). اطّلع على مراجعة Google AI Edge Gallery. ويشغّل التطبيق أيضًا Gemma 4 (E2B وE4B)، وهما أحدث نماذج Google الصغيرة للتشغيل على الجهاز.
- LLM Farm (مجاني، MIT، لنظام iOS فقط): أزالت Apple صفحة التطبيق من App Store في أغسطس 2025، ويذكر ملف README الخاص بالمشروع أن App Store وTestFlight كليهما "غير متاحين مؤقتًا" — الطريق الوحيد هو البناء من المصدر في Xcode. آخر تحديث رسمي: 30 يناير 2026 (2026-01-30)، أي قبل أكثر من 180 يومًا، لذا قد يكون المشروع غير مُصان؛ تحقق من المستودع قبل الاعتماد عليه. اطّلع على مراجعة LLM Farm.
- استيراد النماذج: في PocketPal AI، نزّل نموذج GGUF من Hugging Face داخل التطبيق، أو استورد ملف GGUF نقلته عبر تطبيق الملفات (Files) من Apple. تُخزَّن النماذج في التخزين المحلي للتطبيق — وليس في iCloud.
- إدارة RAM على iPad: يدير iOS ذاكرة RAM للتطبيقات في الخلفية بصرامة. أغلق جميع التطبيقات الأخرى قبل تشغيل نموذج 7B على iPad بذاكرة 12 جيجابايت — سيُخلي iOS النموذج من الذاكرة إذا احتاجها تطبيق آخر. على iPad Pro M5 بذاكرة 16 جيجابايت (فئتا 1 تيرابايت/2 تيرابايت) نادرًا ما تحدث هذه المشكلة.
- تقديرات سرعة التوليد (تقريبية، وليست اختبارات أداء من PromptQuorum — استخدم اختبار الأداء المدمج في PocketPal AI لقياس جهازك): iPad Pro M5 (12 جيجابايت / 16 جيجابايت): Phi-4 Mini ~25 رمز/ثانية، وLlama 3.2 3B ~38 رمز/ثانية، وGemma 3 4B ~23 رمز/ثانية — أسرع بنحو 25–30% من جيل M4 السابق، بما يتماشى مع زيادة سرعة نقل الذاكرة. iPad Air M4 (12 جيجابايت): نماذج 3B–4B ~15–20 رمز/ثانية؛ ونماذج 7B ~7–10 رموز/ثانية (لا تزال بطيئة للدردشة الفورية).
- أجهزة iPad الأساسية وأجهزة iPad بذاكرة 8 جيجابايت أو أقل: استخدم نماذج 1B–3B بتكميم Q4، أو اعتبر الـ iPad شاشة عرض للاتصال عن بُعد. إذا لم يتسع النموذج في الذاكرة الحرة، يُغلق iPadOS التطبيق بدلًا من التباطؤ التدريجي.
⚠️تحذير: لا تحاول تشغيل نموذج 7B على iPad Air بذاكرة 12 جيجابايت للدردشة الفورية. عند 7–10 رموز في الثانية، يستغرق كل رد 10–20 ثانية. هذا مقبول لمهام التلخيص التي ترسل فيها الطلب وتنتظر، لكنه محبط للمحادثة. استخدم نماذج 3B–4B على iPad Air؛ وانتقل إلى iPad Pro M5 بذاكرة 16 جيجابايت أو إلى الاتصال عن بُعد لنماذج 7B فصاعدًا.
Android: الاستدلال على الجهاز
يعتمد الاستدلال على الجهاز في Android على Termux + Ollama — Termux محاكي طرفية Linux يشغّل Ollama بشكل أصلي على Android. هذا أكثر تقنيةً من تجربة تطبيقات iPad، لكنه يتيح الوصول إلى منظومة Ollama الكاملة.
- بدائل أسهل من Termux: يشغّل PocketPal AI (على Google Play، مجاني، MIT؛ آخر تحديث رسمي 2026-10-19) وGoogle AI Edge Gallery (مجاني، Apache 2.0؛ آخر تحديث رسمي 2026-10-23) النماذج على الجهاز دون طرفية. ابدأ بأحدهما ما لم تكن بحاجة تحديدًا إلى Ollama. اطّلع على مراجعة PocketPal AI.
- الأجهزة المدعومة لنماذج 3B فأكثر: 8 جيجابايت RAM كحد أدنى (Samsung Galaxy Tab S10+ أو OnePlus Pad 2 أو Xiaomi Pad 7 Pro). الأجهزة بذاكرة 6 جيجابايت تشغّل Qwen3 1.7B فقط.
- Pixel Tablet غير موصى به للتشغيل على الجهاز: استُبعد Pixel Tablet (طراز 2023، ذاكرة 8 جيجابايت، شريحة Tensor G2) من قائمة الأجهزة الموصى بها للتشغيل على الجهاز — فشريحة Tensor G2 أبطأ بكثير من Snapdragon 8 Gen 3 / Dimensity 9300 في استدلال LLM، إذ تنتج 4–7 رموز/ثانية على Phi-4 Mini (بطيء جدًا للمحادثة). على مستخدمي Pixel Tablet استخدام الاتصال عن بُعد بجهاز منزلي.
- Snapdragon 8 Gen 3 وDimensity 9300 هما أسرع شريحتين في Android للاستدلال على الجهاز في 2026. سرعة التوليد: ~15–25 رمز/ثانية لنماذج 1.7B؛ و~8–12 رمز/ثانية لنماذج 3B.
- تخزين النموذج: لا يملك Android ذاكرة موحدة — يعمل النموذج في ذاكرة النظام دون تسريع GPU في معظم إعدادات Termux. يتطلب تسريع GPU إعدادات Termux:NVIDIA أو بنيات Vulkan محددة؛ والإعداد أكثر تعقيدًا.
- تطبيقات بديلة: MNN LLM (من Alibaba، مجاني، تطبيق Android بالاستدلال على الجهاز لنماذج مختارة) أسهل في الإعداد لكن اختيار النماذج فيه أضيق من Ollama. كما أن لـ AI Runner وllamafile بنيات لـ Android بدعم متفاوت. لا يوجد إصدار Android من LLM Farm — فهو تطبيق iOS فقط؛ وأقرب مكافئ له على Android هو PocketPal AI.
- ماركات أخرى (Huawei MatePad وXiaomi Pad وسلسلة Galaxy Tab A): الذاكرة والشريحة هما الحَكَم، لا الماركة. تحقق من ذاكرة RAM في اللوحي من الإعدادات: أقل من 6 جيجابايت، التزم بنماذج 1B–1.7B أو استخدم الاتصال عن بُعد؛ 8 جيجابايت أو أكثر، اتبع صف 8 جيجابايت في جدول النماذج.
- للاطلاع على دليل إعداد خاص باليابان لهواتف Xperia مع جدول توافق العتاد، راجع <a href="/ar/prompt-bites/run-local-llm-on-xperia-japan" class="text-primary hover:underline">كيفية تشغيل LLM محلي على هواتف Xperia في اليابان</a>.
- 1ثبّت Termux من F-Droid (وليس نسخة متجر Play — فنسخة المتجر قديمة وتفتقر إلى الحزم المطلوبة).
- 2في Termux:
pkg update && pkg upgrade - 3ثبّت Ollama من مستودع حزم Termux:
pkg install ollama(الأدلة الأقدم تبني Ollama من المصدر باستخدام Go، ولم يعد ذلك ضروريًا). - 4نزّل نموذجًا:
ollama pull phi4-miniأوollama pull qwen3:1.7b. - 5شغّل الخادم:
ollama serve(أبقِه يعمل في جلسة Termux). - 6الدردشة عبر Termux:
ollama run phi4-mini— أو افتح متصفح الويب واذهب إلىhttp://localhost:11434للوصول إلى الـ API. ثبّت تطبيق دردشة لـ Android يتصل بنقطة Ollama المحلية للحصول على واجهة رسومية.
💡نصيحة: ثبّت إضافة Termux:Widget وأنشئ اختصارًا يشغّل "ollama serve" — هذا يتيح لك بدء خادم Ollama من الشاشة الرئيسية في Android دون فتح Termux يدويًا. بمجرد أن يعمل Ollama، افتح أي تطبيق دردشة مضبوط للاتصال بـ localhost:11434.
الاتصال عن بُعد بجهاز منزلي
أبسط إعداد لمعظم مستخدمي الألواح: شغّل Ollama وOpen WebUI على جهاز Mac أو PC المنزلي، ثم افتح واجهة الدردشة من متصفح لوحيك على شبكة Wi-Fi نفسها. يصبح لوحيك واجهة لمسية للجهاز الأقوى الذي يشغّل Ollama في المنزل — راجع دليل اللابتوب لتحديد حجم العتاد إذا كنت تختار الجهاز المنزلي.
📍 في جملة واحدة
يمنح الاتصال عن بُعد بجهاز منزلي يشغّل Ollama وOpen WebUI أي لوحي وصولًا كاملًا إلى نماذج 70B عبر المتصفح — بلا نموذج مخزَّن على اللوحي، وبلا تثبيت تطبيق، ودون أي تنازل عن جودة النموذج.
💬 بعبارات بسيطة
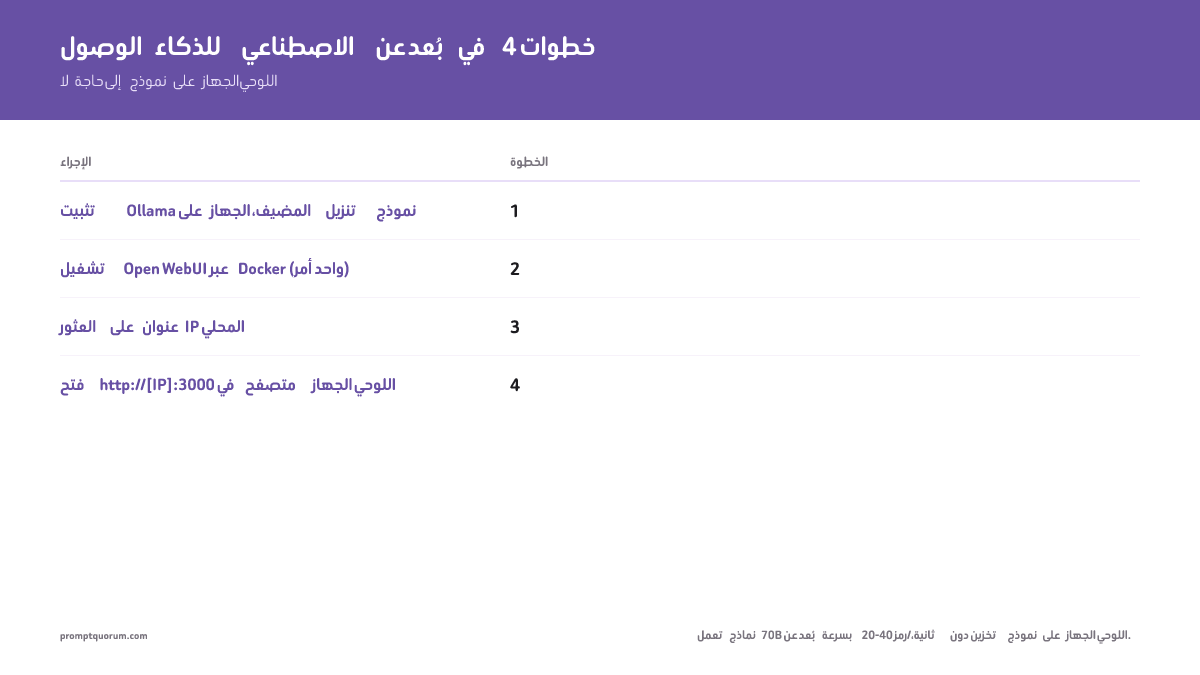
على جهاز Mac أو PC: ثبّت Ollama، ونزّل نموذجًا، وثبّت Open WebUI (أمر Docker واحد)، وشغّله مرتبطًا بعنوان IP شبكتك المحلية. على اللوحي: افتح Safari أو Chrome، واذهب إلى http://[عنوان-IP-الجهاز]:3000، وستحصل على واجهة دردشة كاملة. يعمل النموذج على الـ Mac؛ ولا يعرض اللوحي سوى الدردشة. يعمل على أي لوحي وأي نظام وأي حجم شاشة.
- 1على الجهاز المنزلي: ثبّت Ollama (
brew install ollamaعلى macOS، ونزّله من ollama.com على Windows). نزّل نموذجًا:ollama pull llama3.3:70b(أو أي نموذج). شغّل Ollama مع ربط الشبكة:OLLAMA_HOST=0.0.0.0:11434 ollama serve. - 2ثبّت Open WebUI (أنسب واجهة دردشة للألواح):
docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 --name open-webui ghcr.io/open-webui/open-webui:main. أصبح Open WebUI متاحًا على `http://[عنوان-IP-جهازك]:3000`. - 3اعثر على عنوان IP المحلي لجهازك المنزلي: على macOS: إعدادات النظام (System Settings) ← الشبكة (Network) ← الشبكة الحالية ← عنوان IP. على Windows، شغّل
ipconfigفي موجه الأوامر وابحث عن IPv4 Address. دوّن العنوان (عادةً192.168.x.x). - 4على اللوحي: افتح Safari (iPad) أو Chrome (Android). انتقل إلى `http://[عنوان-IP-جهازك]:3000`. أنشئ حسابًا في Open WebUI (محلي فقط، دون سحابة). اختر نموذجك من القائمة المنسدلة. ابدأ المحادثة.
- 5الأمان: هذا الإعداد للشبكة المحلية فقط. لا تعرّض المنفذ 3000 للإنترنت دون إضافة مصادقة Open WebUI (لديه نظام حسابات إدارية مدمج). الاتصال عبر HTTP عادي — لا ترسل معلومات حساسة عبر شبكات Wi-Fi العامة.
💡نصيحة: أضف عنوان Open WebUI للجهاز المنزلي إلى الشاشة الرئيسية للوحيك (في Safari: مشاركة ← إضافة إلى الشاشة الرئيسية؛ وفي Chrome: قائمة النقاط الثلاث ← إضافة إلى الشاشة الرئيسية). هذا يجعله يبدو كتطبيق أصلي. على iPad، تُخفي تطبيقات الويب بملء الشاشة في Safari عناصر المتصفح لتجربة أقرب إلى التطبيقات.
توصيات النماذج حسب الجهاز
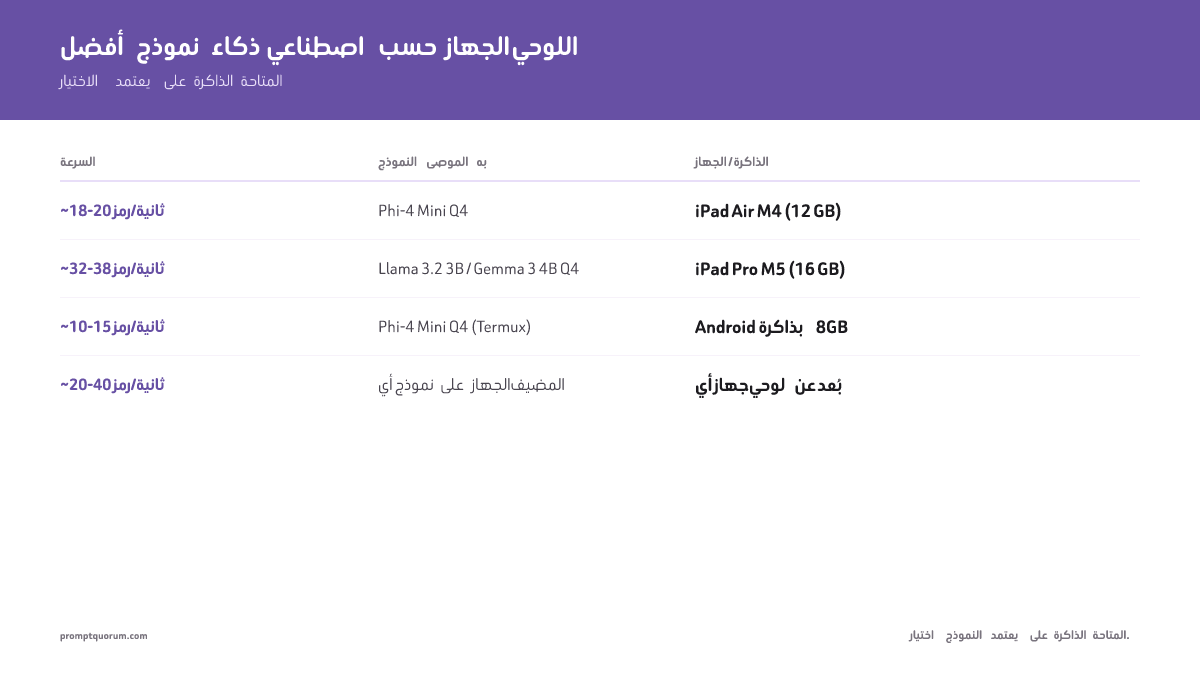
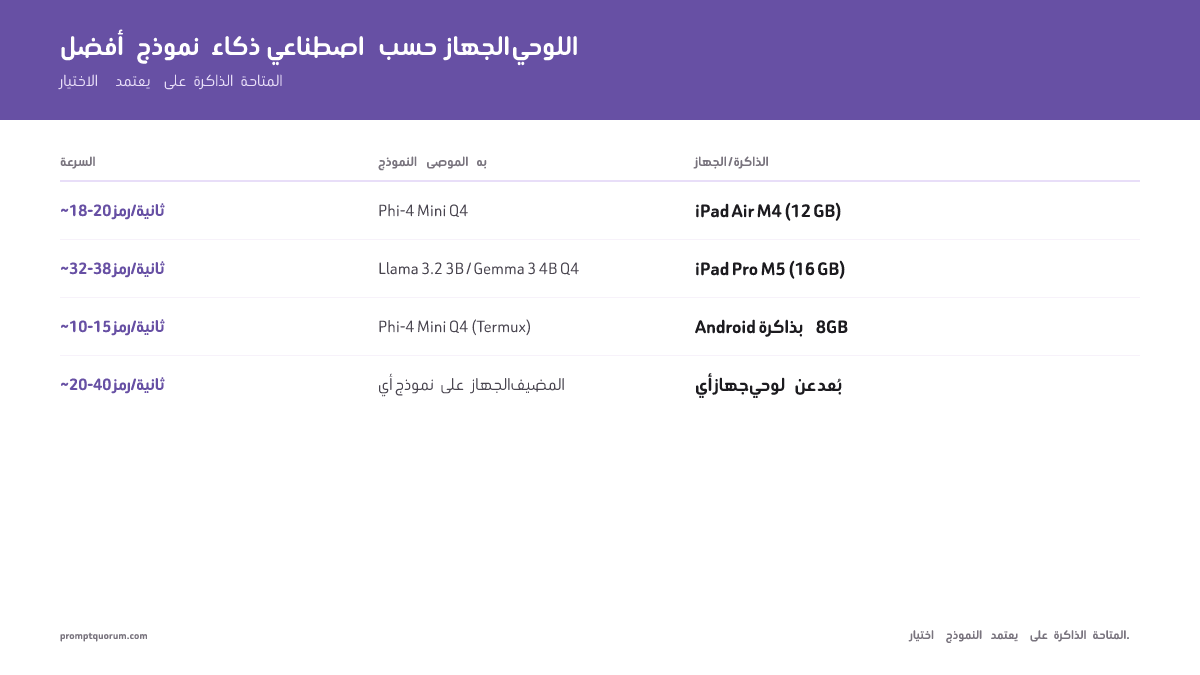
يتحدد اختيار النموذج بذاكرة RAM المتاحة — لا بالتفضيل. يربط الجدول أدناه ذاكرة الجهاز بأكبر نموذج يعمل بسرعة الوقت الفعلي (أكثر من 8 رموز/ثانية). لطبقة النماذج تحديدًا، راجع أفضل نماذج LLM للهاتف في 2026. وللاطلاع على مشهد النماذج الأوسع عبر جميع فئات العتاد، راجع أفضل نماذج LLM المحلية في 2026.
الجهاز / RAM | النموذج الموصى به | السرعة | الأنسب لـ |
|---|---|---|---|
| iPad Air M4 (12 جيجابايت) | Phi-4 Mini Q4 / Llama 3.2 3B Q4 | ~18–20 رمز/ثانية | المساعدة في الكتابة والتلخيص |
| iPad Air M3 / أجهزة iPad الأخرى 8 جيجابايت | Llama 3.2 3B Q4 / Qwen3 1.7B | ~10–18 رمز/ثانية (تقدير) | صياغة خفيفة وملخصات |
| iPad Pro M5 (12 جيجابايت / 16 جيجابايت) | Llama 3.2 3B / Gemma 3 4B Q4 | ~32–38 / ~20–23 رمز/ثانية | محطة LLM حقيقية، وRAG، وصياغة الخيال |
| Android 8 جيجابايت (Tab S10+) | Phi-4 Mini Q4 عبر Termux+Ollama | ~10–15 رمز/ثانية | المستخدمون المتمرسون مع Termux |
| Android 6 جيجابايت | Qwen3 1.7B Q4 | ~15–20 رمز/ثانية | دردشة خفيفة وترجمة ومهام بسيطة |
| Pixel Tablet (8 جيجابايت) | الاتصال عن بُعد فقط | لا ينطبق | Tensor G2 بطيء جدًا للتشغيل على الجهاز |
| iPad mini 7 (A17 Pro، 8 جيجابايت) | Llama 3.2 3B Q4 / Qwen3 1.7B | غير مقاسة | مسودات خفيفة وتلخيص |
| iPad A16 (6 جيجابايت) / iPad الجيل 10 (4 جيجابايت) | Qwen3 1.7B Q4 أو أصغر | غير مقاسة | أسئلة قصيرة؛ للمزيد اتصال عن بُعد |
| Galaxy Tab S11 Ultra (12 / 16 جيجابايت) | Gemma 4 E4B / Phi-4 Mini Q4 | غير مقاسة | تعدد مهام أوسع (فئة 16 جيجابايت) |
| أي لوحي عن بُعد (بما فيه iPad + Ollama) | أي نموذج على الجهاز المنزلي | ~20–40 رمز/ثانية | الجودة أولًا، ونماذج 70B، وتشغيل Ollama مع iPad |
💡نصيحة: لمعظم المهام اليومية (صياغة النصوص، والإجابة عن الأسئلة، وتلخيص المحتوى)، يكفي Phi-4 Mini (3.8B) على اللوحي. أما أين يتراجع مقارنةً بنموذج 70B: الاستدلال المعقد متعدد الخطوات، والكتابة الإبداعية الدقيقة، وتحليل المستندات الطويلة. لهذه المهام، استخدم الاتصال عن بُعد بجهاز منزلي يشغّل نموذجًا أكبر.
واجهات الذكاء الاصطناعي المحلي للوحي
تؤثر واجهة الدردشة التي تستخدمها على اللوحي في سهولة الاستخدام تأثيرًا كبيرًا. بعض الواجهات مصممة للجوّال؛ وأخرى مصممة لسطح المكتب أولًا وتكاد تكون مقبولة على اللوحي.
- Open WebUI (متصفح): أفضل واجهة ويب متجاوبة مع الجوّال للدردشة العامة. تعمل على أي IP:منفذ محلي في Safari أو Chrome. تتكيف بوضوح مع أبعاد شاشات الألواح. موصى بها لإعدادات الاتصال عن بُعد.
- PocketPal AI (تطبيق iPad وAndroid): مجاني ومفتوح المصدر، يستورد نماذج GGUF ولديه اختبار أداء مدمج. الخيار الأكثر مرونة للتشغيل على الجهاز على المنصتين.
- Locally AI (تطبيق iPad): واجهة نظيفة بأسلوب Apple مبنية على MLX؛ أبسط تجربة أولى للمستخدمين غير التقنيين على iPad.
- Google AI Edge Gallery (تطبيق iPad وAndroid): تطبيق من Google يركّز على Gemma؛ أسهل طريقة لتجربة نماذج Google الصغيرة على الجهاز.
- RisuAI (متصفح، متجاوب مع الجوّال): أفضل تجربة جوّال للعب الأدوار وخيال بطاقات الشخصيات. يمكنه الاتصال بنسخة Ollama بعيدة. يعمل في Safari على iPad بواجهة قريبة من جودة التطبيقات.
- SillyTavern (متصفح): يعمل في Safari على iPad متصلًا بنسخة Ollama بعيدة. غير محسَّن للجوّال لكنه يؤدي الغرض. بعض ميزات الإضافات لا تعمل في Safari على الجوّال.
- Termux CLI (Android): سطر أوامر فقط. صالح للمهام المبرمجة؛ وغير عملي للمحادثة دون تطبيق مرافق.
💡نصيحة: للعب الأدوار وخيال بطاقات الشخصيات على iPad، يُعد RisuAI المتصل بنسخة Ollama بعيدة تشغّل Llama 3.3 70B تركيبة قوية في 2026. واجهة RisuAI للجوّال مصممة للمس؛ ويتيح الاتصال عن بُعد الوصول إلى نموذج 70B ينتج صوت شخصيات أفضل بكثير من أي نموذج يتسع على لوحي.
الأخطاء الشائعة
- البحث عن LLM Farm في App Store. أزالته Apple في أغسطس 2025. استخدم PocketPal AI أو Locally AI، أو ابنِ LLM Farm من المصدر.
- تشغيل نموذج 7B على لوحي بذاكرة 8 جيجابايت. عند 5–8 رموز/ثانية، يكون ذلك بطيئًا جدًا للمحادثة. استخدم نماذج 3B للدردشة على الجهاز في الأجهزة بذاكرة 8 جيجابايت؛ واستخدم الاتصال عن بُعد لجودة 7B فصاعدًا.
- استخدام Termux من متجر Play على Android. نسخة Termux في متجر Play قديمة وتفتقر إلى الحزم اللازمة لـ Ollama. ثبّت Termux دائمًا من F-Droid.
- تعريض Open WebUI للإنترنت دون مصادقة. لا يملك Open WebUI كلمة مرور افتراضيًا. إذا عرّضته خارج شبكتك المنزلية، فإن أي شخص يعثر على العنوان يصل إلى نموذجك. فعّل نظام الحسابات الإدارية واستخدم جدار حماية.
- عدم إغلاق التطبيقات الأخرى قبل التشغيل على الجهاز في iPad بذاكرة 8 جيجابايت. يُخلي iOS تطبيقات الخلفية من الذاكرة. يستخدم نموذج 3B على iPad بذاكرة 8 جيجابايت نحو 3.5 جيجابايت؛ وإذا استعاد iOS تلك الذاكرة لتطبيق آخر، ينهار النموذج. أغلق جميع التطبيقات الأخرى قبل بدء الاستدلال.
- توقع واجهة بجودة سطح المكتب في متصفحات الجوّال. SillyTavern وبعض الواجهات الأخرى مصممة لسطح المكتب أولًا. تجربتها في متصفح الجوّال تؤدي الغرض لكنها ليست مصقولة. لتجربة جوّال أفضل، فضّل RisuAI أو Open WebUI.
- كتابة
ipad.localفي المتصفح. يحتاج Safari إلى عنوان الجهاز المنزلي — عنوان IP أو اسم المضيف، مثل192.168.1.20:3000أوmy-mac.local:3000— وليس اسم الجهاز اللوحي. اسم مثلipad.localيشير إلى جهاز لوحي، لا إلى الجهاز الذي يشغّل Ollama.
المصادر
- وثائق LLM Farm (iOS) وGitHub — github.com/guinmoon
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai
- Locally AI — صفحة App Store
- Google AI Edge Gallery — github.com/google-ai-edge/gallery
- حزمة Ollama في Termux — Termux (ثبّت Termux من F-Droid)
- بنية Ollama لمعالجات ARM على Termux — وثائق Ollama
- وثائق Open WebUI — docs.openwebui.com
- مواصفات شريحة Apple M5 لجهاز iPad Pro، وفئات الذاكرة، وسرعة نقل البيانات — Apple Newsroom، أكتوبر 2025
- مواصفات شريحة Apple M4 لجهاز iPad Air والذاكرة — Apple Newsroom، مارس 2026
- نظرة عامة على نماذج Gemma 4 ومتطلبات الذاكرة — Google AI for Developers
- شريحة Samsung Galaxy Tab S11 Ultra وفئات الذاكرة — GSMArena
الأسئلة الشائعة
هل يمكن تشغيل الذكاء الاصطناعي على iPad؟
نعم، على iPad Pro M5 (12 جيجابايت أساسًا / 16 جيجابايت في فئتَي 1 تيرابايت و2 تيرابايت) وiPad Air M4 (12 جيجابايت). يشغّل iPad Pro M5 نموذجَي Phi-4 Mini وLlama 3.2 3B في الوقت الفعلي باستخدام PocketPal AI أو Locally AI، وأسرع بنحو 25–30% من iPad Pro M4 السابق بفضل سرعة نقل الذاكرة الأعلى (153 جيجابايت/ثانية مقابل 120). ويشغّل iPad Air M4 نماذج 3B–4B بسلاسة. لنماذج 7B فصاعدًا على iPad، يُوصى بالاتصال عن بُعد بجهاز Mac أو PC منزلي يشغّل Ollama — يعرض الـ iPad الدردشة بينما يتولى الجهاز المنزلي الاستدلال.
هل يعمل Ollama على iPad؟
لا — لا يملك Ollama إصدارًا مدعومًا لـ iPadOS، لذا لا يمكن تثبيته مباشرةً على iPad كما يمكن على Android عبر Termux. "تشغيل Ollama على iPad" يعني تشغيل Ollama على Mac أو PC والاتصال به من متصفح iPad (عبر Open WebUI على عنوان IP المحلي للجهاز المنزلي) — فـ iPad هنا شاشة عرض وليس محرك الاستدلال. للحصول على استدلال حقيقي على الجهاز في iPad، استخدم بدلًا من ذلك تطبيقًا يعمل على الجهاز مثل PocketPal AI (نماذج GGUF عبر llama.cpp) أو Locally AI (نماذج MLX).
هل يمكن تشغيل الذكاء الاصطناعي على لوحي Android؟
نعم، على الأجهزة بذاكرة 8 جيجابايت أو أكثر باستخدام PocketPal AI أو Termux + Ollama. يشغّل Samsung Galaxy Tab S10+ (ذاكرة 12 جيجابايت) نموذج Phi-4 Mini بسرعة ~10–15 رمز/ثانية. ويمكن للأجهزة بذاكرة 6 جيجابايت تشغيل Qwen3 1.7B. يتطلب إعداد Termux تثبيته من F-Droid وإلمامًا ببعض أوامر الطرفية. الاتصال عن بُعد بجهاز منزلي هو الطريق الأسهل لمعظم مستخدمي ألواح Android.
هل يعمل الذكاء الاصطناعي على الجهاز في اللوحي دون إنترنت؟
نعم. بعد تنزيل النموذج وتثبيت التطبيق، يعمل الاستدلال على الجهاز في iPad (PocketPal AI وLocally AI) وAndroid (Termux + Ollama) دون أي اتصال بالإنترنت. هذه إحدى المزايا الرئيسية للتشغيل على الجهاز مقارنةً بالاتصال عن بُعد — فنهج الاتصال عن بُعد يتطلب شبكة Wi-Fi المنزلية.
ما أفضل تطبيق ذكاء اصطناعي لـ iPad؟
للاستدلال على الجهاز: PocketPal AI (مفتوح المصدر، يستورد أي نموذج GGUF) أو Locally AI (أبسط واجهة، MLX). لم يعد LLM Farm متاحًا على App Store. للاتصال عن بُعد بخادم Ollama منزلي: Open WebUI في Safari (الأفضل للدردشة العامة)، وRisuAI في Safari (الأفضل للعب الأدوار وخيال الشخصيات). يعتمد الاختيار الأفضل على ما تريده: القدرة على الجهاز أم الاستخدام دون اتصال أم أفضل جودة واجهة.
هل Termux + Ollama آمن للاستخدام على Android؟
نعم. Termux محاكي طرفية معروف لـ Android يستخدمه ملايين المطورين. يقدّم Ollama في Termux واجهة API محلية فقط (localhost:11434 افتراضيًا) — ولا يمكن الوصول إليها من أجهزة أخرى على شبكتك ما لم تغيّر عنوان الربط صراحةً. تُخزَّن ملفات النماذج في التخزين الخاص بـ Termux، لا في تخزين Android المشترك.
هل يمكنني الحصول محليًا على ردود بجودة ChatGPT على لوحي؟
ليس تمامًا، لكن قريبًا مع الإعداد المناسب. جودة النماذج السحابية المتقدمة تتطلب عمومًا نموذج 70B فأكثر. على اللوحي: لا يستطيع iPad Pro M5 (12 جيجابايت / 16 جيجابايت) تشغيل نماذج 70B — إذ تتسع نماذج 3B–8B فقط. عبر الاتصال عن بُعد: إذا كان جهازك المنزلي يملك بطاقة GPU بذاكرة 24 جيجابايت (RTX 4090) أو ذاكرة موحدة 64 جيجابايت (Mac M5 Max)، فيمكنه تشغيل Llama 3.3 70B، ويصل لوحيك إلى تلك الجودة عبر Open WebUI في المتصفح. هذا أقرب ما يمكن إلى جودة الذكاء الاصطناعي السحابي على لوحي.
كيف أبقي خادم Ollama المنزلي يعمل عند إغلاق غطاء اللابتوب؟
على macOS، اضبط سياسة السكون عند إغلاق الغطاء: إعدادات النظام (System Settings) ← البطارية (Battery) ← عطّل "Enable Power Nap" واستخدم أداة مثل Amphetamine لمنع السكون عند التوصيل بالكهرباء. على Windows، اذهب إلى Power Options ← Change plan settings ← اختر "Never" للسكون عند التوصيل بالكهرباء. أو شغّل Ollama على جهاز يعمل دائمًا (Mini PC أو NAS أو لابتوب قديم أُعيد توظيفه) بدلًا من لابتوبك الأساسي.
هل يستنزف تشغيل الذكاء الاصطناعي على اللوحي البطارية بسرعة؟
نعم — الاستدلال على الجهاز مكثّف على CPU/GPU ويستنزف البطارية أسرع بكثير من التصفح؛ ويختلف المعدل حسب الجهاز والنموذج. للاستخدام الطويل، أبقِ اللوحي موصولًا بالكهرباء. الاتصال عن بُعد بجهاز منزلي يستهلك بطارية اللوحي بدرجة أقل بكثير — فاللوحي يعرض صفحة ويب فقط.
هل تخفّض الألواح أداءها بسبب الحرارة أثناء الاستدلال؟
نعم، خصوصًا في iPad Air M4 وألواح Android التي لا تملك تبريدًا نشطًا. يملك iPad Pro M5 هامشًا حراريًا أكبر من iPad Air، وتخفّض كثير من ألواح Android أداءها أبكر عند الاستدلال المتواصل. أساليب التخفيف: استخدم أجزاء توليد أقصر (200–400 رمز لكل رد)، وضع اللوحي على سطح صلب، وتجنب تشغيل تطبيقات أخرى مكثّفة للمعالج في الوقت نفسه.
ما أفضل لوحة مفاتيح لاستخدام الذكاء الاصطناعي على اللوحي؟
تُعد Apple Magic Keyboard لجهاز iPad Pro M5 (مع لوحة تتبع) الإعداد الأكثر صقلًا — تعمل اختصارات لوحة المفاتيح كاملة في Safari + Open WebUI، وتتيح لوحة التتبع تحديد النص عبر الردود الطويلة. تُعد Logitech Combo Touch البديل الاقتصادي. على Android: تعمل أي لوحة مفاتيح Bluetooth مع Termux لكن التجربة أخشن (طرفية فقط). لأعمال الكتابة، يحوّل iPad Pro + Magic Keyboard اللوحي إلى محطة ذكاء اصطناعي تركّز على الكتابة.
هل يمكنني تشغيل SillyTavern على iPad؟
نعم، عبر الاتصال عن بُعد. يعمل SillyTavern على Mac أو PC منزلي، ويتصل به Safari على iPad عبر عنوان IP المحلي. واجهة الجوّال تؤدي الغرض لكنها غير مصقولة — بعض ميزات الإضافات (أدوات regex ولوحات الدردشة الجماعية) تعمل لكنها تبدو ضيقة. للعب الأدوار تحديدًا، لدى RisuAI واجهة جوّال أفضل من SillyTavern؛ ويمكن لكليهما الاتصال بخلفية Ollama نفسها على جهازك المنزلي.
هل يستطيع اللوحي التعامل مع RAG للمستندات الطويلة؟
على الجهاز، لا — فتضمين أكثر من 1000 مستند على لوحي غير عملي. عبر الاتصال عن بُعد، نعم — يتولى جهازك المنزلي خط RAG بينما يعرض اللوحي واجهة الدردشة. يتعامل AnythingLLM المشغَّل على جهاز منزلي والمُفتوح عبر متصفح اللوحي مع مجموعات مستندات بأي حجم دون حد من جانب اللوحي. للطلاب والعاملين في مجال المعرفة الراغبين في RAG على اللوحي، الاتصال عن بُعد هو عادةً الخيار الأكثر عملية.
هل يمكنني استخدام شاشات خارجية مع الذكاء الاصطناعي على اللوحي؟
نعم على iPad Pro M5 (يمنح Stage Manager مع شاشة خارجية إعدادًا متعدد النوافذ؛ Open WebUI على الشاشة الخارجية، والملاحظات/المستندات المصدر على شاشة iPad). يدعم Galaxy Tab S10 Ultra وضع DeX مع شاشة خارجية لسير عمل مماثل متعدد الشاشات. أما ألواح Android التي لا تملك وضع DeX فتعكس الشاشة فقط — وهذا أقل فائدة. يُعد iPad Pro + شاشة خارجية + Magic Keyboard أقرب ما يصل إليه لوحي من محطة ذكاء اصطناعي حقيقية في 2026.
هل اللوحي أفضل من الهاتف للذكاء الاصطناعي المحلي؟
للاستخدام الكثيف الكتابة (الصياغة وRAG والمحادثات الطويلة)، نعم — فدعم لوحة المفاتيح وحجم الشاشة مهمان. للدردشة السريعة والاستعلامات الصوتية أو الاستخدام أثناء التنقل، الهاتف الذي تحمله أصلًا أفضل. iPad Pro M5 هو اللوحي الأكثر احتمالًا للتفوق على هاتف رائد في الذكاء الاصطناعي المحلي؛ أما الألواح والهواتف المتوسطة فمتقاربة تقريبًا. لا ينبغي لمعظم القراء شراء لوحي لأجل الذكاء الاصطناعي المحلي فقط — اشتره إذا أردت لوحيًا لأسباب أخرى؛ وقدرة الذكاء الاصطناعي ميزة إضافية.
لماذا الذكاء الاصطناعي المحلي بطيء جدًا على لوحي؟
عادةً لأحد أربعة أسباب: النموذج أكبر من الذاكرة الحرة (يستخدم النظام التبديل أو يغلق التطبيق)، أو التوليد محدود بسرعة نقل الذاكرة لا بسرعة الشريحة، أو اللوحي يخفّض أداءه بسبب الحرارة، أو تطبيقات الخلفية تستهلك الذاكرة. الحلول: انتقل إلى نموذج أصغر أو تكميم Q4، وأغلق التطبيقات الأخرى، وأبقِ اللوحي باردًا وموصولًا بالكهرباء، وقس السرعة الفعلية باختبار الأداء المدمج في PocketPal AI. وإذا بقي نموذج 3B بطيئًا جدًا، فاستخدم الاتصال عن بُعد بجهاز منزلي.
أي الألواح يمكنها تشغيل LLM محلي (iPad Air M3 وiPad الأساسي وGalaxy Tab A وHuawei MatePad وXiaomi Pad)؟
الذاكرة والشريحة هما الحَكَم، لا الماركة. يتعامل iPad Air M3 (8 جيجابايت) مع نماذج 1B–3B؛ أما أجهزة iPad الأساسية وألواح Android الاقتصادية بذاكرة أقل من 6 جيجابايت فتتسع فيها نماذج 1B–1.7B فقط، لذا فالاتصال عن بُعد هو الخيار الأفضل لها. تشغّل ألواح Huawei MatePad وXiaomi Pad بذاكرة 8 جيجابايت أو أكثر التطبيقات نفسها التي تعمل على ألواح Android الأخرى، رهنًا بتوفرها في متجر التطبيقات الخاص بها. تحقق من ذاكرة RAM في لوحيك من الإعدادات، ثم اتبع جدول النماذج أعلاه.
هل يوجد تطبيق Ollama لـ iPad؟
لا يوجد تطبيق Ollama رسمي لـ iPadOS. توجد تطبيقات iPad من جهات خارجية تتصل بخادم Ollama على جهاز Mac أو PC لديك — مثل GetOAI وLLLM — لكنها تعرض الدردشة فقط؛ فالنموذج لا يزال يعمل على الجهاز المنزلي. تحقق من صفحة كل تطبيق في App Store قبل التثبيت. أما مسار المتصفح (Open WebUI في Safari) فلا يحتاج إلى أي تطبيق.
هل يمكنني تشغيل LLM محلي على لوحي Android دون طرفية؟
نعم. ينزّل PocketPal AI (مجاني، مفتوح المصدر، على Google Play) وGoogle AI Edge Gallery (مجاني، Apache 2.0) النماذج ويشغّلانها على الجهاز دون Termux. لا حاجة إلى Termux + Ollama إلا إذا أردت تحديدًا منظومة Ollama أو نقطة API محلية.
هل يمكن لجهاز iPad قديم أو اقتصادي (الجيل 9 أو 10 أو 11، iPad mini، iPad Air 5) تشغيل نموذج لغوي محلي؟
الذاكرة (RAM) هي التي تحسم الأمر. أجهزة iPad من الجيل 9 (3 جيجابايت) والجيل 10 (4 جيجابايت) وiPad mini 6 (4 جيجابايت) أصغر من أن تقدّم دردشة مفيدة على الجهاز، فاستخدم الاتصال عن بُعد. أما iPad الجيل 11 (A16، 6 جيجابايت) فيستوعب نماذج 1B–1.7B بصيغة Q4. ويستوعب iPad mini 7 (A17 Pro، 8 جيجابايت) وiPad Air 5 وiPad Air M3 (8 جيجابايت) نماذج 3B بصيغة Q4 ضمن حدود 8 جيجابايت الموضحة أعلاه. لا تنشر Apple حجم الذاكرة لكل هذه الطرازات؛ الأرقام متداولة على نطاق واسع لكنها ليست مؤكدة من Apple.
هل يعمل نموذج لغوي محلي على Galaxy Tab S11 Ultra أو Galaxy Tab S9 FE؟
يتجاوز Galaxy Tab S11 Ultra (Dimensity 9400+، بذاكرة 12 أو 16 جيجابايت بحسب الفئة) حدّ 8 جيجابايت، ويشغّل التطبيقات نفسها التي يشغّلها Tab S10+ — PocketPal AI وGoogle AI Edge Gallery وTermux + Ollama — مع مساحة أكبر لنماذج 3B–4B. أما Galaxy Tab S9 FE فيُباع بذاكرة 6 أو 8 جيجابايت: نسخة 6 جيجابايت تناسب Qwen3 1.7B فقط، ونسخة 8 جيجابايت تتبع صف 8 جيجابايت في جدول النماذج. شريحة Exynos 1380 من الفئة المتوسطة، فتوقّع سرعة أقل من الأجهزة اللوحية الرائدة.
هل يعمل Gemma 4 على جهاز لوحي؟
نعم، الإصدارات الصغيرة من Gemma 4. تُدرج Google الإصدارين E2B وE4B كأحجام للتشغيل على الجهاز؛ وبترميز 4 بت تذكر Google نحو 2.9 جيجابايت (E2B) و4.5 جيجابايت (E4B) من الذاكرة للأوزان. لذلك يُعد E2B الخيار الأكثر أمانًا للأجهزة اللوحية ذات 8 جيجابايت، ويناسب E4B ذاكرة 12 جيجابايت فأكثر. التطبيق الذي يشغّلهما على iPad وAndroid هو Google AI Edge Gallery، راجع مراجعة Google AI Edge Gallery. لم تقِس PromptQuorum سرعة Gemma 4 على الأجهزة اللوحية.
ما التطبيقات المجانية التي تشغّل نموذجًا لغويًا محليًا على iPad؟
تشغّل PocketPal AI (مجاني، MIT) وGoogle AI Edge Gallery (مجاني، Apache 2.0) وLocally AI (مجاني مع خيارات مدفوعة) النماذج على الجهاز دون تكلفة. كما أن Open WebUI في Safari المتصل بـ Ollama على Mac أو PC مجاني أيضًا. LLM Farm مجاني كذلك، لكنه يتطلب البناء من الشيفرة المصدرية.
هل ما زال بإمكاني تثبيت LLM Farm على iPad؟
ليس من App Store. حذفت Apple تطبيق LLM Farm في أغسطس 2025، ويذكر ملف README الخاص بالمشروع أن App Store وTestFlight غير متاحين مؤقتًا. الطريقة الوحيدة هي بناؤه من الشيفرة المصدرية في Xcode. وكان آخر تحديث رسمي له في 30 يناير 2026، فقد يكون غير مُصان. البديلان القابلان للتثبيت على iPad هما PocketPal AI وLocally AI.