Schnellübersicht
- iPad-Apps: PocketPal AI (kostenlos, MIT), Locally AI (kostenlos + Bezahloptionen, MLX), Google AI Edge Gallery (kostenlos, Apache 2.0). LLM Farm (kostenlos, MIT, nur iOS) wurde im August 2025 aus dem App Store entfernt und muss jetzt aus dem Quellcode gebaut werden.
- Android-Methode: PocketPal AI oder Google AI Edge Gallery (Apps, ohne Terminal) oder Termux + Ollama (CLI).
- Remote-Verbindung: jeder Tablet-Browser → Open WebUI oder eine einfache Chat-UI unter der lokalen IP Ihres Home-Computers. So führen auch iPad-Benutzer Ollama aus, da Ollama keinen nativen iPadOS-Build hat.
- Minimum für On-Device: iPad Air M4 (12 GB) für 3B–4B-Modelle; iPad Pro M5 (12 GB / 16 GB) für 7B–8B-Modelle.
- Minimum Android für On-Device: 8 GB RAM-Gerät (Samsung Galaxy Tab S10+, OnePlus Pad 2).
- Bestes On-Device-Modell: Phi-4 Mini (3.8B, 2,7 GB) für die meisten Tablets; Qwen3 1.7B für sehr limitierte Geräte.
- Geschwindigkeit der Remote-Verbindung: hängt von der Wi-Fi-Qualität und der Generierungsgeschwindigkeit des Home-Computers ab, nicht von der Hardware des Tablets.
Zwei Modi: Lokale Inferenz vs. Remote-Verbindung
Die wichtigste Entscheidung ist nicht, welche App zu verwenden — es ist, ob Inferenz auf dem Tablet oder auf einem leistungsfähigeren Home-Computer durchgeführt wird. Jeder Modus hat eine unterschiedliche Hardware-Anforderung und Leistungsobergrenze.
📍 In einem Satz
Das Ausführen von KI auf einem Tablet hat zwei praktische Modi: lokale Inferenz (Modell läuft auf dem Tablet-Chip, begrenzt auf 3B–7B-Modelle) oder Remote-Verbindung (Tablet ist eine Browser-Anzeige für einen Home-Mac oder PC, auf dem größere Modelle über Ollama und Open WebUI ausgeführt werden).
💬 In einfachen Worten
On-Device-Modus: das Modell lebt auf Ihrem Tablet und funktioniert offline. Es ist auf kleine Modelle (3B, vielleicht 7B auf einem High-End-iPad Pro) begrenzt und ist langsamer als eine Cloud-KI. Remote-Modus: Ihr Home-Mac oder PC führt Ollama und ein 70B-Modell aus, und Ihr Tablet zeigt nur den Chat in einem Browser — Sie erhalten volle 70B-Qualität auf dem Tablet-Bildschirm, kein Modell auf dem Tablet gespeichert, und der Home-Computer muss eingeschaltet sein und im gleichen Wi-Fi. Wählen Sie die Remote-Verbindung, es sei denn, Sie benötigen spezifisch die Offline-Nutzung.
Faktor | Lokale Inferenz | Remote-Verbindung |
|---|---|---|
| Modellgrößenlimit | 3B–8B (iPad Pro M5); 3B–4B (die meisten Tablets) | Unbegrenzt — Home-Computer führt jedes Modell aus |
| Offline-Nutzung | Ja — funktioniert ohne Wi-Fi | Nein — erfordert Home-Wi-Fi |
| Generierungsgeschwindigkeit | Moderat (12–30 Token/Sek auf iPad Pro M5) | Hängt vom Home-Computer ab (bis zu 40+ Token/Sek) |
| Speicher auf Tablet | 2–10 GB pro Modell | Keine — Modell lebt auf dem Home-Computer |
| Setup-Komplexität | Niedrig (App herunterladen + Modelldatei) | Niedrig–Mittel (Home-Computer benötigt Ollama + Open WebUI) |
| Am besten für | Reisen, Offline-Nutzung, 3B-Modell-Aufgaben | Qualitätsorientierte Nutzung, 70B-Modelle, Komfort |

💡Tipp: Wenn Sie bereits einen Mac oder PC zu Hause haben, der Ollama ausführen kann, beginnen Sie mit der Remote-Verbindung. Sie erhalten sofort bessere Modellqualität auf Ihrem Tablet, ohne Modelldateien auf dem Tablet zu speichern oder mit mobilen App-Einschränkungen umzugehen. Fügen Sie später On-Device-Funktionalität hinzu, wenn Sie möchten.
iPad: Lokale Inferenz
iPad Pro M5 ist das iPad, das sich am besten für 7B–8B-Modelle eignet. Apple hat den Basis-RAM des M5 iPad Pro auf 12 GB angehoben (16 GB bei den 1 TB/2 TB-Speicherstufen), gegenüber 8 GB beim Basis-M4-iPad-Pro, und die Speicherbandbreite von 120 GB/s auf 153 GB/s erhöht — LLM-Inferenz auf Apple Silicon ist speicherbandbreiten-limitiert, was sich direkt in schnellerer Generierung niederschlägt. iPad Air M4 (12 GB, gegenüber 8 GB beim M3 Air) führt 3B–4B-Modelle jetzt komfortabel statt nur angemessen aus. Das iPad Air M3 (8 GB) und andere iPads mit 8 GB sind auf 1B–3B-Modelle in Q4 beschränkt. iPhone mit 8 GB RAM führt auch kleine Modelle aus.
- PocketPal AI (kostenlos, Open-Source MIT, iOS + Android): führt GGUF-Modelle über llama.cpp aus, lädt Modelle in der App von Hugging Face herunter oder importiert Dateien und enthält einen integrierten Benchmark, mit dem Sie die Token pro Sekunde Ihres eigenen Tablets messen können. Letztes Upstream-Update: 19. Oktober 2026. Siehe das PocketPal-AI-Review.
- Locally AI (kostenlos mit Bezahloptionen, Closed-Source, iPhone/iPad/Mac): führt offene Modelle über Apples MLX-Framework aus, gebaut für Apple Silicon. Letztes App-Store-Update: 15. Oktober 2026. Siehe das Locally-AI-Review.
- Google AI Edge Gallery (kostenlos, Apache 2.0, iOS + Android): Googles On-Device-App für seine Gemma-Modelle, basierend auf der LiteRT-LM-Runtime. Letztes Upstream-Update: 23. Oktober 2026. Siehe das Google-AI-Edge-Gallery-Review. Die App führt außerdem Gemma 4 (E2B und E4B) aus, Googles aktuelle kleine Modelle für den Einsatz auf dem Gerät.
- LLM Farm (kostenlos, MIT, nur iOS): Apple hat den App-Store-Eintrag im August 2025 entfernt, und die README des Projekts führt sowohl App Store als auch TestFlight als „vorübergehend nicht verfügbar“ — der einzige Weg ist, es aus dem Quellcode in Xcode zu bauen. Letztes Upstream-Update: 30. Januar 2026, vor mehr als 180 Tagen, es könnte also nicht mehr gepflegt werden; prüfen Sie das Repository, bevor Sie sich darauf verlassen. Siehe das LLM-Farm-Review.
- Modelle importieren: in PocketPal AI laden Sie ein GGUF-Modell in der App von Hugging Face herunter oder importieren eine GGUF-Datei, die Sie per Apple Files übertragen haben. Modelle werden im lokalen Speicher der App gespeichert — nicht in iCloud.
- RAM-Verwaltung auf iPad: iOS verwaltet RAM aggressiv für Hintergrund-Apps. Schließen Sie alle anderen Apps vor dem Ausführen eines 7B-Modells auf einem 12 GB-iPad — iOS wird das Modell entfernen, wenn eine andere App Speicher benötigt. Auf dem 16 GB iPad Pro M5 (1 TB/2 TB-Stufen) ist dies selten ein Problem.
- Geschwindigkeitsschätzungen (ungefähr, keine PromptQuorum-Benchmarks — messen Sie Ihr eigenes Gerät mit dem integrierten Benchmark von PocketPal AI): iPad Pro M5 (12 GB / 16 GB): Phi-4 Mini ~25 Token/Sek, Llama 3.2 3B ~38 Token/Sek, Gemma 3 4B ~23 Token/Sek — rund 25–30 % schneller als die vorherige M4-Generation, entsprechend der höheren Speicherbandbreite. iPad Air M4 (12 GB): 3B–4B-Modelle ~15–20 Token/Sek; 7B-Modelle ~7–10 Token/Sek (weiterhin langsam für Echtzeit-Chat).
- Einsteiger-iPads und iPads mit 8 GB RAM oder weniger: verwenden Sie 1B–3B-Modelle in Q4 oder nutzen Sie das iPad als Anzeige für eine Remote-Verbindung. Passt ein Modell nicht in den freien RAM, beendet iPadOS die App, statt sich allmählich zu verlangsamen.

⚠️Warnung: Versuchen Sie nicht, ein 7B-Modell auf einem 12 GB-iPad Air für Echtzeit-Chat auszuführen. Mit 7–10 Token pro Sekunde dauert jede Antwort weiterhin 10–20 Sekunden. Dies ist für Zusammenfassungsaufgaben nützlich, bei denen Sie einen Prompt senden und warten, aber frustrierend für gesprächsbasierte Nutzung. Verwenden Sie 3B–4B-Modelle auf iPad Air; wechseln Sie zum 16 GB iPad Pro M5 oder zur Remote-Verbindung für 7B+.
Android: Lokale Inferenz
Android On-Device-Inferenz verwendet Termux + Ollama — Termux ist ein Linux-Terminal-Emulator, der Ollama nativ auf Android ausführt. Dies ist technischer als die iPad-App-Erfahrung, gibt aber Zugriff auf das vollständige Ollama-Ökosystem.
- Einfachere Alternativen zu Termux: PocketPal AI (Google Play, kostenlos, MIT; letztes Upstream-Update: 19. Oktober 2026) und Google AI Edge Gallery (kostenlos, Apache 2.0; letztes Upstream-Update: 23. Oktober 2026) führen On-Device-Modelle ohne Terminal aus. Beginnen Sie mit einer von beiden, wenn Sie nicht ausdrücklich Ollama brauchen. Siehe das PocketPal-AI-Review.
- Unterstützte Geräte für 3B+ Modelle: 8 GB RAM-Minimum (Samsung Galaxy Tab S10+, OnePlus Pad 2, Xiaomi Pad 7 Pro). Geräte mit 6 GB führen nur Qwen3 1.7B aus.
- Pixel Tablet nicht empfohlen für On-Device: Pixel Tablet (2023-Modell, 8 GB Tensor G2) wurde von der empfohlenen On-Device-Liste ausgeschlossen — Tensor G2 ist bei der LLM-Inferenz erheblich langsamer als Snapdragon 8 Gen 3 / Dimensity 9300 und liefert 4–7 Token/Sek auf Phi-4 Mini (zu langsam für gesprächsbasierte Nutzung). Pixel-Tablet-Benutzer sollten die Remote-Verbindung zu einem Home-Computer verwenden.
- Snapdragon 8 Gen 3 und Dimensity 9300 sind die schnellsten Android-Chips für On-Device-Inferenz 2026. Generierungsgeschwindigkeit: ~15–25 Token/Sek für 1.7B-Modelle; ~8–12 Token/Sek für 3B-Modelle.
- Modellspeicher: Android hat keinen einheitlichen Speicher — das Modell läuft in System-RAM ohne GPU-Beschleunigung in den meisten Termux-Konfigurationen. GPU-Beschleunigung erfordert Termux:NVIDIA oder spezifische Vulkan-Builds; Setup ist komplexer.
- Alternative Apps: MNN LLM (Alibaba, kostenlos, Android-App mit On-Device-Inferenz für ausgewählte Modelle) ist ein einfacheres Setup, hat aber eine begrenztere Model-Auswahl als Ollama. AI Runner und llamafile haben auch Android-Builds mit unterschiedlicher Unterstützung. Es gibt keine Android-Version von LLM Farm — es ist eine iOS-only-App; PocketPal AI ist das nächste Android-Äquivalent.
- Andere Marken (Huawei MatePad, Xiaomi Pad, Galaxy-Tab-A-Serie): RAM und Chip entscheiden, nicht die Marke. Prüfen Sie den RAM des Tablets in den Einstellungen: unter 6 GB bleiben Sie bei 1B–1,7B-Modellen oder nutzen die Remote-Verbindung; bei 8 GB oder mehr folgen Sie der 8-GB-Zeile der Modelltabelle.
- Einen Japan-spezifischen Xperia-Einrichtungsleitfaden mit Hardware-Kompatibilitätstabelle finden Sie unter <a href="/de/prompt-bites/run-local-llm-on-xperia-japan" class="text-primary hover:underline">Lokales LLM auf Xperia ausführen (Japan)</a>.
- 1Installieren Sie Termux von F-Droid (nicht die Play Store-Version — der Play Store-Build ist veraltet und fehlen erforderliche Pakete).
- 2In Termux:
pkg update && pkg upgrade - 3Installieren Sie Ollama aus dem Termux-Paket-Repository:
pkg install ollama(ältere Anleitungen bauen Ollama mit Go aus dem Quellcode, das ist nicht mehr nötig). - 4Ziehen Sie ein Modell:
ollama pull phi4-minioderollama pull qwen3:1.7b. - 5Starten Sie den Server:
ollama serve(halten Sie dies in einer Termux-Sitzung aktiv). - 6Chat über Termux:
ollama run phi4-mini— oder öffnen Sie einen Web-Browser und gehen Sie zuhttp://localhost:11434, um auf die API zuzugreifen. Installieren Sie eine Android-Chat-App, die sich mit einem lokalen Ollama-Endpoint für eine GUI verbindet.

💡Tipp: Installieren Sie das Termux:Widget-Add-on und erstellen Sie eine Verknüpfung, die "ollama serve" ausführt — dies ermöglicht es Ihnen, den Ollama-Server von Ihrem Android-Startbildschirm aus zu starten, ohne Termux manuell zu öffnen. Sobald Ollama läuft, öffnen Sie eine Chat-App, die für localhost:11434 konfiguriert ist.
Remote-Verbindung zum Home-Computer
Das einfachste Setup für die meisten Tablet-Benutzer: Ollama und Open WebUI auf Ihrem Home-Mac oder PC ausführen und dann über Ihren Tablet-Browser im gleichen Wi-Fi auf die Chat-UI zugreifen. Ihr Tablet wird zu einer Touchscreen-Schnittstelle für den leistungsfähigeren Home-Computer, auf dem Ollama läuft — siehe den Laptop-Leitfaden, um die Hardware zu dimensionieren, wenn Sie den Home-Computer auswählen.
📍 In einem Satz
Die Remote-Verbindung zu einem Home-Computer, auf dem Ollama und Open WebUI ausgeführt wird, bietet jedem Tablet vollen Zugriff auf 70B-Modelle über einen Browser — kein Modell auf dem Tablet gespeichert, keine App-Installation und kein Kompromiss bei der Modellqualität.
💬 In einfachen Worten
Auf Ihrem Mac oder PC: Ollama installieren, ein Modell ziehen, Open WebUI installieren (Docker-Einzeiler) und an Ihre lokale Netzwerk-IP binden ausführen. Auf Ihrem Tablet: Safari oder Chrome öffnen, zu http://[your-mac-IP]:3000 gehen, und Sie haben eine vollständige KI-Chat-Schnittstelle. Das Modell läuft auf dem Mac; das Tablet zeigt nur den Chat. Funktioniert auf jedem Tablet, jedem Betriebssystem, jeder Bildschirmgröße.
- 1Auf dem Home-Computer: Ollama installieren (
brew install ollamaauf macOS, von ollama.com auf Windows herunterladen). Ein Modell ziehen:ollama pull llama3.3:70b(oder jedes beliebige Modell). Ollama mit Netzwerk-Bindung starten:OLLAMA_HOST=0.0.0.0:11434 ollama serve. - 2Open WebUI installieren (die Tablet-freundlichste Chat-UI):
docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 --name open-webui ghcr.io/open-webui/open-webui:main. Open WebUI ist jetzt unter `http://[your-machine-IP]:3000` verfügbar. - 3Finden Sie die lokale IP Ihres Home-Computers: auf macOS, Systemeinstellungen → Netzwerk → das aktuelle Netzwerk → IP-Adresse. Auf Windows, führen Sie
ipconfigin der Eingabeaufforderung aus und suchen Sie nach IPv4-Adresse. Notieren Sie die IP (typischerweise192.168.x.x). - 4Auf dem Tablet: Öffnen Sie Safari (iPad) oder Chrome (Android). Navigieren Sie zu `http://[your-machine-IP]:3000`. Erstellen Sie ein Konto in Open WebUI (nur lokal, keine Cloud). Wählen Sie Ihr Modell aus der Dropdown-Liste. Beginnen Sie zu chatten.
- 5Sicherheit: Dieses Setup ist nur lokales Netzwerk. Setzen Sie Port 3000 nicht dem Internet aus, ohne Open WebUI-Authentifizierung hinzuzufügen (es hat ein integriertes Admin-Kontosystem). Die Verbindung ist Plain HTTP — senden Sie keine vertraulichen Informationen über öffentliches Wi-Fi.

💡Tipp: Fügen Sie die Open WebUI-URL Ihres Home-Computers auf dem Startbildschirm Ihres Tablets als Lesezeichen hinzu (in Safari: Freigabe → Zum Startbildschirm hinzufügen; in Chrome: Drei-Punkt-Menü → Zum Startbildschirm hinzufügen). Dies fühlt sich wie eine native App an. Auf iPad verstecken Web-Apps im Vollbildmodus in Safari die Browser-Umgebung für ein App-ähnliches Erlebnis.
Modell-Empfehlungen pro Gerät
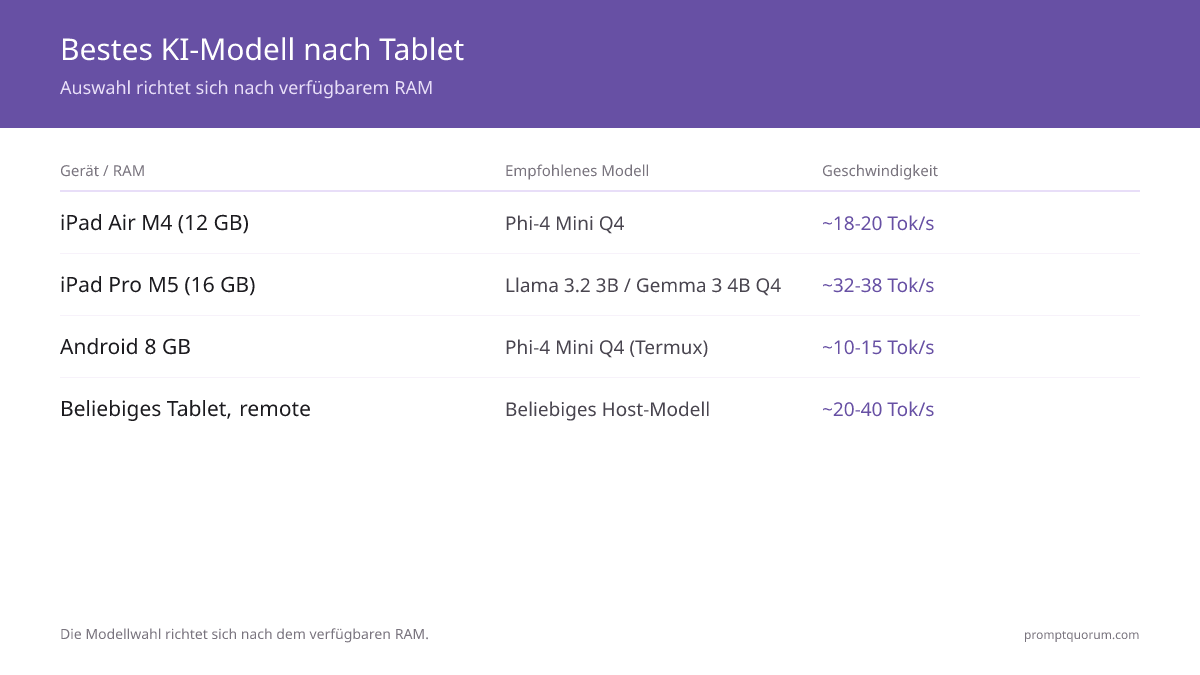
Die Modellwahl wird durch verfügbaren RAM bestimmt — nicht durch Vorlieben. Die Tabelle unten ordnet Geräte-RAM dem größten Modell zu, das mit Echtzeit-Geschwindigkeit (über 8 Token/Sek) läuft. Für die Modellschicht speziell siehe Best Mobile LLM Models 2026. Für die breitere Modelllandschaft über alle Hardware-Ebenen siehe Best Local LLMs 2026.
Gerät / RAM | Empfohlenes Modell | Geschwindigkeit | Am besten für |
|---|---|---|---|
| iPad Air M4 (12 GB) | Phi-4 Mini Q4 / Llama 3.2 3B Q4 | ~18–20 Token/Sek | Schreibunterstützung, Zusammenfassung |
| iPad Air M3 / andere 8-GB-iPads | Llama 3.2 3B Q4 / Qwen3 1.7B | ~10–18 Token/Sek (geschätzt) | Leichtes Entwerfen, Zusammenfassungen |
| iPad Pro M5 (12 GB / 16 GB) | Llama 3.2 3B / Gemma 3 4B Q4 | ~32–38 Token/Sek / ~20–23 Token/Sek | Echte LLM-Workstation, RAG, Fiction-Entwurf |
| Android 8 GB (Tab S10+) | Phi-4 Mini Q4 über Termux+Ollama | ~10–15 Token/Sek | Power-Nutzer komfortabel mit Termux |
| Android 6 GB | Qwen3 1.7B Q4 | ~15–20 Token/Sek | Leichter Chat, Übersetzung, einfache Aufgaben |
| Pixel Tablet (8 GB) | Nur Remote-Verbindung | N/V | Tensor G2 zu langsam für On-Device |
| iPad mini 7 (A17 Pro, 8 GB) | Llama 3.2 3B Q4 / Qwen3 1.7B | Nicht gemessen | Leichtes Entwerfen, Zusammenfassungen |
| iPad A16 (6 GB) / iPad 10. Gen. (4 GB) | Qwen3 1.7B Q4 oder kleiner | Nicht gemessen | Kurze Fragen; für mehr Remote nutzen |
| Galaxy Tab S11 Ultra (12 GB / 16 GB) | Gemma 4 E4B / Phi-4 Mini Q4 | Nicht gemessen | Mehr Multitasking (16-GB-Stufe) |
| Jedes Tablet über Remote | Jedes Modell auf dem Home-Computer | ~20–40 Token/Sek | Qualitätsorientierte Nutzung, 70B-Modelle |

💡Tipp: Für die meisten alltäglichen Aufgaben (Textentwurf, Fragen beantworten, Inhalte zusammenfassen) ist Phi-4 Mini (3.8B) auf einem Tablet ausreichend leistungsfähig. Wo es im Vergleich zu einem 70B-Modell schwach wird: komplexes mehrstufiges Denken, differenziertes kreatives Schreiben und lange Dokumentenanalyse. Für diese Aufgaben verwenden Sie die Remote-Verbindung zu einem Home-Computer, der ein größeres Modell ausführt.
Tablet-Frontends für lokale KI
Die Chat-Schnittstelle, die Sie auf dem Tablet verwenden, beeinflusst die Benutzerfreundlichkeit erheblich. Einige Frontends sind für Mobilgeräte ausgelegt; andere sind Desktop-first und auf Tablets kaum zu verwenden.
- Open WebUI (Browser): beste mobile-responsive Web-UI für allgemeinen Chat. Funktioniert unter jeder lokalen IP:Port in Safari oder Chrome. Passt sich saubern an Tablet-Seitenverhältnisse an. Wird für Remote-Verbindungs-Setups empfohlen.
- PocketPal AI (iPad- und Android-App): kostenlos, Open-Source, importiert GGUF-Modelle und hat einen integrierten Benchmark. Die flexibelste On-Device-Option auf beiden Plattformen.
- Locally AI (iPad-App): aufgeräumte Oberfläche im Apple-Stil auf Basis von MLX; die einfachste Ersteinrichtung für nicht-technische Nutzer auf dem iPad.
- Google AI Edge Gallery (iPad- und Android-App): Googles Gemma-fokussierte App; der einfachste Weg, Googles kleine Modelle On-Device auszuprobieren.
- RisuAI (Browser, mobile-responsive): beste mobile-Erfahrung für Roleplay und Character-Card-Fiction. Kann sich mit einer Remote-Ollama-Instanz verbinden. Funktioniert in iPad Safari mit einer Near-App-Quality-Schnittstelle.
- SillyTavern (Browser): funktioniert auf iPad Safari, verbunden mit einer Remote-Ollama-Instanz. Nicht für Mobilgeräte optimiert, aber funktionsfähig. Einige Erweiterungsfunktionen funktionieren nicht in mobil Safari.
- Termux CLI (Android): nur Befehlszeile. Für skriptgesteuerte Aufgaben nützlich; nicht praktisch für gesprächsbasierte Nutzung ohne begleitende App.
💡Tipp: Für Roleplay und Character-Card-Fiction auf iPad ist RisuAI verbunden mit einer Remote-Ollama-Instanz, auf der Llama 3.3 70B läuft, 2026 eine starke Kombination. Die mobile RisuAI-Schnittstelle ist für Touch ausgelegt; die Remote-Verbindung ermöglicht Zugriff auf ein 70B-Modell, das eine erheblich bessere Character-Voice liefert als jedes Modell, das auf ein Tablet passt.
Im DACH-Kontext: Datenschutz und lokale Inferenz
Für Benutzer in Deutschland, Österreich und der Schweiz hat die lokale Ausführung von KI-Modellen auf Tablets zusätzliche Bedeutung. Die DSGVO-Artikel 28 (Auftragsverarbeitung) und 32 (Datenschutzmassnahmen) fördern Architekturen, bei denen Kundendaten nicht an Cloud-Services gesendet werden. Lokale Inferenz auf einem Tablet — ob On-Device oder Remote-Verbindung zu einem Home-Computer — erfüllt diese Anforderungen ohne teure Enterprise-Lösungen.
- DSGVO-Artikel 28 Compliance: Wenn Ihr Tablet oder Home-Computer mit lokalen LLMs läuft, bleibt sensible Geschäftskommunikation innerhalb Ihres Netzwerks. Keine Datenübertragung zu US-Cloud-APIs (OpenAI, Google, Meta), die unter SCHREMS II-Bedenken fallen.
- Mittelstand-Anwendungsfälle: Kleine und mittlere Unternehmen (KMU) in Deutschland können Phi-4 Mini oder Llama 3.2 lokal ausführen, um interne Dokumentenverwaltung, Kundenkommunikation und Produktbeschreibungen zu unterstützen, ohne DSGVO-Risiken zu tragen. Ein iPad Pro M5 mit 12 GB/16 GB im Büro ist ein kostengünstiger Einstiegspunkt.
💡Tipp: Für DACH-Organisationen, die die Verwendung von Open-Source-Modellen wie Llama oder Qwen mit lokaler Speicherung validieren möchten: Die Open-Source-Lizenzen (Meta, Alibaba) und die lokale Netzwerk-Architektur vereinfachen die Compliance-Dokumentation für Regulatoren und Datenschutzbeauftragte. Führen Sie ein Setup-Proof-of-Concept mit dem Datenschutzbeauftragten durch, bevor Sie unternehmensweite Bereitstellung durchführen.
Häufige Fehler
- LLM Farm im App Store suchen. Apple hat es im August 2025 entfernt. Verwenden Sie PocketPal AI oder Locally AI, oder bauen Sie LLM Farm aus dem Quellcode.
- Ausführen eines 7B-Modells auf einem 8 GB-Tablet. Bei 5–8 Token/Sek ist dies zu langsam für gesprächsbasierte Nutzung. Verwenden Sie 3B-Modelle für On-Device-Chat auf 8 GB-Geräten; verwenden Sie Remote-Verbindung für 7B+ Qualität.
- Verwendung des Play Store Termux auf Android. Die Play Store-Version von Termux ist veraltet und fehlen die Pakete, die für Ollama benötigt werden. Installieren Sie Termux immer von F-Droid.
- Exposing von Open WebUI zum Internet ohne Authentifizierung. Open WebUI hat standardmäßig kein Passwort. Wenn Sie es über Ihr Heimnetzwerk hinaus exponieren, bekommt jeder, der die URL findet, Zugriff auf Ihr Modell. Aktivieren Sie das Admin-Kontosystem und verwenden Sie eine Firewall.
- Nichtschließen anderer Apps vor On-Device auf 8 GB-iPad. iOS räumt Hintergrund-Apps aus dem RAM ab. Ein 3B-Modell auf einem 8 GB-iPad nutzt ~3,5 GB; wenn iOS diesen Speicher für eine andere App zurückfordert, stürzt das Modell ab. Schließen Sie alle anderen Apps vor der Inferenz.
- Erwartung von Desktop-Qualitäts-UI auf Mobil-Browsern. SillyTavern und einige andere Frontends sind Desktop-first. Ihre mobile Erfahrung in einem Browser ist funktionsfähig, aber nicht poliert. Für mobile-first UX bevorzugen Sie RisuAI oder Open WebUI.
ipad.localin den Browser eingeben. Safari braucht die Adresse des Home-Computers – seine IP oder seinen Hostnamen, zum Beispiel192.168.1.20:3000odermein-mac.local:3000–, nicht den Namen des Tablets. Ein Name wieipad.localzeigt auf ein Tablet, nicht auf den Rechner, auf dem Ollama läuft.
Quellen
- LLM Farm (iOS) Dokumentation und GitHub — github.com/guinmoon
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai
- Locally AI — App-Store-Eintrag
- Google AI Edge Gallery — github.com/google-ai-edge/gallery
- Termux-Ollama-Paket — Termux (Termux über F-Droid installieren)
- Ollama ARM-Build für Termux — Ollama-Dokumentation
- Open WebUI-Dokumentation — docs.openwebui.com
- Apple M5-Chip-Spezifikationen für das iPad Pro, RAM-Stufen und Speicherbandbreite — Apple Newsroom, Oktober 2025
- Apple M4-Chip-Spezifikationen und RAM für das iPad Air — Apple Newsroom, März 2026
- Gemma 4 Modellübersicht und Speicherbedarf — Google AI for Developers
- Samsung Galaxy Tab S11 Ultra, Chip und RAM-Stufen — GSMArena
Häufig gestellte Fragen
Können Sie KI auf einem iPad ausführen?
Ja, auf iPad Pro M5 (12 GB Basis / 16 GB bei den 1 TB- und 2 TB-Stufen) und iPad Air M4 (12 GB). Der iPad Pro M5 führt Phi-4 Mini und Llama 3.2 3B in Echtzeit mit PocketPal AI oder Locally AI aus, dank höherer Speicherbandbreite (153 GB/s statt 120 GB/s) rund 25–30 % schneller als der vorherige iPad Pro M4. Der iPad Air M4 führt 3B–4B-Modelle komfortabel aus. Für 7B+ Modelle auf einem iPad wird die Remote-Verbindung zu einem Home-Mac oder PC, auf dem Ollama läuft, empfohlen — das iPad zeigt den Chat, aber der Home-Computer führt Inferenz durch.
Läuft Ollama auf einem iPad?
Nein — Ollama hat keinen unterstützten iPadOS-Build und kann daher nicht direkt auf einem iPad installiert werden, so wie es unter Android über Termux möglich ist. "Ollama auf dem iPad ausführen" bedeutet, Ollama auf einem Mac oder PC laufen zu lassen und sich vom iPad-Browser aus (über Open WebUI unter der lokalen IP des Home-Computers) damit zu verbinden — das iPad ist eine Anzeige, nicht die Inferenz-Engine. Für echte On-Device-Inferenz auf einem iPad verwenden Sie stattdessen eine On-Device-App wie PocketPal AI (GGUF-Modelle über llama.cpp) oder Locally AI (MLX-Modelle).
Können Sie KI auf einem Android-Tablet ausführen?
Ja, auf Geräten mit 8 GB+ RAM mit PocketPal AI oder Termux + Ollama. Das Samsung Galaxy Tab S10+ (12 GB RAM) führt Phi-4 Mini bei ~10–15 Token/Sek aus. Geräte mit 6 GB RAM können Qwen3 1.7B ausführen. Das Setup erfordert Termux von F-Droid und Komfort mit einigen Terminal-Befehlen. Die Remote-Verbindung zu einem Home-Computer ist der einfachere Weg für die meisten Android-Tablet-Benutzer.
Funktioniert On-Device-KI auf einem Tablet ohne Internet?
Ja. Sobald das Modell heruntergeladen ist und die App installiert ist, funktioniert On-Device-Inferenz auf iPad (PocketPal AI, Locally AI) und Android (Termux + Ollama) ohne Internetverbindung. Dies ist einer der Hauptvorteile von On-Device gegenüber Remote-Verbindung — die Remote-Verbindung erfordert Ihr Home-Wi-Fi.
Was ist die beste KI-App für iPad?
Für On-Device-Inferenz: PocketPal AI (Open-Source, importiert jedes GGUF-Modell) oder Locally AI (einfachste UI, MLX). LLM Farm ist im App Store nicht mehr verfügbar. Für Remote-Verbindung zu einem Home-Ollama-Server: Open WebUI in Safari (bester allgemeiner Chat), RisuAI in Safari (beste für Roleplay und Character-Fiction). Die beste Wahl hängt davon ab, ob Sie On-Device-Fähigkeit, Offline-Nutzung oder beste Schnittstellen-Qualität möchten.
Ist Termux + Ollama sicher auf Android zu verwenden?
Ja. Termux ist ein etablierter Android-Terminal-Emulator, der von Millionen von Entwicklern verwendet wird. Ollama in Termux stellt eine nur lokale API bereit (localhost:11434 standard) — sie ist nicht von anderen Geräten in Ihrem Netzwerk aus zugänglich, es sei denn, Sie ändern die Bind-Adresse explizit. Die Modelldateien werden im privaten Termux-Speicher gespeichert, nicht im freigegebenen Android-Speicher.
Kann ich ChatGPT-ähnliche Antworten lokal auf einem Tablet erhalten?
Nicht ganz, aber fast mit dem richtigen Setup. Die Qualität führender Cloud-Modelle erfordert in der Regel ein 70B+ Modell. Auf einem Tablet: Der iPad Pro M5 (12 GB / 16 GB) kann 70B-Modelle nicht ausführen — nur 3B–8B-Modelle passen. Via Remote-Verbindung: Wenn Ihr Home-Computer eine 24 GB-GPU (RTX 4090) oder 64 GB-Unified-Memory (Mac M5 Max) hat, kann er Llama 3.3 70B ausführen, und Ihr Tablet greift diese Qualität über Open WebUI im Browser zu. Das ist die Cloud-KI-Qualität auf einem Tablet am nächsten.
Wie halte ich meinen Home-Ollama-Server am Laufen, wenn ich das Laptop-Deckel schließe?
Auf macOS: Stellen Sie die Sleep-Policy beim Schließen des Deckels ein: Systemeinstellungen → Batterie → deaktivieren Sie "Power Nap aktivieren" und verwenden Sie ein Tool wie Amphetamine, um den Sleep zu verhindern, wenn an Strom angeschlossen. Auf Windows: Gehen Sie zu Energieoptionen → Planeinstellungen ändern → "Niemals" für Sleep, wenn an Strom angeschlossen. Alternativ führen Sie Ollama auf einem Always-On-Computer aus (Mini-PC, NAS oder repurposed altes Laptop), anstatt Ihrem primären Laptop.
Entleert die Ausführung von KI auf einem Tablet die Batterie schnell?
Ja — On-Device-Inferenz ist CPU/GPU-intensiv und entleert die Batterie deutlich schneller als Surfen; die Rate variiert je nach Gerät und Modell. Für längere Nutzung halten Sie das Tablet an Strom angeschlossen. Remote-Verbindung zu einem Home-Computer zieht erheblich weniger Tablet-Batterie — das Tablet zeigt nur eine Webseite an.
Throtteln Tablets während KI-Inferenz?
Ja, besonders auf iPad Air M4 und Android-Tablets ohne aktive Kühlung. iPad Pro M5 hat mehr thermalen Spielraum als das iPad Air, und viele Android-Tablets drosseln bei anhaltender Inferenz früher. Mitigationen: verwenden Sie kürzere Generierungs-Chunks (200–400 Token pro Antwort), halten Sie das Tablet auf einer harten Oberfläche und vermeiden Sie das gleichzeitige Ausführen anderer CPU-schwerer Apps.
Welche Tastatur funktioniert am besten für KI-Tablet-Nutzung?
Apple Magic Keyboard für iPad Pro M5 (mit Trackpad) ist das polierte Setup — volle Tastatur-Shortcuts funktionieren in Safari + Open WebUI, Trackpad ermöglicht Text-Auswahl über lange Antworten. Logitech Combo Touch ist die Budget-Alternative. Android: Jede Bluetooth-Tastatur funktioniert mit Termux, aber die Erfahrung ist rauer (nur Terminal). Für Schreibarbeiten verwandelt sich ein iPad Pro + Magic Keyboard in eine schreiborientierte KI-Workstation.
Kann ich SillyTavern auf iPad ausführen?
Ja, via Remote-Verbindung. SillyTavern läuft auf einem Home-Mac oder PC, und iPad Safari verbindet sich unter der lokalen IP. Mobile UI ist funktionsfähig, aber nicht poliert — einige Erweiterungsfunktionen (Regex-Tools, Group-Chat-Panels) funktionieren, fühlen sich aber beengt an. Für Roleplay speziell hat RisuAI bessere mobile UI als SillyTavern; beide können sich mit demselben Ollama-Backend auf Ihrem Home-Computer verbinden.
Kann ein Tablet Long-Form-RAG durchführen?
On-Device, nein — das Einbetten von 1.000+ Dokumenten auf einem Tablet ist unpraktisch. Via Remote-Verbindung, ja — Ihr Home-Computer verwaltet die RAG-Pipeline, das Tablet zeigt die Chat-Schnittstelle. AnythingLLM auf einem Home-Computer und über Browser auf dem Tablet zugegriffen verwaltet Dokument-Sammlungen jeder Größe ohne Tablet-seitige Begrenzung. Für Schüler oder Knowledge-Worker, die RAG auf Tablet möchten, ist die Remote-Verbindung in der Regel die praktischere Option.
Kann ich externe Displays mit Tablet-KI verwenden?
Ja, auf iPad Pro M5 (Stage Manager + external Display gibt ein Multi-Window-Setup; Open WebUI auf dem externen Monitor, Notizen/Quelldokumente auf dem iPad-Bildschirm). Galaxy Tab S10 Ultra unterstützt DeX-Modus mit externem Display für ähnliches Multi-Monitor-KI-Workflow. Android-Tablets ohne DeX-Modus spiegeln den Bildschirm — weniger nützlich. iPad Pro + externer Monitor + Magic Keyboard ist das Nächste, das ein Tablet zu einer echten KI-Workstation 2026 kommt.
Ist ein Tablet besser als ein Telefon für lokale KI?
Für Tasten-intensive Nutzung (Entwurf, RAG, lange Unterhaltungen), ja — Tastatur-Unterstützung und Bildschirmgröße sind wichtig. Für schnelle Chats, Voice-Queries oder unterwegs ist das Telefon, das Sie bereits tragen, besser. Der iPad Pro M5 ist das Tablet, das ein Flaggschiff-Telefon für lokale KI am ehesten übertrifft; Mid-Range-Tablets und Telefone sind ungefähr gleichwertig. Die meisten Leser sollten kein Tablet speziell für lokale KI kaufen — kaufen Sie eines, wenn Sie es aus anderen Gründen möchten; KI-Fähigkeit ist ein Bonus.
Warum ist lokale KI auf meinem Tablet so langsam?
Meist liegt es an einem von vier Gründen: Das Modell ist zu groß für den freien RAM (das System lagert aus oder beendet die App), die Generierung wird durch die Speicherbandbreite statt durch die Chip-Geschwindigkeit begrenzt, das Tablet drosselt thermisch, oder Hintergrund-Apps belegen Speicher. Abhilfe: wechseln Sie zu einem kleineren Modell oder Q4-Quantisierung, schließen Sie andere Apps, halten Sie das Tablet kühl und am Strom, und messen Sie die reale Geschwindigkeit mit dem integrierten Benchmark von PocketPal AI. Ist ein 3B-Modell immer noch zu langsam, nutzen Sie die Remote-Verbindung zu einem Home-Computer.
Welche Tablets können ein lokales LLM ausführen (iPad Air M3, Einsteiger-iPad, Galaxy Tab A, Huawei MatePad, Xiaomi Pad)?
RAM und Chip entscheiden, nicht die Marke. Das iPad Air M3 (8 GB) bewältigt 1B–3B-Modelle; Einsteiger-iPads und günstige Android-Tablets mit unter 6 GB RAM fassen nur 1B–1,7B-Modelle, für sie ist die Remote-Verbindung die bessere Wahl. Huawei-MatePad- und Xiaomi-Pad-Modelle mit 8 GB oder mehr führen dieselben Apps aus wie andere Android-Tablets, abhängig von deren Verfügbarkeit im jeweiligen App-Store. Prüfen Sie den RAM Ihres Tablets in den Einstellungen und folgen Sie dann der Modelltabelle oben.
Gibt es eine Ollama-App für das iPad?
Es gibt keine offizielle Ollama-App für iPadOS. Es gibt Drittanbieter-Clients für das iPad, die sich mit einem Ollama-Server auf Ihrem Mac oder PC verbinden — zum Beispiel GetOAI und LLLM —, aber sie zeigen nur den Chat an; das Modell läuft weiterhin auf dem Home-Computer. Prüfen Sie jeden App-Store-Eintrag vor der Installation. Der Browser-Weg (Open WebUI in Safari) braucht gar keine App.
Kann ich ein lokales LLM auf einem Android-Tablet ohne Terminal ausführen?
Ja. PocketPal AI (kostenlos, Open-Source, bei Google Play) und Google AI Edge Gallery (kostenlos, Apache 2.0) laden und führen Modelle On-Device ohne Termux aus. Termux + Ollama ist nur nötig, wenn Sie gezielt das Ollama-Ökosystem oder einen lokalen API-Endpoint möchten.
Muss ich bei der Verwendung von lokalen Tablets die DSGVO beachten?
Wenn Sie ein Tablet mit lokalen Modellen für berufliche Kommunikation in Deutschland, Österreich oder der Schweiz verwenden, ja. DSGVO Artikel 28 (Auftragsverarbeitung) und 32 (Datenschutzmassnahmen) erfordern, dass Kundendaten nicht an ungeprüfte Cloud-Services gesendet werden. Lokale Inferenz auf Ihrem Tablet oder Home-Computer erfüllt diese Anforderung. Dokumentieren Sie Ihre Setup-Architektur (wo Daten gespeichert sind, welche Modelle verwendet werden) für den Datenschutzbeauftragten bei auditpflichtigen Prozessen.
Ist ein Tablet mit lokalen Modellen für deutschen Mittelstand geeignet?
Ja. Kleine und mittlere Unternehmen können einen iPad Pro M5 (12 GB / 16 GB) mit Phi-4 Mini oder Llama 3.2 für interne Dokumentenverwaltung, Geschäftskommunikation und Produktbeschreibungen einsetzen. Das Setup ist kostengünstiger als Enterprise-LLM-Dienste, erfüllt DSGVO-Anforderungen ohne externe Anwälte und gibt KMU Zugang zu Fähigkeiten, die sonst große Unternehmen vorbehalten sind. Der BSI empfiehlt diesen Ansatz für Organisationen unter der Datenschutz-Grundverordnung.
Können ältere oder Einsteiger-iPads (iPad 9., 10. oder 11. Generation, iPad mini, iPad Air 5) ein lokales LLM ausführen?
Der RAM entscheidet. Das iPad der 9. Generation (3 GB), das der 10. Generation (4 GB) und das iPad mini 6 (4 GB) sind für sinnvollen Chat auf dem Gerät zu knapp – nutzen Sie hier die Remote-Verbindung. Das iPad der 11. Generation (A16, 6 GB) schafft 1B–1.7B-Modelle in Q4. Das iPad mini 7 (A17 Pro, 8 GB), das iPad Air 5 und das iPad Air M3 (8 GB) schaffen 3B-Modelle in Q4, innerhalb der oben beschriebenen 8-GB-Grenzen. Apple veröffentlicht den RAM nicht für alle diese Modelle; die Angaben sind allgemein berichtet, aber nicht von Apple bestätigt.
Läuft ein lokales LLM auf dem Galaxy Tab S11 Ultra oder dem Galaxy Tab S9 FE?
Das Galaxy Tab S11 Ultra (Dimensity 9400+, je nach Ausführung 12 GB oder 16 GB RAM) liegt über der 8-GB-Schwelle und führt dieselben Apps aus wie das Tab S10+ – PocketPal AI, Google AI Edge Gallery oder Termux + Ollama – mit mehr Spielraum für 3B–4B-Modelle. Das Galaxy Tab S9 FE wird mit 6 GB oder 8 GB verkauft: Die 6-GB-Version schafft nur Qwen3 1.7B, die 8-GB-Version folgt der 8-GB-Zeile der Modelltabelle. Der Exynos 1380 ist ein Mittelklasse-Chip; rechnen Sie mit geringerem Tempo als bei Flaggschiff-Tablets.
Läuft Gemma 4 auf einem Tablet?
Ja, die kleinen Gemma-4-Varianten. Google nennt Gemma 4 E2B und E4B als Größen für den Einsatz auf dem Gerät; bei 4-Bit-Quantisierung gibt Google rund 2,9 GB (E2B) und 4,5 GB (E4B) Speicher für die Gewichte an. E2B ist daher die sicherere Wahl für 8-GB-Tablets, E4B eignet sich eher ab 12 GB. Die App dafür ist Google AI Edge Gallery auf iPad und Android, siehe die Google AI Edge Gallery Review. PromptQuorum hat die Geschwindigkeit von Gemma 4 auf Tablets nicht gemessen.
Welche kostenlosen Apps führen ein lokales LLM auf dem iPad aus?
PocketPal AI (kostenlos, MIT), Google AI Edge Gallery (kostenlos, Apache 2.0) und Locally AI (kostenlos, mit kostenpflichtigen Optionen) führen Modelle ohne Kosten direkt auf dem Gerät aus. Open WebUI in Safari, verbunden mit Ollama auf einem Mac oder PC, ist ebenfalls kostenlos. LLM Farm ist auch kostenlos, muss aber aus dem Quellcode gebaut werden.
Kann ich LLM Farm noch auf dem iPad installieren?
Nicht über den App Store. Apple hat LLM Farm im August 2025 entfernt, und die README des Projekts führt sowohl den App Store als auch TestFlight als vorübergehend nicht verfügbar. Der einzige Weg ist der Bau aus dem Quellcode in Xcode. Das letzte Upstream-Update war am 30. Januar 2026, daher wird das Projekt möglicherweise nicht mehr gepflegt. PocketPal AI und Locally AI sind die installierbaren Alternativen auf dem iPad.