Wichtigste Erkenntnisse
- PocketPal AI ist die beste kostenlose Standard-App. Quelloffen, App-Store-Installation, unterstützt jedes GGUF-Modell von Hugging Face. Führt Phi-4 Mini mit ~10–15 Tokens/Sek. auf dem iPhone 16 Pro aus. Empfohlener Einstiegspunkt für die meisten iPhone-Nutzer.
- Private LLM ist die beste kostenpflichtige Option (5,99 € einmalig, kein Abo). Ein Kauf deckt iPhone, iPad und Mac mit Family Sharing ab. Kuratierte Modellbibliothek, iOS-Shortcuts-Integration und Siri-Unterstützung ("Hey Siri, ask Private LLM").
- Locally AI ist die kostenlose MLX-basierte Alternative, jetzt vom LM-Studio-Team entwickelt. Führt Llama-, Gemma-, Qwen- und DeepSeek-Modelle auf Apple MLX aus, unterstützt iOS Shortcuts und kann Apples eigenes On-Device-Foundation-Modell als Chat-Interface nutzbar machen.
- MLC Chat ist Metal-beschleunigt, aber inaktiv. Die MLC-LLM-Engine erzeugt weiterhin ~25–35 % mehr Tokens/Sek. als llama.cpp-basierte Apps auf gleicher Hardware, doch die App wurde seit Ende 2024 nicht aktualisiert – ihre Modellbibliothek liegt vor Phi-4 Mini und Gemma 3.
- LLM Farm wurde im August 2025 aus dem App Store entfernt. Die eigene README beschreibt die App als „vorübergehend nicht verfügbar". Sie bleibt quelloffen und über Xcode aus dem Quellcode baubar und ist weiterhin die konfigurierbarste Option (Mirostat, Chat-Templates) für Entwickler.
- Apple Intelligence ist On-Device-KI, aber keine eigenständige App. Apples ~3B-Foundation-Modell treibt Systemfunktionen an (Schreibwerkzeuge, Smart Reply, Benachrichtigungs-Zusammenfassungen). Seit iOS 26 können Drittanbieter-Apps es über das Foundation-Models-Framework aufrufen, und Shortcuts kann es über die Aktion „Modell verwenden" ansprechen.
- Empfohlenes Modell für iPhone 16 Pro / 17 Pro: Phi-4 Mini (3,8B Q4_K_M, ~2,7 GB). Bestes Verhältnis aus Qualität und Geschwindigkeit für die 8-GB+-RAM-Klasse. Ältere iPhones mit 6 GB RAM (iPhone 14 Pro): Qwen3 1.7B oder SmolLM 2 1.7B.
Kurzübersicht
- Verglichene Apps: PocketPal AI, Private LLM, Locally AI (von LM Studio), MLC Chat, Apple Intelligence (System) – sowie LLM Farm, im August 2025 aus dem App Store entfernt.
- Testgeräte: iPhone 16 Pro (A18 Pro, 8 GB RAM) und iPhone 17 Pro (A19 Pro, 12 GB RAM).
- Inference-Engines: llama.cpp (PocketPal AI, LLM Farm), Apple MLX (Locally AI), MLC LLM mit Metal (MLC Chat), proprietäres On-Device-Runtime (Private LLM, Apple Intelligence).
- Mindest-iPhone für 3B+-Modelle: iPhone 14 Pro (A16, 6 GB RAM) für 1.7B; jedes 8-GB+-iPhone (15 Pro, 16er-Serie, 16e, 17er-Serie) für 3B–4B.
- Beste kostenlose App: PocketPal AI – App Store, quelloffen, Modellflexibilität.
- Beste kostenpflichtige App: Private LLM – 5,99 € einmalig (iPhone + iPad + Mac), Shortcuts + Siri-Unterstützung.
- Offline: Alle fünf laufen vollständig offline, sobald das Modell heruntergeladen ist – keine Cloud-Verbindung erforderlich.
Welche iPhone-App sollte ich zuerst installieren?
Für die meisten Nutzer: PocketPal AI aus dem App Store, dann Phi-4 Mini (3,8B Q4_K_M) herunterladen. Diese Kombination funktioniert auf iPhone 14 Pro und neueren Modellen, ist kostenlos und liefert brauchbare Ergebnisse für alltäglichen Chat, Zusammenfassungen und schnelles Schreiben. Wählen Sie eine andere App nur, wenn Sie einen spezifischen Bedarf haben, den PocketPal AI nicht abdeckt.
📍 In einem Satz
Für die meisten iPhone-Nutzer 2026 gilt: PocketPal AI (kostenlos, App Store) installieren und Phi-4 Mini herunterladen – damit sind alltäglicher Chat, Zusammenfassungen und Textentwürfe auf jedem iPhone mit 6 GB+ RAM abgedeckt.
💬 In einfachen Worten
Fünf iPhone-Apps führen KI 2026 vollständig auf dem Gerät aus. PocketPal AI ist der beste kostenlose Einstiegspunkt: einmal installieren, eine 2,7-GB-Modelldatei herunterladen, und Sie haben einen privaten Chat-Assistenten, der auch in der U-Bahn ohne WLAN funktioniert. Private LLM ist die kostenpflichtige Option, wenn Siri mit dem lokalen Modell sprechen soll. Locally AI vom LM-Studio-Team ist die kostenlose moderne Alternative mit Shortcuts-Unterstützung. MLC Chat ist schnell, wird aber nicht mehr aktualisiert. Apple Intelligence ist in iOS integriert, aber keine Chat-App. PocketPal AI deckt 90 % der Anwendungsfälle ab.
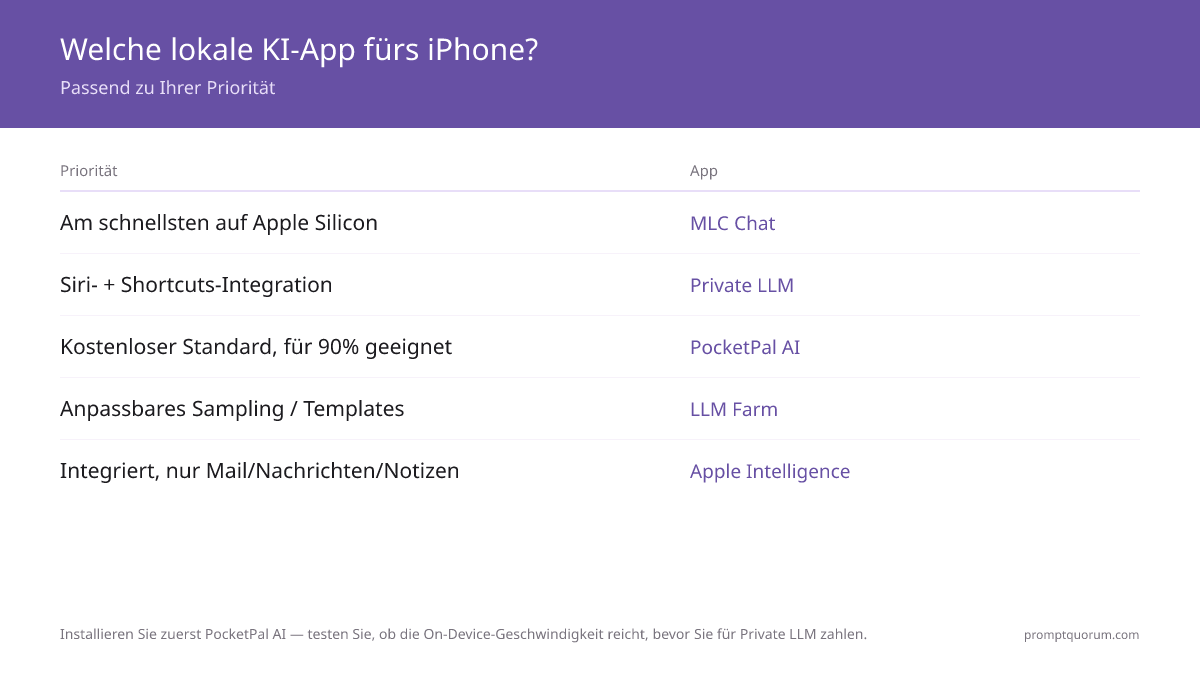
Entscheidungshilfe: Welche iPhone-Local-KI-App?
Lokales LLM nutzen, wenn:
- •Sie möchten eine kostenlose Chat-KI, die offline funktioniert → PocketPal AI
- •Sie möchten, dass Siri mit Ihrem lokalen Modell spricht → Private LLM
- •Sie möchten eine kostenlose MLX-App mit Shortcuts und Zugriff auf Apple Foundation Models → Locally AI
- •Sie akzeptieren eine ältere Modellbibliothek für maximale Metal-Geschwindigkeit → MLC Chat
- •Sie benötigen nur Schreibhilfe in Mail / Nachrichten / Notizen → Apple Intelligence (integriert)
Cloud-Modell nutzen, wenn:
- •Sie benötigen 70B+-Modellqualität (Llama 3.3 70B, GPT-5.5-Niveau) → Cloud oder Remote-Verbindung zu einem Heimrechner
- •Sie benötigen speziell GPT-5.5, Claude Opus oder Gemini → Cloud-Apps (diese sind lokal nicht verfügbar)
- •Sie benötigen Echtzeit-Vision oder multimodale Ausgabe über Text hinaus → Cloud (On-Device-Multimodal ist 2026 begrenzt)
Schnelle Entscheidung:
- →Kostenlos + funktioniert für 90 % der Nutzer: PocketPal AI
- →Kostenpflichtig + iOS-native Integration: Private LLM
- →Kostenlos + LM-Studio-Ökosystem: Locally AI

💡Tipp: Installieren Sie zuerst PocketPal AI, auch wenn Sie später für Private LLM bezahlen möchten. Testen Sie damit, ob die On-Device-Inferenz auf Ihrem iPhone schnell genug für Ihren Anwendungsfall ist. Wenn ja, entscheiden Sie, ob die iOS-Shortcuts- und Siri-Integration von Private LLM die 5,99 € wert ist. Wenn nein, haben Sie die 5,99 € gespart, bevor Sie gezahlt haben.
iPhone-App-Vergleichstabelle
Die fünf Apps unterscheiden sich in drei Dimensionen, die für die meisten Nutzer entscheidend sind: Kosten, Modellflexibilität und iOS-Integration. Geschwindigkeitsunterschiede existieren, sind aber geringer als der Abstand zwischen diesen Apps und einem Cloud-LLM.
📍 In einem Satz
PocketPal AI ist die beste kostenlose Standard-App, Private LLM die beste kostenpflichtige Option, Locally AI die kostenlose MLX-Wahl vom LM-Studio-Team, MLC Chat Metal-schnell, aber inaktiv, und Apple Intelligence systemintegriert.
💬 In einfachen Worten
Die Wahl hängt meist von drei Faktoren ab: Möchten Sie für Siri-Integration zahlen (Private LLM), möchten Sie das LM-Studio-Ökosystem mit Shortcuts kostenlos (Locally AI), oder möchten Sie maximale Rohgeschwindigkeit und akzeptieren eine ältere Modellbibliothek (MLC Chat)? Für alles andere ist PocketPal AI die Standardwahl. Die Werte in der Tabelle gelten für Q4_K_M-Quantisierung – der Standard für mobile Inferenz 2026.
App | Preis | Tokens/Sek. (Phi-4 Mini, 16 Pro) | Datenschutz | Am besten geeignet für |
|---|---|---|---|---|
| PocketPal AI | Kostenlos (Open Source) | ~10–15 | Nur lokal, keine Telemetrie | Kostenlose Standard-App für die meisten Nutzer |
| Private LLM | 5,99 € einmalig | ~10–14 | Nur lokal, opt-in Analysen | iOS Shortcuts + Siri-Integration |
| Locally AI | Kostenlos (LM-Studio-Team) | k. A. – MLX-Katalog (kein Phi-4) | Nur lokal, keine Datenerhebung | MLX + Shortcuts, LM-Studio-Anbindung |
| MLC Chat | Kostenlos (Open Source) | k. A. – Bibliothek vor Phi-4 | Nur lokal, keine Telemetrie | Metal-Geschwindigkeit, ältere Modelle |
| LLM Farm | Kostenlos (nur Quellcode) | ~10–15 | Nur lokal, keine Telemetrie | Power-User (App Store entfernt) |
| Apple Intelligence | Kostenlos (in iOS integriert) | k. A. (Systemfunktion) | Lokal + opt-in Private Cloud Compute | Hilfe in Mail, Nachrichten, Notizen |
Hinweis zur Apple Neural Engine (ANE) im Vergleich zu Metal und MLX: PocketPal AI und LLM Farm verwenden llama.cpp mit Metal Performance Shadern, die auf der GPU laufen. MLC Chat verwendet MLC LLM mit tieferer Metal-Optimierung und erreicht auf gleicher Hardware 25–35 % mehr Tokens/Sek. für die Modelle, die es unterstützt. Locally AI nutzt Apple MLX, Apples eigenes Open-Source-Array-Framework, das eine vergleichbare GPU-Effizienz auf Apple Silicon erreicht. Apple Intelligence nutzt die ANE speziell für das systemintegrierte ~3B-Modell – energieeffizienter, aber weniger flexibel als Metal-basierte Inferenz. Seit iOS 26 können Drittanbieter-Apps dieses Systemmodell über das Foundation-Models-Framework aufrufen – genau das tut Locally AI –, aber eigene GGUF/MLX-Modelle können die ANE weiterhin nicht direkt ansprechen.

💡Tipp: Die Tokens/Sek.-Werte gelten für Q4_K_M-Quantisierung (der Standard für mobile Inferenz 2026) und ein inaktives iPhone ohne andere ressourcenintensive Apps. Hintergrund-Apps reduzieren den Durchsatz um 10–30 %. Auf dem iPhone 17 Pro sind die Tokens/Sek. dank A19-Pro-Verbesserungen etwa 20–30 % höher als auf dem iPhone 16 Pro.
PocketPal AI: Kostenlose Open-Source-Standardlösung
PocketPal AI ist der empfohlene Einstiegspunkt für die meisten iPhone-Nutzer 2026. Die App ist kostenlos, quelloffen (GitHub: a-ghorbani/pocketpal-ai), im App Store verfügbar und unterstützt jedes GGUF-Modell von Hugging Face. Unter der Haube verwendet sie llama.cpp mit Apple-Silicon-Optimierungen.
- Was sie ist: eine iOS-App, die GGUF-Modelle lokal mit llama.cpp ausführt. Kein Abo, keine Telemetrie, kein Konto erforderlich.
- Installation: App Store → „PocketPal AI". Kostenloser Download.
- Modell hinzufügen: In der App auf „Modelle" tippen → „Von Hugging Face hinzufügen" → suchen (z. B. „phi-4-mini-instruct-Q4_K_M") → zum Herunterladen tippen. Das Modell wird im lokalen Speicher der App gespeichert (~2,7 GB für Phi-4 Mini Q4).
- Generierungsgeschwindigkeit (iPhone 16 Pro): Phi-4 Mini ~10–15 Tokens/Sek., Llama 3.2 3B ~12–18 Tokens/Sek., Gemma 3 4B ~7–10 Tokens/Sek., Qwen3 1.7B ~18–24 Tokens/Sek.
- Am besten geeignet für: Nutzer, die eine kostenlose, App-Store-installierbare Chat-App ohne Konto wünschen, die jedes Community-GGUF-Modell unterstützt.
💡Tipp: Die Modellauswahl in PocketPal AI hat einen „Empfohlen"-Filter, der Modelle anzeigt, die nachweislich in den RAM Ihres Geräts passen. Für ein iPhone 16 Pro (8 GB RAM) empfiehlt der Filter Q4_K_M-Varianten von Modellen bis ~4B Parameter. Vertrauen Sie diesem Filter – ein zu großes Modell führt dazu, dass iOS die App mitten in der Antwort beendet.
Private LLM: Kostenpflichtige Option mit iOS-Integration
Private LLM ist die stärkste kostenpflichtige iPhone-Option 2026 (5,99 € einmalig, kein Abo). Die App ist nur über den App Store erhältlich und enthält eine kuratierte Bibliothek optimierter Modelle. Ihr Alleinstellungsmerkmal ist die iOS-Integration: Shortcuts-Aktionen und der Sprach-Trigger „Hey Siri, ask Private LLM".
- Was sie ist: eine kostenpflichtige iOS-App mit kuratierter Modellbibliothek und tiefer iOS-Integration. Verwendet ein proprietäres On-Device-Runtime, das für Apple Silicon optimiert ist.
- Installation: App Store → „Private LLM". Einmaliger Kauf 5,99 € (kein Abo).
- Kuratierte Modellbibliothek: ~30 Modelle, vorgetestet und für iPhone optimiert, darunter Llama 3.2 3B, Phi-4 Mini, Mistral Small Instruct und mehrere ungefilterte Varianten. Weniger flexibel als PocketPal AI, aber kein Risiko, ein Modell zu installieren, das abstürzt.
- iOS Shortcuts: Private LLM stellt eine Shortcuts-Aktion „Text mit Private LLM generieren" bereit, die in Automatisierungen eingebunden werden kann. Nützlich, um lokale KI per Schaltfläche auf dem Home-Bildschirm oder per NFC-Tag auszulösen.
- Siri-Integration: „Hey Siri, ask Private LLM [Ihre Frage]" leitet den Prompt an das On-Device-Modell weiter und Siri liest die Antwort vor – ohne Internetverbindung. Die Latenz ist höher als im Chat-UI (~3–5 Sekunden bis Audio beginnt).
💡Tipp: Private LLM ist ein universeller Kauf: Der Einmalpreis von 5,99 € deckt iPhone, iPad und Mac in einem Kauf ab, und Apple Family Sharing erweitert dies auf bis zu sechs Familienmitglieder. Kein Abo, keine In-App-Käufe – der angezeigte Preis ist der Gesamtpreis.
Locally AI: Kostenlose MLX-App von LM Studio
Locally AI ist eine kostenlose, datenschutzfokussierte Chat-App, die inzwischen vom LM-Studio-Team entwickelt wird und auf Apples eigenem MLX-Framework statt auf llama.cpp basiert. Sie ist der neueste ernstzunehmende Zugang in dieser Kategorie und die einzige App hier, die Apples On-Device-Foundation-Modell als Chat-Interface bereitstellt.
- Was sie ist: eine iOS-/iPadOS-/macOS-App, die Apple MLX für Inferenz nutzt, entwickelt vom Team hinter der Desktop-App LM Studio.
- Installation: App Store → „Locally AI". Kostenlos, kein Konto erforderlich, 100 % offline.
- Modellbibliothek: Llama 3.2, Gemma 2/3/4, Qwen 3, DeepSeek, LFM 2.5, Bonsai, Ministral 3 und Apple Foundation Models – ein breiterer und aktuellerer Katalog als bei MLC Chat.
- iOS Shortcuts: bietet eine Shortcuts-Aktion – gleichwertig zur Automatisierungsunterstützung von Private LLM, aber kostenlos.
- LM Link: eine optionale Funktion, die per Ende-zu-Ende-verschlüsselter Verbindung mit LM Studio auf einem Mac verbindet und so bei Bedarf auf ein größeres Modell auf einem Heimrechner zugreift.
- Voraussetzungen: iOS/iPadOS 18.1+ (die Effizienzvorteile von Apple Silicon zeigen sich am stärksten ab iPhone 15 Pro).
💡Tipp: Locally AI ist die einzige App in diesem Leitfaden, die Apples eigenes On-Device-Foundation-Modell hinter ein normales Chat-Fenster stellen kann – nützlich, um zu testen, was das Modell von Apple Intelligence kann, ohne durch Schreibwerkzeuge-Menüs zu navigieren. Für Drittanbieter-GGUF-Flexibilität hat PocketPal AI weiterhin den größeren Modellkatalog.
MLC Chat: Apple-Silicon-Optimierung
MLC Chat (aus dem MLC-LLM-Projekt) bleibt die Metal-Referenz-App auf dem iPhone, wurde aber selbst seit Ende 2024 nicht mehr aktualisiert. Sie ist kostenlos, quelloffen und führt Modelle aus, die mit der MLC-LLM-Toolchain kompiliert wurden – kein Standard-GGUF. Genau diese Kompilierungspflicht ist auch der Grund, warum ihr Katalog nicht mit PocketPal AI oder Locally AI mithalten konnte.
- Was sie ist: die iOS-Referenz-App des MLC-LLM-Projekts, die die Metal-beschleunigte Inferenz von MLC LLM auf Apple Silicon demonstriert.
- Installation: App Store → „MLC Chat". Kostenlos.
- Geschwindigkeitsvorteil (auf Architekturebene): Die Metal-beschleunigte Engine von MLC LLM erzeugt ~25–35 % mehr Tokens/Sek. als llama.cpp-basierte Apps auf demselben iPhone – für Modelle, die beide unterstützen. Da die eigene Modellliste der App aber vor aktuellen Empfehlungen wie Phi-4 Mini und Gemma 3 liegt, lässt sich dieser Vorteil ohne selbst kompilierten Build 2026 nicht mehr testen.
- Modellbibliothek: beschränkt auf Modelle, die das MLC-LLM-Projekt vor der App-Stagnation kompiliert hat – Llama 3.2 3B, RedPajama und ähnliche Modelle aus 2024. Nicht jedes Hugging-Face-GGUF funktioniert, und kein aktuelles kleines Modell ist im App-Store-Build enthalten.
- Am besten geeignet für: Entwickler, die bereits in die MLC-LLM-Toolchain investiert haben und bereit sind, ein eigenes Modell zu kompilieren, oder die gezielt eines der bereits enthaltenen Modelle aus der Zeit vor 2025 benötigen.
⚠️Warnung: Da der App-Store-Build von MLC Chat seit Ende 2024 nicht aktualisiert wurde, erwarten Sie in der Modellauswahl keine Phi-4 Mini, Qwen3 oder Gemma 3. Wer heute aktuelle Modelle mit Metal-Klasse-GPU-Effizienz möchte, findet in Locally AI (Apple MLX) oder PocketPal AI (llama.cpp mit Metal Performance Shadern) aktiv gepflegte Alternativen.
LLM Farm: Entfernt, aber weiter konfigurierbar
LLM Farm wurde im August 2025 aus dem App Store und TestFlight entfernt – die eigene GitHub-README beschreibt die App auf beiden Plattformen als „vorübergehend nicht verfügbar". Das Projekt (GitHub: guinmoon/LLMFarm) bleibt quelloffen und verzeichnete bis 2026 GitHub-Issue-Aktivität, aber neue Nutzer können es nicht mehr über den App Store installieren; es muss per Xcode aus dem Quellcode gebaut werden.
- Was sie ist: eine iOS-App von Entwickler @guinmoon, die GGUF-Modelle mit umfangreichen Konfigurationsmöglichkeiten ausführt und zuvor über den App Store vertrieben wurde.
- Aktuelle Verfügbarkeit: zum Zeitpunkt dieses Updates weder über den App Store noch TestFlight installierbar. Der Quellcode bleibt öffentlich und baubar.
- Aus Quellcode bauen: Repository klonen, in Xcode öffnen und mit einem kostenlosen oder kostenpflichtigen Apple-Developer-Konto auf ein Gerät bauen – der Standard-Sideloading-Workflow für jede Open-Source-iOS-App ohne App-Store-Eintrag.
- Freigegebene Einstellungen (nach dem Bauen): Temperatur, Top-p, Top-k, Mirostat-Sampling, Wiederholungsstrafe, System-Prompt je Modell, Chat-Template-Auswahl, Kontextfensterlänge.
- Am besten geeignet für: Entwickler, die mit dem Bauen einer App aus dem Quellcode in Xcode vertraut sind und gezielt Mirostat-Sampling-Kontrollen möchten. Alle anderen sollten PocketPal AI oder Locally AI verwenden – beide vollständig über den App Store installierbar und kostenlos.
⚠️Warnung: Verlassen Sie sich nicht auf einen App-Store-Link zu LLM Farm – ein solcher Link ist als veraltet zu behandeln. Das Bauen aus dem Quellcode erfordert Xcode und Grundkenntnisse in iOS-Codesignierung. Wenn das mehr Aufwand ist, als Sie möchten, deckt PocketPal AI denselben Anwendungsfall „flexible kostenlose Chat-App" ab, ohne den App Store zu verlassen.
Apple Intelligence: Systemintegrierte On-Device-KI
Apple Intelligence führt Apples eigenes ~3B-Foundation-Modell auf dem Gerät aus – auf iPhone 15 Pro und neueren Modellen (A17-Pro-Chip, mindestens 8 GB RAM). Standardmäßig ist es keine Chat-App – es treibt Systemfunktionen in Mail (Smart Reply), Nachrichten (Schreibwerkzeuge), Notizen (Zusammenfassung) und Benachrichtigungs-Zusammenfassungen an. Seit iOS 26 können Drittanbieter über Apples Foundation-Models-Framework direkt auf dieses On-Device-Modell zugreifen, und Apps wie Locally AI nutzen dies bereits für ein echtes Chat-Interface.
- Wo es zu finden ist: integriert in iOS 18+ (Foundation-Models-Framework seit iOS 26). Aktivieren Sie es unter Einstellungen → Apple Intelligence & Siri.
- Hardware-Anforderung: iPhone 15 Pro / 15 Pro Max, iPhone-16-Serie, iPhone 16e, iPhone-17-Serie. Ältere iPhones (14 und älter) unterstützen Apple Intelligence nicht.
- On-Device-Funktionen: Schreibwerkzeuge (Umschreiben, Zusammenfassen, Korrekturlesen) in jedem Textfeld, Smart Reply in Mail und Nachrichten, Benachrichtigungs-Zusammenfassungen, Genmoji-Generierung.
- Foundation-Models-Framework (ab iOS 26): eine native Swift-API, die Entwicklern mit wenigen Zeilen Code direkten Zugriff auf dasselbe On-Device-Modell gibt – so macht Locally AI es als Chat-Option zugänglich, und so kann die Shortcuts-Aktion „Modell verwenden" einen Prompt an dieses Modell, an Private Cloud Compute oder an ChatGPT weiterleiten.
- Private Cloud Compute: Für Aufgaben, die das On-Device-Modell übersteigen, greift Apple Intelligence auf Private Cloud Compute (PCC) zurück – von Apple betriebene Server mit größeren Modellen und kryptografischen Garantien, dass keine Nutzerdaten gespeichert werden. PCC ist opt-in und kann deaktiviert werden.
- Verhältnis zu Chat-Apps: Apple Intelligence ist eine Ergänzung, kein Ersatz. Die Systemfunktionen übernehmen Textumschreibung und Zusammenfassung innerhalb von iOS-Apps; PocketPal AI, Private LLM, Locally AI und MLC Chat bieten ein eigenständiges Chat-Interface für beliebige Fragen – und Locally AI kann inzwischen genau ein solches Interface auch für Apples eigenes Modell bereitstellen.
💡Tipp: Wenn Apple Intelligence Ihr einziger Bedarf ist (E-Mails umschreiben, Benachrichtigungen zusammenfassen), benötigen Sie keine separate Chat-App. Wenn Sie dem Modell Fragen stellen möchten – etwa „Erkläre Quantentunneln einfach" oder „Erstelle einen Projektplan für X" –, installieren Sie eine Chat-App: entweder eine dedizierte wie PocketPal AI, oder Locally AI, das Apples eigenes On-Device-Modell mit einem Chat-Fenster versehen kann.
Modelle nach iPhone-Modell
Der iPhone-RAM bestimmt die Modellgröße – nicht die Chip-Generation. Ein 6-GB-iPhone (14 Pro, 15) kann 1,7B-Modelle komfortabel ausführen; ein 8-GB+-iPhone (15 Pro, 16er-Serie, 16e, 17er-Serie) führt 3B–4B-Modelle komfortabel und 7B-Modelle langsam aus. Für den umfassenderen Überblick über Modelle auf allen Hardware-Klassen (nicht nur Mobilgeräte) siehe Die besten lokalen LLMs 2026.
iPhone-Modell (Jahr, RAM) | Empfohlenes Modell | Download-Größe | Erwartete Geschwindigkeit |
|---|---|---|---|
| iPhone 17 Pro (2025, 12 GB) | Phi-4 Mini oder Llama 3.2 3B (Q4_K_M) | ~2,5–2,7 GB | ~13–20 Tokens/Sek. |
| iPhone 16 Pro / 16 Pro Max / 16e (2024–2025, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2,7 GB | ~10–15 Tokens/Sek. |
| iPhone 15 Pro / Pro Max (2023, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2,7 GB | ~8–12 Tokens/Sek. |
| iPhone 14 Pro / Pro Max (2022, 6 GB) | Qwen3 1.7B oder SmolLM 2 1.7B (Q4_K_M) | ~1,1 GB | ~15–20 Tokens/Sek. |
| iPhone 14 / 15 / 16 (nicht Pro, 6 GB) | Qwen3 1.7B oder SmolLM 2 1.7B (Q4_K_M) | ~1,1 GB | ~12–18 Tokens/Sek. |
| iPhone SE / ältere Modelle (4 GB) | Für On-Device-LLM nicht empfohlen | — | — |

💡Tipp: Für ältere iPhones mit 6 GB RAM ist Qwen3 1.7B 2026 das beste Verhältnis aus Modellgröße und Qualität. SmolLM 2 1.7B (HuggingFace) ist vergleichbar. Beide erzeugen kohärente Kurzantworten (1–3 Absätze), haben aber Schwierigkeiten bei mehrstufigem Schlussfolgern. Installieren Sie Phi-4 Mini nicht auf einem 6-GB-iPhone – es passt nominell, aber iOS beendet die App unter Speicherdruck.
Akkuverbrauch und thermisches Throttling
On-Device-LLM-Inferenz auf dem iPhone ist CPU/GPU-intensiv und erzeugt Wärme. Aktive Inferenz (Modell generiert Tokens) verbraucht ~3–5 W; anhaltende Generierung drosselt den Chip und entlädt den Akku auf dem iPhone 16 Pro um ca. 20–30 % pro Stunde.
- Akkuverbrauch (aktiver Chat): ~20–30 % pro Stunde auf dem iPhone 16 Pro mit Phi-4 Mini. Das iPhone 17 Pro entlädt sich bei höherer Spitzenleistung geringfügig schneller, gleicht dies aber durch schnellere Fertigstellung des Workloads aus.
- Thermisches Throttling setzt nach ~10–15 Minuten Dauergenerierung ein. Wenn der Chip ~38 °C Oberflächentemperatur erreicht, reduziert iOS die Taktfrequenz, was die Tokens/Sek. um 30–50 % senkt. Abkühlen stellt die volle Geschwindigkeit wieder her.
- Gegenmaßnahme: Halten Sie das iPhone während längerer Inferenzsitzungen mit der Vorderseite nach oben auf einer harten Oberfläche (nicht in der Hand oder Tasche), um die Wärmeabgabe zu verbessern. Ein passiver Kühlaufsatz hilft, ist aber bei kurzen Interaktionen kaum nötig.
- Phantom-Verbrauch: Wenn Sie eine Chat-App nach der Generierung im Hintergrund geöffnet lassen, bleibt RAM belegt, aber keine Inferenz läuft – der Akkueinfluss ist minimal. Vollständiges Schließen der App gibt die ~3 GB RAM wieder frei.
- MagSafe-Laden während der Inferenz: Auf iPhone 17 Pro und 16 Pro (beide mit verbessertem Thermaldesign) unbedenklich. Auf dem iPhone 15 Pro kann die Kombination aus Laden und Inferenz die thermischen Grenzen schneller erreichen – besser danach laden.

⚠️Warnung: Führen Sie On-Device-LLM-Inferenz auf einem iPhone nicht im direkten Sonnenlicht oder in einem heißen Auto aus. Die Kombination aus Umgebungshitze und Inferenz-Workload überschreitet die thermischen Grenzen des Chips innerhalb von Minuten, löst aggressives Throttling aus und kann die Meldung „iPhone muss sich abkühlen" auslösen. Die Chat-App stürzt nicht ab, aber die Generierung wird extrem langsam.
iOS Shortcuts, Siri und Sideloading
Die iOS-Integration unterscheidet sich je nach App erheblich. Private LLM und Locally AI bieten beide Shortcuts-Aktionen; PocketPal AI und MLC Chat sind eigenständige Chat-Apps ohne Shortcuts-Aktionen (Stand 2026).
Private-LLM-Shortcut: Ausgewählten Text zusammenfassen
“1. Aktion: „Ausgewählten Text abrufen" (iOS-Share-Sheet-Eingabe). 2. Aktion: „Text mit Private LLM generieren" → Prompt: „Fasse den folgenden Text in drei Stichpunkten zusammen: [Ausgewählter Text]" → Modell: Phi-4 Mini. 3. Aktion: „Ergebnis anzeigen" oder „In Zwischenablage kopieren". Zum Share Sheet hinzufügen, damit Sie es für beliebigen Text in jeder App vollständig offline ausführen können.”
Apple-Intelligence-Shortcut: Ton anpassen
“1. Aktion: „Zwischenablage abrufen". 2. Aktion: „Modell verwenden" → Modell: On-device → Prompt: „Schreibe dies in einem professionellen, präzisen Ton um: [Zwischenablage]". 3. Aktion: „In Zwischenablage kopieren". Einem Sperrbildschirm-Widget zuweisen, um alles, was Sie kopieren, mit einem Tipp umzuschreiben.”
- Private LLM bietet eine Shortcuts-Aktion „Text mit Private LLM generieren" und einen Sprach-Trigger „Hey Siri, ask Private LLM [Frage]". Die iOS-nativste der kostenpflichtigen Chat-Apps.
- Locally AI bietet kostenlos eine Shortcuts-Aktion und kann einen Shortcut über die Foundation-Models-Integration an Apples eigenes On-Device-Modell weiterleiten – kein Sprach-Trigger, aber Shortcuts-Automatisierung ohne Bezahlung.
- PocketPal AI ist eine eigenständige Chat-App – keine Shortcuts-Aktion, keine Siri-Integration. Sie öffnen die App und chatten. Pläne für Shortcuts-Unterstützung werden in den GitHub-Issues verfolgt, sind aber nicht veröffentlicht.
- MLC Chat ist eine Referenz-App für das MLC-LLM-Projekt – minimale iOS-Integration und seit Ende 2024 kein Update. Keine Shortcuts-Aktion.
- LLM Farm ist aus dem App Store entfernt (August 2025) und hat, aus Quellcode gebaut, keine Shortcuts-Aktion.
- Apple Intelligence integriert sich über die Aktion „Modell verwenden" (iOS 18.4+, seit iOS 26 zusammen mit dem Foundation-Models-Framework erweitert) in iOS Shortcuts. Diese leitet einen Prompt an das On-Device-Modell, Private Cloud Compute oder ChatGPT (konfigurierbar) weiter. Die On-Device-Ausgabe kann in weitere Shortcuts-Aktionen eingebunden werden.
- Sideloading: PocketPal AI, Private LLM, Locally AI und MLC Chat sind im App Store und erfordern kein Sideloading oder Jailbreak; Apple Intelligence ist in iOS integriert. LLM Farm ist die Ausnahme – die Installation erfordert nun das Bauen aus dem Quellcode in Xcode. EU-Nutzer können App-Store-Apps unter dem DMA 2026 auch über alternative Marktplätze installieren, aber die App selbst ist identisch.

💡Tipp: Für die freihändige Nutzung beim Fahren oder Kochen ist „Hey Siri, ask Private LLM" von Private LLM die einzige On-Device-Option, die ohne Berühren des Telefons funktioniert. Apple Intelligence unterstützt Sprache über Siri, aber nur für Systemaufgaben (Schreiben, Zusammenfassen, App-Aktionen) – allgemeine Fragen wie bei den Chat-Apps sind nicht möglich.
Häufige Fehler
- Ein Modell installieren, das größer ist als der iPhone-RAM erlaubt. Ein 7B-Modell auf einem 8-GB-iPhone läuft mit ~3–5 Tokens/Sek. und stürzt ab, wenn iOS Arbeitsspeicher für eine andere App beansprucht. Verwenden Sie das empfohlene Modell für Ihre iPhone-Klasse (3B–4B für 8-GB-Geräte, 1,7B für 6-GB-Geräte).
- Cloud-KI-Qualität von On-Device-Modellen erwarten. Phi-4 Mini (3,8B) ist für seine Größe beeindruckend, aber kein GPT-5.5. Verwenden Sie es für Chat, Zusammenfassungen, Textentwürfe und schnelle Fragen – nicht für mehrstufiges Schlussfolgern, komplexe Code-Generierung oder nuanciertes kreatives Schreiben.
- Inferenz im direkten Sonnenlicht oder in einem heißen Auto ausführen. Thermisches Throttling setzt innerhalb von Minuten ein. Die Generierung verlangsamt sich um 30–50 %, und die Meldung „iPhone muss sich abkühlen" kann erscheinen. Führen Sie Inferenz bei Raumtemperatur aus.
- 3+ Chat-Apps mit je 3-GB-Modellen installiert lassen. Sie verbrauchen ~10 GB Speicher mit duplizierten Modellen. Entscheiden Sie sich für eine App und ein Modell; deinstallieren Sie die anderen, bis Sie sicher sind, dass Sie sie benötigen.
- Annehmen, Apple Intelligence habe überhaupt kein Chat-Interface. Das stimmte bis iOS 18, aber seit iOS 26 können Apps wie Locally AI Apples On-Device-Modell über das Foundation-Models-Framework mit einem echten Chat-Fenster versehen. Die Systemfunktionen (Schreibwerkzeuge, Smart Reply) sind für sich genommen weiterhin keine Chat-UI.
- LLM Farm im App Store suchen. Die App wurde im August 2025 entfernt. Die Suche im App Store danach ist Zeitverschwendung; verwenden Sie PocketPal AI für denselben freien/flexiblen Anwendungsfall, oder bauen Sie LLM Farm aus dem Quellcode in Xcode, wenn Sie speziell die Mirostat-Kontrollen benötigen.
Quellen
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai (Open-Source-iOS-App).
- Private LLM — App-Store-Eintrag und Entwicklerdokumentation.
- Locally AI — App-Store-Eintrag (LM-Studio-Team, basiert auf Apple MLX).
- MLC Chat / MLC-LLM-Projekt — llm.mlc.ai (Metal-beschleunigte iOS-Bereitstellung).
- LLM Farm — github.com/guinmoon/LLMFarm (Open-Source-iOS-App; App-Store-/TestFlight-Eintrag laut Projekt-README vorübergehend nicht verfügbar).
- Apple Intelligence und On-Device-Foundation-Modelle — Apple Machine Learning Research und Apple-Entwicklerdokumentation (Foundation-Models-Framework, eingeführt mit iOS 26).
Häufig gestellte Fragen
Kann das iPhone wirklich ein 7B-Modell ausführen?
Technisch ja auf iPhone 15 Pro und neueren Modellen (8 GB RAM), aber nicht mit nutzbarer Geschwindigkeit. Ein 7B-Q4-Modell auf dem iPhone 16 Pro generiert mit ~3–5 Tokens/Sek. – für den Chat frustrierend. iOS neigt auch dazu, die App zu beenden, wenn andere Apps Arbeitsspeicher benötigen. Verwenden Sie 3B–4B-Modelle (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) für den alltäglichen On-Device-Chat. Für 7B+-Qualität verbinden Sie sich remote mit einem Mac oder PC zu Hause, auf dem Ollama läuft.
Entlädt lokale KI meinen iPhone-Akku?
Ja – aktive Inferenz verbraucht ~3–5 W und entlädt den Akku auf dem iPhone 16 Pro um ca. 20–30 % pro Stunde. Bei gelegentlichem Chat (wenige Prompts) ist der Einfluss gering. Bei dauerhafter Nutzung (langes Gespräch, mehrere Zusammenfassungsaufgaben) schließen Sie das iPhone an. Das Modell selbst im RAM ohne laufende Inferenz hat vernachlässigbaren Akkueinfluss.
Wird mein iPhone bei lokaler KI heiß?
Ja, nach etwa 10–15 Minuten Dauergenerierung. Die Chipoberfläche erreicht ~38 °C und iOS drosselt die Taktfrequenz, was die Tokens/Sek. um 30–50 % senkt. Um dies zu minimieren: Halten Sie das iPhone bei langen Sitzungen mit der Vorderseite nach oben auf einer harten Oberfläche (nicht in der Hand) und vermeiden Sie direktes Sonnenlicht. Kurze Interaktionen (unter 5 Minuten) erzeugen selten spürbare Wärme.
Kann ich Siri mit einem lokalen Modell verwenden?
Ja, mit Private LLM (5,99 € einmalig). „Hey Siri, ask Private LLM [Frage]" leitet den Prompt an das On-Device-Modell weiter und Siri liest die Antwort vor – vollständig offline. PocketPal AI, Locally AI und MLC Chat haben 2026 keine Sprach-Integration mit Siri, wobei Locally AI Shortcuts-Automatisierung unterstützt. Apple Intelligence integriert sich in Siri, aber nur für Systemaufgaben (Schreiben, Zusammenfassen, App-Aktionen), nicht für allgemeine Fragen.
Funktionieren diese Apps auf dem iPhone SE oder älteren iPhones?
Eingeschränkt. Das iPhone SE (4 GB RAM) liegt unter der praktischen Schwelle für On-Device-LLMs 2026. iPhone 14 / 15 (nicht Pro, 6 GB RAM) kann 1,7B-Modelle (Qwen3 1.7B, SmolLM 2 1.7B) ausführen, aber keine 3B+-Modelle. iPhone 14 Pro und 15 Pro (6–8 GB RAM) können 3B-Modelle wie Phi-4 Mini mit 8–12 Tokens/Sek. ausführen. Für ältere iPhones ist die bessere Option eine Remote-Verbindung zu einem Mac oder PC zu Hause.
Kann ich den Chat-Verlauf zwischen iPhone und Mac synchronisieren?
Nicht in PocketPal AI, Private LLM oder MLC Chat – der Chat-Verlauf wird lokal auf jedem Gerät gespeichert, ohne iCloud-Sync. Private LLM und Locally AI sind beide universelle Käufe/Downloads, die auch nativ auf dem Mac laufen, aber der Verlauf synchronisiert sich trotzdem nicht zwischen den iPhone- und Mac-Kopien. Für geräteübergreifenden Chat-Verlauf ist der praktische Ansatz: Open WebUI auf einem Mac zu Hause betreiben und von iPhone und Mac aus im Browser darauf zugreifen – Open WebUI speichert den Chat-Verlauf serverseitig.
Sind diese Apps außerhalb des App Stores erhältlich?
PocketPal AI ist quelloffen und kann per Xcode aus dem Quellcode gebaut werden, aber der App-Store-Build ist die Standardverteilung. LLM Farm ist die Ausnahme, die nun aus dem Quellcode gebaut werden muss – sie wurde im August 2025 aus dem App Store und TestFlight entfernt. Private LLM, Locally AI und MLC Chat sind nur im App Store erhältlich. EU-Nutzer können App-Store-Apps unter dem DMA 2026 auch über alternative Marktplätze installieren; die zugrundeliegende App ist aber identisch.
Benötigt eine der Apps einen Jailbreak?
Nein. PocketPal AI, Private LLM, Locally AI, MLC Chat und Apple Intelligence laufen alle auf Standard-iOS. Auch das Bauen von LLM Farm aus dem Quellcode in Xcode erfordert keinen Jailbreak – es nutzt das Standard-Sideloading für Entwickler, keinen Jailbreak-Exploit. Ein Jailbreak ist für keine dieser Apps erforderlich oder empfohlen.
Kann ich lokale KI in iOS Shortcuts verwenden?
Ja, über Private LLM (Aktion „Text mit Private LLM generieren"), Locally AI (kostenlose Shortcuts-Aktion) oder Apple Intelligence (Aktion „Modell verwenden", iOS 18.4+, erweitert mit iOS 26). PocketPal AI und MLC Chat haben 2026 keine Shortcuts-Aktionen. Locally AI ist die einzige kostenlose Option mit Shortcuts-Unterstützung und Zugriff auf Apples eigenes On-Device-Modell.
Wie vergleicht sich lokale KI mit der ChatGPT-App auf dem iPhone?
On-Device-Modelle (Phi-4 Mini, Llama 3.2 3B) liegen bei komplexem Schlussfolgern, breitem Weltwissen und multimodalen Aufgaben weiterhin spürbar hinter Frontier-Cloud-Modellen, sind aber bei einfachen Anfragen schneller (kein Netzwerk-Round-Trip) und vollständig privat. Der ehrliche Kompromiss: lokale KI für Routine- und private Aufgaben; ChatGPT oder eine andere Cloud-App für gelegentliche schwierige Fragen. Viele Nutzer 2026 haben beide und wählen je nach Anfrage.
Ist LLM Farm noch sicher, wenn sie nicht mehr im App Store ist?
Der Quellcode ist öffentlich auf GitHub und erhält bis 2026 weiterhin Issue-Aktivität, ist also nicht verwaist – aber sobald aus dem Quellcode gebaut und sideloaded, durchläuft die App nicht mehr Apples App-Store-Prüfprozess. Wenn Sie nicht speziell die Mirostat-Sampling-Kontrollen benötigen, deckt PocketPal AI denselben freien/flexiblen/quelloffenen Anwendungsfall ab und bleibt im App Store mit Apples Standard-App-Review.
Muss ich bei der Verwendung dieser iPhone-LLM-Apps die DSGVO beachten?
Für den privaten Gebrauch ist die DSGVO in der Regel nicht relevant. Für professionelle oder geschäftliche Nutzung – insbesondere wenn Sie Texte mit personenbezogenen Daten (Kundennamen, E-Mails, Vertragsinhalte) in das Modell eingeben – gilt Folgendes: Da PocketPal AI, Private LLM, Locally AI und MLC Chat die Verarbeitung vollständig auf dem Gerät ausführen und keine Daten an externe Server senden, erfüllen sie die DSGVO-Anforderungen aus Artikel 28 (Auftragsverarbeitung) und zur Datenminimierung in der Regel besser als Cloud-KI-Dienste. Für Unternehmen empfiehlt das BSI in seinen Grundschutz-Katalogen On-Device-Verarbeitung als bevorzugtes Muster für die KI-Nutzung mit sensiblen Daten. Schalten Sie bei Private LLM die opt-in-Analysen in den Einstellungen aus, um jede externe Datenübertragung zu unterbinden.
Sind diese iPhone-LLM-Apps für den deutschen Mittelstand geeignet?
Ja, insbesondere PocketPal AI, Private LLM und Locally AI eignen sich für KMU-Anwendungsfälle im deutschen Mittelstand. Typische Einsatzszenarien: Vertriebsmitarbeitende, die offline Angebotszusammenfassungen erstellen; Servicetechniker, die im Feld ohne Internetverbindung Dokumentation zusammenfassen; Büromitarbeitende, die E-Mails und Berichte schnell umformulieren möchten. Da alle Daten lokal auf dem Gerät verbleiben, können DSGVO-Compliance-Anforderungen einfacher eingehalten werden als bei Cloud-Diensten. Für den Einsatz in regulierten Bereichen (Gesundheitswesen, Finanzdienstleistungen) empfiehlt sich eine Prüfung der IT-Sicherheitsstandards nach BSI IT-Grundschutz. Der einmalige Preis von Private LLM (5,99 € ohne Abo) passt gut zur typischen Beschaffungspraxis im Mittelstand.