Principais conclusões
- PocketPal AI é a melhor opção gratuita por padrão. Código aberto, instalação pela App Store, compatível com qualquer modelo GGUF do Hugging Face. Executa o Phi-4 Mini a ~10–15 tokens/seg no iPhone 16 Pro. Ponto de partida recomendado para a maioria dos usuários de iPhone.
- Private LLM é a melhor opção paga (R$ 29,90 pagamento único, sem assinatura). Uma única compra cobre iPhone, iPad e Mac com Compartilhamento familiar. Biblioteca de modelos curada, integração com iOS Shortcuts e suporte de Siri "E aí Siri, pergunte ao Private LLM".
- Locally AI é a alternativa gratuita baseada em MLX, agora desenvolvida pela equipe da LM Studio. Executa modelos Llama, Gemma, Qwen e DeepSeek em Apple MLX, funciona com iOS Shortcuts e pode expor o próprio modelo de base no dispositivo da Apple como interface de chat.
- MLC Chat tem aceleração Metal, mas está parado. Seu motor MLC LLM continua gerando ~25–35% mais tokens/seg que apps baseados em llama.cpp no mesmo hardware, mas o app não é atualizado desde o final de 2024, então sua biblioteca de modelos é anterior ao Phi-4 Mini e ao Gemma 3.
- LLM Farm foi removido da App Store em agosto de 2025. O próprio README o descreve como "temporariamente indisponível". Continua de código aberto e compilável a partir do código-fonte, e segue sendo a opção mais configurável (mirostat, templates de chat) para desenvolvedores.
- Apple Intelligence está no dispositivo, mas não é um app independente. O modelo de base ~3B da Apple potencializa funções do sistema (Ferramentas de escrita, Resposta inteligente, Resumos de notificações). Desde o iOS 26, apps de terceiros podem chamá-lo pelo framework Foundation Models, e o Shortcuts pode acioná-lo com a ação "Usar modelo".
- Modelo recomendado para iPhone 16 Pro / 17 Pro: Phi-4 Mini (3.8B Q4_K_M, ~2.7 GB). Melhor equilíbrio entre qualidade e velocidade para o nível de 8 GB+ de RAM. iPhones mais antigos com 6 GB de RAM (iPhone 14 Pro): Qwen3 1.7B ou SmolLM 2 1.7B.
Fatos rápidos
- Apps comparados: PocketPal AI, Private LLM, Locally AI (da LM Studio), MLC Chat, Apple Intelligence (sistema) — além do LLM Farm, removido da App Store em agosto de 2025.
- Dispositivos de teste: iPhone 16 Pro (A18 Pro, 8 GB RAM) e iPhone 17 Pro (A19 Pro, 12 GB RAM).
- Motores de inferência: llama.cpp (PocketPal AI, LLM Farm), Apple MLX (Locally AI), MLC LLM com Metal (MLC Chat), runtime no dispositivo proprietário (Private LLM, Apple Intelligence).
- iPhone mínimo para modelos 3B+: iPhone 14 Pro (A16, 6 GB RAM) para 1.7B; qualquer iPhone de 8 GB+ (15 Pro, série 16, 16e, série 17) para 3B–4B.
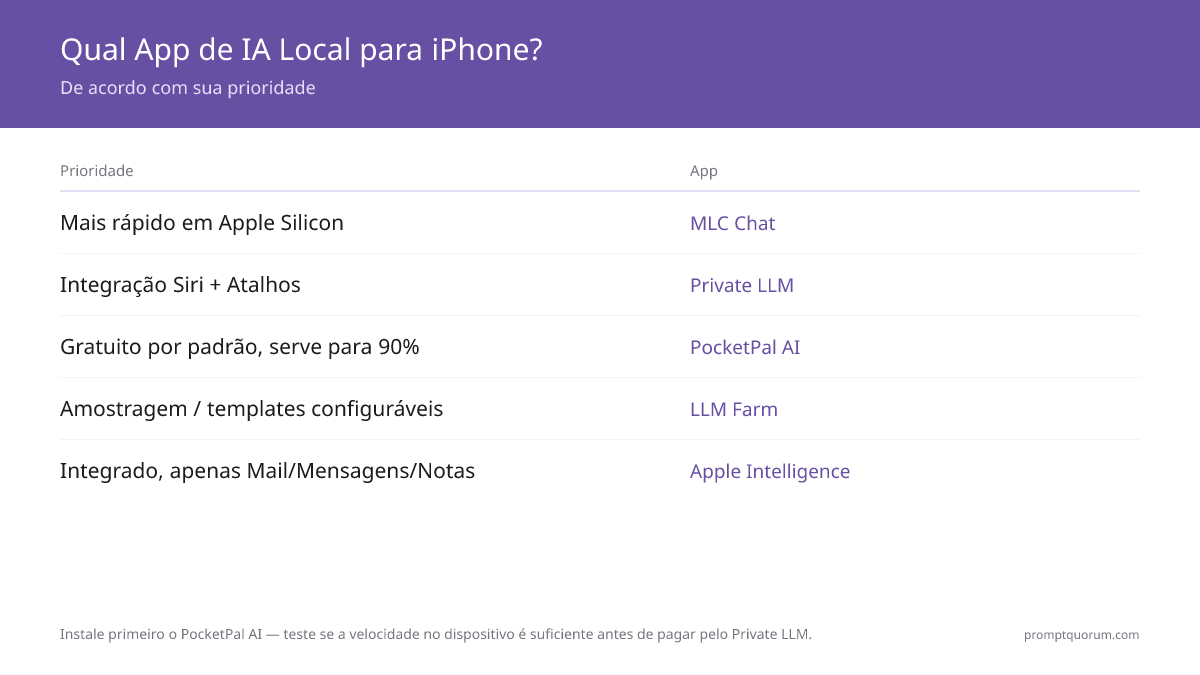
- Melhor app gratuito: PocketPal AI — App Store, código aberto, flexibilidade de modelos.
- Melhor app pago: Private LLM — R$ 29,90 pagamento único (iPhone+iPad+Mac), suporte de Shortcuts + Siri.
- Sem conexão: Os cinco funcionam completamente sem conexão depois que o modelo é baixado; sem chamadas à nuvem.
Qual app instalar primeiro no iPhone?
Para a maioria dos usuários: PocketPal AI pela App Store e depois baixe o Phi-4 Mini (3.8B Q4_K_M). Essa combinação funciona no iPhone 14 Pro e modelos mais recentes, não custa nada e produz resultados úteis para o chat diário, o resumo e a escrita rápida. Escolha outro app só quando você tiver uma necessidade específica que ele não cobre.
📍 Em uma frase
Para a maioria dos usuários de iPhone em 2026, instale o PocketPal AI (grátis, App Store) e baixe o Phi-4 Mini — ele cobre o chat diário, resumo e escrita em qualquer iPhone com 6 GB+ de RAM.
💬 Em termos simples
Cinco apps executam IA completamente no seu iPhone em 2026. O PocketPal AI é o melhor ponto de partida gratuito — instale-o, baixe um arquivo de modelo de 2.7 GB uma única vez e você terá um assistente de chat privado que funciona no trem sem WiFi. O Private LLM é a opção paga se você quer que a Siri converse com o modelo local. O Locally AI, da equipe da LM Studio, é a alternativa gratuita e moderna com suporte a Shortcuts. O MLC Chat é rápido, mas não é mais atualizado. O Apple Intelligence é integrado ao iOS mas não é um app de chat. O PocketPal AI cobre 90% dos casos de uso.
Decisão: qual app de IA local para iPhone?
Use um LLM local se:
- •Você quer uma IA de chat gratuita que funcione sem conexão → PocketPal AI
- •Você quer que a Siri converse com o seu modelo local → Private LLM
- •Você quer um app MLX gratuito com Shortcuts e acesso aos Apple Foundation Models → Locally AI
- •Você aceita uma biblioteca de modelos mais antiga em troca da velocidade Metal máxima → MLC Chat
- •Você só precisa de assistência de escrita no Mail / Mensagens / Notas → Apple Intelligence (integrado)
Use um modelo em nuvem se:
- •Você precisa de qualidade de modelo 70B+ (Llama 3.3 70B, nível GPT-5.5) → use a nuvem ou conecte-se remotamente a uma máquina doméstica
- •Você precisa de acesso a GPT-5.5, Claude Opus ou Gemini especificamente → apps na nuvem (não disponíveis localmente)
- •Você precisa de visão em tempo real ou saída multimodal além do texto → nuvem (o multimodal no dispositivo é limitado em 2026)
Decisão rápida:
- →Grátis + funciona para 90% dos usuários: PocketPal AI
- →Pago + integração nativa iOS: Private LLM
- →Grátis + ecossistema LM Studio: Locally AI
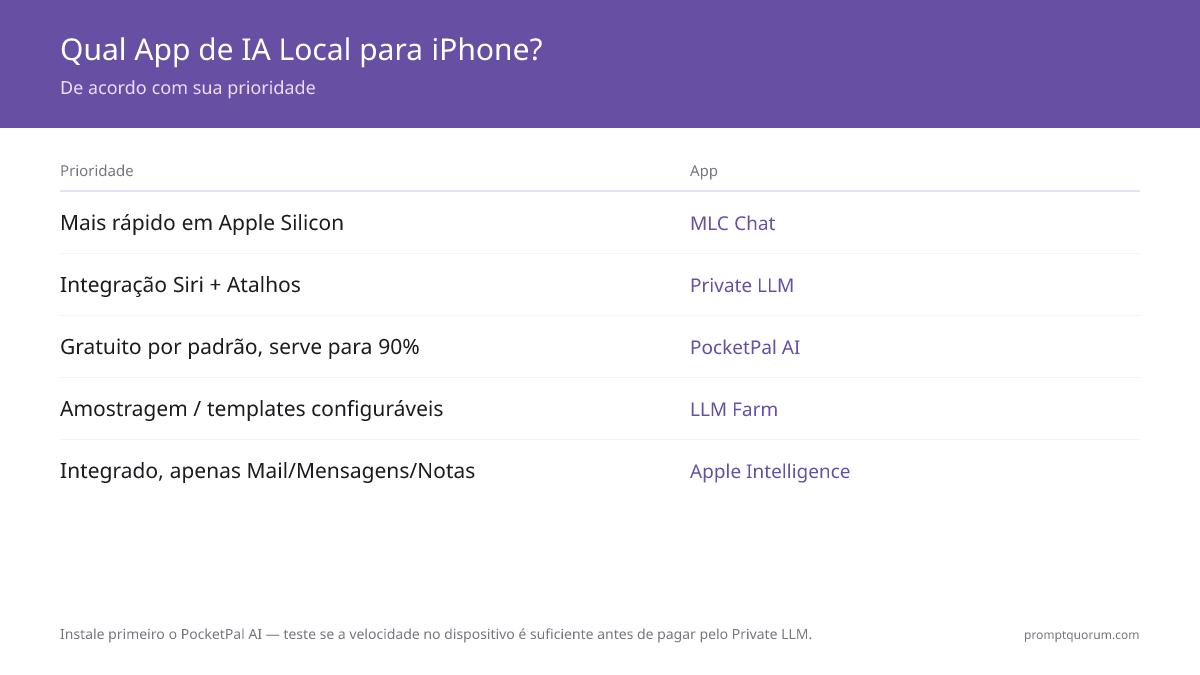
💡Dica: Instale o PocketPal AI primeiro, mesmo que você planeje pagar pelo Private LLM mais tarde. Use o PocketPal AI para verificar se a inferência no dispositivo no seu modelo de iPhone é rápida o suficiente para o seu caso de uso. Se for, decida se a integração com iOS Shortcuts e Siri do Private LLM vale R$ 29,90. Se não, você terá economizado esse valor antes de pagar.
Tabela comparativa de apps para iPhone
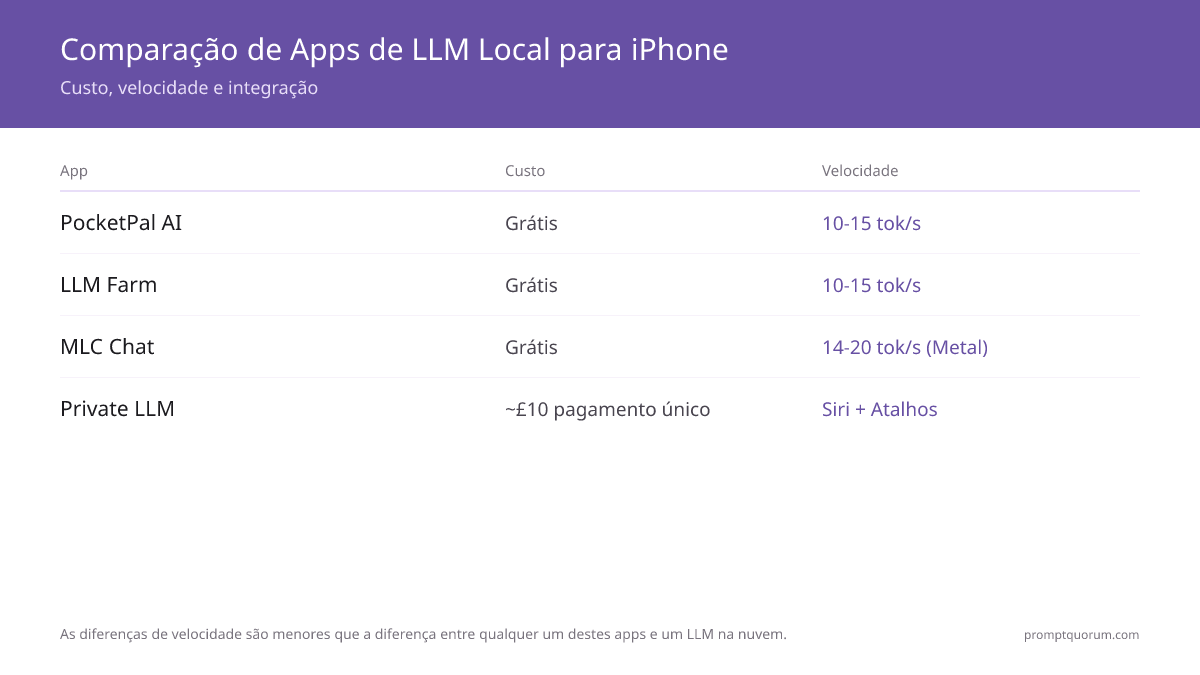
Os cinco apps se diferenciam em três eixos que importam à maioria dos usuários: custo, flexibilidade de modelos e integração com o iOS. As diferenças de velocidade existem, mas são menores que a diferença entre qualquer um desses apps e um LLM na nuvem.
📍 Em uma frase
O PocketPal AI é a melhor opção gratuita por padrão, o Private LLM é a melhor opção paga, o Locally AI é a opção MLX gratuita da equipe da LM Studio, o MLC Chat é rápido no Metal mas está parado, e o Apple Intelligence é integrado ao sistema.
💬 Em termos simples
A escolha geralmente se reduz a três coisas: você quer pagar pela integração com Siri (Private LLM)?, você quer o ecossistema da LM Studio com Shortcuts de graça (Locally AI)? ou você quer velocidade bruta máxima aceitando uma biblioteca de modelos mais antiga (MLC Chat)? Para todo o resto, o PocketPal AI é a opção padrão. Os dados da tabela assumem quantização Q4_K_M — o padrão para inferência móvel em 2026.
App | Preço | Tokens/seg (Phi-4 Mini, 16 Pro) | Privacidade | Ideal para |
|---|---|---|---|---|
| PocketPal AI | Grátis (código aberto) | ~10–15 | Só local, sem telemetria | Opção gratuita por padrão para a maioria |
| Private LLM | R$ 29,90 pagamento único | ~10–14 | Só local, analytics opt-in | iOS Shortcuts + integração Siri |
| Locally AI | Grátis (equipe LM Studio) | N/D — catálogo MLX (sem Phi-4) | Só local, sem coleta de dados | MLX + Shortcuts, vínculo com LM Studio |
| MLC Chat | Grátis (código aberto) | N/D — biblioteca anterior ao Phi-4 | Só local, sem telemetria | Velocidade Metal, modelos antigos |
| LLM Farm | Grátis (só código-fonte) | ~10–15 | Só local, sem telemetria | Usuários avançados (removido da App Store) |
| Apple Intelligence | Grátis (integrado ao iOS) | N/A (função do sistema) | Local + Private Cloud Compute opt-in | Assistência em Mail, Mensagens, Notas |
Nota sobre Apple Neural Engine (ANE), Metal e MLX: PocketPal AI e LLM Farm usam llama.cpp com Metal Performance Shaders para a inferência, que é executada na GPU. O MLC Chat usa MLC LLM com uma otimização Metal mais profunda, alcançando 25–35% mais tokens/seg no mesmo hardware para os modelos que suporta. O Locally AI usa o Apple MLX, o framework open source de arrays da própria Apple, alcançando eficiência de GPU comparável no Apple Silicon. O Apple Intelligence usa o ANE especificamente para o modelo de sistema ~3B, que é mais eficiente energeticamente mas menos flexível que a inferência baseada em Metal. Desde o iOS 26, apps de terceiros podem chamar esse modelo de sistema pelo framework Foundation Models — é exatamente o que o Locally AI faz —, mas modelos GGUF/MLX personalizados ainda não conseguem apontar diretamente para o ANE.
💡Dica: Os números de tokens/seg assumem quantização Q4_K_M (o padrão para inferência móvel em 2026) e um iPhone ocioso sem outros apps pesados em execução. Os apps em segundo plano reduzem o desempenho em 10–30%. Os tokens/seg no iPhone 17 Pro são aproximadamente 20–30% mais altos que no iPhone 16 Pro graças às melhorias do A19 Pro.
PocketPal AI: opção gratuita e de código aberto
O PocketPal AI é o ponto de partida recomendado para a maioria dos usuários de iPhone em 2026. É gratuito, de código aberto (GitHub: a-ghorbani/pocketpal-ai), disponível na App Store e compatível com qualquer modelo GGUF do Hugging Face. O app usa llama.cpp internamente com otimizações para Apple Silicon.
- O que é: um app iOS que executa modelos GGUF localmente usando llama.cpp. Sem assinatura, sem telemetria, sem conta necessária.
- Instalação: App Store → "PocketPal AI". Download gratuito.
- Adicionar um modelo: no app, toque em Modelos → "Adicionar do Hugging Face" → pesquise (p. ex. "phi-4-mini-instruct-Q4_K_M") → toque para baixar. O modelo é armazenado no armazenamento local do app (~2.7 GB para Phi-4 Mini Q4).
- Velocidade de geração (iPhone 16 Pro): Phi-4 Mini ~10–15 tok/seg, Llama 3.2 3B ~12–18 tok/seg, Gemma 3 4B ~7–10 tok/seg, Qwen3 1.7B ~18–24 tok/seg.
- Ideal para: usuários que querem um app de chat gratuito, instalável pela App Store, sem conta, compatível com qualquer modelo GGUF publicado pela comunidade.
💡Dica: O seletor de modelos do PocketPal AI tem um filtro "Recomendados" que mostra modelos verificados para caber na RAM do seu dispositivo. Para um iPhone 16 Pro (8 GB de RAM), o seletor recomenda variantes Q4_K_M de modelos de até ~4B parâmetros. Confie neste filtro — executar um modelo grande demais faz o iOS fechar o app no meio da resposta.
Private LLM: opção paga com integração iOS
O Private LLM é a opção paga mais sólida para iPhone em 2026 (R$ 29,90 pagamento único, sem assinatura). Está disponível apenas na App Store e vem com uma biblioteca curada de modelos otimizados. O seu diferencial é a integração com o iOS: ações de Shortcuts e um comando de voz "E aí Siri, pergunte ao Private LLM".
- O que é: um app iOS pago com biblioteca de modelos curada e integração profunda com o iOS. Usa um runtime no dispositivo proprietário otimizado para Apple Silicon.
- Instalação: App Store → "Private LLM". Compra única R$ 29,90 (sem assinatura).
- Biblioteca de modelos curada: ~30 modelos pré-testados e otimizados para iPhone, incluindo Llama 3.2 3B, Phi-4 Mini, Mistral Small Instruct e várias variantes sem censura. Menos flexibilidade que o PocketPal AI, mas sem risco de instalar um modelo que trave.
- iOS Shortcuts: o Private LLM expõe uma ação "Gerar texto com Private LLM" que você pode encadear em automações de Shortcuts. Útil para acionar a IA local a partir de um botão na sua tela inicial ou por meio de etiquetas NFC.
- Integração com Siri: "E aí Siri, pergunte ao Private LLM [sua pergunta]" envia o prompt ao modelo no dispositivo e a Siri lê a resposta em voz alta. Funciona sem conexão à internet. A latência é maior que na interface de chat (~3–5 segundos antes de o áudio começar).
💡Dica: O Private LLM é uma compra universal: o preço único de R$ 29,90 cobre iPhone, iPad e Mac em uma única compra, e o Compartilhamento familiar da Apple estende isso a até seis membros. Sem assinatura nem compras dentro do app — o preço exibido é o custo total.
Locally AI: app MLX gratuito da LM Studio
O Locally AI é um app de chat gratuito e focado em privacidade, agora desenvolvido pela equipe da LM Studio, construído sobre o framework MLX da própria Apple em vez de llama.cpp. É o mais novo concorrente sério nessa categoria e o único app deste guia que expõe o modelo de base no dispositivo da Apple como interface de chat.
- O que é: um app iOS/iPadOS/macOS que usa Apple MLX para inferência, desenvolvido pela equipe por trás do app de desktop LM Studio.
- Instalação: App Store → "Locally AI". Grátis, sem necessidade de conta, 100% offline.
- Biblioteca de modelos: Llama 3.2, Gemma 2/3/4, Qwen 3, DeepSeek, LFM 2.5, Bonsai, Ministral 3 e Apple Foundation Models — um catálogo mais amplo e atual que o do MLC Chat.
- iOS Shortcuts: expõe uma ação de Shortcuts gratuitamente, no mesmo nível do suporte de automação do Private LLM.
- LM Link: um recurso opcional que se conecta ao LM Studio rodando em um Mac por uma conexão criptografada ponta a ponta, permitindo que o app do iPhone recorra a um modelo maior em uma máquina doméstica quando necessário.
- Requisitos: iOS/iPadOS 18.1+ (as vantagens de eficiência do Apple Silicon aparecem mais a partir do iPhone 15 Pro).
💡Dica: O Locally AI é o único app deste guia capaz de colocar o próprio modelo de base no dispositivo da Apple atrás de uma janela de chat comum — útil para testar o que o modelo do Apple Intelligence consegue fazer sem navegar pelos menus de Ferramentas de escrita. Para a flexibilidade de GGUF de terceiros, o PocketPal AI ainda tem o catálogo de modelos mais amplo.
MLC Chat: otimização para Apple Silicon
O MLC Chat (do projeto MLC LLM) continua sendo o app de referência para aceleração Metal, mas o app em si não é atualizado desde o final de 2024. É gratuito, de código aberto e executa modelos compilados pela cadeia de ferramentas MLC LLM em vez de GGUF padrão — essa exigência de compilação também é o motivo pelo qual seu catálogo não acompanhou o PocketPal AI nem o Locally AI.
- O que é: o app iOS de referência do projeto MLC LLM, que demonstra a inferência acelerada por Metal do MLC LLM no Apple Silicon.
- Instalação: App Store → "MLC Chat". Grátis.
- Vantagem de velocidade (a nível de arquitetura): o motor acelerado por Metal do MLC LLM gera ~25–35% mais rápido que apps baseados em llama.cpp no mesmo iPhone para os modelos que ambos suportam — mas a própria lista de modelos do app é anterior a opções atuais como Phi-4 Mini e Gemma 3, então essa vantagem não pode ser testada em 2026 sem compilar você mesmo.
- Biblioteca de modelos: limitada aos modelos que o projeto MLC LLM compilou antes de o app ficar parado — Llama 3.2 3B, RedPajama e modelos semelhantes de 2024. Nem todo GGUF do Hugging Face funciona, e nenhum modelo pequeno da geração atual está na versão da App Store.
- Ideal para: desenvolvedores já investidos na cadeia de ferramentas MLC LLM e dispostos a compilar seu próprio modelo, ou que precisam especificamente de um dos modelos já incluídos de antes de 2025.
⚠️Aviso: Como a versão da App Store do MLC Chat não é atualizada desde o final de 2024, não espere ver Phi-4 Mini, Qwen3 ou Gemma 3 no seletor de modelos. Se você quer modelos da geração atual com eficiência de GPU nível Metal hoje, o Locally AI (Apple MLX) ou o PocketPal AI (llama.cpp com Metal Performance Shaders) são as alternativas atualmente mantidas ativamente.
LLM Farm: removido mas ainda configurável
O LLM Farm foi removido da App Store e do TestFlight em agosto de 2025 — o próprio README no GitHub descreve o app como "temporariamente indisponível" em ambos. O projeto (GitHub: guinmoon/LLMFarm) continua de código aberto e teve atividade de issues até 2026, mas novos usuários não conseguem mais instalá-lo pela App Store; é preciso compilá-lo a partir do código-fonte com o Xcode.
- O que é: um app iOS do desenvolvedor @guinmoon que executa modelos GGUF com amplas opções de configuração, anteriormente distribuído pela App Store.
- Disponibilidade atual: não instalável pela App Store ou TestFlight no momento desta atualização. O código-fonte continua público e compilável.
- Compilar a partir do código-fonte: clone o repositório, abra no Xcode e compile em um dispositivo com uma conta Apple Developer gratuita ou paga — o fluxo padrão de sideloading para qualquer app iOS de código aberto sem ficha na App Store.
- Configuração exposta (após compilar): temperatura, top-p, top-k, amostragem mirostat, penalidade por repetição, prompt de sistema por modelo, seleção de template de chat, comprimento da janela de contexto.
- Ideal para: desenvolvedores confortáveis em compilar um app a partir do código-fonte no Xcode que querem especificamente os controles de amostragem mirostat. Todos os demais devem usar PocketPal AI ou Locally AI, ambos totalmente instaláveis pela App Store e gratuitos.
⚠️Aviso: Não espere que um link da App Store para o LLM Farm funcione — trate qualquer link desse tipo encontrado em outro lugar como desatualizado. Compilar a partir do código-fonte exige Xcode e conhecimento básico de assinatura de código no iOS. Se isso for mais trabalho do que você quer ter, o PocketPal AI cobre o mesmo caso de uso de "app de chat gratuito e flexível" sem sair da App Store.
Apple Intelligence: IA no dispositivo integrada ao sistema
O Apple Intelligence executa o modelo de base ~3B próprio da Apple no dispositivo no iPhone 15 Pro e modelos mais recentes (chip A17 Pro com 8 GB de RAM no mínimo). Por padrão não é um app de chat — potencializa funções do sistema no Mail (Resposta inteligente), Mensagens (ferramentas de escrita), Notas (resumo) e Resumos de notificações. Desde o iOS 26, o framework Foundation Models da Apple permite que desenvolvedores terceiros acessem diretamente esse modelo no dispositivo, e apps como o Locally AI já o usam para oferecer uma interface de chat real.
- Onde está: integrado ao iOS 18+ (framework Foundation Models desde o iOS 26). Ative em Ajustes → Apple Intelligence e Siri.
- Requisito de hardware: iPhone 15 Pro / 15 Pro Max, série iPhone 16, iPhone 16e, série iPhone 17. Os iPhones mais antigos (14 e inferiores) não são compatíveis com o Apple Intelligence.
- Funções no dispositivo: Ferramentas de escrita (reescrever, resumir, revisar) dentro de qualquer campo de texto, Resposta inteligente no Mail e Mensagens, Resumos de notificações, geração de Genmoji.
- Framework Foundation Models (iOS 26+): uma API Swift nativa que dá aos desenvolvedores acesso direto ao mesmo modelo no dispositivo com poucas linhas de código — é assim que o Locally AI o expõe como opção de chat, e como a ação "Usar modelo" do Shortcuts pode enviar um prompt para esse modelo, para o Private Cloud Compute ou para o ChatGPT.
- Private Cloud Compute: para tarefas que superam a capacidade do modelo no dispositivo, o Apple Intelligence recorre ao Private Cloud Compute (PCC) — servidores operados pela Apple que executam modelos maiores com garantias criptográficas de que nenhum dado do usuário é retido. O PCC é opt-in e pode ser desativado.
- Relação com os apps de chat: o Apple Intelligence é um complemento, não um substituto. Suas funções de sistema cuidam da reescrita e do resumo de texto dentro dos apps do iOS; PocketPal AI, Private LLM, Locally AI e MLC Chat fornecem uma interface de chat dedicada para perguntas arbitrárias — e o Locally AI agora pode oferecer esse mesmo tipo de interface para o próprio modelo da Apple.
💡Dica: Se o Apple Intelligence é a sua única necessidade (reescrever e-mails, resumir notificações), você não precisa de um app de chat independente. Se você quer fazer perguntas ao modelo como "explique o tunelamento quântico em termos simples" ou "crie um plano de projeto para X", instale um app de chat — um dedicado como o PocketPal AI, ou o Locally AI, capaz de colocar o próprio modelo no dispositivo da Apple atrás de uma janela de chat.
Modelos conforme o modelo de iPhone
A RAM do iPhone determina o limite de tamanho do modelo, não a geração do chip. Um iPhone de 6 GB (14 Pro, 15) consegue executar modelos 1.7B confortavelmente; um iPhone de 8 GB+ (15 Pro, série 16, 16e, série 17) executa modelos 3B–4B confortavelmente e modelos 7B lentamente. Para o panorama mais amplo de modelos em todo o hardware (não apenas móvel), consulte Os melhores LLMs locais em 2026.
Nível de iPhone (Ano, RAM) | Modelo recomendado | Tamanho de download | Velocidade esperada |
|---|---|---|---|
| iPhone 17 Pro (2025, 12 GB) | Phi-4 Mini ou Llama 3.2 3B (Q4_K_M) | ~2.5–2.7 GB | ~13–20 tok/seg |
| iPhone 16 Pro / 16 Pro Max / 16e (2024–2025, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 GB | ~10–15 tok/seg |
| iPhone 15 Pro / Pro Max (2023, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 GB | ~8–12 tok/seg |
| iPhone 14 Pro / Pro Max (2022, 6 GB) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~15–20 tok/seg |
| iPhone 14 / 15 / 16 (não Pro, 6 GB) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~12–18 tok/seg |
| iPhone SE / modelos antigos (4 GB) | Não recomendado para LLM no dispositivo | — | — |

💡Dica: Para iPhones mais antigos de 6 GB, o Qwen3 1.7B é o melhor equilíbrio entre tamanho de modelo e qualidade em 2026. O SmolLM 2 1.7B (HuggingFace) é comparável. Ambos produzem respostas curtas coerentes (1–3 parágrafos), mas têm dificuldades com o raciocínio de múltiplos passos. Não instale o Phi-4 Mini em um iPhone de 6 GB — nominalmente cabe, mas o iOS vai fechar o app sob qualquer pressão de memória.
Consumo de bateria e throttling térmico
A inferência LLM no dispositivo no iPhone é intensiva em CPU/GPU e gera calor. A inferência ativa (o modelo gerando tokens) consome ~3–5 W; a geração sustentada vai limitar o chip e drenar a bateria aproximadamente 20–30% por hora no iPhone 16 Pro.
- Consumo de bateria (chat ativo): ~20–30% por hora no iPhone 16 Pro executando o Phi-4 Mini. O iPhone 17 Pro se descarrega ligeiramente mais rápido devido a uma maior potência de pico, mas compensa ao terminar a carga de trabalho antes.
- O throttling térmico aparece após ~10–15 minutos de geração contínua. Quando o chip atinge ~38 °C de temperatura superficial, o iOS reduz as velocidades de clock, baixando os tokens/seg em 30–50%. Deixar o telefone esfriar restaura a velocidade completa.
- Mitigação: mantenha o iPhone de frente para cima sobre uma superfície dura (não na mão nem no bolso) durante sessões de inferência longas para permitir a dissipação de calor. Uma capa com dissipador passivo ajuda, mas raramente é necessária para interações curtas.
- Consumo fantasma: se você deixar um app de chat aberto em segundo plano depois da geração, a RAM permanece alocada mas nenhuma inferência é executada — o impacto na bateria é mínimo. Fechar o app completamente libera os ~3 GB de RAM.
- Carga MagSafe durante a inferência: aceitável no iPhone 17 Pro e 16 Pro (ambos têm designs térmicos melhorados). No iPhone 15 Pro, a combinação de carga e inferência pode atingir os limites térmicos mais rápido — é melhor carregar depois.

⚠️Aviso: Não execute inferência LLM no dispositivo em um iPhone sob luz solar direta ou em um carro quente. A combinação de calor ambiente e carga de inferência leva o chip além dos limites térmicos em minutos, ativando um throttling agressivo e potencialmente o aviso "O iPhone precisa esfriar". O app de chat não fecha, mas a geração fica extremamente lenta.
iOS Shortcuts, Siri e sideloading
A integração com o iOS varia significativamente conforme o app. Private LLM e Locally AI oferecem ações de Shortcuts; PocketPal AI e MLC Chat são apps de chat independentes sem ações de Shortcuts em 2026.
Shortcut do Private LLM: resumir texto selecionado
“1. Ação: "Obter texto selecionado" (entrada do Share Sheet do iOS). 2. Ação: "Gerar texto com Private LLM" → Prompt: "Resuma o seguinte texto em três pontos-chave: [Texto selecionado]" → Modelo: Phi-4 Mini. 3. Ação: "Mostrar resultado" ou "Copiar para a área de transferência". Adicione-o ao Share Sheet para executá-lo sobre qualquer texto selecionado em qualquer app, completamente sem conexão.”
Shortcut do Apple Intelligence: reescrever o tom
“1. Ação: "Obter área de transferência". 2. Ação: "Usar modelo" → Modelo: No dispositivo → Prompt: "Reescreva isto em um tom profissional e conciso: [Área de transferência]". 3. Ação: "Copiar para a área de transferência". Atribua-o a um widget da tela de bloqueio para reescrever com um toque qualquer coisa que você copiar.”
- Private LLM expõe uma ação de Shortcuts "Gerar texto com Private LLM" e um gatilho de voz "E aí Siri, pergunte ao Private LLM [pergunta]". O mais integrado de forma nativa com o iOS entre os apps de chat pagos.
- Locally AI expõe uma ação de Shortcuts gratuitamente e pode encaminhar um atalho para o próprio modelo no dispositivo da Apple por meio da integração com Foundation Models — sem gatilho de voz, mas com automação de Shortcuts sem pagar.
- PocketPal AI é um app de chat independente — sem ação de Shortcuts, sem integração com Siri. Você abre o app e conversa. Os planos de suporte de Shortcuts são rastreados nos issues do GitHub, mas não foram publicados.
- MLC Chat é um app de referência para o projeto MLC LLM — integração iOS mínima e sem atualizações desde o final de 2024. Sem ação de Shortcuts.
- LLM Farm foi removido da App Store (agosto de 2025) e, quando compilado a partir do código-fonte, também não tem ação de Shortcuts.
- Apple Intelligence se integra com o iOS Shortcuts por meio da ação "Usar modelo" (iOS 18.4+, ampliada com o framework Foundation Models no iOS 26). Isso envia um prompt ao modelo no dispositivo, ao Private Cloud Compute ou ao ChatGPT (configurável). A saída no dispositivo pode ser encadeada em outras ações de Shortcuts.
- Sideloading: PocketPal AI, Private LLM, Locally AI e MLC Chat estão na App Store e não exigem sideloading nem jailbreak; o Apple Intelligence é integrado ao iOS. O LLM Farm é a exceção — instalá-lo agora exige compilar a partir do código-fonte no Xcode. Os usuários da UE também podem instalar apps da App Store por meio de marketplaces alternativos sob o DMA em 2026, mas o app em si é idêntico.

💡Dica: Para uso mãos livres ao dirigir ou cozinhar, o "E aí Siri, pergunte ao Private LLM" do Private LLM é a única opção no dispositivo que funciona sem tocar no telefone. O Apple Intelligence suporta voz por meio da Siri, mas só para tarefas do sistema (escrita, resumo, ações de app) — ele não expõe perguntas e respostas gerais como os apps de chat.
Erros frequentes
- Instalar um modelo maior do que a RAM do seu iPhone permite. Um modelo 7B em um iPhone de 8 GB gera a ~3–5 tokens/seg e fecha quando o iOS recupera memória para outro app. Fique com o modelo recomendado para o seu nível de iPhone (3B–4B para dispositivos de 8 GB, 1.7B para dispositivos de 6 GB).
- Esperar qualidade de IA na nuvem dos modelos no dispositivo. O Phi-4 Mini (3.8B) é impressionante para o seu tamanho, mas não é GPT-5.5. Use-o para chat, resumo, escrita e perguntas rápidas — não para raciocínio de múltiplos passos, geração de código complexo ou escrita criativa com nuances.
- Executar inferência sob luz solar direta ou em um carro quente. O throttling térmico aparece em questão de minutos. A geração fica 30–50% mais lenta e pode aparecer o aviso "O iPhone precisa esfriar". Execute a inferência à temperatura ambiente.
- Deixar instalados 3 ou mais apps de chat com modelos de 3 GB em cada um. Você vai consumir ~10 GB de armazenamento em modelos duplicados. Escolha um app e um modelo; desinstale os demais até ter certeza de que precisa deles.
- Supor que o Apple Intelligence não tem interface de chat alguma. Isso era verdade até o iOS 18, mas desde o iOS 26 apps como o Locally AI conseguem colocar o modelo no dispositivo da Apple atrás de uma janela de chat real pelo framework Foundation Models. As funções de sistema (Ferramentas de escrita, Resposta inteligente) sozinhas ainda não são uma interface de chat.
- Procurar o LLM Farm na App Store. Ele foi removido em agosto de 2025. Pesquisá-lo na App Store é perda de tempo; use o PocketPal AI para o mesmo caso de uso gratuito/flexível, ou compile o LLM Farm a partir do código-fonte no Xcode se precisar especificamente dos controles mirostat.
Fontes
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai (app iOS de código aberto).
- Private LLM — ficha da App Store e documentação do desenvolvedor.
- Locally AI — ficha da App Store (equipe da LM Studio, baseado em Apple MLX).
- MLC Chat / projeto MLC LLM — llm.mlc.ai (implantação iOS acelerada por Metal).
- LLM Farm — github.com/guinmoon/LLMFarm (app iOS de código aberto; ficha da App Store/TestFlight temporariamente indisponível segundo o README do projeto).
- Apple Intelligence e modelos de base no dispositivo — Apple Machine Learning Research e documentação do Apple Developer (framework Foundation Models, introduzido no iOS 26).
Perguntas frequentes
O iPhone consegue realmente executar um modelo 7B?
Tecnicamente sim no iPhone 15 Pro e modelos mais recentes (8 GB de RAM), mas não a uma velocidade utilizável. Um modelo 7B Q4 no iPhone 16 Pro gera a ~3–5 tokens/seg — frustrante para o chat. O iOS também tende a fechar o app quando outros apps precisam de memória. Use modelos 3B–4B (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) para o chat no dispositivo do dia a dia. Para qualidade 7B+, conecte-se remotamente a um Mac ou PC doméstico que execute o Ollama.
A IA local esgota a bateria do meu iPhone?
Sim — a inferência ativa consome ~3–5 W e drena a bateria aproximadamente 20–30% por hora no iPhone 16 Pro. Para o uso ocasional (alguns prompts), o impacto é pequeno. Para o uso sustentado (conversa longa, múltiplas tarefas de resumo), mantenha o iPhone na tomada. O modelo em si, armazenado na RAM sem inferência ativa, tem um impacto mínimo na bateria.
O meu iPhone vai esquentar usando IA local?
Sim, depois de cerca de 10–15 minutos de geração contínua. A temperatura superficial do chip atinge ~38 °C e o iOS reduz as velocidades de clock, baixando os tokens/seg em 30–50%. Para minimizar isso: mantenha o iPhone de frente para cima sobre uma superfície dura (não na mão) durante sessões longas, e evite a luz solar direta. As interações curtas (menos de 5 minutos) raramente causam calor notável.
Posso usar a Siri com um modelo local?
Sim, com o Private LLM (R$ 29,90 pagamento único). Dizer "E aí Siri, pergunte ao Private LLM [pergunta]" envia o prompt ao modelo no dispositivo e a Siri lê a resposta em voz alta — completamente sem conexão. PocketPal AI, Locally AI e MLC Chat não têm integração de voz com a Siri em 2026, embora o Locally AI suporte automação com Shortcuts. O Apple Intelligence se integra com a Siri, mas só para tarefas do sistema (escrita, resumo, ações de app), não para perguntas e respostas gerais.
Esses apps funcionam no iPhone SE ou em iPhones mais antigos?
Com limitações. O iPhone SE (4 GB de RAM) está abaixo do limite prático para LLM no dispositivo em 2026. O iPhone 14 / 15 (não Pro, 6 GB de RAM) consegue executar modelos 1.7B (Qwen3 1.7B, SmolLM 2 1.7B), mas não 3B+. O iPhone 14 Pro e 15 Pro (6–8 GB de RAM) conseguem executar modelos 3B como o Phi-4 Mini a 8–12 tokens/seg. Para iPhones mais antigos, a melhor opção é conectar-se remotamente a um Mac ou PC doméstico.
Posso sincronizar o histórico de chat entre iPhone e Mac?
Não em PocketPal AI, Private LLM ou MLC Chat — o histórico de chat é armazenado localmente em cada dispositivo, sem sincronização com o iCloud. Private LLM e Locally AI são compras/downloads universais que também funcionam nativamente no Mac, mas o histórico ainda assim não sincroniza entre as cópias de iPhone e Mac. Para histórico de chat entre dispositivos, a abordagem prática é executar o Open WebUI em um Mac doméstico e acessá-lo pelos navegadores de iPhone e Mac — o Open WebUI armazena o histórico de chat no servidor.
Esses apps estão disponíveis fora da App Store?
O PocketPal AI é de código aberto e pode ser compilado a partir do código-fonte com o Xcode, mas a versão da App Store é a distribuição padrão. O LLM Farm é a exceção que agora precisa ser compilada a partir do código-fonte — foi removido da App Store e do TestFlight em agosto de 2025. Private LLM, Locally AI e MLC Chat estão apenas na App Store. Os usuários da UE podem instalar apps da App Store por meio de marketplaces alternativos sob o DMA em 2026, mas o conteúdo é idêntico.
Algum deles requer jailbreak?
Não. PocketPal AI, Private LLM, Locally AI, MLC Chat e Apple Intelligence funcionam todos no iOS padrão. Compilar o LLM Farm a partir do código-fonte no Xcode também não exige jailbreak — usa o sideloading padrão para desenvolvedores, não um exploit de jailbreak. O jailbreak não é necessário nem recomendado para nenhum desses apps.
Posso usar IA local no iOS Shortcuts?
Sim, por meio do Private LLM (ação "Gerar texto com Private LLM"), do Locally AI (ação de Shortcuts gratuita) ou do Apple Intelligence (ação "Usar modelo", iOS 18.4+, ampliada com o iOS 26). PocketPal AI e MLC Chat não têm ações de Shortcuts em 2026. O Locally AI é a única opção gratuita que oferece tanto suporte a Shortcuts quanto acesso ao próprio modelo no dispositivo da Apple.
Como a IA local se compara ao app do ChatGPT no iPhone?
Os modelos no dispositivo (Phi-4 Mini, Llama 3.2 3B) continuam claramente atrás dos modelos de ponta na nuvem em raciocínio complexo, conhecimento geral do mundo e tarefas multimodais, mas são mais rápidos em consultas simples (sem ida e volta de rede) e completamente privados. A troca honesta: IA local para tarefas rotineiras e privadas; ChatGPT ou outro app na nuvem para perguntas difíceis ocasionais. Muitos usuários em 2026 têm ambos e escolhem conforme a consulta.
O LLM Farm ainda é seguro de usar agora que não está na App Store?
O código-fonte é público no GitHub e continua recebendo atividade de issues até 2026, então não está abandonado, mas depois de compilado a partir do código-fonte e instalado por sideloading, ele não passa mais pelo processo de revisão da App Store da Apple. Se você não precisa especificamente dos controles de amostragem mirostat, o PocketPal AI cobre o mesmo caso de uso gratuito, flexível e de código aberto permanecendo na App Store com a revisão padrão da Apple.