Conclusiones clave
- PocketPal AI es la mejor opción gratuita por defecto. Código abierto, instalación desde el App Store, compatible con cualquier modelo GGUF de Hugging Face. Ejecuta Phi-4 Mini a ~10–15 tokens/seg en iPhone 16 Pro. Punto de partida recomendado para la mayoría de usuarios de iPhone.
- Private LLM es la mejor opción de pago (5,99 € de pago único, sin suscripción). Una sola compra cubre iPhone, iPad y Mac con Compartir en familia. Biblioteca de modelos curada, integración con iOS Shortcuts y soporte de Siri "Oye Siri, pregúntale a Private LLM".
- Locally AI es la alternativa gratuita basada en MLX, ahora desarrollada por el equipo de LM Studio. Ejecuta modelos Llama, Gemma, Qwen y DeepSeek sobre Apple MLX, funciona con iOS Shortcuts y puede exponer el propio modelo de base en dispositivo de Apple como interfaz de chat.
- MLC Chat tiene aceleración Metal, pero está inactiva. Su motor MLC LLM sigue generando ~25–35 % más tokens/seg que las apps basadas en llama.cpp en el mismo hardware, pero la app no se ha actualizado desde finales de 2024, por lo que su biblioteca de modelos es anterior a Phi-4 Mini y Gemma 3.
- LLM Farm fue retirada del App Store en agosto de 2025. Su propio README la describe como "temporalmente no disponible". Sigue siendo de código abierto y se puede compilar desde el código fuente, y sigue siendo la opción más configurable (mirostat, plantillas de chat) para desarrolladores.
- Apple Intelligence está en el dispositivo, pero no es una app independiente. El modelo de base ~3B de Apple potencia funciones del sistema (Herramientas de escritura, Respuesta inteligente, Resúmenes de notificaciones). Desde iOS 26, las apps de terceros pueden llamarlo mediante el framework Foundation Models, y Shortcuts puede invocarlo con la acción "Usar modelo".
- Modelo recomendado para iPhone 16 Pro / 17 Pro: Phi-4 Mini (3.8B Q4_K_M, ~2.7 GB). Mejor equilibrio entre calidad y velocidad para el nivel de 8 GB+ de RAM. iPhones más antiguos con 6 GB de RAM (iPhone 14 Pro): Qwen3 1.7B o SmolLM 2 1.7B.
Datos rápidos
- Apps comparadas: PocketPal AI, Private LLM, Locally AI (de LM Studio), MLC Chat, Apple Intelligence (sistema) — además de LLM Farm, retirada del App Store en agosto de 2025.
- Dispositivos de prueba: iPhone 16 Pro (A18 Pro, 8 GB RAM) y iPhone 17 Pro (A19 Pro, 12 GB RAM).
- Motores de inferencia: llama.cpp (PocketPal AI, LLM Farm), Apple MLX (Locally AI), MLC LLM con Metal (MLC Chat), runtime en dispositivo propietario (Private LLM, Apple Intelligence).
- iPhone mínimo para modelos 3B+: iPhone 14 Pro (A16, 6 GB RAM) para 1.7B; cualquier iPhone de 8 GB+ (15 Pro, serie 16, 16e, serie 17) para 3B–4B.
- Mejor app gratuita: PocketPal AI — App Store, código abierto, flexibilidad de modelos.
- Mejor app de pago: Private LLM — 5,99 € de pago único (iPhone + iPad + Mac), soporte de Shortcuts + Siri.
- Sin conexión: Las cinco funcionan completamente sin conexión una vez descargado el modelo; sin llamadas a la nube.
¿Qué app instalar primero en el iPhone?
Para la mayoría de usuarios: PocketPal AI desde el App Store y luego descarga Phi-4 Mini (3.8B Q4_K_M). Esta combinación funciona en iPhone 14 Pro y modelos más recientes, no cuesta nada y produce resultados útiles para el chat diario, la síntesis y la redacción rápida. Elige otra app solo cuando tengas una necesidad específica que esta no cubra.
📍 En una frase
Para la mayoría de usuarios de iPhone en 2026, instala PocketPal AI (gratis, App Store) y descarga Phi-4 Mini — cubre el chat diario, síntesis y redacción en cualquier iPhone con 6 GB+ de RAM.
💬 En términos simples
Cinco apps ejecutan IA completamente en tu iPhone en 2026. PocketPal AI es el mejor punto de partida gratuito — instálala, descarga un archivo de modelo de 2.7 GB una sola vez y tendrás un asistente de chat privado que funciona en el tren sin WiFi. Private LLM es la opción de pago si quieres que Siri hable con el modelo local. Locally AI, del equipo de LM Studio, es la alternativa gratuita moderna con soporte de Shortcuts. MLC Chat es rápida pero ya no se actualiza. Apple Intelligence está integrada en iOS pero no es una app de chat. PocketPal AI cubre el 90 % de los casos de uso.
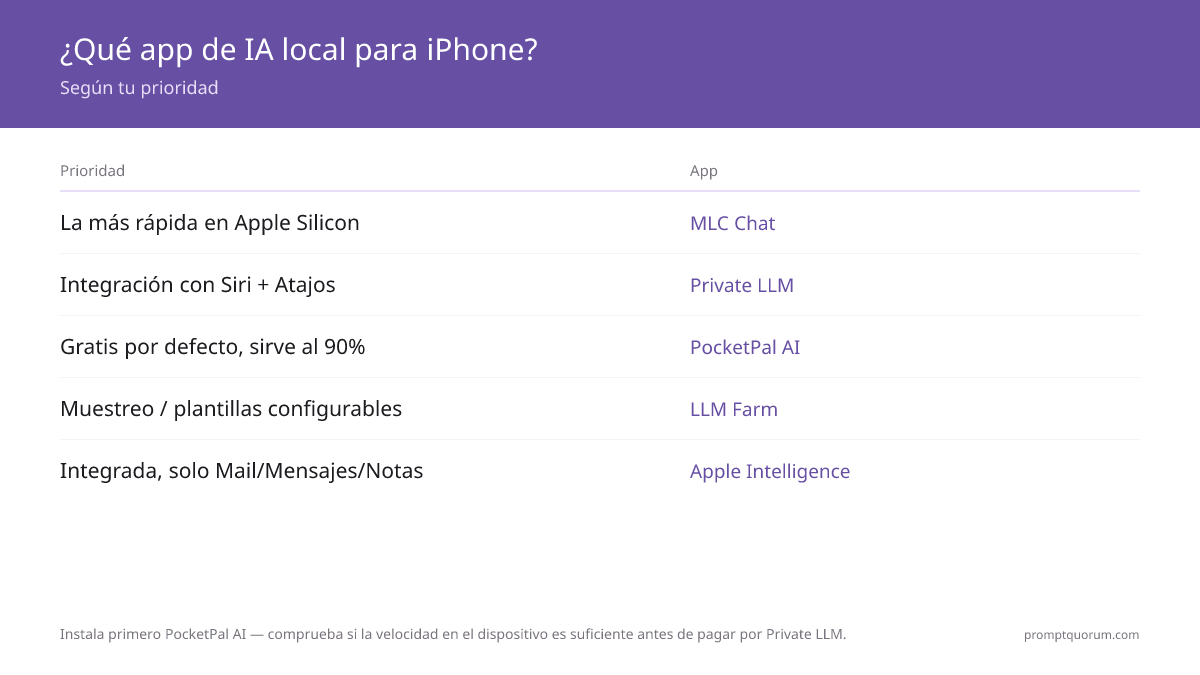
Decisión: ¿qué app de IA local para iPhone?
Usa un LLM local si:
- •Quieres una IA de chat gratuita que funcione sin conexión → PocketPal AI
- •Quieres que Siri hable con tu modelo local → Private LLM
- •Quieres una app MLX gratuita con Shortcuts y acceso a Apple Foundation Models → Locally AI
- •Aceptas una biblioteca de modelos más antigua a cambio de la máxima velocidad Metal → MLC Chat
- •Solo necesitas asistencia de escritura en Mail / Mensajes / Notas → Apple Intelligence (integrada)
Usa un modelo en la nube si:
- •Necesitas calidad de modelo 70B+ (Llama 3.3 70B, nivel GPT-5.5) → usa la nube o conéctate de forma remota a una máquina doméstica
- •Necesitas acceso a GPT-5.5, Claude Opus o Gemini específicamente → apps en la nube (no disponibles en local)
- •Necesitas visión en tiempo real o salida multimodal más allá del texto → nube (el multimodal en dispositivo es limitado en 2026)
Decisión rápida:
- →Gratis + funciona para el 90 % de los usuarios: PocketPal AI
- →De pago + integración nativa iOS: Private LLM
- →Gratis + ecosistema LM Studio: Locally AI
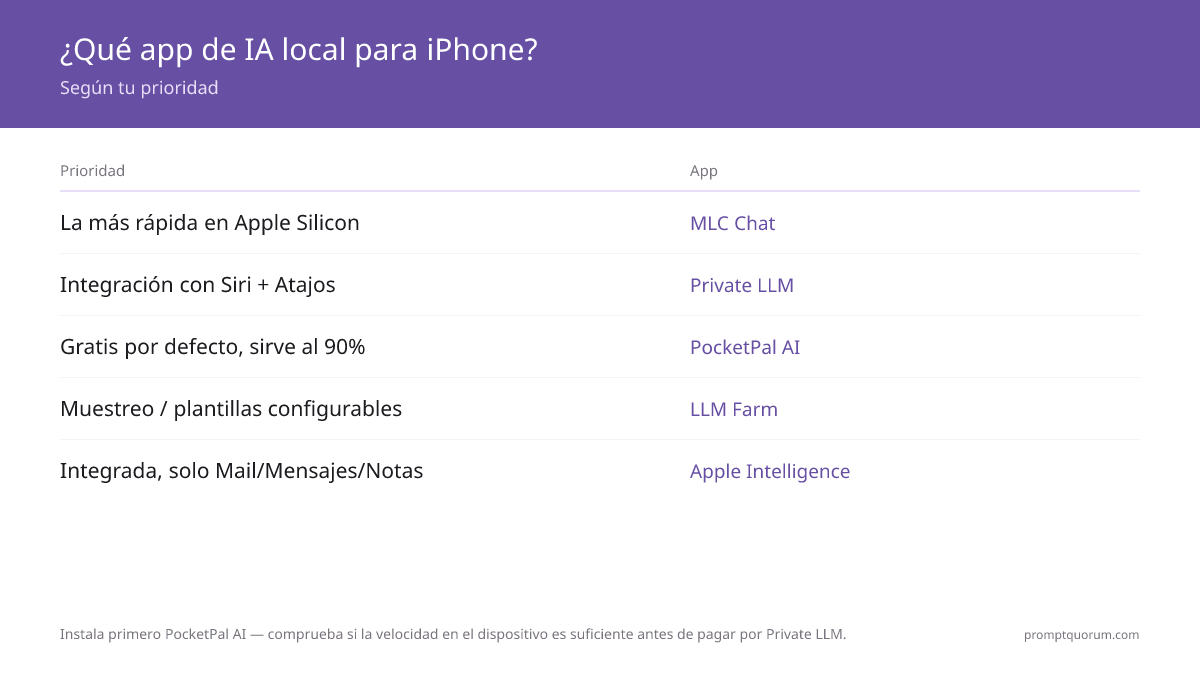
💡Consejo: Instala PocketPal AI primero, incluso si planeas pagar por Private LLM más adelante. Usa PocketPal AI para comprobar si la inferencia en dispositivo en tu modelo de iPhone es suficientemente rápida para tu caso de uso. Si es así, decide si la integración con iOS Shortcuts y Siri de Private LLM vale 5,99 €. Si no, te habrás ahorrado los 5,99 € antes de pagar.
Tabla comparativa de apps para iPhone
Las cinco apps se diferencian en tres ejes que importan a la mayoría de usuarios: coste, flexibilidad de modelos e integración con iOS. Las diferencias de velocidad existen, pero son menores que la brecha entre cualquiera de estas apps y un LLM en la nube.
📍 En una frase
PocketPal AI es la mejor opción gratuita por defecto, Private LLM es la mejor opción de pago, Locally AI es la opción MLX gratuita del equipo de LM Studio, MLC Chat es rápida en Metal pero está inactiva, y Apple Intelligence está integrada en el sistema.
💬 En términos simples
La elección generalmente se reduce a tres cosas: ¿quieres pagar por la integración con Siri (Private LLM)?, ¿quieres el ecosistema de LM Studio con Shortcuts gratis (Locally AI)? o ¿quieres la máxima velocidad bruta aceptando una biblioteca de modelos más antigua (MLC Chat)? Para todo lo demás, PocketPal AI es la opción por defecto. Los datos de la tabla asumen cuantización Q4_K_M — el estándar para inferencia móvil en 2026.
App | Precio | Tokens/seg (Phi-4 Mini, 16 Pro) | Privacidad | Ideal para |
|---|---|---|---|---|
| PocketPal AI | Gratis (código abierto) | ~10–15 | Solo local, sin telemetría | Opción gratuita por defecto para la mayoría |
| Private LLM | 5,99 € pago único | ~10–14 | Solo local, análisis opt-in | iOS Shortcuts + integración Siri |
| Locally AI | Gratis (equipo LM Studio) | N/D — catálogo MLX (sin Phi-4) | Solo local, sin recopilación de datos | MLX + Shortcuts, enlace con LM Studio |
| MLC Chat | Gratis (código abierto) | N/D — biblioteca anterior a Phi-4 | Solo local, sin telemetría | Velocidad Metal, modelos antiguos |
| LLM Farm | Gratis (solo código fuente) | ~10–15 | Solo local, sin telemetría | Usuarios avanzados (retirada del App Store) |
| Apple Intelligence | Gratis (integrada en iOS) | N/A (función del sistema) | Local + Private Cloud Compute opt-in | Asistencia en Mail, Mensajes, Notas |
Nota sobre Apple Neural Engine (ANE), Metal y MLX: PocketPal AI y LLM Farm usan llama.cpp con Metal Performance Shaders para la inferencia, que se ejecuta en la GPU. MLC Chat usa MLC LLM con una optimización Metal más profunda, logrando un 25–35 % más de tokens/seg en el mismo hardware para los modelos que admite. Locally AI usa Apple MLX, el framework de cálculo de código abierto propio de Apple, logrando una eficiencia de GPU comparable en Apple Silicon. Apple Intelligence usa el ANE específicamente para el modelo de sistema ~3B, que es más eficiente energéticamente pero menos flexible que la inferencia basada en Metal. Desde iOS 26, las apps de terceros pueden llamar a ese modelo de sistema mediante el framework Foundation Models —justo lo que hace Locally AI—, pero los modelos GGUF/MLX personalizados todavía no pueden apuntar directamente al ANE.
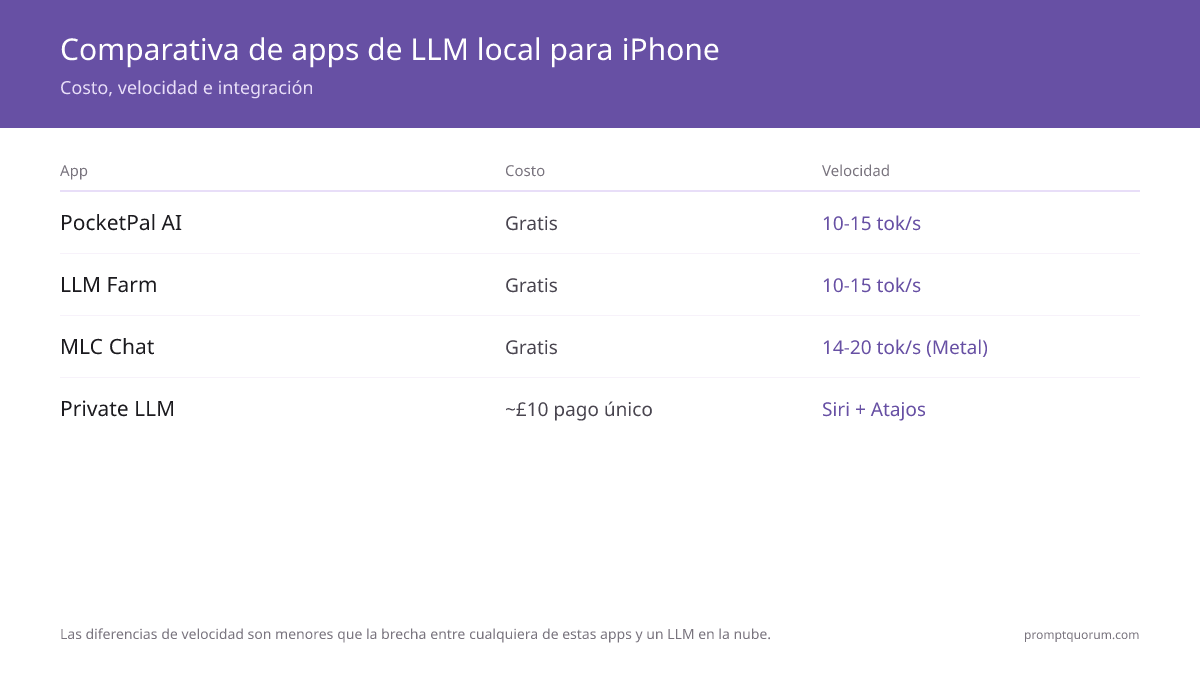
💡Consejo: Las cifras de tokens/seg asumen cuantización Q4_K_M (el estándar para inferencia móvil en 2026) y un iPhone inactivo sin otras apps pesadas en ejecución. Las apps en segundo plano reducen el rendimiento un 10–30 %. Los tokens/seg en iPhone 17 Pro son aproximadamente un 20–30 % más altos que en iPhone 16 Pro gracias a las mejoras del A19 Pro.
PocketPal AI: opción gratuita y de código abierto
PocketPal AI es el punto de partida recomendado para la mayoría de usuarios de iPhone en 2026. Es gratuita, de código abierto (GitHub: a-ghorbani/pocketpal-ai), disponible en el App Store y compatible con cualquier modelo GGUF de Hugging Face. La app usa llama.cpp internamente con optimizaciones para Apple Silicon.
- Qué es: una app iOS que ejecuta modelos GGUF en local usando llama.cpp. Sin suscripción, sin telemetría, sin cuenta requerida.
- Instalación: App Store → "PocketPal AI". Descarga gratuita.
- Agregar un modelo: en la app, toca Modelos → "Agregar desde Hugging Face" → busca (p. ej. "phi-4-mini-instruct-Q4_K_M") → toca para descargar. El modelo se almacena en el almacenamiento local de la app (~2.7 GB para Phi-4 Mini Q4).
- Velocidad de generación (iPhone 16 Pro): Phi-4 Mini ~10–15 tok/seg, Llama 3.2 3B ~12–18 tok/seg, Gemma 3 4B ~7–10 tok/seg, Qwen3 1.7B ~18–24 tok/seg.
- Ideal para: usuarios que quieren una app de chat gratuita, instalable desde el App Store, sin cuenta, compatible con cualquier modelo GGUF publicado por la comunidad.
💡Consejo: El selector de modelos de PocketPal AI tiene un filtro "Recomendados" que muestra modelos verificados para que quepan en la RAM de tu dispositivo. Para un iPhone 16 Pro (8 GB de RAM), el selector recomienda variantes Q4_K_M de modelos de hasta ~4B parámetros. Confía en este filtro — ejecutar un modelo demasiado grande hace que iOS cierre la app a mitad de la respuesta.
Private LLM: opción de pago con integración iOS
Private LLM es la opción de pago más sólida para iPhone en 2026 (5,99 € de pago único, sin suscripción). Solo está disponible en el App Store y viene con una biblioteca curada de modelos optimizados. Su diferenciador es la integración con iOS: acciones de Shortcuts y un comando de voz "Oye Siri, pregúntale a Private LLM".
- Qué es: una app iOS de pago con biblioteca de modelos curada e integración profunda con iOS. Usa un runtime en dispositivo propietario optimizado para Apple Silicon.
- Instalación: App Store → "Private LLM". Compra única 5,99 € (sin suscripción).
- Biblioteca de modelos curada: ~30 modelos pre-probados y optimizados para iPhone, incluyendo Llama 3.2 3B, Phi-4 Mini, Mistral Small Instruct y varias variantes sin censura. Menos flexibilidad que PocketPal AI, pero sin riesgo de instalar un modelo que se cuelgue.
- iOS Shortcuts: Private LLM expone una acción "Generar texto con Private LLM" que puedes encadenar en automatizaciones de Shortcuts. Útil para activar la IA local desde un botón en tu pantalla de inicio o mediante etiquetas NFC.
- Integración con Siri: "Oye Siri, pregúntale a Private LLM [tu pregunta]" envía el prompt al modelo en dispositivo y Siri lee la respuesta en voz alta. Funciona sin conexión a internet. La latencia es mayor que en la interfaz de chat (~3–5 segundos antes de que empiece el audio).
💡Consejo: Private LLM es una compra universal: el precio único de 5,99 € cubre iPhone, iPad y Mac en una sola compra, y Compartir en familia de Apple lo extiende hasta seis miembros. Sin suscripción ni compras integradas — el precio mostrado es el coste total.
Locally AI: app MLX gratuita de LM Studio
Locally AI es una app de chat gratuita centrada en la privacidad, ahora desarrollada por el equipo de LM Studio, construida sobre el framework Apple MLX en lugar de llama.cpp. Es la incorporación seria más reciente en esta categoría y la única app de esta guía que expone el modelo de base en dispositivo de Apple como interfaz de chat.
- Qué es: una app iOS/iPadOS/macOS que usa Apple MLX para la inferencia, desarrollada por el equipo detrás de la app de escritorio LM Studio.
- Instalación: App Store → "Locally AI". Gratis, sin cuenta requerida, 100 % sin conexión.
- Biblioteca de modelos: Llama 3.2, Gemma 2/3/4, Qwen 3, DeepSeek, LFM 2.5, Bonsai, Ministral 3 y Apple Foundation Models — un catálogo más amplio y actual que el de MLC Chat.
- iOS Shortcuts: expone una acción de Shortcuts de forma gratuita, a la altura del soporte de automatización de Private LLM.
- LM Link: una función opcional que se conecta a LM Studio ejecutándose en un Mac mediante un enlace cifrado de extremo a extremo, permitiendo que la app de iPhone recurra a un modelo más grande en una máquina doméstica cuando sea necesario.
- Requisitos: iOS/iPadOS 18.1+ (las ventajas de eficiencia de Apple Silicon se notan más a partir de iPhone 15 Pro).
💡Consejo: Locally AI es la única app de esta guía capaz de poner el propio modelo de base en dispositivo de Apple detrás de una ventana de chat normal — útil para probar qué puede hacer el modelo de Apple Intelligence sin navegar por los menús de Herramientas de escritura. Para flexibilidad GGUF de terceros, PocketPal AI sigue teniendo el catálogo de modelos más amplio.
MLC Chat: optimización para Apple Silicon
MLC Chat (del proyecto MLC LLM) sigue siendo la app de referencia para la aceleración Metal, pero no se ha actualizado desde finales de 2024. Es gratuita, de código abierto y ejecuta modelos compilados por la cadena de herramientas MLC LLM en lugar de GGUF estándar — ese requisito de compilación es también la razón por la que su catálogo no ha seguido el ritmo de PocketPal AI o Locally AI.
- Qué es: la app iOS de referencia del proyecto MLC LLM, que demuestra la inferencia acelerada por Metal de MLC LLM en Apple Silicon.
- Instalación: App Store → "MLC Chat". Gratis.
- Ventaja de velocidad (a nivel de arquitectura): el motor acelerado por Metal de MLC LLM genera ~25–35 % más rápido que las apps basadas en llama.cpp en el mismo iPhone para los modelos que ambas admiten — pero la propia lista de modelos de la app es anterior a opciones actuales como Phi-4 Mini y Gemma 3, por lo que esta ventaja no se puede comprobar en 2026 sin compilar uno mismo.
- Biblioteca de modelos: limitada a los modelos que el proyecto MLC LLM compiló antes de que la app quedara inactiva — Llama 3.2 3B, RedPajama y modelos similares de 2024. No todos los GGUF de Hugging Face funcionan, y ningún modelo pequeño de la generación actual figura en la versión del App Store.
- Ideal para: desarrolladores ya invertidos en la cadena de herramientas MLC LLM y dispuestos a compilar su propio modelo, o quienes necesitan específicamente uno de los modelos ya incluidos de antes de 2025.
⚠️Advertencia: Como la versión del App Store de MLC Chat no se ha actualizado desde finales de 2024, no esperes encontrar Phi-4 Mini, Qwen3 o Gemma 3 en su selector. Si quieres modelos de la generación actual con eficiencia de GPU de clase Metal hoy, Locally AI (Apple MLX) o PocketPal AI (llama.cpp con Metal Performance Shaders) son las alternativas mantenidas activamente.
LLM Farm: retirada pero aún configurable
LLM Farm fue retirada del App Store y de TestFlight en agosto de 2025 — su propio README de GitHub describe la app como "temporalmente no disponible" en ambos. El proyecto (GitHub: guinmoon/LLMFarm) sigue siendo de código abierto y ha tenido actividad de issues hasta 2026, pero los nuevos usuarios ya no pueden instalarla desde el App Store; hay que compilarla desde el código fuente con Xcode.
- Qué es: una app iOS del desarrollador @guinmoon que ejecuta modelos GGUF con amplias opciones de configuración, anteriormente distribuida en el App Store.
- Disponibilidad actual: no instalable desde el App Store ni TestFlight en el momento de esta actualización. El código fuente sigue siendo público y compilable.
- Compilar desde el código fuente: clona el repositorio, ábrelo en Xcode y compílalo en un dispositivo con una cuenta de Apple Developer gratuita o de pago — el flujo estándar de carga lateral para cualquier app iOS de código abierto sin ficha en el App Store.
- Configuración expuesta (tras compilar): temperatura, top-p, top-k, muestreo mirostat, penalización por repetición, prompt de sistema por modelo, selección de plantilla de chat, longitud de la ventana de contexto.
- Ideal para: desarrolladores cómodos compilando una app desde el código fuente en Xcode que quieren específicamente los controles de muestreo mirostat. El resto debería usar PocketPal AI o Locally AI, ambas instalables por completo desde el App Store y gratuitas.
⚠️Advertencia: No esperes que funcione un enlace del App Store para LLM Farm — trata cualquier enlace de ese tipo que encuentres en otro sitio como obsoleto. Compilar desde el código fuente requiere Xcode y conocimientos básicos de firma de código en iOS. Si eso supone más esfuerzo del que quieres invertir, PocketPal AI cubre el mismo caso de uso de "app de chat gratuita y flexible" sin salir del App Store.
Apple Intelligence: IA en dispositivo integrada en el sistema
Apple Intelligence ejecuta el modelo de base ~3B propio de Apple en el dispositivo en iPhone 15 Pro y modelos más recientes (chip A17 Pro con 8 GB de RAM mínimo). Por defecto no es una app de chat — potencia funciones del sistema en Mail (Respuesta inteligente), Mensajes (herramientas de escritura), Notas (síntesis) y Resúmenes de notificaciones. Desde iOS 26, el framework Foundation Models de Apple permite a desarrolladores externos acceder directamente a ese modelo en dispositivo, y apps como Locally AI ya lo aprovechan para ofrecer una interfaz de chat real.
- Dónde está: integrada en iOS 18+ (framework Foundation Models desde iOS 26). Actívala en Ajustes → Apple Intelligence y Siri.
- Requisito de hardware: iPhone 15 Pro / 15 Pro Max, serie iPhone 16, iPhone 16e, serie iPhone 17. Los iPhones más antiguos (14 e inferiores) no son compatibles con Apple Intelligence.
- Funciones en dispositivo: Herramientas de escritura (reescribir, resumir, revisar) dentro de cualquier campo de texto, Respuesta inteligente en Mail y Mensajes, Resúmenes de notificaciones, generación de Genmoji.
- Framework Foundation Models (iOS 26+): una API Swift nativa que da a los desarrolladores acceso directo al mismo modelo en dispositivo con unas pocas líneas de código — así es como Locally AI lo expone como opción de chat, y cómo la acción de Shortcuts "Usar modelo" puede enviar un prompt a ese modelo, a Private Cloud Compute o a ChatGPT.
- Private Cloud Compute: para tareas que superan la capacidad del modelo en dispositivo, Apple Intelligence recurre a Private Cloud Compute (PCC) — servidores operados por Apple que ejecutan modelos más grandes con garantías criptográficas de que no se retienen datos del usuario. PCC es opt-in y puede desactivarse.
- Relación con las apps de chat: Apple Intelligence es un complemento, no un reemplazo. Sus funciones de sistema gestionan la reescritura y síntesis de texto dentro de las apps de iOS; PocketPal AI, Private LLM, Locally AI y MLC Chat proporcionan una interfaz de chat dedicada para preguntas arbitrarias — y Locally AI ahora puede ofrecer ese mismo tipo de interfaz para el propio modelo de Apple.
💡Consejo: Si Apple Intelligence es tu única necesidad (reescribir correos, resumir notificaciones), no necesitas una app de chat independiente. Si quieres hacerle preguntas al modelo como "explica el efecto túnel cuántico en términos simples" o "crea un plan de proyecto para X", instala una app de chat — una dedicada como PocketPal AI, o Locally AI, capaz de poner el propio modelo en dispositivo de Apple detrás de una ventana de chat.
Modelos según el modelo de iPhone
La RAM del iPhone determina el límite de tamaño del modelo, no la generación del chip. Un iPhone de 6 GB (14 Pro, 15) puede ejecutar modelos 1.7B cómodamente; un iPhone de 8 GB+ (15 Pro, serie 16, 16e, serie 17) ejecuta modelos 3B–4B cómodamente y modelos 7B lentamente. Para el panorama más amplio de modelos en todo el hardware (no solo móvil), consulta Los mejores LLM locales en 2026.
Nivel de iPhone (Año, RAM) | Modelo recomendado | Tamaño de descarga | Velocidad esperada |
|---|---|---|---|
| iPhone 17 Pro (2025, 12 GB) | Phi-4 Mini o Llama 3.2 3B (Q4_K_M) | ~2.5–2.7 GB | ~13–20 tok/seg |
| iPhone 16 Pro / 16 Pro Max / 16e (2024–2025, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 GB | ~10–15 tok/seg |
| iPhone 15 Pro / Pro Max (2023, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 GB | ~8–12 tok/seg |
| iPhone 14 Pro / Pro Max (2022, 6 GB) | Qwen3 1.7B o SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~15–20 tok/seg |
| iPhone 14 / 15 / 16 (no Pro, 6 GB) | Qwen3 1.7B o SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~12–18 tok/seg |
| iPhone SE / modelos antiguos (4 GB) | No recomendado para LLM en dispositivo | — | — |

💡Consejo: Para iPhones más antiguos de 6 GB, Qwen3 1.7B es el mejor equilibrio entre tamaño de modelo y calidad en 2026. SmolLM 2 1.7B (HuggingFace) es comparable. Ambos producen respuestas cortas coherentes (1–3 párrafos), pero tienen dificultades con el razonamiento de múltiples pasos. No instales Phi-4 Mini en un iPhone de 6 GB — nominalmente cabe, pero iOS cerrará la app bajo cualquier presión de memoria.
Consumo de batería y throttling térmico
La inferencia LLM en dispositivo en iPhone es intensiva en CPU/GPU y genera calor. La inferencia activa (el modelo genera tokens) consume ~3–5 W; la generación sostenida limitará el chip y drenará la batería aproximadamente un 20–30 % por hora en iPhone 16 Pro.
- Consumo de batería (chat activo): ~20–30 % por hora en iPhone 16 Pro ejecutando Phi-4 Mini. iPhone 17 Pro se descarga ligeramente más rápido debido a una mayor potencia pico, pero lo compensa al terminar la carga de trabajo antes.
- El throttling térmico aparece tras ~10–15 minutos de generación continua. Cuando el chip alcanza ~38 °C de temperatura superficial, iOS reduce las velocidades de reloj, bajando los tokens/seg un 30–50 %. Dejar que el teléfono se enfríe restaura la velocidad completa.
- Mitigación: mantén el iPhone boca arriba sobre una superficie dura (no en la mano ni en el bolsillo) durante sesiones de inferencia largas para permitir la disipación de calor. Una carcasa con disipador pasivo ayuda, pero raramente es necesaria para interacciones cortas.
- Consumo fantasma: si dejas una app de chat abierta en segundo plano después de la generación, la RAM permanece asignada pero no se ejecuta inferencia — el impacto en la batería es mínimo. Cerrar la app completamente libera los ~3 GB de RAM.
- Carga MagSafe durante la inferencia: aceptable en iPhone 17 Pro y 16 Pro (ambos tienen diseños térmicos mejorados). En iPhone 15 Pro, la combinación de carga e inferencia puede alcanzar los límites térmicos más rápido — es mejor cargar después.

⚠️Advertencia: No ejecutes inferencia LLM en dispositivo en un iPhone bajo luz solar directa o en un coche caliente. La combinación de calor ambiental y carga de inferencia lleva el chip más allá de los límites térmicos en minutos, activando un throttling agresivo y potencialmente la advertencia "El iPhone necesita enfriarse". La app de chat no se cierra, pero la generación se ralentiza enormemente.
iOS Shortcuts, Siri y carga lateral
La integración con iOS varía significativamente según la app. Private LLM y Locally AI ofrecen acciones de Shortcuts; PocketPal AI y MLC Chat son apps de chat independientes sin acciones de Shortcuts en 2026.
Shortcut de Private LLM: resumir texto seleccionado
“1. Acción: "Obtener texto seleccionado" (entrada del Share Sheet de iOS). 2. Acción: "Generar texto con Private LLM" → Prompt: "Resume el siguiente texto en tres puntos clave: [Texto seleccionado]" → Modelo: Phi-4 Mini. 3. Acción: "Mostrar resultado" o "Copiar al portapapeles". Agrégalo al Share Sheet para ejecutarlo sobre cualquier texto seleccionado en cualquier app, completamente sin conexión.”
Shortcut de Apple Intelligence: reescribir el tono
“1. Acción: "Obtener portapapeles". 2. Acción: "Usar modelo" → Modelo: En dispositivo → Prompt: "Reescribe esto en un tono profesional y conciso: [Portapapeles]". 3. Acción: "Copiar al portapapeles". Asígnalo a un widget de la pantalla de bloqueo para reescribir con un toque cualquier cosa que copies.”
- Private LLM expone una acción de Shortcuts "Generar texto con Private LLM" y un disparador de voz "Oye Siri, pregúntale a Private LLM [pregunta]". La más integrada de forma nativa con iOS de las apps de chat de pago.
- Locally AI expone una acción de Shortcuts de forma gratuita y puede enviar un shortcut al propio modelo en dispositivo de Apple mediante su integración con Foundation Models — sin disparador de voz, pero con automatización de Shortcuts sin pagar.
- PocketPal AI es una app de chat independiente — sin acción de Shortcuts, sin integración con Siri. Abres la app y chateas. Los planes de soporte de Shortcuts se rastrean en los issues de GitHub, pero no se han publicado.
- MLC Chat es una app de referencia para el proyecto MLC LLM — integración iOS mínima y sin actualizaciones desde finales de 2024. Sin acción de Shortcuts.
- LLM Farm está retirada del App Store (agosto de 2025) y, una vez compilada desde el código fuente, tampoco tiene acción de Shortcuts.
- Apple Intelligence se integra con iOS Shortcuts mediante la acción "Usar modelo" (iOS 18.4+, ampliada con el framework Foundation Models en iOS 26). Esto envía un prompt al modelo en dispositivo, a Private Cloud Compute o a ChatGPT (configurable). La salida en dispositivo puede encadenarse en otras acciones de Shortcuts.
- Carga lateral: PocketPal AI, Private LLM, Locally AI y MLC Chat están en el App Store y no requieren carga lateral ni jailbreak; Apple Intelligence está integrada en iOS. LLM Farm es la excepción — su instalación ahora requiere compilar desde el código fuente en Xcode. Los usuarios de la UE también pueden instalar apps del App Store mediante marketplaces alternativos bajo el DMA en 2026, pero la app en sí es idéntica.

💡Consejo: Para uso manos libres al conducir o cocinar, el "Oye Siri, pregúntale a Private LLM" de Private LLM es la única opción en dispositivo que funciona sin tocar el teléfono. Apple Intelligence admite voz mediante Siri, pero solo para tareas del sistema (escritura, síntesis, acciones de app) — no expone preguntas y respuestas generales como las apps de chat.
Errores frecuentes
- Instalar un modelo más grande de lo que permite la RAM de tu iPhone. Un modelo 7B en un iPhone de 8 GB genera a ~3–5 tokens/seg y se cierra cuando iOS recupera memoria para otra app. Quédate con el modelo recomendado para tu nivel de iPhone (3B–4B para dispositivos de 8 GB, 1.7B para dispositivos de 6 GB).
- Esperar calidad de IA en la nube de los modelos en dispositivo. Phi-4 Mini (3.8B) es impresionante para su tamaño, pero no es GPT-5.5. Úsalo para chat, síntesis, redacción y preguntas rápidas — no para razonamiento de múltiples pasos, generación de código complejo o escritura creativa con matices.
- Ejecutar inferencia bajo luz solar directa o en un coche caliente. El throttling térmico aparece en cuestión de minutos. La generación se ralentiza un 30–50 % y puede aparecer la advertencia "El iPhone necesita enfriarse". Ejecuta la inferencia a temperatura ambiente.
- Dejar instaladas 3 o más apps de chat con modelos de 3 GB en cada una. Consumirás ~10 GB de almacenamiento en modelos duplicados. Elige una app y un modelo; desinstala las demás hasta que estés seguro de que las necesitas.
- Suponer que Apple Intelligence no tiene interfaz de chat en absoluto. Eso era cierto hasta iOS 18, pero desde iOS 26 apps como Locally AI pueden poner el modelo en dispositivo de Apple detrás de una ventana de chat real mediante el framework Foundation Models. Las funciones de sistema (Herramientas de escritura, Respuesta inteligente) por sí solas siguen sin ser una interfaz de chat.
- Buscar LLM Farm en el App Store. Fue retirada en agosto de 2025. Buscarla allí es perder el tiempo; usa PocketPal AI para el mismo caso de uso gratuito y flexible, o compila LLM Farm desde el código fuente en Xcode si necesitas específicamente sus controles mirostat.
Fuentes
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai (app iOS de código abierto).
- Private LLM — ficha del App Store y documentación del desarrollador.
- Locally AI — ficha del App Store (equipo de LM Studio, basada en Apple MLX).
- MLC Chat / proyecto MLC LLM — llm.mlc.ai (despliegue iOS acelerado por Metal).
- LLM Farm — github.com/guinmoon/LLMFarm (app iOS de código abierto; ficha de App Store/TestFlight temporalmente no disponible según el README del proyecto).
- Apple Intelligence y modelos de base en dispositivo — Apple Machine Learning Research y documentación de Apple Developer (framework Foundation Models, introducido con iOS 26).
Preguntas frecuentes
¿El iPhone puede ejecutar de verdad un modelo 7B?
Técnicamente sí en iPhone 15 Pro y modelos más recientes (8 GB de RAM), pero no a una velocidad utilizable. Un modelo 7B Q4 en iPhone 16 Pro genera a ~3–5 tokens/seg — frustrante para el chat. iOS también tiende a cerrar la app cuando otras apps necesitan memoria. Usa modelos 3B–4B (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) para el chat en dispositivo del día a día. Para calidad 7B+, conéctate de forma remota a un Mac o PC doméstico que ejecute Ollama.
¿La IA local agota la batería de mi iPhone?
Sí — la inferencia activa consume ~3–5 W y drena la batería aproximadamente un 20–30 % por hora en iPhone 16 Pro. Para el uso ocasional (unos pocos prompts), el impacto es pequeño. Para el uso sostenido (conversación larga, múltiples tareas de síntesis), mantén el iPhone enchufado. El modelo en sí, almacenado en RAM sin inferencia activa, tiene un impacto mínimo en la batería.
¿Se calentará mi iPhone usando IA local?
Sí, después de unos 10–15 minutos de generación continua. La temperatura superficial del chip alcanza ~38 °C y iOS reduce las velocidades de reloj, bajando los tokens/seg un 30–50 %. Para minimizarlo: mantén el iPhone boca arriba sobre una superficie dura (no en la mano) durante sesiones largas, y evita la luz solar directa. Las interacciones cortas (menos de 5 minutos) raramente causan calor notable.
¿Puedo usar Siri con un modelo local?
Sí, con Private LLM (5,99 € de pago único). Decir "Oye Siri, pregúntale a Private LLM [pregunta]" envía el prompt al modelo en dispositivo y Siri lee la respuesta en voz alta — completamente sin conexión. PocketPal AI, Locally AI y MLC Chat no tienen integración de voz con Siri en 2026, aunque Locally AI admite automatización con Shortcuts. Apple Intelligence se integra con Siri, pero solo para tareas del sistema (escritura, síntesis, acciones de app), no para preguntas y respuestas generales.
¿Estas apps funcionan en iPhone SE o iPhones más antiguos?
Con limitaciones. iPhone SE (4 GB de RAM) está por debajo del umbral práctico para LLM en dispositivo en 2026. iPhone 14 / 15 (no Pro, 6 GB de RAM) puede ejecutar modelos 1.7B (Qwen3 1.7B, SmolLM 2 1.7B), pero no 3B+. iPhone 14 Pro y 15 Pro (6–8 GB de RAM) pueden ejecutar modelos 3B como Phi-4 Mini a 8–12 tokens/seg. Para iPhones más antiguos, la mejor opción es conectarse de forma remota a un Mac o PC doméstico.
¿Puedo sincronizar el historial de chat entre iPhone y Mac?
No en PocketPal AI, Private LLM ni MLC Chat — el historial de chat se almacena localmente en cada dispositivo, sin sincronización con iCloud. Private LLM y Locally AI son compras/descargas universales que también funcionan de forma nativa en Mac, pero el historial sigue sin sincronizarse entre las copias de iPhone y Mac. Para historial de chat entre dispositivos, el enfoque práctico es ejecutar Open WebUI en un Mac doméstico y acceder a él desde los navegadores de iPhone y Mac — Open WebUI almacena el historial de chat en el servidor.
¿Están estas apps disponibles fuera del App Store?
PocketPal AI es de código abierto y puede compilarse desde el código fuente con Xcode, pero la versión del App Store es la distribución estándar. LLM Farm es la excepción que ahora debe compilarse desde el código fuente — fue retirada del App Store y de TestFlight en agosto de 2025. Private LLM, Locally AI y MLC Chat solo están en el App Store. Los usuarios de la UE pueden instalar apps del App Store mediante marketplaces alternativos bajo el DMA en 2026, pero el contenido es idéntico.
¿Alguna de ellas requiere jailbreak?
No. PocketPal AI, Private LLM, Locally AI, MLC Chat y Apple Intelligence funcionan todas en iOS estándar. Compilar LLM Farm desde el código fuente en Xcode tampoco requiere jailbreak — usa la carga lateral estándar para desarrolladores, no un exploit de jailbreak. El jailbreak no es necesario ni recomendado para ninguna de estas apps.
¿Puedo usar IA local en iOS Shortcuts?
Sí, mediante Private LLM (acción "Generar texto con Private LLM"), Locally AI (acción de Shortcuts gratuita) o Apple Intelligence (acción "Usar modelo", iOS 18.4+, ampliada con iOS 26). PocketPal AI y MLC Chat no tienen acciones de Shortcuts en 2026. Locally AI es la única opción gratuita que ofrece tanto soporte de Shortcuts como acceso al propio modelo en dispositivo de Apple.
¿Cómo se compara la IA local con la app de ChatGPT en iPhone?
Los modelos en dispositivo (Phi-4 Mini, Llama 3.2 3B) siguen claramente por detrás de los modelos de vanguardia en la nube en razonamiento complejo, conocimiento general del mundo y tareas multimodales, pero son más rápidos en consultas simples (sin ida y vuelta de red) y completamente privados. El intercambio honesto: IA local para tareas rutinarias y privadas; ChatGPT u otra app en la nube para preguntas difíciles ocasionales. Muchos usuarios en 2026 tienen ambas y eligen según la consulta.
¿Sigue siendo seguro usar LLM Farm ahora que no está en el App Store?
El código fuente es público en GitHub y sigue recibiendo actividad de issues hasta 2026, por lo que no está abandonado, pero una vez compilada desde el código fuente e instalada por carga lateral, ya no pasa por el proceso de revisión del App Store de Apple. Si no necesitas específicamente sus controles de muestreo mirostat, PocketPal AI cubre el mismo caso de uso gratuito, flexible y de código abierto sin salir del App Store, con la revisión estándar de Apple.