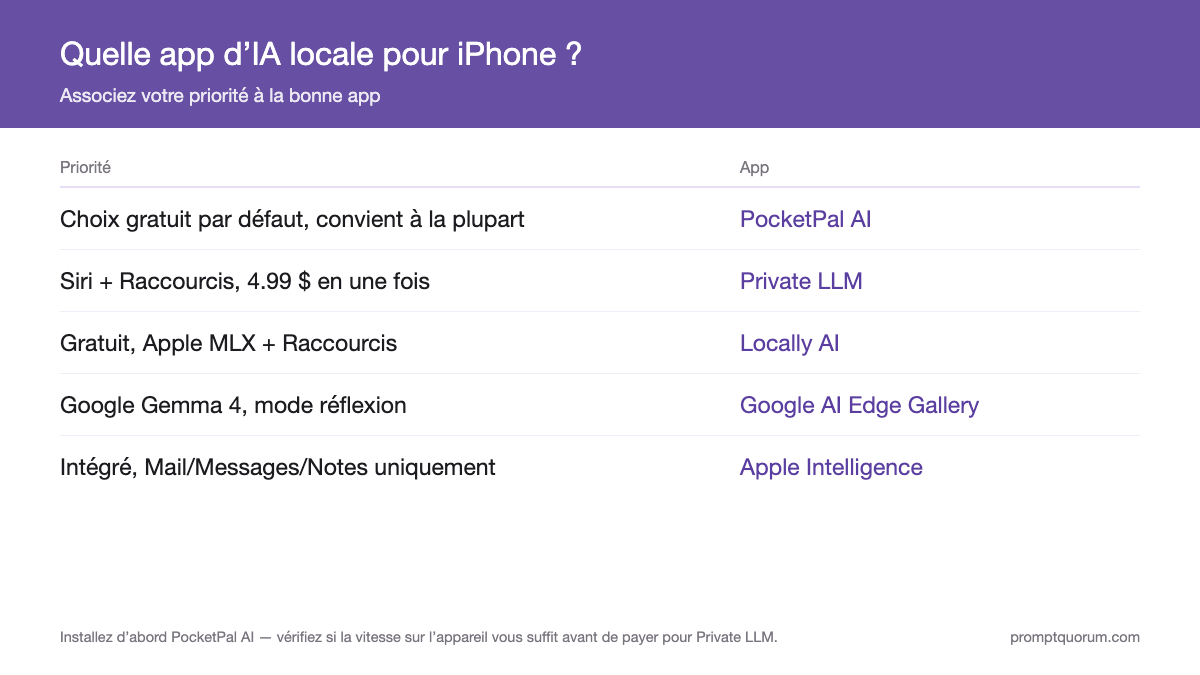
Données rapides
- Applications comparées : PocketPal AI, Private LLM, Locally AI (par LM Studio), Google AI Edge Gallery, MLC Chat, Apple Intelligence (système) — ainsi que LLM Farm, actuellement absent de l'App Store (README : « temporairement indisponible »).
- Dernières mises à jour amont (vérifiées le 23 octobre 2026) : PocketPal AI v1.20.1 (19 octobre 2026) · Locally AI v1.66.0 (15 octobre 2026) · Google AI Edge Gallery v1.0.13 (8 octobre 2026) · Private LLM v1.9.16 (14 septembre 2026) · app iPhone MLC Chat v1.6 (27 septembre 2024 — obsolète) · LLM Farm version 1.4.3 (27 janvier 2025), dernier push de code le 30 janvier 2026 — obsolète.
- Appareils de référence pour les vitesses : iPhone 16 Pro (A18 Pro, 8 Go de RAM) et iPhone 17 Pro (A19 Pro, 12 Go de RAM). Les vitesses sont des plages indicatives d'orientation, pas des mesures de PromptQuorum. L'iPhone 18 Pro, l'iPhone 18 Pro Max et l'iPhone Duo (A20 Pro) n'ont pas de chiffres de vitesse ici.
- Moteurs d'inférence : llama.cpp (PocketPal AI, LLM Farm), Apple MLX (Locally AI), MLC LLM avec Metal (MLC Chat), Google LiteRT-LM (Google AI Edge Gallery), runtime on-device propriétaire (Private LLM, Apple Intelligence).
- iPhone minimum pour les modèles 3B+ : iPhone 14 Pro (A16, 6 Go de RAM) pour 1.7B ; tout iPhone 8 Go+ (15 Pro, série 16, 16e, série 17, 18 Pro) pour 3B–4B.
- Application gratuite recommandée : PocketPal AI — App Store, open source, flexibilité des modèles.
- Option payante : Private LLM — $4.99 en achat unique (iPhone + iPad + Mac), support Shortcuts + Siri.
- Hors ligne : une fois le modèle téléchargé, le chat on-device des six fonctionne sans WiFi ; les fonctions qui récupèrent des données en direct (par exemple les skills Wikipédia et cartes de Google AI Edge Gallery, ou le LM Link optionnel de Locally AI) nécessitent une connexion. Selon le README ou la fiche de PocketPal AI, Private LLM, Locally AI et Google AI Edge Gallery, le chat on-device n'effectue aucun appel cloud (non vérifié pour MLC Chat et LLM Farm) ; Apple Intelligence peut utiliser Private Cloud Compute.
Quelle application iPhone installer en premier ?
Pour la plupart des utilisateurs : PocketPal AI depuis l'App Store, puis téléchargez Phi-4 Mini (3.8B Q4_K_M) — ou un petit modèle plus récent comme Gemma 4 E2B/E4B ou Qwen3.5 4B. Cette combinaison fonctionne sur iPhone 15 Pro et les modèles plus récents (8 Go+ de RAM) ; sur un iPhone 6 Go comme l'iPhone 14 Pro, téléchargez plutôt un modèle 1.7B tel que Qwen3 1.7B (voir Modèles par génération d'iPhone). Elle ne coûte rien pour le chat et produit des résultats utilisables pour la conversation quotidienne, la synthèse et la rédaction rapide. Ne choisissez une autre application que si vous avez un besoin précis qu'elle ne couvre pas.
📍 En une phrase
Pour la plupart des utilisateurs iPhone en 2026, installez PocketPal AI (gratuit, App Store) et téléchargez Phi-4 Mini ou un petit modèle plus récent comme Gemma 4 E2B — il couvre le chat quotidien, la synthèse et la rédaction — avec un modèle 3B–4B sur les iPhone 8 Go+ et un modèle 1.7B sur les iPhone 6 Go.
💬 En termes simples
Six options iPhone font tourner l'IA sur votre téléphone en 2026 ; les apps de chat gardent la conversation sur l'appareil une fois le modèle téléchargé, et Apple Intelligence peut aussi utiliser Private Cloud Compute d'Apple pour les requêtes plus lourdes. PocketPal AI est le point de départ gratuit recommandé — installez-le, téléchargez une fois un fichier modèle de 2.7 Go, et vous disposez d'un assistant de chat privé qui fonctionne dans le train sans WiFi. Private LLM est l'option payante si vous voulez que Siri parle au modèle local. Locally AI, de l'équipe LM Studio, est l'alternative gratuite moderne avec support Shortcuts, et Google AI Edge Gallery est l'application gratuite de Google pour ses modèles Gemma 4. La version iPhone de MLC Chat n'est plus mise à jour. Apple Intelligence est intégré à iOS mais n'est pas une application de chat. PocketPal AI convient à la plupart des usages.
Décision : quelle application d'IA locale pour iPhone ?
Utilisez un LLM local si :
- •Vous voulez une IA de chat gratuite fonctionnant hors ligne → PocketPal AI
- •Vous voulez que Siri parle à votre modèle local → Private LLM
- •Vous voulez une app MLX gratuite avec Shortcuts et accès aux Apple Foundation Models → Locally AI
- •Vous voulez le Gemma 4 de Google avec mode réflexion et agent skills → Google AI Edge Gallery
- •Vous voulez expérimenter la chaîne d'outils MLC LLM et acceptez une version iPhone sans mise à jour depuis septembre 2024 → MLC Chat
- •Vous n'avez besoin que d'une aide à la rédaction dans Mail / Messages / Notes → Apple Intelligence (intégré)
- •Vous voulez un chat hors ligne avec questions sur documents, mémoire modifiable ou Kid Mode protégé par PIN → MemoryAI
Utilisez un modèle cloud si :
- •Vous avez besoin de la qualité d'un modèle 70B+ (Llama 3.3 70B, niveau GPT-5.5) → utilisez le cloud ou connectez-vous à distance à une machine domestique
- •Vous avez besoin spécifiquement de GPT-5.5, Claude Opus ou Gemini → applications cloud (non disponibles en local)
- •Vous avez besoin de vision en temps réel ou de sorties multimodales au-delà du texte → cloud (le multimodal on-device reste limité en 2026)
Décision rapide :
- →Gratuit + convient à la plupart : PocketPal AI
- →Payant + intégration native iOS : Private LLM
- →Gratuit + écosystème LM Studio : Locally AI
- →Gratuit + Gemma 4 de Google : Google AI Edge Gallery
- →Gratuite + documents, mémoire, Kid Mode : MemoryAI

💡Astuce: Installez PocketPal AI en premier, même si vous comptez payer Private LLM plus tard. Utilisez-le pour vérifier si l'inférence on-device sur votre iPhone est assez rapide pour votre usage. Si oui, décidez si l'intégration Shortcuts et Siri de Private LLM vaut $4.99. Sinon, vous avez économisé $4.99 en le découvrant avant de payer. PocketPal AI intègre aussi un benchmark qui mesure tokens/sec et mémoire sur votre propre iPhone — fiez-vous-y plutôt qu'à n'importe quel tableau, y compris celui ci-dessous.
Tableau comparatif des applications iPhone
Les six options se distinguent sur trois axes importants pour la plupart des utilisateurs : le coût, la flexibilité des modèles et l'intégration avec iOS. Les écarts de vitesse existent mais sont plus faibles que l'écart entre n'importe laquelle de ces applications et un LLM cloud. Prix et versions relevés sur les fiches App Store US et les pages des projets le 23 octobre 2026.
📍 En une phrase
PocketPal AI est l'option gratuite par défaut recommandée, Private LLM l'option payante, Locally AI le choix MLX gratuit de l'équipe LM Studio, Google AI Edge Gallery l'application Gemma 4 gratuite de Google, MLC Chat est inactif sur iPhone et Apple Intelligence est intégré au système.
💬 En termes simples
Le choix se résume généralement à trois critères : voulez-vous payer pour l'intégration Siri (Private LLM), voulez-vous gratuitement l'écosystème LM Studio avec Shortcuts (Locally AI), ou le Gemma 4 de Google avec un mode réflexion (Google AI Edge Gallery). Pour tout le reste, PocketPal AI est le choix par défaut. Les vitesses du tableau sont des plages indicatives en quantisation Q4_K_M — le standard de l'inférence mobile en 2026 — et non des mesures de PromptQuorum.
Application | Prix | Tokens/sec (Phi-4 Mini, 16 Pro) | Confidentialité | Idéal pour |
|---|---|---|---|---|
| PocketPal AI | Gratuit (MIT) + achats intégrés optionnels | ~10–15 | Chat on-device, sans compte (README) | Défaut gratuit pour la plupart |
| Private LLM | $4.99 achat unique | Aucun chiffre | On-device ; sans compte ni suivi (développeur) | Shortcuts + intégration Siri |
| Locally AI | Gratuit (équipe LM Studio) | N/A — catalogue MLX (pas de Phi-4) | On-device ; aucune collecte (fiche) | MLX + Shortcuts, lien LM Studio |
| Google AI Edge Gallery | Gratuit (Google) | N/A — LiteRT-LM, Gemma 4 | On-device après téléchargement (fiche) | Gemma 4, mode réflexion, agent skills |
| MLC Chat | Gratuit (open source) | N/A — bibliothèque antérieure à Phi-4 | Inférence locale (doc projet ; non vérifié) | Utilisateurs MLC LLM (app iOS inactive) |
| LLM Farm | Gratuit (compilation depuis les sources) | Aucun chiffre | Inférence locale (doc projet ; non vérifié) | Développeurs (hors App Store, obsolète) |
| Apple Intelligence | Gratuit (intégré à iOS) | N/A (fonctionnalité système) | Local + Private Cloud Compute (Apple) | Aide Mail, Messages, Notes |
| MemoryAI | Gratuite ; sans publicité ni achat intégré | Aucune valeur | Sur l'appareil après téléchargement ; événements d'usage et plantages envoyés | Documents, mémoire modifiable, Kid Mode |
| fullmoon | Gratuite (MIT) | Aucune valeur | Sur l’appareil selon l’éditeur ; politique contradictoire | Chat hors ligne simple ; aucune version depuis janv. 2025 |
| Cloak: Local AI | Achat unique (1,99 €, App Store français) ; sans abonnement | Aucune valeur | Sur l’appareil après le téléchargement du modèle ; sondage facultatif et compteurs d’usage sur option | Chat sans configuration, mémos vocaux, Recap |
Note sur Apple Neural Engine (ANE), Metal et MLX : PocketPal AI et LLM Farm utilisent llama.cpp avec Metal Performance Shaders pour l'inférence, qui s'exécute sur le GPU. MLC Chat utilise MLC LLM avec une optimisation Metal plus poussée que le projet MLC LLM décrit comme plus rapide que les applications basées sur llama.cpp sur le même matériel (affirmation du projet ; PromptQuorum ne l'a pas mesurée). Locally AI utilise Apple MLX, le framework de calcul open source d'Apple, d'une efficacité GPU comparable sur Apple Silicon. Google AI Edge Gallery exécute Gemma 4 via le runtime LiteRT-LM de Google. Apple Intelligence utilise l'ANE spécifiquement pour le modèle système d'environ 3B, plus économe en énergie mais moins flexible que l'inférence basée sur Metal. Depuis iOS 26, les applications tierces peuvent appeler ce modèle système via le framework Foundation Models — Locally AI le fait déjà —, mais les modèles GGUF/MLX personnalisés ne peuvent toujours pas cibler directement l'ANE. Apple indique que l'A20 Pro de l'iPhone 18 Pro dispose d'un Neural Engine 16 cœurs double avec deux fois la puissance de calcul précédente ; c'est une affirmation d'Apple, et PromptQuorum n'a pas mesuré ce qu'elle change pour ces applications.

💡Astuce: Les tokens/sec sont des plages d'orientation approximatives pour des modèles Q4_K_M sur des iPhone récents, et non des mesures de PromptQuorum ; elles ne sont pas rattachées à une version d'application ou à une date de test. Ils supposent une quantisation Q4_K_M (le standard de l'inférence mobile en 2026) et un iPhone au repos sans autre application lourde. Les applications en arrière-plan peuvent réduire nettement le débit, et l'iPhone 17 Pro est généralement plus rapide que l'iPhone 16 Pro. Mesurez votre propre téléphone avec le benchmark intégré de PocketPal AI.
PocketPal AI : option gratuite open source
PocketPal AI est le point de départ recommandé pour la plupart des utilisateurs iPhone en 2026. Gratuit, open source (MIT ; GitHub : a-ghorbani/pocketpal-ai), disponible sur l'App Store et compatible avec tout modèle GGUF de Hugging Face. L'application utilise llama.cpp en coulisses avec des optimisations Apple Silicon. Test complet : Test de PocketPal AI.
- Qu'est-ce que c'est : une application iOS/iPadOS et Android qui exécute des modèles GGUF en local avec llama.cpp, publiée par Gooya UG. Le README indique que les invites, réponses et documents ne sont pas envoyés à des serveurs externes ; le chat ne demande aucun compte.
- Version et dernière mise à jour : v1.20.1, publiée le 19 octobre 2026 (release GitHub) ; la fiche App Store affiche la même version. Versions récentes : v1.19.0 (4 oct.), v1.20.0 (14 oct.), v1.20.1 (19 oct. 2026) — pas d'avertissement d'obsolescence.
- Installation : App Store → « PocketPal AI ». Téléchargement gratuit avec achats intégrés optionnels (Pals premium et « PocketPal Plus »). Requiert iOS/iPadOS 15.1 ou plus ; c'est la RAM, pas la version d'iOS, qui fixe la taille de modèle utilisable. Depuis la v1.20.0, l'application propose aussi en option Se connecter avec Apple et la suppression de compte.
- Ajouter un modèle : dans l'application, appuyez sur Modèles → « Ajouter depuis Hugging Face » → recherchez (ex. « phi-4-mini-instruct-Q4_K_M ») → appuyez pour télécharger. Le modèle est stocké dans l'espace local de l'application (~2.7 Go pour Phi-4 Mini Q4).
- Vitesse de génération (iPhone 16 Pro, indicative) : Phi-4 Mini ~10–15 tok/sec, Llama 3.2 3B ~12–18 tok/sec, Gemma 3 4B ~7–10 tok/sec, Qwen3 1.7B ~18–24 tok/sec. Ce sont des plages d'orientation approximatives, pas des mesures de PromptQuorum — utilisez le benchmark intégré, qui indique tokens/sec et mémoire sur votre propre iPhone.
- Autres fonctions : Pals (assistants personnalisés), synthèse vocale on-device, Talents (calculatrice et outils date/heure pour les modèles capables) et un navigateur de modèles Hugging Face compatible avec les modèles à accès restreint via un jeton.
- Idéal pour : les utilisateurs qui veulent une application de chat gratuite, installable depuis l'App Store, sans compte, compatible avec tout modèle GGUF de la communauté.
💡Astuce: Le sélecteur de modèles de PocketPal AI propose un filtre « Recommandés » qui, selon la documentation de l'application, affiche les modèles tenant dans la RAM de votre appareil. Vérifiez-le sur votre propre téléphone — un modèle trop grand peut conduire iOS à fermer l'application en pleine réponse.
Private LLM : option payante avec intégration iOS
Private LLM est l'option iPhone payante de ce guide ($4.99 en achat unique, sans abonnement). Disponible uniquement sur l'App Store, il propose une bibliothèque de modèles optimisés sélectionnés. Sa différence tient à l'intégration iOS : le développeur indique qu'il s'intègre directement à Siri et à l'application Shortcuts. Test complet : Test de Private LLM.
- Qu'est-ce que c'est : une application iOS payante avec une bibliothèque de modèles sélectionnés et une intégration iOS poussée. Utilise un runtime on-device propriétaire optimisé pour Apple Silicon.
- Installation : App Store → « Private LLM - Local AI Chat » (Numen Technologies Limited). Achat unique $4.99 (sans abonnement ; la fiche n'affiche aucun achat intégré). Requiert iOS/iPadOS 17.0 ou plus sur une puce A12 Bionic ou plus récente.
- Version et dernière mise à jour : v1.9.16, publiée le 14 septembre 2026 (historique des versions App Store) ; la version précédente, 1.9.15, datait du 9 juillet 2026. Les mises à jour arrivent tous les deux à trois mois — sous le seuil de trois mois, donc pas d'avertissement d'obsolescence.
- Bibliothèque de modèles sélectionnés : privatellm.app annonce plus de 140 modèles locaux sur iPhone, iPad et Mac, avec des familles comme Llama, Qwen3, Gemma 3 et Phi 4 ; le sous-ensemble compatible iPhone est plus restreint. Moins de flexibilité que PocketPal AI, mais des modèles pré-optimisés pour le runtime de l'application.
- Shortcuts : selon le développeur, Private LLM s'intègre à l'application Shortcuts et peut transmettre ses réponses à d'autres applications compatibles avec la spécification x-callback-url. Utile pour déclencher l'IA locale depuis un bouton de l'écran d'accueil ou via des étiquettes NFC.
- Intégration Siri : le développeur mentionne l'intégration Siri ; une invite acheminée vers le modèle on-device fonctionne sans connexion internet (internet n'est requis que pour le premier téléchargement du modèle).
💡Astuce: Selon privatellm.app, un seul achat de $4.99 couvre iPhone, iPad et Mac, et la fiche App Store indique que jusqu'à six membres de la famille peuvent l'utiliser via le partage familial. Ni abonnement ni achat intégré ne sont affichés — le prix indiqué est le coût total. Le développeur déclare qu'il n'y a ni compte, ni suivi, ni journaux.
Locally AI : application MLX gratuite de LM Studio
Locally AI est une application de chat gratuite (sa fiche indique qu'elle ne collecte aucune donnée), développée par l'équipe LM Studio (listée sous Element Labs Inc) et construite sur le framework Apple MLX plutôt que sur llama.cpp. C'est la seule application ici à exposer le modèle de fondation on-device d'Apple comme interface de chat. Test complet : Test de Locally AI.
- Qu'est-ce que c'est : une application iOS/iPadOS/macOS utilisant Apple MLX pour l'inférence, développée par l'équipe derrière l'application de bureau LM Studio.
- Installation : App Store → « Locally AI ». Gratuit, aucun achat intégré affiché, aucun compte requis (selon la fiche), fonctionne hors ligne.
- Version et dernière mise à jour : v1.66.0, publiée le 15 octobre 2026 (historique des versions App Store) ; environ une version par mois en 2026 — pas d'avertissement d'obsolescence.
- Bibliothèque de modèles : Llama 3.2, Gemma 2/3/4, Qwen 3 et 3.5, DeepSeek, LFM 2.5, Bonsai, Ministral 3 et Apple Foundation Models — un catalogue plus large et plus récent que celui de MLC Chat.
- iOS Shortcuts : expose une action Shortcuts, à égalité avec l'automatisation de Private LLM, mais gratuitement.
- LM Link : une fonction optionnelle qui se connecte à LM Studio sur un Mac via ce que LM Studio décrit comme une liaison chiffrée de bout en bout, permettant à l'application iPhone de basculer vers un modèle plus grand sur une machine domestique si nécessaire.
- Prérequis : iOS/iPadOS 18.1 ou plus (macOS 26.0 ou plus pour la version Mac). Les gains d'efficacité d'Apple Silicon sont les plus marqués à partir de l'iPhone 15 Pro.
💡Astuce: Locally AI est la seule application de ce guide capable de placer le propre modèle de fondation on-device d'Apple derrière une fenêtre de chat classique — utile pour tester ce que peut faire le modèle d'Apple Intelligence sans fouiller les menus des Outils d'écriture. Pour la flexibilité GGUF tierce, PocketPal AI garde le plus grand catalogue de modèles.
Google AI Edge Gallery : l'application Gemma 4 gratuite de Google
Google AI Edge Gallery est l'application gratuite de Google pour exécuter ses modèles Gemma 4 sur téléphone, et elle est disponible sur l'App Store iPhone. La fiche mentionne un chat IA avec mode réflexion, des agent skills, l'entrée image et audio, Prompt Lab et le benchmark de modèles. Google indique que l'application est en développement actif. Test complet : Test de Google AI Edge Gallery.
- Qu'est-ce que c'est : l'application vitrine de Google pour l'IA on-device, construite sur le runtime LiteRT-LM de Google. Gratuite ; aucun achat intégré affiché.
- Installation : App Store → « Google AI Edge Gallery ». Requiert iOS 17.0 ou plus. Les modèles se téléchargent séparément dans l'application.
- Version et dernière mise à jour : v1.0.13, publiée le 8 octobre 2026 (historique des versions App Store). Le support de Gemma 4 est arrivé avec la v1.0.2 le 3 avril 2026 — pas d'avertissement d'obsolescence.
- Modèles : la famille Gemma 4 (E2B et E4B sont les variantes adaptées aux téléphones ; Google indique des fichiers LiteRT-LM d'environ 2.58 Go et 3.65 Go), EmbeddingGemma 2 et FunctionGemma 270M. Les modèles au format LiteRT-LM peuvent aussi être importés depuis Hugging Face.
- Fonctions : Thinking Mode (modèles Gemma 4 uniquement), Agent Skills (par exemple recherche Wikipédia et cartes, plus des skills communautaires), Ask Image, Audio Scribe, Prompt Lab et benchmark de modèles.
- Limites : uniquement des modèles LiteRT-LM, pas GGUF ni MLX ; la fiche ne mentionne ni Shortcuts ni Siri ; PromptQuorum n'a pas de chiffres de vitesse pour cette application.
- Idéal pour : les utilisateurs qui veulent le Gemma 4 de Google avec un mode de raisonnement visible et des outils d'agent, sans frais.
💡Astuce: Google indique une mémoire de pointe d'environ 607 Mo sur CPU et 1 450 Mo sur GPU pour Gemma 4 E2B sur un iPhone 17 Pro (chiffres du fournisseur, d'après la page LiteRT-LM Gemma 4 de Google ; non remesurés par PromptQuorum). E2B est le point de départ pratique pour la plupart des téléphones ; E4B convient aux iPhone 8 Go+.
MLC Chat : optimisé pour Apple Silicon
Avertissement d'obsolescence : l'app iPhone MLC Chat n'a reçu aucune mise à jour depuis la version 1.6 du 27 septembre 2024 (plus de deux ans), elle n'est donc peut-être plus maintenue — vérifiez avant de vous y fier. Le dépôt du moteur MLC LLM reste actif sur GitHub (dernière activité le 6 octobre 2026). MLC Chat est gratuit, open source, et exécute des modèles compilés par la chaîne d'outils MLC LLM plutôt que des GGUF standard, et son catalogue n'a pas suivi celui de PocketPal AI ou de Locally AI. Test complet : Test de MLC Chat.
- Qu'est-ce que c'est : l'application iOS de référence du projet MLC LLM, qui démontre l'inférence accélérée par Metal de MLC LLM sur Apple Silicon.
- Installation : App Store → « MLC Chat ». Gratuit. Requiert iOS/iPadOS 17.0 ou plus.
- Version et dernière mise à jour : v1.6, publiée le 27 septembre 2024 (historique des versions App Store ; ajout de Llama 3.2 3B). Auparavant : la 1.5 a ajouté Gemma 2 2B (août 2024), la 1.4 a ajouté Phi-3, Mistral v3 et Qwen2 (juin 2024). Dernière mise à jour iPhone il y a plus de deux ans — avertissement d'obsolescence activé.
- Vitesse (affirmation du projet, non mesurée ici) : le projet MLC LLM décrit son moteur accéléré par Metal comme plus rapide que les applications basées sur llama.cpp sur le même iPhone — mais la liste de modèles de l'application précède des choix actuels comme Phi-4 Mini et Gemma 3, si bien que cet avantage est invérifiable sur les modèles recommandés en 2026 sans version compilée soi-même.
- Bibliothèque de modèles : limitée aux modèles compilés par le projet MLC LLM avant que l'application ne devienne inactive — Llama 3.2 3B, Gemma 2 2B, Phi-3, Mistral v3, Qwen2 et autres versions de 2024. Tous les GGUF Hugging Face ne fonctionnent pas, et aucun petit modèle de génération actuelle n'est fourni dans la version App Store.
- Idéal pour : les développeurs déjà investis dans la chaîne d'outils MLC LLM, prêts à compiler leur propre modèle, ou ayant spécifiquement besoin de l'un des modèles d'avant 2025 qu'elle fournit déjà.
⚠️Attention: Comme la version App Store de MLC Chat n'a reçu aucune mise à jour depuis le 27 septembre 2024, n'attendez pas Phi-4 Mini, Qwen3 ou Gemma 3 dans son sélecteur. Si vous voulez aujourd'hui des modèles de génération actuelle avec une efficacité GPU de classe Metal, Locally AI (Apple MLX), PocketPal AI (llama.cpp avec Metal Performance Shaders) ou Google AI Edge Gallery (Gemma 4) sont les alternatives activement maintenues.
LLM Farm : absent de l'App Store, sources toujours disponibles
Avertissement d'obsolescence : la dernière version de LLM Farm (1.4.3) date du 27 janvier 2025 et son dernier push de code du 30 janvier 2026 — près de neuf mois sans mise à jour — il n'est donc peut-être plus maintenu. Le test PromptQuorum du projet date son retrait de l'App Store d'août 2025 ; son propre README GitHub décrit l'application comme « temporairement indisponible » sur l'App Store et TestFlight. Le projet (GitHub : guinmoon/LLMFarm) reste open source et a connu une activité d'issues GitHub jusqu'en octobre 2026, mais les nouveaux utilisateurs ne peuvent plus l'installer depuis l'App Store ; il faut le compiler depuis les sources via Xcode (README : macOS 13+ et iOS 16+). Test complet : Test de LLM Farm.
- Qu'est-ce que c'est : une application iOS du mainteneur du projet qui exécute des modèles GGUF avec de nombreuses options de configuration, auparavant distribuée sur l'App Store.
- Disponibilité actuelle : non installable depuis l'App Store ni TestFlight à la date de cette mise à jour. Le code source reste public et compilable.
- Compiler depuis les sources : clonez le dépôt, ouvrez-le dans Xcode et compilez sur un appareil avec un compte Apple Developer gratuit ou payant — le flux de chargement latéral standard pour toute application iOS open source sans fiche App Store.
- Configuration exposée (une fois compilée) : température, top-p, top-k, échantillonnage mirostat, pénalité de répétition, invite système par modèle, choix du modèle de chat, longueur de la fenêtre de contexte.
- Idéal pour : les développeurs à l'aise avec la compilation d'une application depuis les sources dans Xcode qui veulent spécifiquement les contrôles d'échantillonnage mirostat. Tous les autres devraient utiliser PocketPal AI ou Locally AI, toutes deux entièrement installables depuis l'App Store et gratuites.
⚠️Attention: Ne comptez pas sur un lien App Store pour LLM Farm — tout lien de ce type trouvé ailleurs est obsolète. Compiler depuis les sources demande Xcode et des notions de base de signature de code iOS. Si c'est plus d'efforts que vous ne le souhaitez, PocketPal AI couvre le même usage d'application de chat gratuite et flexible sans quitter l'App Store.
Apple Intelligence : IA on-device intégrée au système
Apple Intelligence exécute le propre modèle de fondation d'environ 3B d'Apple on-device sur iPhone 15 Pro et les modèles plus récents (génération iPhone 15 Pro, 8 Go de RAM selon la presse ; Apple ne communique pas la RAM). Par défaut, ce n'est pas une application de chat — il alimente des fonctions système dans Mail (Réponse intelligente), Messages (outils d'écriture), Notes (synthèse) et les Résumés de notifications. Depuis iOS 26, le framework Foundation Models d'Apple permet aux développeurs tiers d'appeler directement ce même modèle on-device, et des applications comme Locally AI l'utilisent pour offrir une véritable interface de chat. iOS 27 étend le framework : selon le guide développeur d'Apple, les applications peuvent utiliser tout modèle de langage conforme à son protocole de modèles de langage, y compris les modèles d'Apple et des modèles cloud.
- Où il se trouve : intégré à iOS 18+ (framework Foundation Models ajouté avec iOS 26). À activer dans Réglages → Apple Intelligence et Siri.
- Matériel requis : iPhone 15 Pro / 15 Pro Max, série iPhone 16, iPhone 16e, série iPhone 17, et pour 2026 les iPhone 18 Pro, 18 Pro Max et iPhone Duo (A20 Pro). Les iPhone antérieurs (14 et inférieurs) ne prennent pas en charge Apple Intelligence. Consultez la liste de compatibilité actuelle d'Apple pour iOS 27 avant d'acheter.
- Siri AI (iOS 27) : Apple décrit Siri AI comme disponible en bêta dans iOS 27, déployé d'abord en anglais, non disponible initialement dans l'UE sur iOS, et soumis à des limites d'usage quotidiennes pour certaines fonctions côté serveur. Il est distinct des applications de chat on-device de ce guide.
- Fonctions on-device : Outils d'écriture (réécrire, résumer, relire) dans tout champ de texte, Réponse intelligente dans Mail et Messages, Résumés de notifications, génération de Genmoji.
- Framework Foundation Models (iOS 26+) : une API Swift native qui donne aux développeurs un accès direct au même modèle on-device en quelques lignes de code — c'est ainsi que Locally AI l'expose comme option de chat, et que l'action Shortcuts « Utiliser le modèle » peut lui acheminer une invite, ou la diriger vers Private Cloud Compute ou ChatGPT.
- Private Cloud Compute : pour les tâches qui dépassent le modèle on-device, Apple Intelligence peut envoyer la requête à Private Cloud Compute (PCC) — des serveurs exploités par Apple qui exécutent des modèles plus grands dont Apple indique qu'ils ne conservent aucune donnée utilisateur. Consultez la documentation d'Apple sur Apple Intelligence et la confidentialité pour connaître les réglages disponibles sur votre appareil.
- Relation avec les applications de chat : Apple Intelligence est un complément, pas un remplacement. Ses fonctions système gèrent la réécriture et la synthèse de texte dans les applications iOS ; PocketPal AI, Private LLM, Locally AI et MLC Chat offrent une interface de chat dédiée pour des questions libres — et Locally AI peut désormais placer le modèle d'Apple derrière cette même interface.
💡Astuce: Si Apple Intelligence est votre seul besoin (réécrire des e-mails, résumer des notifications), vous n'avez pas besoin d'une application de chat séparée. Si vous voulez poser au modèle des questions comme « explique l'effet tunnel en termes simples » ou « rédige un plan de projet pour X », installez une application de chat — une application dédiée comme PocketPal AI, ou Locally AI, qui peut placer le modèle on-device d'Apple derrière une fenêtre de chat.
MemoryAI : chat hors ligne avec mémoire modifiable (non mesuré)
MemoryAI est une application de chat gratuite et hors ligne pour iPhone, avec questions sur vos documents, une mémoire modifiable sur l'appareil et un Kid Mode protégé par PIN. Elle a été ajoutée après la comparaison principale : elle ne figure donc pas dans le tableau comparatif et n'a pas fait partie de nos tests.
- Bibliothèque de modèles : les modèles se téléchargent dans l'application (0,3 à 4 Go chacun) et des fichiers GGUF personnalisés peuvent être importés depuis Hugging Face. Elle utilise deux moteurs d'inférence : llama.cpp et LiteRT de Google.
- Fonctions : questions sur vos documents, une mémoire d'agent que vous pouvez ouvrir, modifier et supprimer, un mode vocal mains libres (saisie vocale et lecture à voix haute sur l'appareil), la compréhension d'images avec des modèles de vision et un Kid Mode verrouillé par un code PIN parental.
- Prérequis et prix : iOS 16.4+, 4 Go de RAM minimum. Gratuite, sans publicité, abonnement ni achat intégré.
- Confidentialité et licence : les conversations, documents et souvenirs restent sur l'appareil après le téléchargement du modèle. L'application envoie des événements d'usage et des rapports de plantage (sans contenu des conversations, selon le développeur) et son code est fermé.
- Installation : App Store. Première version publiée le 30 mars 2026 : c'est donc une application jeune. L'App Store affiche la version 1.0.60.
💡Astuce: Les informations ci-dessus proviennent des fiches des stores, de la politique de confidentialité et du développeur, qui a relu notre texte ; nous n'avons pas chronométré MemoryAI sur nos téléphones de test. Notes complètes : test de MemoryAI.
fullmoon : chat gratuit et open source sur Apple MLX (aucune version depuis début 2025)
fullmoon est une application de chat hors ligne gratuite, sous licence MIT, pour iPhone, iPad et Mac, qui exécute de petits modèles via MLX d’Apple ; elle n’a toutefois reçu aucune version depuis le 28 janvier 2025 ni aucune modification de code depuis le 5 mai 2025 et n’est peut-être plus maintenue. Elle a été ajoutée après la comparaison principale et n’a donc pas fait partie de nos tests.
- Modèles : Llama 3.2 1B et 3B et deux builds de DeepSeek-R1-Distill-Qwen-1.5B (0.7–1.9 GB chacun), d’après le site.
- Fonctions : prompt système modifiable, thème et polices, et une action Raccourcis ; l’historique est stocké localement (README).
- Prérequis et prix : iOS 17.6+, 31.6 MB avant le téléchargement des modèles. Gratuite au téléchargement.
- Confidentialité et licence : la politique dit que rien n’est collecté mais énumère aussi des usages des données collectées, ce qui la rend contradictoire. Le code source est public sous licence MIT.
- Installation : App Store (version 1.2.0) ; le site propose aussi un lien TestFlight pour les versions plus récentes.
💡Astuce: Les informations ci-dessus proviennent du site de l’éditeur, de la fiche App Store, de la politique de confidentialité et du dépôt public ; nous n’avons pas fait tourner fullmoon sur nos téléphones de test. Détails : test de fullmoon.
Cloak: Local AI : chat hors ligne à achat unique (non mesuré)
Cloak: Local AI est une appli de chat hors ligne à achat unique pour iPhone et iPad, avec mémos vocaux et un Recap hebdomadaire. Elle a été ajoutée après la comparaison principale : elle ne figure donc pas dans les chiffres de vitesse et n’a pas fait partie de nos tests.
- Bibliothèque de modèles : l’appli télécharge un modèle recommandé depuis Hugging Face lors de la configuration ; il n’y a pas de sélecteur de modèle, et le nom et la taille du modèle ne sont pas publiés.
- Fonctions : plusieurs fils de discussion locaux, un prompt système personnalisable, des mémos vocaux transformés en notes ou en conversations, et Recap, un résumé des sept derniers jours à partir de Photos, de la localisation et des mémos vocaux. Une version Mac distincte, Cloak: Local AI Chat, ne propose que le chat.
- Prérequis et prix : iOS ou iPadOS 18.0+. Achat unique à 1,99 € sur l’App Store français, sans abonnement et sans achat intégré indiqué.
- Confidentialité et licence : selon la politique, les conversations restent sur l’appareil après le téléchargement du modèle. La version iPhone envoie une réponse facultative à un sondage de configuration et, uniquement si vous l’activez, des compteurs quotidiens d’usage ; elle est à source fermée.
- Installation : App Store. Première sortie le 25 juin 2026 ; l’App Store affiche la version 1.2.9, sortie le 27 octobre 2026.
💡Astuce: Ces informations proviennent des fiches de l’App Store, du site de Polyaura et de sa politique de confidentialité ; le développeur n’a pas été contacté et nous n’avons pas mesuré Cloak sur nos téléphones de test. Notes complètes : test de Cloak: Local AI.
Reins : client de chat pour votre serveur Ollama ou LM Studio (non mesuré)
Reins est une appli de chat gratuite pour iPhone et iPad qui se connecte à votre propre serveur Ollama, LM Studio ou compatible OpenAI et, depuis la version 2, peut aussi exécuter des modèles MLX sur l’appareil. Elle a été ajoutée après le comparatif principal ; elle ne figure donc pas dans le tableau comparatif et n’a pas fait partie de nos tests.
- Bibliothèque de modèles : les modèles MLX sur l’appareil se téléchargent dans l’appli depuis Hugging Face, et tout modèle MLX peut être recherché et téléchargé ; les Apple Foundation Models sont aussi pris en charge.
- Fonctions : appels d’outils, recherche web intégrée sans clé d’API, pièces jointes image, PDF, CSV et texte, branches de chat, mode réflexion et chats temporaires.
- Configuration et prix : iOS 17.0 ou ultérieur (la génération en arrière-plan exige iOS 26). Téléchargement gratuit, avec Reins Pro en achat intégré mensuel, annuel ou à vie ; les sources n’énumèrent pas ce que Pro débloque.
- Confidentialité et licence : le développeur affirme qu’il n’y a ni connexion, ni analytique, ni collecte de données. La version 2 est fermée ; le dépôt public ne contient le code que jusqu’à la version 1.3.4.
- Installation : App Store. L’App Store indique la version 2.3.3, publiée le 21 octobre 2026.
💡Astuce: Ces informations viennent de la fiche de l’App Store, du site et des politiques du développeur ; nous n’avons pas mesuré Reins sur nos téléphones de test. Notes complètes : test de Reins.
Modèles par génération d'iPhone
La RAM de l'iPhone fixe la taille maximale du modèle — pas la génération de puce. Un iPhone 6 Go (14 Pro, 15) exécute confortablement des modèles 1.7B ; un iPhone 8 Go+ (15 Pro, série 16, 16e, série 17) exécute confortablement des modèles 3B–4B et lentement des modèles 7B. Petits modèles récents à essayer en plus de Phi-4 Mini : Gemma 4 E2B et E4B (Google, avril 2026 ; environ 2.58 Go et 3.65 Go en fichiers LiteRT-LM) et la série Qwen3.5 (Alibaba, mars 2026 ; 0.8B, 2B, 4B et 9B, Apache 2.0 selon la synthèse Artificial Analysis). PromptQuorum n'a pas de chiffres de vitesse pour eux ; Locally AI et Google AI Edge Gallery les proposent directement. Pour le panorama plus large des modèles sur tout le matériel (pas seulement mobile), voir Meilleurs LLM locaux en 2026.
Niveau iPhone (Année, RAM) | Modèle recommandé | Taille de téléchargement | Vitesse (indicative) |
|---|---|---|---|
| iPhone 18 Pro / Pro Max (2026, ~12 Go selon la presse) | Comme le 17 Pro ; RAM non publiée par Apple | ~2.5–3.7 Go | Aucun chiffre |
| iPhone 17 Pro / 17 Pro Max (2025, 12 Go) | Phi-4 Mini / Llama 3.2 3B / Gemma 4 E4B | ~2.5–3.7 Go | ~13–20 tok/sec (Phi-4 Mini) |
| iPhone série 16 / 16e / 17 (2024–2025, 8 Go) | Phi-4 Mini (3.8B Q4_K_M) ou Gemma 4 E2B | ~2.6–2.7 Go | ~10–15 tok/sec (Phi-4 Mini) |
| iPhone 15 Pro / Pro Max (2023, 8 Go) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 Go | ~8–12 tok/sec |
| iPhone 13 Pro / 14 Pro / Pro Max (6 Go) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 Go | ~15–20 tok/sec |
| iPhone 14 / 14 Plus / 15 / 15 Plus (6 Go) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 Go | ~12–18 tok/sec |
| iPhone 13 / 12 / SE / anciens (4 Go) | Non recommandé pour un LLM on-device | — | — |

💡Astuce: Pour les anciens iPhone 6 Go, Qwen3 1.7B ou SmolLM 2 1.7B (HuggingFace) sont des choix raisonnables en 2026 ; Qwen3.5 2B et Gemma 4 E2B sont des options plus récentes de même taille. Ces petits modèles produisent des réponses courtes cohérentes (1–3 paragraphes) mais peinent sur le raisonnement multi-étapes. N'installez pas Phi-4 Mini sur un iPhone 6 Go — il tient nominalement, mais iOS arrêtera l'application à la moindre pression mémoire. Les chiffres de vitesse du tableau sont des plages indicatives arrondies pour Phi-4 Mini, Llama 3.2 3B et Qwen3 1.7B, non rattachées à une version d'application ou à une date de test ; Gemma 4 et Qwen3.5 n'ont pas de chiffres ici. Les pages produit d'Apple n'indiquent pas la RAM des iPhone : les chiffres de RAM ici sont des caractéristiques largement rapportées, et les ~12 Go de l'iPhone 18 Pro viennent de la presse.
Autonomie et surchauffe
L'inférence LLM on-device sur iPhone sollicite fortement le CPU/GPU et produit de la chaleur. À titre indicatif (ordre de grandeur, pas une mesure de PromptQuorum), l'inférence active consomme ~3–5 W ; une génération soutenue fait ralentir la puce et peut vider la batterie d'environ 20–30 % par heure sur iPhone 16 Pro.
- Consommation de batterie (chat actif, indicative) : ~20–30 % par heure sur iPhone 16 Pro avec Phi-4 Mini.
- Une génération soutenue peut déclencher une limitation thermique. Quand la puce chauffe, iOS réduit les fréquences d'horloge et les tokens/sec baissent. Le moment où cela commence et la perte de vitesse dépendent du téléphone, de l'étui, de la charge et de la température ambiante ; PromptQuorum ne l'a pas mesuré. Laisser le téléphone refroidir restaure la vitesse.
- Atténuation : gardez l'iPhone écran vers le haut sur une surface dure (pas dans la main ni la poche) pendant les longues sessions pour dissiper la chaleur. Un étui dissipateur passif aide mais est rarement nécessaire pour de courtes interactions.
- Consommation fantôme : si vous laissez une application de chat ouverte en arrière-plan après la génération, la RAM reste allouée mais aucune inférence ne tourne — l'impact sur la batterie est minimal. Fermer complètement l'application libère les ~3 Go de RAM.
- Charge MagSafe pendant l'inférence : recharger pendant la génération peut échauffer l'appareil ; si le téléphone chauffe, interrompez la charge ou la génération, ou chargez après.

⚠️Attention: N'exécutez pas d'inférence LLM on-device sur un iPhone en plein soleil ou dans une voiture chaude. En plein soleil ou dans une voiture chaude, la puce peut atteindre plus tôt ses limites thermiques, ce qui peut déclencher une limitation et l'avertissement d'Apple « L'iPhone doit refroidir ». En général, la génération ralentit plutôt que l'application ne se ferme.
Raccourcis iOS, Siri et chargement latéral
L'intégration iOS varie beaucoup selon les applications. Private LLM et Locally AI prennent tous deux en charge Shortcuts ; PocketPal AI, Google AI Edge Gallery et MLC Chat sont des applications de chat autonomes sans Shortcuts ni Siri mentionnés dans leur README ou leur fiche App Store.
Raccourci Private LLM : résumer le texte sélectionné
“1. Action : « Obtenir le texte sélectionné » (entrée Share Sheet iOS). 2. Action : génération de texte Private LLM (parmi les actions Shortcuts de l'app Private LLM) → Invite : « Résume le texte suivant en trois points clés : [Texte sélectionné] » → choisissez un modèle installé dans l'app. 3. Action : « Afficher le résultat » ou « Copier dans le presse-papiers ». Ajoutez-le à la Share Sheet pour l'exécuter sur tout texte sélectionné dans n'importe quelle application, sur l'appareil et sans WiFi. Les noms d'action suivent la description du développeur et peuvent différer selon la version de l'app.”
Raccourci Apple Intelligence : réécrire sur un ton professionnel
“1. Action : « Obtenir le presse-papiers ». 2. Action : « Utiliser le modèle » → Modèle : On-device → Invite : « Réécris ceci sur un ton professionnel et concis : [Presse-papiers] ». 3. Action : « Copier dans le presse-papiers ». Assignez-le à un widget de l'écran verrouillé pour réécrire en un tap tout ce que vous copiez.”
- Private LLM s'intègre à Shortcuts et à Siri, selon le développeur, et peut transmettre ses réponses aux applications compatibles x-callback-url. L'application de chat la plus native pour iOS ici.
- Locally AI expose gratuitement une action Shortcuts et peut acheminer un raccourci vers le propre modèle on-device d'Apple via son intégration du framework Foundation Models — pas de déclencheur vocal Siri, mais une automatisation Shortcuts sans payer.
- PocketPal AI est une application de chat autonome — son README ne mentionne ni action Shortcuts ni intégration Siri. Vous ouvrez l'application et vous discutez.
- Google AI Edge Gallery est une application de chat et de démonstration autonome — sa fiche App Store ne mentionne ni action Shortcuts ni intégration Siri.
- MLC Chat est une application de référence pour le projet MLC LLM — intégration iOS minimale et aucune mise à jour iPhone depuis septembre 2024. Pas d'action Shortcuts.
- LLM Farm n'est actuellement pas sur l'App Store et, une fois compilé depuis les sources, n'a pas d'action Shortcuts.
- Apple Intelligence s'intègre à iOS Shortcuts via l'action « Utiliser le modèle » (iOS 18.4+, étendue avec le framework Foundation Models dans iOS 26). Elle achemine une invite vers le modèle on-device, Private Cloud Compute ou ChatGPT (configurable). La sortie on-device peut être enchaînée avec d'autres actions Shortcuts.
- Chargement latéral : PocketPal AI, Private LLM, Locally AI, Google AI Edge Gallery et MLC Chat sont sur l'App Store et n'exigent ni chargement latéral ni jailbreak ; Apple Intelligence est intégré à iOS. LLM Farm fait exception — l'installer exige désormais une compilation depuis les sources dans Xcode. Dans l'UE, des marketplaces d'applications alternatives existent en vertu du DMA, mais les applications qu'elles proposent dépendent de chaque développeur : installez depuis le canal officiel du développeur ; aucune de ces applications n'en a besoin.

💡Astuce: Pour une utilisation mains libres en conduisant ou en cuisinant, l'intégration Siri de Private LLM est la seule application de chat de ce guide dont le développeur indique une intégration Siri, ce qui permet de l'utiliser sans toucher le téléphone. Apple Intelligence prend en charge la voix via Siri, mais uniquement pour les tâches système (écriture, synthèse, actions d'application) — il n'expose pas de Q&R général comme les applications de chat.
Erreurs fréquentes
- Installer un modèle plus grand que ce que la RAM de votre iPhone permet. Un modèle 7B sur un iPhone 8 Go est souvent trop lent pour le chat et peut être fermé par iOS quand il récupère la mémoire pour une autre application ; mesurez-le d'abord avec le benchmark intégré de PocketPal AI. Respectez le modèle recommandé pour votre niveau d'iPhone (3B–4B pour les appareils 8 Go, 1.7B pour les appareils 6 Go).
- Attendre d'un modèle on-device la qualité d'une IA cloud. Phi-4 Mini (3.8B) est impressionnant pour sa taille mais n'est pas GPT-5.5. Utilisez-le pour le chat, la synthèse, la rédaction et les Q&R rapides — pas pour le raisonnement multi-étapes, la génération de code complexe ou l'écriture créative nuancée.
- Exécuter l'inférence en plein soleil ou dans une voiture chaude. La limitation thermique peut intervenir rapidement, la génération ralentit et l'avertissement « L'iPhone doit refroidir » peut apparaître. Exécutez l'inférence à température ambiante.
- Laisser 3+ applications de chat installées avec des modèles de 3 Go dans chacune. Vous consommerez ~10 Go de stockage en modèles dupliqués. Choisissez une application et un modèle ; désinstallez les autres tant que vous n'êtes pas sûr d'en avoir besoin.
- Supposer qu'Apple Intelligence n'a aucune interface de chat. C'était vrai jusqu'à iOS 18, mais depuis iOS 26 des applications comme Locally AI peuvent placer le modèle on-device d'Apple derrière une vraie fenêtre de chat via le framework Foundation Models. Les fonctions système (Outils d'écriture, Réponse intelligente) ne sont toujours pas une interface de chat en soi.
- Chercher LLM Farm sur l'App Store. Il n'y est actuellement pas (le test PromptQuorum de LLM Farm date son retrait d'août 2025). Le chercher sur l'App Store fait perdre du temps ; utilisez PocketPal AI pour le même usage gratuit et flexible, ou compilez LLM Farm depuis les sources dans Xcode si vous avez spécifiquement besoin de ses contrôles mirostat.
- Croire que « gratuit » signifie « sans achat ». PocketPal AI est gratuit pour le chat local mais vend du contenu premium optionnel (Pals et « PocketPal Plus »), tandis que Locally AI et Google AI Edge Gallery n'affichent aucun achat intégré. Consultez la section des achats intégrés de la fiche avant d'installer (la fiche App Store US de PocketPal AI affichait une classification d'âge 18+ le 23 octobre 2026).
- Juger un modèle sur un seul tableau de vitesses. Les plages de tokens/sec de ce guide sont indicatives, et des modèles plus récents comme Gemma 4 et Qwen3.5 n'y figurent pas. Lancez la même invite sur deux modèles dans le benchmark de PocketPal AI avant de supprimer celui que vous avez déjà téléchargé.
Sources
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai (README, licence MIT, version v1.20.1 du 19 octobre 2026) et fiche App Store (historique des versions, achats intégrés, classification d'âge, iOS 15.1+). Consulté le 23 octobre 2026.
- Private LLM — fiche App Store (v1.9.16, $4.99, iOS 17.0+, partage familial) et privatellm.app (Siri et Shortcuts, liste de modèles, un achat pour iPhone, iPad et Mac). Consulté le 23 octobre 2026.
- Locally AI — fiche App Store (v1.66.0, gratuit, Element Labs Inc, iOS 18.1+ ; équipe LM Studio) et lmstudio.ai/locally (LM Link). Consulté le 23 octobre 2026.
- Google AI Edge Gallery — fiche App Store (v1.0.13, gratuit, iOS 17.0+, Gemma 4, Agent Skills, Thinking Mode), github.com/google-ai-edge/gallery et la page LiteRT-LM Gemma 4 de Google (tailles de fichiers et mémoire E2B/E4B, chiffres du fournisseur). Consulté le 23 octobre 2026.
- MLC Chat / projet MLC LLM — fiche App Store (v1.6, 27 sept. 2024, historique des versions), llm.mlc.ai et github.com/mlc-ai/mlc-llm (dépôt du moteur). Consulté le 23 octobre 2026.
- LLM Farm — github.com/guinmoon/LLMFarm (README : « temporairement indisponible » sur TestFlight et App Store ; version 1.4.3 du 27 janv. 2025 ; dernier push le 30 janv. 2026) et le test PromptQuorum de LLM Farm pour le retrait d'août 2025. Consulté le 23 octobre 2026.
- Apple Intelligence et modèles de fondation on-device — Apple Machine Learning Research, le guide développeur Nouveautés d'iOS 27 (framework Foundation Models), la page iPhone 18 Pro (A20 Pro, Neural Engine 16 cœurs double, bêta Siri AI, pas de chiffre de RAM) et la page iPhone Duo. Consulté le 23 octobre 2026.
- Série Qwen3.5 (0.8B–9B, mars 2026) — synthèse Artificial Analysis.
Questions fréquemment posées
L'iPhone peut-il vraiment faire tourner un modèle 7B ?
Techniquement oui sur iPhone 15 Pro et les modèles plus récents (8 Go de RAM), mais pas à une vitesse utilisable. Un modèle 7B Q4 sur iPhone 16 Pro est souvent trop lent pour un chat confortable (indicatif). iOS tend aussi à arrêter l'application quand d'autres ont besoin de mémoire. Utilisez des modèles 3B–4B (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) pour le chat on-device quotidien. Pour une qualité 7B+, connectez-vous à distance à un Mac ou PC domestique exécutant Ollama.
L'IA locale vide-t-elle la batterie de mon iPhone ?
Oui — l'inférence active consomme typiquement ~3–5 W et, à titre de repère indicatif approximatif, peut vider la batterie d'environ 20–30 % par heure sur iPhone 16 Pro. Pour un usage occasionnel (quelques invites), l'impact est faible. En usage soutenu (longue conversation, plusieurs synthèses), la batterie se vide vite ; charger pendant la génération peut ajouter de la chaleur, donc mettez la génération en pause si le téléphone chauffe. Le modèle simplement présent en RAM sans inférence a un impact négligeable sur la batterie.
Mon iPhone va-t-il chauffer avec l'IA locale ?
Oui, c'est possible, surtout lors d'une longue génération continue. iOS réduit les fréquences d'horloge quand la puce chauffe, ce qui fait baisser les tokens/sec ; le moment et l'ampleur varient selon le téléphone, l'étui, la charge et la température ambiante, et PromptQuorum ne les a pas mesurés. Pour limiter cela : gardez l'iPhone écran vers le haut sur une surface dure (pas dans la main) pendant les longues sessions et évitez le soleil direct. Les courtes interactions provoquent en général peu de chaleur notable.
Puis-je utiliser Siri avec un modèle local ?
Oui, avec Private LLM ($4.99 en achat unique). Le développeur indique qu'il s'intègre directement à Siri et à Shortcuts, de sorte qu'une invite peut être acheminée vers le modèle on-device sans connexion internet. PocketPal AI, Locally AI, Google AI Edge Gallery et MLC Chat ne mentionnent pas d'intégration vocale Siri, bien que Locally AI prenne en charge l'automatisation Shortcuts. Apple Intelligence s'intègre à Siri mais uniquement pour les tâches système (écriture, synthèse, actions d'application), pas pour le Q&R général ; Siri AI est une fonction bêta distincte d'iOS 27, d'abord en anglais et non disponible initialement dans l'UE.
Ces applications fonctionnent-elles sur iPhone SE ou les anciens iPhone ?
De façon limitée. L'iPhone SE et les iPhone 13 / 12 (4 Go de RAM) sont sous le seuil pratique pour les LLM on-device en 2026. Les iPhone 14 / 15 (non Pro, 6 Go de RAM) peuvent faire tourner des modèles 1.7B (Qwen3 1.7B, SmolLM 2 1.7B) mais pas 3B+. Les iPhone 13 Pro et 14 Pro (6 Go de RAM) restent aussi à 1.7B ; l'iPhone 15 Pro (8 Go de RAM) peut faire tourner des modèles 3B comme Phi-4 Mini à environ 8–12 tokens/sec (indicatif). Pour les anciens iPhone, le mieux est de se connecter à distance à un Mac ou PC domestique.
Puis-je synchroniser l'historique de chat entre iPhone et Mac ?
Pas dans PocketPal AI, Private LLM, Google AI Edge Gallery ni MLC Chat — l'historique est stocké localement sur chaque appareil, sans synchronisation iCloud. Private LLM et Locally AI fonctionnent aussi nativement sur Mac (avec Private LLM, un seul achat couvre iPhone, iPad et Mac), mais l'historique ne se synchronise toujours pas entre les copies iPhone et Mac. Pour un historique commun, l'approche pratique est d'exécuter Open WebUI sur un Mac domestique et d'y accéder depuis les navigateurs de l'iPhone et du Mac — Open WebUI stocke l'historique côté serveur.
Ces applications sont-elles disponibles en dehors de l'App Store ?
PocketPal AI est open source et peut être compilé depuis les sources via Xcode, mais la version App Store est la distribution standard. LLM Farm est l'exception qui doit désormais être compilée depuis les sources — il n'est actuellement ni sur l'App Store ni sur TestFlight (le README indique « temporairement indisponible »). Private LLM, Locally AI, Google AI Edge Gallery et MLC Chat sont uniquement sur l'App Store. Dans l'UE, des marketplaces d'applications alternatives existent en vertu du DMA, mais les applications qu'elles proposent dépendent de chaque développeur : installez depuis le canal officiel du développeur ; aucune de ces applications n'en a besoin.
L'une d'elles nécessite-t-elle un jailbreak ?
Non. PocketPal AI, Private LLM, Locally AI, Google AI Edge Gallery, MLC Chat et Apple Intelligence fonctionnent tous sur iOS standard. Compiler LLM Farm depuis les sources dans Xcode ne demande pas non plus de jailbreak — c'est le chargement latéral standard pour développeurs, pas un exploit. Le jailbreak n'est ni requis ni recommandé pour aucune de ces applications.
Puis-je utiliser l'IA locale dans iOS Shortcuts ?
Oui, via Private LLM (ses actions Shortcuts), Locally AI (une action Shortcuts gratuite) ou Apple Intelligence (l'action « Utiliser le modèle », iOS 18.4+, étendue avec iOS 26). PocketPal AI, Google AI Edge Gallery et MLC Chat ne mentionnent pas d'actions Shortcuts. Parmi les applications comparées ici, Locally AI est la seule option gratuite qui indique à la fois le support Shortcuts et l'accès au propre modèle on-device d'Apple.
Comment l'IA locale se compare-t-elle à l'application ChatGPT sur iPhone ?
Les modèles on-device (Phi-4 Mini, Llama 3.2 3B) restent nettement en retrait des modèles cloud de pointe pour le raisonnement complexe, les connaissances générales et les tâches multimodales, mais ils sont plus rapides sur les requêtes simples (pas d'aller-retour réseau) et, selon la documentation de chaque application, gardent la conversation sur l'appareil. Le compromis honnête : IA locale pour les tâches courantes et privées ; ChatGPT ou une autre application cloud pour les questions difficiles occasionnelles. Beaucoup d'utilisateurs en 2026 gardent les deux et choisissent selon la requête.
LLM Farm est-il encore sûr à utiliser maintenant qu'il n'est plus sur l'App Store ?
Le code source est public sur GitHub et reçoit encore de l'activité d'issues en 2026, mais la dernière version (1.4.3) date du 27 janvier 2025 et le dernier push de code du 30 janvier 2026 : il n'est peut-être plus maintenu. Compilé depuis les sources et chargé latéralement, il ne passe en outre plus par le processus de révision de l'App Store d'Apple. Si vous n'avez pas spécifiquement besoin de ses contrôles d'échantillonnage mirostat, PocketPal AI couvre le même usage gratuit, flexible et open source tout en restant sur l'App Store avec la révision standard d'Apple.
Lesquelles de ces applications iPhone sont gratuites ?
PocketPal AI est gratuit (licence MIT) avec des achats intégrés optionnels pour les Pals premium et « PocketPal Plus ». Locally AI et Google AI Edge Gallery sont gratuits sans achat intégré affiché. MLC Chat est gratuit. LLM Farm est gratuit mais doit être compilé depuis les sources. Private LLM coûte $4.99 en achat unique, sans achat intégré affiché. Apple Intelligence est intégré à iOS. Les prix ont été relevés sur l'App Store US le 23 octobre 2026 et peuvent différer selon le pays.
L'iPhone Duo ou l'iPhone 18 Pro peuvent-ils faire tourner un LLM local hors ligne ?
En principe oui : les deux utilisent la puce A20 Pro d'Apple, et les applications de ce guide fonctionnent sur tout iPhone respectant leur version minimale d'iOS. C'est la RAM qui détermine la taille du modèle, et les pages iPhone 18 Pro et iPhone Duo d'Apple n'indiquent pas de RAM ; la presse évoque 12 Go pour l'iPhone 18 Pro, ce qui n'est pas confirmé. PromptQuorum n'a pas de vitesses mesurées pour ces deux téléphones. Installez PocketPal AI et lancez son benchmark intégré pour voir ce que fait réellement votre téléphone.
Ces applications fonctionnent-elles sur iPad ?
Oui pour la plupart. PocketPal AI (iPadOS 15.1+, support complet de l'iPad selon son README), Private LLM (iPadOS 17.0+) et Locally AI (iPadOS 18.1+) indiquent un support iPad. La fiche de Google AI Edge Gallery exige iOS 17.0 ou plus ; vérifiez sa page pour votre iPad. Comme sur iPhone, la RAM détermine les modèles qui tiennent. Pour des conseils propres à l'iPad, voir Comment utiliser l'IA sur une tablette.
Pourquoi LLM Farm a-t-il disparu de l'App Store ?
Le README du projet indique : « The app is temporarily unavailable in TestFlight and Appstore. » PromptQuorum n'a pas trouvé de raison publique à ce retrait ; toute explication lue ailleurs n'est donc pas confirmée (voir le test de LLM Farm). Le code source reste public, mais la dernière version était la 1.4.3 du 27 janvier 2025. Pour une alternative gratuite installable depuis l'App Store, utilisez PocketPal AI ou Locally AI.
Existe-t-il une application Ollama pour iPhone ?
La page de téléchargement d'Ollama liste macOS, Windows et Linux, et aucune application iPhone. Pour utiliser des modèles Ollama ou LM Studio depuis un iPhone, exécutez le serveur sur un Mac ou un PC et connectez-vous depuis une application cliente ; Locally AI propose LM Link, que LM Studio décrit comme une connexion chiffrée vers LM Studio sur un Mac. Pour des modèles qui tournent entièrement sur le téléphone, utilisez les applications de ce guide.
Dois-je télécharger Gemma 4 ou Phi-4 Mini ?
PromptQuorum n'a pas de benchmark comparatif des deux sur iPhone. Faits utiles : Gemma 4 E2B et E4B sont les modèles de Google adaptés aux téléphones (environ 2.58 Go et 3.65 Go en fichiers LiteRT-LM dans Google AI Edge Gallery ; Locally AI liste aussi Gemma 4), tandis que Phi-4 Mini (3.8B Q4_K_M, ~2.7 Go) est le modèle sur lequel reposent les vitesses de ce guide. Sur un iPhone 8 Go, essayez les deux avec vos propres invites et comparez les tokens/sec dans le benchmark de PocketPal AI ; sur un iPhone 6 Go, restez sur des modèles de classe 1.7B.