Points clés
- LM Studio est le chemin le plus rapide de zéro à discussion locale. Téléchargez l'installateur depuis lmstudio.ai, ouvrez l'onglet Discover, cherchez « Phi-4 Mini », téléchargez et commencez à discuter. Moins de 10 minutes sur une connexion internet décente.
- Jan est l'alternative open-source. Même facilité d'utilisation que LM Studio, entièrement open-source, fonctionne sur AppImage Linux. Si vous préférez les logiciels open-source ou voulez voir le code source, Jan est le choix équivalent.
- GPT4All est l'expérience la plus simplifiée. Fenêtre de chat unique, recommandations de modèles curées, pas de frais généraux de navigation de modèles. Idéal pour les utilisateurs qui veulent poser une question et obtenir une réponse sans décisions de configuration.
- Commencez avec Phi-4 Mini ou Llama 3.2 3B sur n'importe quel matériel. Ces modèles 3B fonctionnent sur n'importe quel ordinateur portable fabriqué au cours des 7 dernières années — pas de GPU, pas de 32 GB de RAM, pas de matériel spécial. Ils sont plus lents qu'une IA cloud mais produisent des résultats utilisables pour la plupart des tâches quotidiennes.
- Aucun compte cloud requis. Après le téléchargement initial (l'application + le fichier modèle), tout fonctionne localement sans connexion internet. Pas de clé API, pas d'abonnement, pas de données envoyées à aucun serveur.
- Sur Apple Silicon, presque n'importe quel modèle fonctionne bien. Le MacBook Air M3 (8 GB) exécute Llama 3.2 3B et Phi-4 Mini couramment. Le M3 Pro ou M4 (16 GB+) exécute Qwen3 8B confortablement. Le M5 Max (64 GB) exécute les modèles 70B.
- LM Studio sert également une API locale. Si vous souhaitez ensuite connecter Obsidian, VS Code ou un autre outil à votre modèle local, l'onglet Local Server de LM Studio expose une API compatible OpenAI sur localhost — aucune configuration supplémentaire.
Faits rapides
- LM Studio : lmstudio.ai — Windows (x64, ARM), macOS (Apple Silicon, macOS 14+ ; pas de support Mac Intel), Linux (AppImage, .deb). Version actuelle : 0.4.x.
- Jan : jan.ai — Windows (x64), macOS (Apple Silicon, Intel), Linux (AppImage). Version actuelle : 0.8.x, Apache 2.0.
- GPT4All : gpt4all.io — Windows (x64, ARM), macOS (Apple Silicon, Intel), Linux (AppImage). Dernière version majeure : v3.10, début 2025 — développement au ralenti.
- Modèles recommandés : Phi-4 Mini (3,8B, ~2.7 GB) ou Gemma 4 E2B, Llama 3.2 3B (~2.2 GB), Qwen3 8B (~5 GB), gpt-oss 20B (~13 GB), Qwen 3.6 27B (~16 GB, meilleur modèle grand public).
- GPU optionnel : Tous trois supportent CUDA (NVIDIA) et Metal (Apple Silicon). GPU accélère 5–10x mais n'est pas nécessaire.
- RAM minimum : 6 GB pour modèles 3B–8B sans GPU. 4 GB pour Phi-4 Mini seul. 16 GB+ recommandé pour plusieurs modèles.
- Coût : Jan (Apache 2.0) et GPT4All (MIT) sont entièrement open-source ; LM Studio est gratuit mais à code source disponible. Aucun abonnement requis.
Les trois options comparées
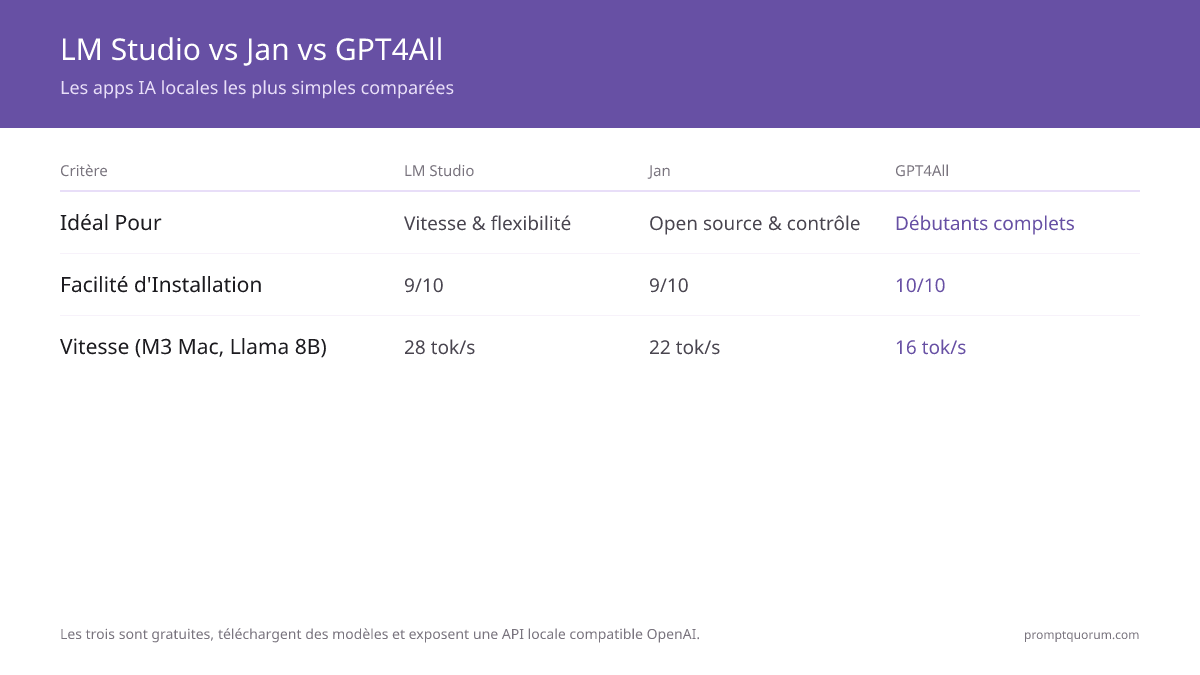
Quelle est la meilleure application pour vous ? Cela dépend de votre système d'exploitation, de votre matériel et de ce que vous valorisez — vitesse, interface utilisateur ou facilité d'installation.
Critère | |||
|---|---|---|---|
| Idéal pour | Vitesse et flexibilité | Open-source et contrôle | Débutants absolus |
| Facilité d'installation | 9/10 | 9/10 | 10/10 |
| Performance (M3 Mac, Llama 8B) | 28 tokens/sec | 22 tokens/sec | 16 tokens/sec |
| Licence | Propriétaire (gratuit) | Apache 2.0 | MIT (open-source) |
| Taille téléchargement | ~450 MB | ~380 MB | ~290 MB |
| API OpenAI locale | Oui (+ compatible Anthropic) | Oui | Oui |
| Développement actif | Fréquent (0.4.x, 2026) | Fréquent (0.8.x, 2026) | Au ralenti depuis début 2025 |

LM Studio : Guide d'installation
- 1Téléchargez LM Studio
Why it matters: LM Studio est l'application de bureau officielle pour Windows, Mac et Linux. Aucun terminal, aucune installation de dépendances. - 2Ouvrez l'onglet « Discover »
Why it matters: LM Studio inclut un navigateur de modèles intégré qui télécharge directement depuis Hugging Face. Pas de recherche manuelle, pas d'URLs d'extraction. - 3Cherchez « Phi-4 Mini » ou « Llama 3.2 3B »
Why it matters: Ces deux modèles sont optimisés pour les appareils bas de gamme et les ordinateurs portables. Phi-4 Mini est plus performant ; Llama 3.2 3B est plus polyvalent. - 4Cliquez sur « Load »
Why it matters: LM Studio téléchargera le modèle quantifié (Q4_K_M) et le chargera en mémoire. Cela prend quelques minutes selon votre connexion internet. - 5Tapez une question dans le chat
Why it matters: Une fois chargé, vous pouvez commencer à discuter immédiatement. Aucune autre étape. La première génération de réponse peut prendre 10–30 secondes selon votre matériel.

Jan : Guide d'installation
- 1Téléchargez Jan
Why it matters: Jan est l'alternative open-source la plus proche de LM Studio en termes de convivialité. Aucun terminal requis. - 2Ouvrez l'onglet « Hub »
Why it matters: Jan propose également un navigateur de modèles. L'interface est légèrement différente mais fonctionne de la même manière que LM Studio. - 3Cherchez « Phi-4 Mini » ou « Llama 3.2 3B »
Why it matters: Mêmes modèles recommandés. Jan télécharge également depuis Hugging Face via son backend. - 4Cliquez sur « Download »
Why it matters: Jan télécharge et configure le modèle. L'interface affiche la barre de progression. - 5Naviguez vers l'onglet « Chat » et commencez
Why it matters: Après téléchargement, le modèle est automatiquement disponible pour discussion.
GPT4All : Guide d'installation
- 1Téléchargez GPT4All
Why it matters: GPT4All est la plus ancienne et la plus simple des trois. Pas de terminal, installation standard. - 2Lancez GPT4All
Why it matters: L'interface est intentionnellement minimaliste — une seule fenêtre, aucun onglet ou menu complexe. - 3Sélectionnez un modèle recommandé dans le menu
Why it matters: GPT4All vous demande de choisir parmi 5–10 modèles pré-sélectionnés. Aucun choix de navigation. Choix simple : débutant-friendly. - 4Téléchargez et lancez
Why it matters: GPT4All télécharge et charge le modèle. C'est aussi simple que cela. - 5Commencez à discuter
Why it matters: Pas d'options supplémentaires. Juste une boîte de saisie et une fenêtre de réponse.

Quel modèle dois-je télécharger en premier ?
Choisissez en fonction de votre matériel. Les trois applications vous permettent de télécharger plusieurs modèles et de basculer entre eux.
- Matériel bas de gamme (8 GB RAM, pas de GPU) : Phi-4 Mini (3,8B, ~2.7 GB) ou Gemma 4 E2B. Le plus rapide sur appareils faibles. Comprend bien le code et les questions techniques.
- Matériel moyen (8–16 GB RAM, GPU optionnel) : Llama 3.2 3B ou Qwen3 8B. Bon équilibre entre vitesse et qualité. Recommandé pour la plupart des utilisateurs.
- Apple Silicon (M3, M4, M5, 16–32 GB) : gpt-oss 20B ou Qwen3 14B. Apple Silicon excelle grâce à la mémoire unifiée. Qualité et vitesse supérieures.
- NVIDIA RTX 3060 ou meilleur : Qwen3 8B ou gpt-oss 20B selon la VRAM disponible. Le GPU accélère ces modèles 5–10x par rapport au CPU seul.
- RTX 4090 ou Mac 32 GB+ : Qwen 3.6 27B — le meilleur modèle grand public en 2026 (77,2 % SWE-bench, Apache 2.0). Qualité proche du cloud, temps réel sur ce matériel.

Exigences matérielles
Les trois applications fonctionnent sur n'importe quel matériel moderne. Les modèles 3B fonctionnent sur les appareils bas de gamme. Les modèles 8B+ requièrent un minimum de 16 GB RAM. Note de plateforme : LM Studio nécessite Apple Silicon sous macOS — sur un Mac Intel, utilisez Jan ou GPT4All, qui prennent toujours en charge Intel via l'inférence CPU.
- Matériel minimum recommandé : MacBook Air M3 (8 GB), PC Windows avec Intel i7/i5 (16 GB RAM), ou ordinateur portable Linux équivalent.
- GPU recommandé : NVIDIA RTX 3060 ou meilleur (12+ GB VRAM) pour amélioration de vitesse 5–10x. Apple Silicon fournit l'amélioration équivalente via Metal.
- RAM : 8 GB minimum pour modèles 3B. 16 GB pour modèles 8B. 32+ GB pour modèles 70B.
- Stockage disque : 20–50 GB pour 3–5 modèles quantifiés.
- Processeur : CPU moderne (Intel i7 2019+, AMD Ryzen 5 2019+, ou Apple Silicon). Les CPU anciens fonctionnent mais sont lents.
- Aucune GPU requise pour commencer. Les modèles 3B–8B fonctionnent confortablement sur CPU moderne sans GPU.

Erreurs courantes
- Télécharger le modèle non-quantifié. Les modèles bruts sont 2–4 fois plus gros (16–32 GB). Toujours télécharger quantifiés : Q4_K_M, Q5_K_M ou Q3_K. LM Studio et Jan le font automatiquement ; GPT4All ne propose que des versions quantifiées.
- Ne pas attendre les paroles de "modèle chargé". LM Studio et Jan affichent une notification quand le modèle est prêt. Les messages d'erreur indiquent un chargement incomplet.
- Confondre mémoire VRAM avec RAM système. RTX 3060 VRAM (12 GB) est différente de votre RAM système (16 GB). Tous les deux sont utilisés lors du chargement du modèle. Chaque application montre l'utilisation ; surveiller pour éviter les blocages.
- Penser qu'une GPU est obligatoire. Phi-4 Mini et Llama 3.2 3B fonctionnent bien sur CPU. GPU accélère environ 5–10x, mais n'est pas une exigence pour commencer.
- Bloquer sur la première réponse lente. La première exécution d'un modèle peut prendre 30–60 secondes (compilation du code). Les exécutions ultérieures sont rapides (~1–2 tokens/sec sur CPU, 20–50 tokens/sec sur GPU).
Sources
- LM Studio — Application de bureau officielle avec navigateur de modèles intégré ; changelog de la version 0.4.
- Jan — Alternative open-source (Apache 2.0) à LM Studio.
- GPT4All — Application la plus simple pour débutants ; dépôt et historique des versions.
- Hugging Face — Dépôt principal pour modèles GGUF open-source.
- llama.cpp — Moteur d'inférence de bas niveau utilisé par LM Studio, Jan et GPT4All.
- Ollama — Alternative en ligne de commande pour développeurs et power users.
Questions fréquemment posées
Quelle application est la plus rapide ?
LM Studio est le plus rapide en général — il expose les paramètres GPU et de quantification, et dispose du meilleur support batch pour NVIDIA. Jan est très proche. GPT4All est le plus lent mais toujours utilisable sur matériel moderne.
Puis-je utiliser l'une de ces applications sans internet après le téléchargement initial ?
Oui. Les trois fonctionnent entièrement hors ligne une fois les modèles téléchargés. Idéal pour la confidentialité et les environnements sans internet.
Quelle est la différence entre GGUF, GPTQ et d'autres formats ?
GGUF est le format principal supporté par les trois applications. C'est le plus compatible et le plus facile à quantifier. GPTQ est un format plus ancien et moins couramment vu maintenant. Vous n'avez pas besoin de connaître la différence — les trois applications gèrent automatiquement.
Puis-je connecter mon modèle local à d'autres applications ?
Oui. Le Local Server de LM Studio expose une API compatible OpenAI et Anthropic sur localhost:1234, et Jan une API compatible OpenAI sur localhost:1337. Vous pouvez pointer Obsidian, VS Code, ou d'autres outils vers ces endpoints. Depuis la version 0.4, LM Studio peut aussi utiliser des outils MCP locaux.
Que fait la quantification ? Comment choisir Q4 vs Q5 vs Q6 ?
La quantification réduit la précision numérique du modèle — moins de mémoire, légèrement moins de qualité. Q3 = très compressé, mauvaise qualité. Q4 = bon compromis (recommandé). Q5 = qualité supérieure, taille plus grande. Q6 = qualité quasi-originale, gros fichier. Commencez par Q4_K_M.
Puis-je exécuter plusieurs modèles simultanément ?
Non. Les trois applications chargent un seul modèle à la fois en mémoire. Vous devez décharger le modèle actuel avant de charger un autre.
Combien cela coûte-t-il ? Y a-t-il un abonnement ?
Zéro. Les trois applications sont gratuites. LM Studio est propriétaire mais gratuit. Jan et GPT4All sont open-source sous licences permissives. Aucun abonnement, aucun compte requis.
Quelle application est la plus stable ? Dois-je m'attendre à des plantages ?
Toutes les trois sont stables. Les plantages sont rares et généralement causés par un manque de mémoire (décharger le modèle résout le problème). GPT4All reçoit toutefois beaucoup moins de correctifs qu'auparavant — son développement est au ralenti depuis début 2025 — alors que LM Studio et Jan publient des mises à jour fréquentes en 2026.
GPT4All est-il encore activement développé en 2026 ?
Pas activement. Sa dernière version majeure (v3.10) date de début 2025, et son dépôt GitHub n'a pas reçu de mise à jour notable depuis. L'application s'installe et fonctionne toujours parfaitement hors ligne, et reste l'option la plus simple à fenêtre unique — mais sa liste de modèles sélectionnés n'inclut plus les modèles récents comme Qwen 3.6 ou gpt-oss. Pour des modèles à jour sans terminal, préférez LM Studio ou Jan.
Puis-je utiliser ces applications sur un réseau local ou distant ?
Les trois incluses l'API compatible OpenAI. Avec une configuration réseau, vous pouvez pointer des clients distants vers localhost:1234 ou équivalent. Mais par défaut, elles n'écoutent que localhost.
Quelle est la différence entre CPU et GPU dans le contexte des applications locales ?
CPU = plus lent, gratuit. GPU = 5–10x plus rapide, coûteux. Pour matériel bas de gamme, CPU fonctionne bien. Pour matériel moyen-à-élevé, GPU améliore considérablement les temps de réponse. Toutes les trois supportent les deux.
Quels modèles LM Studio prend-il en charge sur les Mac Apple Silicon ?
LM Studio prend en charge toute la bibliothèque de modèles GGUF ainsi que le format MLX d'Apple sur Apple Silicon (M1 à M5), en utilisant Metal pour l'accélération GPU via l'architecture de mémoire unifiée. Modèles de départ recommandés : Phi-4 Mini (3,8B) ou Gemma 4 E2B sur les Mac avec 8 Go, Qwen3 8B sur les Mac avec 16 Go et plus, gpt-oss 20B ou Qwen3 14B sur les Mac avec 16 à 32 Go, et Qwen 3.6 27B sur les Mac avec 32 Go et plus — Llama 3.3 70B reste une option sur les machines 48–64 Go de classe Max. LM Studio détecte automatiquement la mémoire disponible et recommande un niveau de quantification adapté — généralement Q4_K_M.
Quelle est la configuration requise pour LM Studio sur Windows, Mac Intel et Apple Silicon ?
Sous macOS, LM Studio nécessite un Mac Apple Silicon (M1 ou plus récent) avec macOS 14 ou supérieur — les Mac Intel ne sont pas pris en charge ; les utilisateurs de Mac Intel doivent installer Jan ou GPT4All à la place, qui tournent en inférence CPU à environ 5–10 tokens/seconde pour un modèle 3B. Sous Windows, le minimum est de 8 Go de RAM pour les modèles 3B à 7B, avec une GPU NVIDIA (8 Go+ de VRAM) optionnelle pour l'accélération CUDA sur les modèles plus grands. Linux a le même minimum de 8 Go de RAM via AppImage ou .deb, avec support CUDA si une GPU NVIDIA est présente. Apple Silicon reste globalement le plus rapide, grâce à la mémoire unifiée et à l'accélération Metal, sans GPU séparé nécessaire.
LM Studio fonctionne-t-il sous Linux ?
Oui. LM Studio propose des versions Linux sous forme d'AppImage et de paquet .deb, avec les mêmes fonctionnalités que les versions Windows et macOS : navigateur de modèles, interface de chat, et un onglet Local Server pour l'accès à une API compatible OpenAI. L'accélération CUDA fonctionne sous Linux si une GPU NVIDIA est présente ; sans GPU, LM Studio utilise l'inférence CPU, comme sous Windows.
Quelles sont les meilleures alternatives à LM Studio en 2026 ?
Jan est l'alternative la plus proche — même rapidité d'installation, entièrement open-source sous licence Apache 2.0, et support AppImage pour Linux. GPT4All est l'alternative la plus simple pour les débutants purs, avec une liste de modèles sélectionnés et une interface de chat à fenêtre unique, même si son développement est au ralenti depuis début 2025. Pour les développeurs qui préfèrent un outil en ligne de commande, Ollama est l'alternative de référence, mais nécessite l'utilisation du terminal plutôt qu'une interface graphique. Les quatre utilisent les mêmes fichiers de modèles GGUF et sont gratuits.