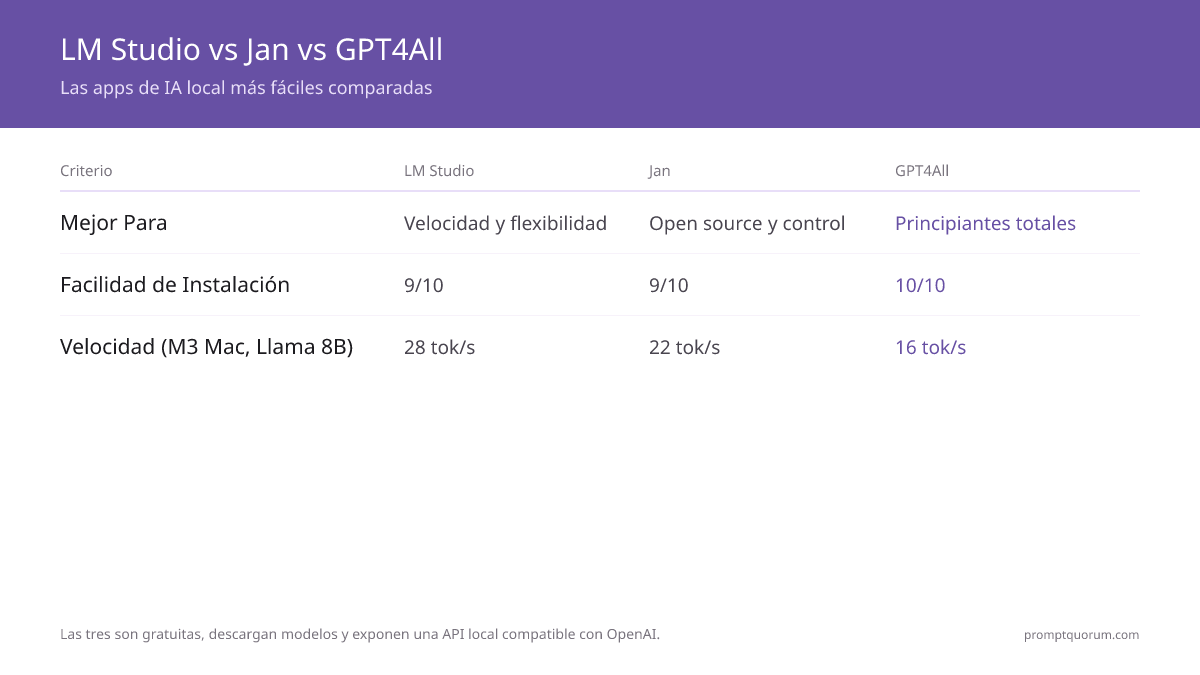
Conclusiones clave
- LM Studio es el camino más rápido de cero a chatear localmente. Descarga el instalador desde lmstudio.ai, abre la pestaña Discover, busca "Phi-4 Mini", descarga el modelo y empieza a chatear. En menos de 10 minutos con una conexión a internet decente.
- Jan es la alternativa de código abierto. Misma facilidad de uso que LM Studio, completamente de código abierto bajo Apache 2.0 (relicenciado desde AGPLv3 en 2025), funciona en Linux AppImage. Si prefieres software de código abierto o quieres ver el código fuente, Jan es la opción equivalente.
- GPT4All es la experiencia más simplificada. Ventana de chat única, recomendaciones de modelos seleccionados, sin sobrecarga de navegación de modelos. Lo mejor para usuarios que quieren escribir una pregunta y obtener una respuesta sin tomar decisiones de configuración — pero su desarrollo está estancado desde principios de 2025, así que su lista de modelos seleccionados ya no incluye los modelos más recientes.
- Empieza con Phi-4 Mini o Llama 3.2 3B en cualquier hardware. Estos modelos de 3B funcionan en cualquier portátil fabricado en los últimos 7 años — sin GPU, sin 32 GB de RAM, sin hardware especial. Son más lentos que una IA en la nube pero producen resultados utilizables para la mayoría de las tareas cotidianas.
- No se necesita cuenta en la nube. Tras la descarga inicial (la aplicación y el archivo del modelo), todo se ejecuta localmente sin conexión a internet. Sin clave de API, sin suscripción, sin datos enviados a ningún servidor.
- En Apple Silicon, casi cualquier modelo funciona bien. El MacBook Air M3 (8 GB) ejecuta Llama 3.2 3B y Phi-4 Mini con fluidez. El M3 Pro o M4 (16 GB+) ejecuta Qwen3 8B cómodamente. El M5 Max (64 GB) ejecuta modelos de 70B.
- LM Studio también sirve una API local. Si más adelante quieres conectar Obsidian, VS Code u otra herramienta a tu modelo local, la pestaña Local Server de LM Studio expone una API compatible con OpenAI y Anthropic en localhost:1234 — sin configuración adicional. Desde la versión 0.4 también puede usar herramientas MCP locales.
Datos rápidos
- LM Studio: lmstudio.ai — Windows (x64, ARM), macOS (Apple Silicon, macOS 14+; sin soporte para Mac Intel), Linux (AppImage, .deb). Línea de versión actual: 0.4.x.
- Jan: jan.ai — Windows (x64), macOS (Apple Silicon, Intel), Linux (AppImage). Línea de versión actual: 0.8.x, Apache 2.0.
- GPT4All: gpt4all.io — Windows (x64), macOS (Apple Silicon, Intel), Linux (AppImage). Última versión importante: v3.10, a principios de 2025 — el desarrollo está estancado.
- Hardware mínimo: cualquier portátil con 8 GB RAM para modelos de 3B–7B; 16 GB+ para modelos de 8B–14B; 24 GB+ para 30B+.
- No se necesita GPU para modelos de 3B–7B en Apple Silicon o modo de inferencia por CPU.
- Las tres son gratuitas; Jan (Apache 2.0) y GPT4All (MIT) son completamente de código abierto, LM Studio es gratuita pero solo con código disponible.
- Recomendación de primer modelo: Phi-4 Mini (3,8B, ~2,7 GB de descarga) o Gemma 4 E2B para hardware con menos de 8 GB; Qwen3 8B para sistemas de 8–16 GB.
Las tres opciones comparadas
Las tres aplicaciones se instalan como aplicaciones de escritorio estándar y no requieren el uso de la línea de comandos. Las diferencias están en la profundidad de funciones, el tamaño de la biblioteca de modelos y el equilibrio entre simplicidad y configurabilidad.
📍 En una frase
LM Studio es la aplicación de IA local más fácil para Windows y Mac — instala, navega por los modelos, descarga, chatea — con Jan como equivalente de código abierto y GPT4All como la opción más sencilla de ventana única.
💬 En términos simples
Si solo quieres iniciar un chat de IA local lo más rápido posible: descarga LM Studio, ábrelo, haz clic en Discover, escribe "Phi-4 Mini", descarga el modelo (~2,7 GB), haz clic en Chat y empieza a hablar. Esa es la configuración completa. Sin terminal, sin Python, sin cuenta. Si LM Studio te parece que tiene demasiadas opciones, prueba GPT4All — tiene una ventana y una lista corta de modelos preseleccionados.
Característica | |||
|---|---|---|---|
| Tiempo de configuración (primera ejecución) | ~8 minutos | ~10 minutos | ~5 minutos |
| Biblioteca de modelos | Búsqueda GGUF + MLX completa de Hugging Face (~50.000+ modelos) | Seleccionados + búsqueda en Hugging Face | Lista seleccionada (~20 modelos, desactualizada) |
| Servidor de API local | Sí (compatible con OpenAI y Anthropic) | Sí (compatible con OpenAI) | Sí (limitado, menos documentado) |
| Multi-chat / historial de conversaciones | Sí | Sí | Ventana de chat única |
| Licencia del código fuente | Gratuito, código disponible (no OSI) | Apache 2.0 (completamente de código abierto) | MIT (completamente de código abierto) |
| Desarrollo activo | Frecuente (0.4.x, 2026) | Frecuente (0.8.x, 2026) | Estancado desde principios de 2025 |
| Compatibilidad con Linux | AppImage, .deb | AppImage | AppImage |
| Lo mejor para | Usuarios que quieren la mejor interfaz + acceso a API para desarrolladores | Usuarios que prefieren software de código abierto | Principiantes absolutos que quieren la interfaz más sencilla |
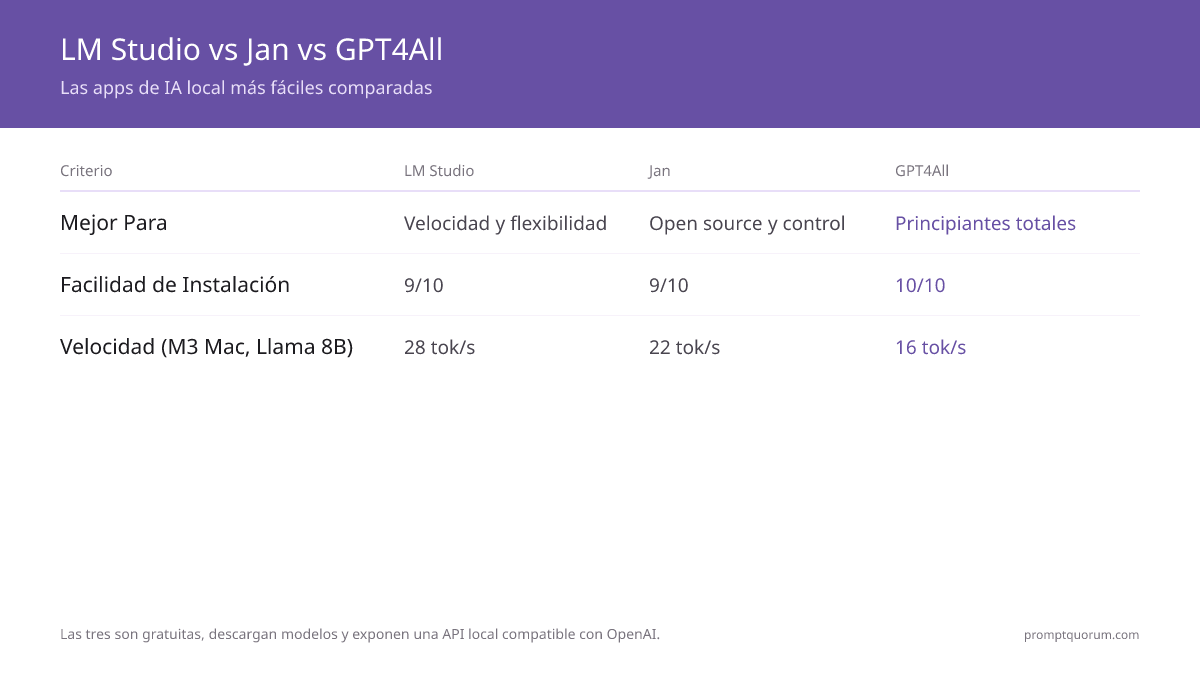
💡Consejo: Comienza con LM Studio a menos que tengas una razón específica para no hacerlo. Tiene la mejor interfaz, la biblioteca de modelos más grande y una ruta de actualización clara (pestaña Local Server) si quieres conectar otras herramientas más adelante. Si prefieres firmemente el software de código abierto, Jan es la opción equivalente.
LM Studio: guía de configuración
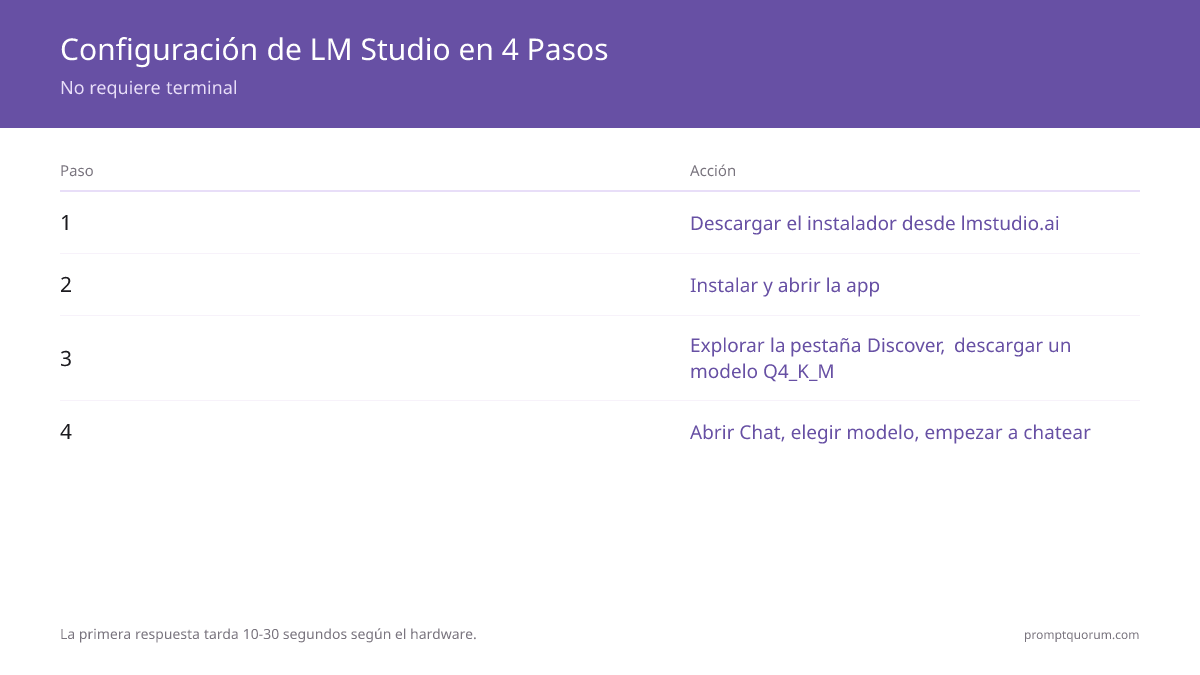
LM Studio se instala en 3 minutos y te tiene chateando en menos de 10. El proceso es idéntico en Windows y macOS — descarga, instala, navega por los modelos, descarga un modelo, chatea.
- 1Ve a lmstudio.ai y descarga el instalador para tu plataforma (Windows .exe, macOS .dmg para Apple Silicon, Linux .AppImage o .deb).
- 2Ejecuta el instalador. Acepta cualquier aviso de seguridad (es una aplicación nueva, no firmada por Apple/Microsoft de forma predeterminada en algunas versiones).
- 3Abre LM Studio. La barra lateral izquierda muestra: Chat, Search (Discover), Models y Local Server.
- 4Haz clic en "Discover" (el ícono del telescopio). En la barra de búsqueda, escribe "Phi-4 Mini" (para sistemas de 8 GB o menos) o "Qwen3 8B" (para sistemas de 16 GB+).
- 5Haz clic en el modelo y luego en "Download" junto a la variante de cuantización Q4_K_M. Esta es la mejor relación calidad-tamaño para la mayoría del hardware.
- 6Espera a que la descarga se complete (2–5 GB según el modelo). El progreso se muestra en la barra inferior.
- 7Haz clic en "Chat" en la barra lateral. Selecciona tu modelo descargado en el menú desplegable de la parte superior. Escribe tu primer mensaje.
💡Consejo: En macOS, LM Studio detecta tu hardware automáticamente y recomienda el mejor nivel de cuantización para tu memoria disponible. Acepta la recomendación a menos que tengas una razón específica para modificarla. En Windows con GPU NVIDIA, LM Studio habilita automáticamente la aceleración por GPU — no necesitas configurar CUDA.
Jan: guía de configuración
Jan es la alternativa de código abierto a LM Studio — misma facilidad de uso, experiencia de descarga de modelos idéntica, licencia Apache 2.0 (relicenciada desde AGPLv3 en 2025). Usa Jan si el software de código abierto es importante para ti, si usas un Mac Intel, o si quieres inspeccionar o modificar el código de la aplicación.
- 1Ve a jan.ai y descarga el instalador para tu plataforma.
- 2Ejecuta el instalador y abre Jan.
- 3Haz clic en "Hub" en la barra lateral izquierda para navegar por los modelos.
- 4Busca "Phi-4 Mini" o "Qwen3 8B" y haz clic en "Download". El Hub descarga archivos GGUF desde Hugging Face.
- 5Una vez descargado, haz clic en "Thread" para iniciar una nueva conversación. Selecciona tu modelo en el selector de modelos en la parte inferior de la ventana de chat.
- 6Escribe tu primer mensaje. Jan usa los mismos archivos de modelo que LM Studio — cualquier modelo que descargues funciona en ambas aplicaciones.
💡Consejo: Jan y LM Studio usan el mismo formato de modelo GGUF. Los archivos de modelo descargados por una aplicación pueden apuntarse manualmente a la otra. Si ya descargaste modelos en LM Studio y quieres probar Jan (o viceversa), puedes ahorrar la re-descarga de 2–5 GB apuntando Jan al directorio de modelos de LM Studio (normalmente ~/Library/Application Support/LM Studio/models en macOS).
GPT4All: guía de configuración
GPT4All ofrece la experiencia más simplificada — una ventana de chat única y una lista seleccionada de modelos recomendados. Si LM Studio y Jan tienen demasiadas opciones y solo quieres escribir una pregunta y obtener una respuesta, empieza aquí. Una advertencia para 2026: el desarrollo de GPT4All está estancado desde principios de 2025 (última versión importante v3.10), así que la app sigue funcionando bien sin conexión pero su lista de modelos seleccionados ya no incluye los más recientes. Elige LM Studio o Jan si quieres los lanzamientos de modelos actuales.
- 1Ve a gpt4all.io y descarga el instalador para tu plataforma.
- 2Ejecuta el instalador y abre GPT4All.
- 3La pestaña Models muestra una lista seleccionada de modelos recomendados con descripciones en lenguaje sencillo (p. ej., "rápido, bueno para código", "mejor para chat general"). Haz clic en "Download" en el modelo más adecuado para tu hardware.
- 4Una vez descargado, la ventana de chat se abre automáticamente con el modelo seleccionado. Escribe tu primer mensaje.
- 5GPT4All no tiene historial de conversaciones múltiples — cada sesión comienza desde cero. Está diseñado para uso de una sola tarea en lugar de conversaciones extendidas.

💡Consejo: GPT4All incluye una función "LocalDocs" que te permite agregar una carpeta de documentos (PDFs, archivos de texto) y hacer preguntas sobre ellos. Esta es una versión simplificada de RAG — útil para preguntas básicas sobre documentos sin configurar LlamaIndex o AnythingLLM. La precisión es limitada en comparación con una configuración RAG adecuada, pero no requiere ninguna configuración adicional.
¿Qué modelo debo descargar primero?
El primer modelo correcto depende de cuánta RAM tiene tu computadora. Más RAM = modelo más grande = mejores respuestas, pero cualquier computadora moderna puede ejecutar algo útil.
RAM disponible | Primer modelo recomendado | Tamaño de descarga | Velocidad esperada |
|---|---|---|---|
| 8 GB o menos | Phi-4 Mini (3,8B Q4) o Gemma 4 E2B | ~2–3 GB | 15–30 tokens/seg en Apple Silicon; 5–10 tok/seg solo CPU Intel/AMD |
| 8–16 GB | Llama 3.2 3B (Q4) o Qwen3 8B (Q4) | 2,0–4,9 GB | 20–40 tok/seg en Apple Silicon; 8–15 tok/seg solo CPU |
| 16–32 GB | gpt-oss 20B (~13 GB) o Qwen3 14B (Q4) | ~9–13 GB | 15–25 tok/seg en Apple Silicon (Qwen3 14B); GPU necesaria para tiempo real en x86 |
| 32 GB+ (Apple Silicon) o 24 GB VRAM (NVIDIA) | Qwen 3.6 27B (Q4) — el mejor modelo de consumo | ~16 GB | Tiempo real en Macs de clase M4 Pro/M5 y GPUs de clase RTX 4090 |

💡Consejo: Comienza con el modelo más pequeño que se ejecute lo suficientemente rápido como para sentirse interactivo (más de 8 tokens por segundo en velocidad de escritura en tiempo real). Un modelo grande y lento es peor de usar que uno pequeño y rápido — la frustración de esperar 10 segundos por oración derrota el propósito. Actualiza a un modelo más grande cuando hayas experimentado los límites del pequeño.
Requisitos de hardware
No necesitas una PC para juegos ni una GPU dedicada para ejecutar IA local en 2026. Los Mac con Apple Silicon son el mejor hardware de consumo para LLMs locales; cualquier MacBook Air desde M1 en adelante ejecuta modelos pequeños bien. En Windows y Linux, el modo de inferencia por CPU funciona para modelos de 3B–7B en cualquier portátil con 8 GB RAM. Una nota de plataforma: LM Studio requiere Apple Silicon en macOS — en un Mac Intel, usa Jan o GPT4All, que siguen admitiendo Intel mediante inferencia por CPU.
📍 En una frase
Cualquier portátil con 8 GB RAM fabricado después de 2018 puede ejecutar un modelo de IA local — los Mac con Apple Silicon los ejecutan más rápido, pero las máquinas Windows y Linux solo con CPU ejecutan modelos de 3B–7B a velocidades de generación utilizables.
💬 En términos simples
No se necesita GPU para los modelos pequeños (Phi-4 Mini, Llama 3.2 3B). Estos se ejecutan en inferencia por CPU y producen una respuesta a velocidad de escritura en cualquier portátil moderno. Si tienes una GPU NVIDIA con 8 GB+ VRAM, LM Studio la usará automáticamente y ejecutará modelos más grandes (Mistral Small, Qwen3 8B) mucho más rápido. Si tienes un Mac con Apple Silicon, la arquitectura de memoria unificada significa que puedes ejecutar modelos hasta el tamaño de tu RAM.
- Apple Silicon (M1–M5): el mejor hardware de consumo para LLMs locales. La memoria unificada significa que la GPU y la CPU comparten RAM — un MacBook Air M3 con 8 GB ejecuta Phi-4 Mini a más de 20 tokens/seg; un M5 Max con 64 GB ejecuta Llama 3.3 70B. LM Studio ejecuta aquí tanto modelos GGUF (llama.cpp) como MLX.
- GPU NVIDIA (Windows/Linux): la aceleración CUDA en LM Studio y Jan acelera drásticamente la generación. RTX 3060 12 GB ejecuta Qwen3 8B en tiempo real. RTX 4090 24 GB ejecuta Qwen 3.6 27B y otros modelos de clase 30B.
- GPU AMD (Windows/Linux): el soporte ROCm en LM Studio y Jan está mejorando pero es menos maduro que CUDA. Si tienes una GPU AMD, consulta las notas de la versión de LM Studio para tu tarjeta específica antes de depender de la aceleración por GPU.
- Solo CPU Intel/AMD: funciona para modelos de 3B–7B a 5–15 tokens/seg — utilizable pero lento. La experiencia es mejor para tareas donde envías un prompt y haces otra cosa (resumen, redacción de correos) que para uso conversacional en tiempo real.
- RAM y VRAM: el modelo debe caber completamente en RAM (o VRAM). Un modelo de 4B necesita ~3 GB; un modelo de 8B necesita ~5 GB; un modelo de 14B necesita ~9 GB; un modelo de 70B necesita ~42 GB. Si el modelo es demasiado grande, LM Studio te avisará antes de descargarlo.

⚠️Advertencia: No intentes ejecutar un modelo más grande que tu RAM disponible. LM Studio usará el disco como intercambio si el modelo no cabe en RAM, lo que hace que la generación sea tan lenta (~0,5 tokens/seg) que la aplicación parece rota. Siempre comprueba el tamaño del modelo en la pestaña Discover antes de descargarlo y compáralo con tu RAM disponible.
Errores comunes
- Descargar un modelo demasiado grande para tu RAM. Comprueba la RAM disponible antes de descargar. Un modelo de 70B en una máquina de 16 GB usará el disco como intercambio y producirá salida a 1 token cada 10 segundos.
- Esperar calidad de IA en la nube de un modelo de 3B. Los modelos locales pequeños (3B–7B) son menos capaces que GPT-5.5 o Claude. Son mejores que nada y útiles para muchas tareas, pero cometen más errores, pierden contexto más rápido y producen salidas menos matizadas.
- No usar la cuantización Q4_K_M. LM Studio usa Q4_K_M por defecto para la mayoría de los modelos, que es la elección correcta. Q8 requiere el doble de RAM para una ganancia de calidad modesta; Q2 requiere menos RAM pero degrada notablemente la calidad de la salida. Mantente en Q4_K_M a menos que tengas una razón específica para desviarte.
- Cerrar el chat entre sesiones y perder el historial. En LM Studio y Jan, cada sesión de chat guarda su historial a menos que lo elimines. Guarda o fija las conversaciones importantes; no asumas que el historial persiste si reinstala o borras la aplicación.
- No ejecutar el Local Server para integraciones. Si más adelante quieres usar tu modelo local con Obsidian, VS Code u otra herramienta, haz clic en la pestaña Local Server en LM Studio y presiona Start. Otras herramientas se conectan a
http://localhost:1234usando la API compatible con OpenAI.
Fuentes
- Registro de cambios de LM Studio 0.4 y compatibilidad de hardware — lmstudio.ai/changelog
- Documentación de Jan y repositorio de código abierto (Apache 2.0) — jan.ai/docs
- Biblioteca de modelos de GPT4All, documentación de LocalDocs e historial de versiones — github.com/nomic-ai/gpt4all
- Informe técnico de Phi-4 Mini — Microsoft Research
- Especificación del formato de cuantización GGUF — llama.cpp
Preguntas frecuentes
¿Tiene algún costo ejecutar una aplicación de IA local?
Sin costo continuo. LM Studio, Jan y GPT4All son gratuitas para descargar y usar. Los modelos también son gratuitos — son de código abierto y se descargan directamente desde Hugging Face o repositorios similares. El único costo es la electricidad (ejecutar tu CPU/GPU) y la descarga única del modelo (2–40 GB según el modelo). No hay tarifas de suscripción, costos de API ni cargos por mensaje.
¿Necesito conexión a internet para usar una aplicación de IA local?
Solo para la descarga inicial de la aplicación y los archivos del modelo. Una vez descargados, todo se ejecuta localmente — no se necesita conexión a internet. Puedes usar tu aplicación de IA local en un avión, en un hotel sin Wi-Fi o en un entorno con red restringida.
¿Qué tan privada es una aplicación de IA local?
Completamente privada. Tus conversaciones, prompts y las respuestas del modelo nunca salen de tu máquina. No hay servidores en la nube, sin registros, sin recopilación de datos de entrenamiento. LM Studio tiene análisis opcionales (se puede desactivar en la configuración), pero el contenido del chat en sí nunca se transmite. Jan y GPT4All no tienen telemetría por defecto.
¿Cuál es la diferencia entre LM Studio y Ollama?
LM Studio es una aplicación de escritorio con interfaz gráfica — interactúas con ella a través de una interfaz visual. Ollama es una herramienta de línea de comandos que ejecuta un servidor de modelos local — interactúas con ella a través de una terminal o llamadas a la API. Para usuarios no técnicos, LM Studio es mucho más fácil. Para desarrolladores que quieren integrar modelos locales en sus propias herramientas, la API de Ollama es más sencilla de usar. Ambas ejecutan los mismos archivos de modelo GGUF.
¿Puedo usar una aplicación de IA local en un MacBook más antiguo?
Sí, si cumple con el requisito de RAM (8 GB mínimo para modelos de 3B). En un MacBook Intel de 2018 en adelante, usa Jan o GPT4All — LM Studio requiere Apple Silicon en macOS. Un Mac Intel ejecuta Phi-4 Mini a velocidad lenta pero utilizable (~5–10 tokens/seg, inferencia por CPU). Los Mac con Apple Silicon (M1 en adelante) son significativamente más rápidos debido a la arquitectura de memoria unificada y el Neural Engine. Un MacBook Air M1 de 2020 ejecuta Phi-4 Mini a más de 20 tokens/seg.
¿Puedo ejecutar varios modelos al mismo tiempo?
LM Studio admite cargar un modelo a la vez en la interfaz gráfica, pero puedes ejecutar varios modelos simultáneamente a través del Local Server si tienes suficiente RAM. Jan y GPT4All son de un modelo a la vez. Para flujos de trabajo con múltiples modelos, Ollama es más flexible — puede servir varios modelos simultáneamente en el mismo servidor.
¿Qué aplicación de IA local funciona en un Chromebook?
Ninguna de las tres funciona de forma nativa en ChromeOS. Sin embargo, los Chromebooks con Linux (Crostini) habilitado pueden instalar Jan u Ollama a través de la terminal de Linux. La experiencia es más técnica que en Windows o Mac. En Chromebooks Android con buena RAM (8 GB+), Termux también puede ejecutar Ollama, pero esto requiere comodidad con la línea de comandos.
¿Cómo actualizo a una versión más nueva del modelo?
En LM Studio, abre la pestaña Discover, busca la versión más nueva del modelo, descárgala y cambia a ella en el selector de modelos de Chat. La versión antigua no se elimina automáticamente — elimínala manualmente desde la pestaña Models si necesitas espacio en disco. En Jan, el Hub muestra las actualizaciones disponibles para los modelos que has descargado. GPT4All muestra los nuevos modelos en su lista de modelos seleccionados.
¿Qué modelos admite LM Studio en Mac con Apple Silicon?
LM Studio admite toda la biblioteca de modelos GGUF además del formato MLX de Apple en Apple Silicon (de M1 a M5), usando Metal para la aceleración por GPU a través de la arquitectura de memoria unificada. Puntos de partida recomendados: Phi-4 Mini (3.8B) o Gemma 4 E2B en Mac con 8 GB, Qwen3 8B en Mac con 16 GB o más, gpt-oss 20B o Qwen3 14B en Mac con 16–32 GB, y Qwen 3.6 27B en Mac con 32 GB o más — Llama 3.3 70B sigue siendo una opción en equipos de clase Max con 48–64 GB. LM Studio detecta automáticamente la memoria disponible y recomienda un nivel de cuantización adecuado — normalmente Q4_K_M.
¿Cuáles son los requisitos del sistema de LM Studio en Windows, Mac Intel y Apple Silicon?
En macOS, LM Studio requiere un Mac con Apple Silicon (M1 o posterior) con macOS 14 o superior — los Mac Intel no son compatibles; los usuarios de Mac Intel deben instalar Jan o GPT4All, que ejecutan inferencia por CPU a unos 5–10 tokens/seg para un modelo de 3B. En Windows, el mínimo es 8 GB de RAM para modelos de 3B–7B, con una GPU NVIDIA (8 GB+ de VRAM) opcional para aceleración CUDA en modelos más grandes. Linux tiene el mismo mínimo de 8 GB de RAM vía AppImage o .deb, con soporte CUDA si hay una GPU NVIDIA presente. Apple Silicon es el más rápido en general, gracias a la memoria unificada y la aceleración Metal, sin necesidad de GPU separada.
¿LM Studio funciona en Linux?
Sí. LM Studio ofrece compilaciones para Linux como AppImage y como paquete .deb, con el mismo conjunto de funciones que las versiones de Windows y macOS: navegador de modelos, interfaz de chat y una pestaña Local Server para acceso a una API compatible con OpenAI. La aceleración CUDA funciona en Linux cuando hay una GPU NVIDIA presente; sin GPU, LM Studio recurre a la inferencia por CPU, igual que en Windows.
¿Cuáles son las mejores alternativas a LM Studio en 2026?
Jan es la alternativa más cercana — la misma facilidad de instalación, completamente de código abierto bajo Apache 2.0, y soporte de AppImage para Linux. GPT4All es la alternativa más simple para principiantes puros, con una lista de modelos seleccionados y una interfaz de chat de una sola ventana, aunque su desarrollo está estancado desde principios de 2025. Para desarrolladores que prefieren una herramienta de línea de comandos, Ollama es la alternativa líder, aunque requiere el uso de terminal en lugar de una interfaz gráfica. Las cuatro ejecutan los mismos archivos de modelo GGUF y son gratuitas.
¿Puedo conectar mi modelo local a otras aplicaciones?
Sí. El Local Server de LM Studio expone una API compatible con OpenAI y Anthropic en http://localhost:1234, y Jan una API compatible con OpenAI en http://localhost:1337. Apunta Obsidian, VS Code o cualquier otra herramienta que acepte un endpoint de API personalizado a esa dirección. Muchos flujos de trabajo — RAG, pruebas de prompts, integración de chatbots — se vuelven posibles una vez que tu API local está disponible. Desde la versión 0.4, LM Studio también puede usar herramientas MCP locales.
¿Qué cuantización debo usar — Q3, Q4, Q5 o Q6?
La mayoría de los usuarios deberían usar Q4_K_M, que es lo que LM Studio recomienda por defecto. Q3 está muy comprimida y pierde calidad notable. Q4 es el equilibrio recomendado entre calidad y tamaño de archivo. Q5 y Q6 son más grandes y algo mejores si tienes RAM de sobra. En hardware con menos de 8 GB, empieza con Q4_K_M de un modelo de clase 3B en lugar de una cuantización menor de uno más grande.
¿Sigue manteniéndose GPT4All en 2026?
No de forma activa. La última versión importante de GPT4All (v3.10) se lanzó a principios de 2025, y su repositorio de GitHub no ha tenido actualizaciones significativas desde entonces. La aplicación se sigue instalando y funciona completamente sin conexión, y sigue siendo la opción más sencilla de ventana única — pero su lista de modelos seleccionados está desactualizada, así que modelos más nuevos como Qwen 3.6 o gpt-oss no están disponibles en ella. Si quieres los lanzamientos de modelos actuales con una configuración sin terminal, elige LM Studio o Jan.