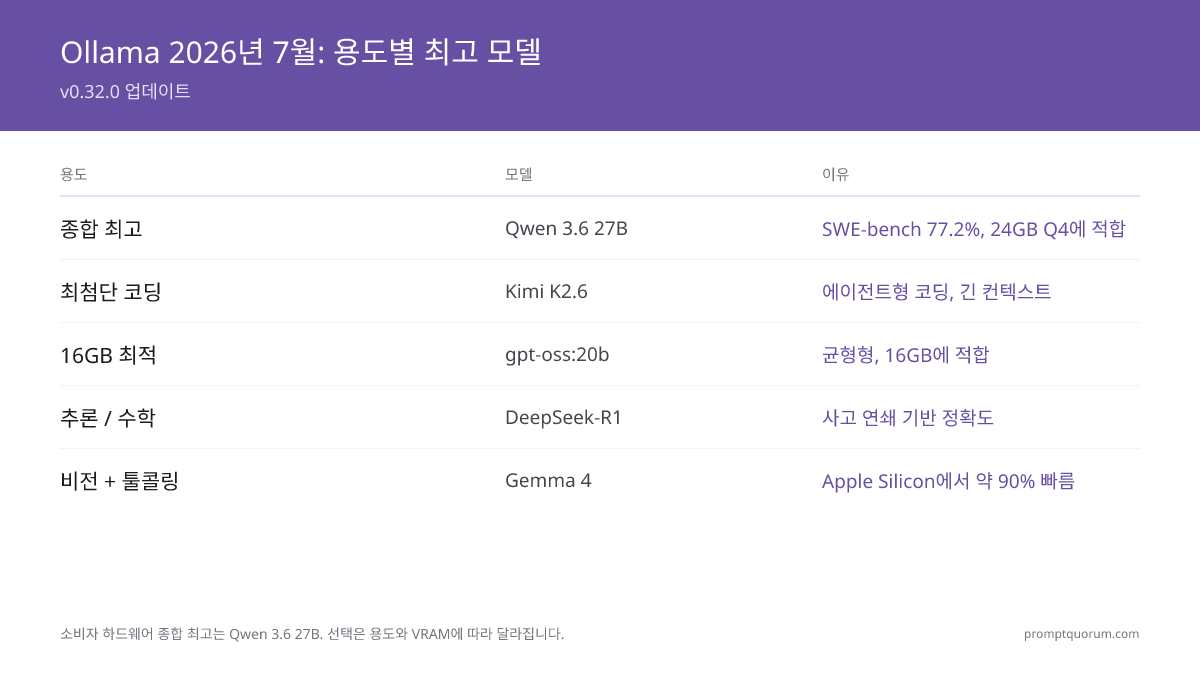
최신 Ollama 버전은 무엇이며 무엇이 바뀌었습니까?
현재 Ollama 버전: v0.40.5(2026년 10월 14일 출시). ollama.com/download에서 받을 수 있는 최신 안정 버전입니다. 10월 16일에 v0.40.6 프리릴리스가 공개되었지만 아직 안정 버전으로 표시되지 않았습니다. `curl https://ollama.ai/install.sh | sh`(macOS: `brew upgrade ollama`)로 업데이트한 뒤 `ollama --version`으로 확인하세요.
v0.33~v0.40 시리즈의 변경 사항(2026년 8~10월): v0.33.0(8월 21일)은 Claude Desktop을 서드파티 게이트웨이로 사용할 수 있게 했고 KV 캐시 프리필 복원 지점의 안정성을 높였습니다. v0.34.0(9월 5일)은 ChatGPT Desktop에서 Ollama 모델을 쓸 수 있게 했고 Apple Silicon의 구조화 출력을 빠르게 했으며, v0.34.1(9월 14일)은 MLX safetensors 기반 `ollama create`의 실험 표시를 없앴습니다. v0.40.0(9월 25일)은 Apple Silicon에서 qwen3.8, gemma4, qwen3.6 같은 지원 아키텍처를 기본적으로 MLX로 실행합니다. v0.35.0(9월 28일)은 `/v1/systemone`을 통한 결정 모델(텍스트 대신 선택지·확률·점수를 반환하는 모델, 첫 모델은 Nimble과 Tev1)을 추가했고, v0.35.1(9월 29일)은 멀티모달 Clef 모델을 추가했습니다. v0.40.2(10월 8일)는 이전 모델을 백그라운드에서 업그레이드할 때 백업을 유지하고, v0.40.4(10월 12일)는 `ollama run <결정-모델> --ask`를 추가했으며, v0.40.5(10월 14일)는 NVIDIA Nemotron 3.5 Super 지원과 Clef 결정 모델의 클라우드 액세스를 추가했습니다. 전체 노트: github.com/ollama/ollama/releases.
지난 업데이트 이후 추가된 최신 모델(2026년 6월 말~7월):
- Nemotron 3.5 Lightning, Super, Bolt(NVIDIA, 2026년 8~10월) — Lightning(8월 11일)은 활성 파라미터 3B의 30B MoE로 단일 GPU에서 상시 실행되는 에이전트용이며, Super는 120B 비전-언어 MoE(활성 12B, 최대 100만 토큰 컨텍스트, 도구·사고 모드), Bolt는 Super를 74B(활성 9B)로 줄여 24GB NVIDIA GPU에 맞춘 모델입니다. 설치: `ollama pull nemotron-3.5-lightning`, `ollama run nemotron-3.5-super`, `ollama run nemotron-3.5-bolt`
- Laguna XS 2.1(Poolside, 2026년 7월 2일) — 33B 전체/3B 활성 MoE로, 에이전틱 코딩과 장시간 로컬 작업(계획, 코드 작성, 테스트 실행, 반복)을 위해 구축되었습니다. 256K 컨텍스트, OpenMDW-1.1 라이선스. SWE-bench Verified 70.9%, SWE-bench Multilingual 63.1%. Pull: `ollama pull laguna-xs-2.1`
- Kimi K2.7 Code(Moonshot AI, 2026년 6월) — Kimi K2.6을 기반으로 한 코딩 특화 에이전틱 모델로, 장시간 코딩 세션을 특별히 겨냥합니다. Pull: `ollama pull kimi-k2.7-code:cloud` (cloud tag; local GGUF builds need 300+ GB)
- DeepSeek V4 Pro(DeepSeek, 2026년 4월 23일) — 알고리즘 코딩 특화 모델, 93.5% LiveCodeBench, MIT 라이선스. 경량 하드웨어용 보급형 모델 DeepSeek V4 Flash. Pull: `ollama pull deepseek-v4-pro`
- Kimi K2.6(Moonshot AI, 2026년 4월 20일) — 최전선 코딩 모델, SWE-Bench Pro 58.6, SWE-bench Verified 80.2%(GPT-5.5와 동점). MoE 아키텍처(32B 활성 / 1T 전체). Modified MIT 라이선스. Pull: `ollama pull kimi-k2.6:cloud` (cloud tag; local GGUF builds need 300+ GB)
- Qwen3.8-27B(Alibaba, 2026년 4월 16일) — 소비자 하드웨어 전반 최고, 61.7 SWE-bench Pro, Apache 2.0, Q4에서 24GB에 적합. 또한 Qwen3.6-35B-A3B(MoE, 73.4 SWE-bench)도 있습니다. Pull: `ollama pull qwen3.8:27b`
- GLM-5.3(Z.ai) — 744B / 40B 활성 MoE, MIT 라이선스. 구조화된 코드 생성 분야 선두. Pull: `ollama pull glm-5.3`
- gpt-oss(OpenAI, 2026년) — 오픈 웨이트 MoE: gpt-oss:20b(21B 전체 / 3.6B 활성, 16GB에서 실행, ~o3-mini 수준, 조정 가능한 추론)와 gpt-oss:120b(80GB). Pull: `ollama pull gpt-oss:20b`
- Gemma 4(Google, 2026년 4월 2일) — 멀티모달 크기 E2B / E4B / E12B(26B MoE) / E27B(31B 밀집), 모두 비전과 도구 호출 지원. Apple Silicon에서 이제 약 90% 빨라졌습니다(2026년 7월 MLX 업데이트). E4B는 ~6GB VRAM에서 실행됩니다. Pull: `ollama pull gemma4:e4b`
# Ollama를 최신 버전으로 업데이트 (v0.40.5)
curl https://ollama.ai/install.sh | sh

# 또는 Mac에서: brew upgrade ollama

# 현재 버전 확인
ollama --version  # 출력: ollama version 0.40.5

# 2026년 7월 최신 모델 Pull
ollama pull laguna-xs-2.1
ollama pull kimi-k2.7-code:cloud
ollama pull nemotron-3.5-lightning
ollama pull kimi-k2.6:cloud
Ollama 버전 이력과 릴리스 타임라인은 어떻게 되나요?
Ollama는 2023년 7월 8일 첫 릴리스 v0.0.1을 공개했고 2026년 10월 14일 v0.40.5에 도달했습니다. 표는 Ollama로 할 수 있는 일을 바꾼 릴리스를 정리한 것이며, 모든 태그와 전체 노트는 github.com/ollama/ollama/releases에 있습니다. 2026년 9월 하순에 버전 번호가 v0.35에서 v0.40으로 건너뛰어, GitHub에서는 v0.40.0(9월 25일)이 v0.35 릴리스(9월 28~29일)와 나란히 표시됩니다.
버전 | 출시일 | 주요 변경 |
|---|---|---|
| v0.40.5 | 2026년 10월 14일 | Nemotron 3.5 Super, 클라우드 결정 모델 |
| v0.40.0 | 2026년 9월 25일 | Apple Silicon 기본 MLX |
| v0.35.0 | 2026년 9월 28일 | /v1/systemone 결정 모델 |
| v0.34.0 | 2026년 9월 5일 | ChatGPT Desktop에서 Ollama 모델 |
| v0.33.0 | 2026년 8월 21일 | Claude Desktop 게이트웨이, KV 복원 |
| v0.32.0 | 2026년 7월 11일 | "Chat, Code & Work" 에이전트 |
| v0.0.1 | 2023년 7월 8일 | 첫 공개 릴리스 |
2026년 Ollama에서 가장 인기 있는 모델은 무엇입니까?
Ollama에서의 인기는 각 모델의 라이브러리 페이지에 표시되는 다운로드 수로 측정됩니다. 2026년 7월 기준, 다운로드 상위 모델은 여전히 Meta의 Llama 계열이 주도하고 있습니다 -- Llama 3.2 3B가 첫 설치 테스트 모델로 많이 사용되어 전체 다운로드 1위입니다. 그러나 Llama 4 Scout는 2026년 4월 출시 이후 빠르게 순위를 올리고 있습니다.
Qwen3는 Ollama 라이브러리에서 가장 빠르게 성장하는 모델 계열로, Qwen3와 새로운 Qwen3.8 밀집 변형이 기존 Qwen3를 빠르게 대체하고 있습니다. DeepSeek-R1은 출시 이후 대규모 다운로드 급증을 기록했으며 추론 작업에서 높은 다운로드 수를 유지하고 있습니다. Dolphin 3.0(Cognitive Computations, Llama 3.1 기반)은 무필터 로컬 어시스턴트를 원하는 사용자를 위한 무검열 범용 모델 중 가장 많이 Pull된 모델로 남아 있습니다.
Meta는 2026년 4월에 Scout(17B 활성, 109B 전체, MoE)와 Maverick(17B 활성, 400B 전체) 변형을 포함한 Llama 4를 출시했습니다. Llama 4 Scout는 이제 Ollama 라이브러리에서 안정적으로 사용 가능합니다(`ollama pull llama4:scout`). Llama 4 계열은 혼합 전문가(MoE) 아키텍처를 사용합니다 — 토큰당 17B 파라미터만 활성화되지만, 109B 전체 파라미터로 Scout는 Q4에서 ~55GB VRAM이 필요합니다(1.78비트에서만 24GB에 적합, ~20 tok/s). Scout의 핵심 특징은 소비자 하드웨어 적합성이 아니라 1,000만 토큰 컨텍스트 창과 멀티모달 입력입니다. 경량 설정(8GB RAM)에서는 Llama 3.2 3B가 여전히 가장 쉬운 첫 번째 모델입니다.
Kimi K2.6(Moonshot AI, Modified MIT 라이선스, 32B 활성 / 1T 전체 MoE)은 SWE-Bench Pro 58.6을 달성하여 GPT-5.5와 동점을 기록했습니다. Laguna XS 2.1(Poolside)은 장시간 로컬 코딩 세션을 위해 구축된 가장 새로운 에이전틱 코딩 도전자입니다. Qwen3.8-27B는 소비자 하드웨어 전반 최고 모델로서 61.7 SWE-bench Pro를 달성했습니다(Q4에서 24GB에 적합). OpenAI의 오픈 웨이트 gpt-oss:20b(21B 전체 / 3.6B 활성 MoE)는 16GB에서 ~o3-mini 수준의 조정 가능한 추론으로 실행됩니다.
Ollama 라이브러리는 수백 개의 큐레이팅된 모델을 보유하고 있으며, Laguna XS 2.1과 Kimi K2.7 Code가 6월 업데이트 이후 최신 추가 모델입니다.
버전 참고: Ollama에서는 Qwen3.6과 Qwen3.8이 더 새로운 Qwen 세대입니다(qwen3.6:35b 약 24 GB, qwen3.8:27b 18 GB). qwen3:30b와 qwen3-coder:30b(각 19 GB)는 이전 세대 선택지로 계속 사용할 수 있습니다. Mistral의 현재 Small 모델은 Mistral Small 4이지만 확인 시점에 Ollama 라이브러리에는 올라와 있지 않았으므로, mistral-small3.1과 mistral-small:24b(Mistral Small 3)가 받을 수 있는 Small 모델로 남아 있습니다.
사용 사례별로 가장 적합한 Ollama 모델은 무엇입니까?
모델 출력 품질은 프롬프트 방식에 크게 의존합니다. 연쇄 사고, 퓨샷 예시, 출력 형식 지정 등 모든 로컬 모델에서 작동하는 구조화된 기법은 프롬프트 엔지니어링 가이드를 참조하십시오. 추론 작업에서는 연쇄 사고 프롬프팅이 DeepSeek-R1 및 Qwen3 출력 품질을 크게 향상시킵니다. 이러한 모델의 양자화 트레이드오프를 이해하려면 양자화 가이드 →를 참조하십시오. 각 모델에 필요한 VRAM 양을 확인하려면 VRAM 요구 사항 가이드 →를 참조하십시오. Gemma 4를 사용한 에이전트 워크플로에 대해서는 트리 오브 소트 및 ReAct를 참조하십시오. 이러한 모델을 실행하기 위한 하드웨어 요구 사항은 하드웨어 가이드 →를 참조하십시오. 이 목록의 도구 호출 모델이 파일 및 데이터베이스 액세스와 함께 다단계 루프에 연결되면 오픈소스 오케스트레이션 패턴에 대해 MCP를 활용한 로컬 AI 에이전트를 참조하십시오.
- 일반 채팅(입문): `ollama run llama3.2:3b` -- 문서가 가장 많고 첫 번째 모델로 최적 지원.
- 일반 채팅(전반 최고): `ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro, 소비자 하드웨어 전반 최고, Q4에서 24GB에 적합. 균형잡힌 범용: `ollama run qwen3:30b`. 8GB 기기에서는 `ollama run llama3.2:3b`를 유지하십시오.
- 긴 컨텍스트 / 멀티모달: `ollama run llama4:scout` -- 1,000만 토큰 컨텍스트 + 멀티모달, MoE(17B 활성/109B 전체). Q4에서 ~55GB VRAM 필요(1.78비트에서만 24GB에 적합, ~20 tok/s).
- 소형 최강 / 16GB: `ollama run gpt-oss:20b` -- 21B 전체 / 3.6B 활성 MoE, ~o3-mini 수준, 조정 가능한 추론. 더 큰 모델: `ollama run gpt-oss:120b`(80GB).
- 8GB에서 코딩: `ollama run qwen3:8b` -- 8GB VRAM 기기에서 쓸 만한 로컬 코딩 모델. 5GB 사용, 다국어 지원.
- 8GB에서 일반 추론(코딩 외): `ollama run mistral:7b` -- 8GB 기기용 경량 범용 모델이며, 속도는 하드웨어에 따라 달라집니다.
- 코딩(최고 에이전트, 24B): `ollama run devstral-small-2` -- 최고 에이전트 코딩 모델(다중 파일 편집, 디버깅). 16GB RAM. Mistral AI 제공.
- 코딩(최고 밀집, 27B): `ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro. 최고 밀집 코딩 모델. 18 GB VRAM.
- 코딩(최전선 MoE): `ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58.6(GPT-5.5 동점), 최상위. MoE(32B 활성/1T 전체). Modified MIT 라이선스. 소비자 하드웨어에는 양자화 필요.
- 코딩(에이전틱, 장시간 작업): `ollama run laguna-xs-2.1` -- Poolside의 33B/3B 활성 MoE, SWE-bench Verified 70.9%, 256K 컨텍스트. 계획 → 코드 작성 → 테스트 → 반복의 다단계 루프용으로 구축. OpenMDW-1.1 라이선스.
- 에이전트 작업 및 도구 호출: `ollama run gemma4:e4b` -- 2026년 4월 2일 출시. 내장 도구 호출 + 비전 지원. 로컬 에이전트, 함수 호출, 구조화된 출력에 권장. 6GB RAM.
- 추론 및 수학: `ollama run deepseek-r1:7b` -- 연쇄 사고 모델, 7B에서 최고 로컬 수학 성능.
- 다국어: `ollama run qwen3:8b` -- 29개 이상 언어 기본 지원, 다국어 범용 모델.
- 러시아어 작업: `ollama run qwen3:8b` 또는 `ollama run mistral-small3.1` -- 두 모델 모두 네이티브 다국어 학습 데이터에 러시아어를 포함합니다. 이 페이지는 러시아어 성능 순위를 매기지 않습니다. 직접 작성한 프롬프트로 두 모델을 모두 시험해 보십시오.
- 무검열 / 범용: `ollama run dolphin3` -- Dolphin 3.0(Cognitive Computations, Llama 3.1 기반), 내장 콘텐츠 필터링 없음, 일반 채팅/코딩/에이전틱 작업에 사용.
- 이미지 이해: `ollama run gemma4:e4b` -- 비전 + 도구 호출(2026년 7월 기준 Apple Silicon에서 약 90% 빨라짐). 또는 전용 비전용 `ollama run llama3.2-vision:11b`.
- 빠르고 경량: `ollama run gemma2:2b` -- 가장 빠른 CPU 추론, 1.7GB RAM.
- 고품질(16GB RAM): `ollama run mistral-small3.1` -- 14GB RAM에서 우수한 품질.
- 임베딩 생성: `ollama run nomic-embed-text` -- RAG 파이프라인용 1억 3,700만 파라미터 임베딩 모델.
- 문서 Q&A(RAG): Open WebUI의 RAG 기능과 함께 `ollama run llama3.2` -- 가장 잘 지원되는 조합.
- 홈 자동화 / 웨이크 워드 AI: `ollama run phi4-mini` — Phi-4 Mini(3.8B, ~3GB VRAM)는 독립 GPU 없이 미니 PC에서 Home Assistant 음성 쿼리를 처리할 수 있으며, 속도는 하드웨어에 따라 달라집니다. Home Assistant + Ollama 통합 가이드 → 참조.
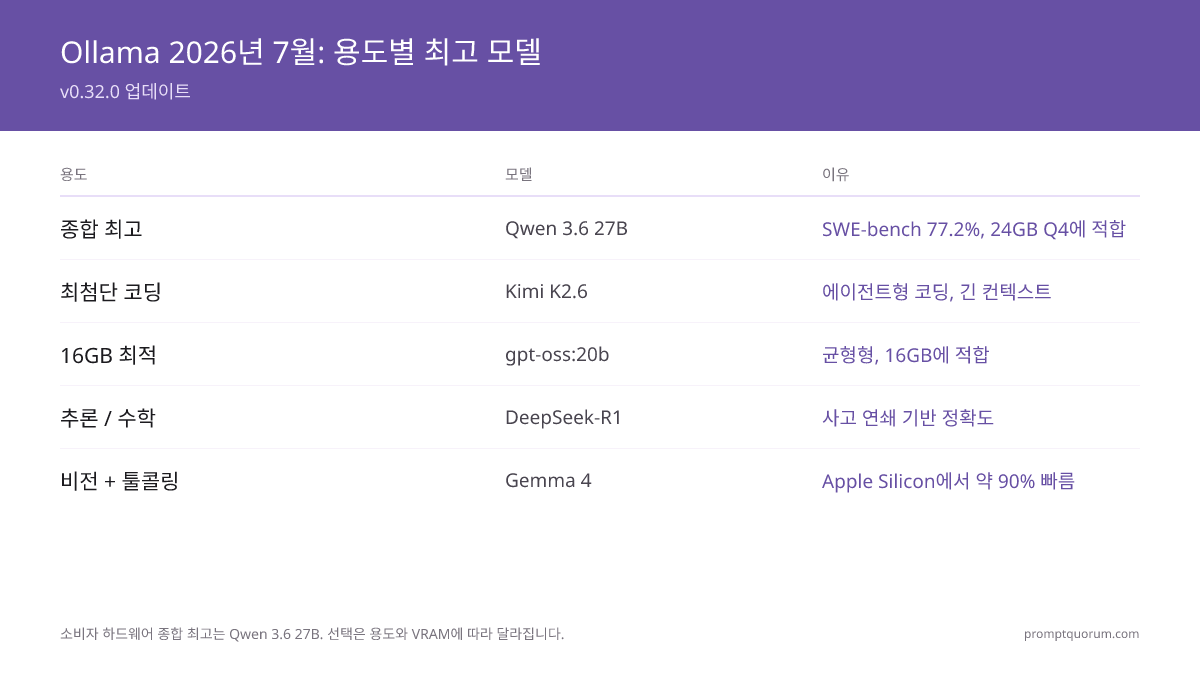
신규 Ollama 모델 — 2026년 7월 릴리스
2026년 7월 기준 Ollama 라이브러리의 최신 모델을 최신순으로 정리한 목록입니다. 워크플로를 구축하기 전에 `ollama pull <model>`로 가용성을 확인하십시오 — 새 모델은 출시 후 며칠 내에 ollama.com/library에 등장합니다.
Model | Released | Best For | Ollama Command |
|---|---|---|---|
| nemotron-3.5-super | 2026년 10월 | NVIDIA — 비전-언어 MoE, 120B/활성 12B, 1M 컨텍스트, 도구 | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 2026년 10월 | NVIDIA — 24GB GPU용 74B/활성 9B MoE | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026년 8월 11일 | NVIDIA — 상시 실행 에이전트용 30B/활성 3B MoE | ollama run nemotron-3.5-lightning |
| laguna-xs-2.1 | 2026년 7월 2일 | Poolside — 에이전틱 코딩, 33B/3B 활성 MoE, SWE-bench Verified 70.9%, 256K 컨텍스트 | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026년 6월 | Moonshot AI — Kimi K2.6 기반 코딩 특화 에이전틱 모델 | ollama run kimi-k2.7-code:cloud |
| deepseek-v4-pro | 2026년 4월 23일 | 알고리즘 코딩, 93.5% LiveCodeBench, MIT | ollama run deepseek-v4-pro |
| kimi-k2.6 | 2026년 4월 20일 | 최전선 코딩(SWE-Bench Pro 58.6), MoE(32B/1T), Modified MIT | ollama run kimi-k2.6:cloud |
| qwen3.8:27b | 2026년 4월 16일 | 소비자 하드웨어 전반 최고, 61.7 SWE-bench Pro, Q4에서 24GB 적합 | ollama run qwen3.8:27b |
| qwen3:30b | 2026년 | 균형잡힌 범용; 코드 완성에는 qwen3-coder:30b | ollama run qwen3:30b |
| gpt-oss:20b | 2026년 | 소형 최강 / 16GB, ~o3-mini, 조정 가능한 추론(gpt-oss:120b도 있음) | ollama run gpt-oss:20b |
| glm-5.3 | Z.ai | 744B/40B 활성 MoE, MIT 라이선스 | ollama run glm-5.3 |
| gemma4:e4b | 2026년 4월 2일 | 비전 + 도구 호출(E2B/E4B/E12B/E27B) | ollama run gemma4:e4b |
| deepseek-v4-flash | 2026년 4~5월 | 저비용 코딩 옵션 | ollama run deepseek-v4-flash |
| qwen3:8b | 2026년 | 7B급 다국어 모델 | ollama run qwen3:8b |
DeepSeek-R1이란 무엇이며 어떻게 다릅니까?
DeepSeek-R1은 추론 모델입니다 -- 답변을 직접 생성하는 표준 채팅 모델과 달리, DeepSeek-R1은 최종 답변 전에 명시적인 연쇄 사고 추론을 생성합니다. 이를 통해 수학, 논리 퍼즐, 단계별 문제 해결에서 성능이 크게 향상됩니다.
DeepSeek-R1 7B는 연쇄 사고 추론 모델입니다. 표준 모델보다 느리지만(응답당 토큰 수가 많음) 추론이 중요한 작업에서 훨씬 더 정확합니다.
버전 참고: DeepSeek-R1은 이전 세대 모델입니다. DeepSeek의 현재 오픈 웨이트 제품군은 DeepSeek-V4이며 확인 시점에 Ollama 라이브러리에는 올라와 있지 않았으므로, deepseek-r1 증류 모델(1.5B~70B)이 받을 수 있는 추론 선택지로 남아 있습니다. DeepSeek은 호스팅된 R1 API 모델을 DeepSeek-V4로 대체했습니다.
# DeepSeek-R1 Pull 및 실행
ollama run deepseek-r1:7b

# 더 나은 품질을 위한 대형 변형
ollama run deepseek-r1:14b   # 10GB RAM
ollama run deepseek-r1:32b   # 20GB RAM
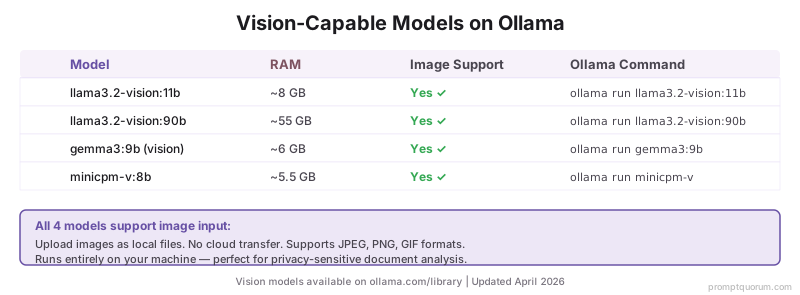
Ollama 모델 중 이미지 입력을 지원하는 모델은 무엇입니까?
2026년 7월 기준, Ollama에서 이미지 입력(멀티모달)을 지원하는 모델은 다음과 같습니다: Gemma 4는 비전과 도구 호출을 모두 지원합니다 — Ollama의 비전 모델 중 유일하며, 7월 MLX 업데이트 이후 Apple Silicon에서 거의 90% 더 빠르게 실행됩니다.
Model | RAM | Image Support | Ollama Command |
|---|---|---|---|
| llama3.2-vision:11b | ~8GB | 예 | ollama run llama3.2-vision:11b |
| llama3.2-vision:90b | ~55GB | 예 | ollama run llama3.2-vision:90b |
| gemma3:9b (vision) | ~6GB | 예 | ollama run gemma3:9b |
| minicpm-v:8b | ~5.5GB | 예 | ollama run minicpm-v |
| gemma4:e4b | ~6GB | 예 + 도구 호출 ✓ | ollama run gemma4:e4b |
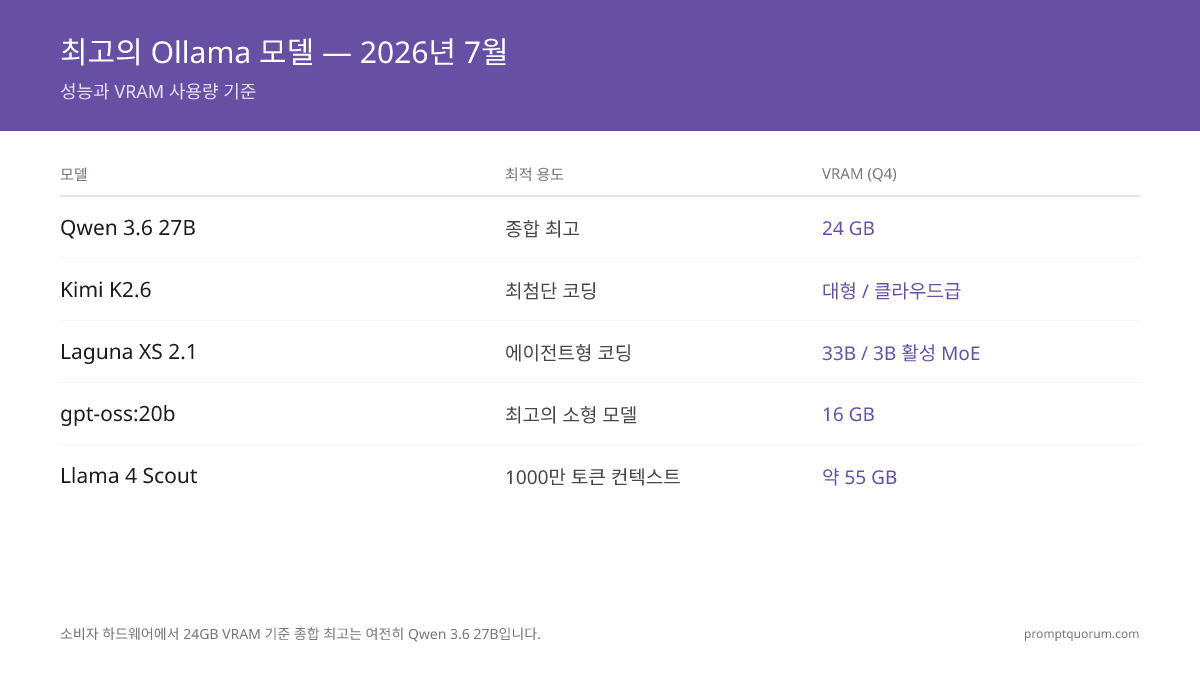
Ollama 최고 오픈소스 모델 10개는 무엇입니까?
튜토리얼이 많아 Llama 3.x의 다운로드 수는 여전히 높습니다. 2026년 7월 신규 프로젝트에는 Qwen3.8-27B(소비자 하드웨어 전반 최고), Kimi K2.6 또는 Laguna XS 2.1(코딩), gpt-oss:20b, qwen3:30b를 권장합니다.
# | Model | Best For | RAM | HumanEval |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | 소비자 하드웨어 전반 최고 | 24GB (Q4) | 61.7 SWE-bench Pro |
| 2 | Kimi K2.6 | 최전선 코딩, MoE(32B/1T), Modified MIT | 양자화 | 58.6 SWE-Bench Pro |
| 3 | gpt-oss:20b | 소형 최강 / 16GB, 조정 가능한 추론 | 16GB | ~o3-mini |
| 4 | qwen3:30b | 균형잡힌 범용; 코드에는 qwen3-coder:30b | ~18GB | 강력 |
| 5 | Laguna XS 2.1 | 에이전틱 코딩, 장시간 작업(계획/코드/테스트/반복) | 양자화 | 70.9% SWE-bench Verified |
| 6 | Devstral Small 2 24B | 에이전트 코딩(다중 파일) | 16GB | 68.0% (SWE-bench Verified) |
| 7 | deepseek-r1:7b | 추론, 수학 | 5GB | — |
| 8 | gemma4:e4b | 비전 + 도구 호출(멀티모달) | ~6GB | — |
| 9 | Llama 4 Scout | 긴 컨텍스트 10M + 멀티모달, MoE | ~55GB (Q4) | — |
| 10 | Llama 3.2 3B | 첫 번째 모델, 일반 채팅 | 2.5GB | — |
Ollama 모델 라이브러리를 어떻게 탐색합니까?
Ollama 모델을 활용하는 두 가지 방법이 있습니다. 설치된 모델 전환: Ollama Mac 앱에서 채팅 입력창 하단의 모델 드롭다운 버튼(현재 모델 이름 표시, 예: "gemma3:1b")을 클릭하여 로컬에 설치된 모델 간에 전환합니다. 새 모델 찾기 및 다운로드: ollama.com/library를 방문하여 카테고리별로 수백 개의 큐레이팅된 모델을 탐색한 후, 아래 CLI 명령을 사용하여 모델을 Pull하고 관리합니다.
# 로컬에 다운로드된 모든 모델 목록
ollama list

# 모델 검색 및 Pull
ollama pull qwen2.5-coder:32b

# 모델의 모든 사용 가능한 태그 확인
ollama show qwen2.5

# 디스크 공간 확보를 위해 모델 제거
ollama rm llama3.2:3b
오픈소스 Ollama 모델: 지역별 맥락
EU / GDPR + 라이선스 준수. 프로덕션에서 Ollama 모델을 배포하는 EU 조직에게는 라이선스 선택이 성능만큼 중요합니다. Apache 2.0(완전 개방, 상업적 사용 가능): Mistral Small 3, Mistral Small 3.1, Qwen3 8B, Qwen3.8-27B, Devstral Small 2, Granite 4.2. Meta Llama 커뮤니티 라이선스(월간 활성 사용자 7억 명 초과 시 상업적 사용 제한): Llama 3.1 8B, Llama 3.2 3B, Llama 3.2 Vision 11B. Llama 3.2 Vision은 예외입니다. 허용 가능한 사용 정책(Acceptable Use Policy)은 EU에 거주하거나 주된 사업장을 둔 개인·기업에는 라이선스 권리를 부여하지 않습니다(이를 기반으로 한 제품의 최종 사용자는 해당되지 않음). EU에서 사용하기 전에 확인하십시오. MIT(상업적 사용 가능): DeepSeek-R1 7B·14B. 수정 MIT(저작자 표시 조항과 함께 상업적 사용 가능): Kimi K2.6. OpenMDW-1.1(허용적, 상업적 사용 가능): Laguna XS 2.1. 상업 배포 전에는 항상 라이선스 조건을 확인하세요. 규제 산업의 EU 기업에는 Devstral Small 2 같은 Mistral 모델(프랑스, Apache 2.0)이 합리적인 기본 선택입니다. EU 출신이며 허용적인 라이선스이기 때문입니다. Ollama로 모델을 완전히 온프레미스에서 실행하면 프롬프트가 외부 서버로 전송되지 않습니다. 이는 GDPR 의무 이행을 돕지만 그것만으로 충족되지는 않습니다(`:cloud` 태그는 Ollama의 호스팅 서비스로 데이터를 보냅니다).
일본(METI). 일본 기업의 Ollama 배포에는 Qwen3 / Qwen3.8이 권장할 만한 모델 계열입니다. 일본어 텍스트를 네이티브로 처리해 추론 시간과 KV 캐시에 도움이 됩니다. 일본어 코딩 워크플로에서는 Qwen3.8-27B(Qwen 발표 SWE-bench Pro 61.7)가 일본어 코드 주석을 네이티브로 처리합니다. 정확한 모델 버전을 기록해 두는 것은 규정 준수 문서화의 모범 사례입니다. `ollama show <모델>`로 파라미터 수, 양자화 수준, 컨텍스트 길이를 포함한 전체 사양을 규정 준수 기록용으로 얻을 수 있습니다.
중국. 중국 CAC 생성형 AI 관리 조치(2023)는 중국 내 일반 대중에게 생성형 AI 서비스를 제공하는 사업자에게 신고 또는 보안 평가 의무를 부과할 수 있습니다. 해당 여부는 법률 자문을 통해 확인하십시오. Qwen3 / Qwen3.8(Alibaba, Apache 2.0)은 중국 기업의 Ollama 배포에 자연스러운 선택입니다. 중국 출신 모델, Apache 2.0 라이선스, 뛰어난 중국어 성능 때문입니다. Kimi K2.6(Moonshot AI, 수정 MIT)도 중국 출신이지만 Ollama에서는 클라우드 태그로만 제공되며 로컬 실행에는 서버급 하드웨어가 필요합니다. 명령: 최고 품질은 `ollama run qwen3.8:27b`, 속도는 `ollama run qwen3:8b`. 추론에는 DeepSeek-R1(MIT 라이선스)이 적합합니다. Ollama로 로컬에서 실행하는 추론 자체는 데이터를 국외로 보내지 않으므로 해당 단계에서는 국외 이전 문제가 발생하지 않습니다. 다만 PIPL 등의 의무가 귀하의 데이터 처리에 적용되는지는 법률 자문을 통해 확인하십시오. 이 섹션은 일반 정보이며 법률 자문이 아닙니다.
Ollama 모델 선택 시 흔한 실수는 무엇입니까?
RAM 확인 없이 기본적으로 가장 큰 모델 태그를 Pull하는 경우
태그 없이 `ollama pull llama3.3`을 실행하면 일반적으로 가장 큰 표준 양자화 변형이 다운로드됩니다. 8GB RAM 기기에서 llama3.3(70B, ~40GB)을 Pull하면 실패하거나 심각한 스왑 사용이 발생합니다. 항상 변형을 지정하십시오: 8GB 기기에는 `ollama pull llama3.2:3b`.
작업별 특화 모델이 있을 때 범용 모델을 사용하는 경우
코딩 작업의 경우, `qwen2.5-coder:7b`는 코드용으로 만들어졌고 범용 `qwen2.5:7b`에는 없는 FIM(fill-in-the-middle) 코드 완성 지원을 포함합니다. 추론/수학에서는 `deepseek-r1:7b`는 전용 연쇄 사고 추론 모델입니다. Ollama 라이브러리에 작업별 특화 모델이 존재하는 이유가 있습니다.
워크플로 구축 전에 모델 가용성을 확인하지 않는 경우
Ollama 라이브러리는 시간이 지남에 따라 변경됩니다 -- 모델이 추가되고 간혹 제거됩니다. 특정 모델 기반의 프로덕션 파이프라인을 구축하기 전에, 해당 모델이 라이브러리에 있는지 확인하십시오(로컬에서 `ollama list`, 또는 ollama.com/library 확인). 프로덕션 워크플로에서는 특정 모델 버전을 고정하십시오: `ollama pull llama3.1:8b-instruct-q4_K_M`.
대형 모델에 양자화 태그를 지정하지 않는 경우
양자화 접미사 없이 `ollama pull qwen2.5-coder:32b`를 실행하면 VRAM이 처리할 수 없는 크기의 기본 변형이 다운로드될 수 있습니다. 16GB VRAM에서는 명시적 Q4_K_M 변형을 Pull하십시오: `ollama pull qwen2.5-coder:32b-instruct-q4_K_M`. Pull 후 `ollama show <model>`을 실행하여 VRAM 요구 사항이 하드웨어와 일치하는지 확인하십시오.
DeepSeek-R1이 표준 채팅 모델만큼 빠를 것으로 기대하는 경우
DeepSeek-R1은 최종 답변 전에 명시적인 연쇄 사고 추론 토큰을 생성합니다 -- 이것이 수학과 논리에서 표준 모델보다 뛰어난 이유이지만, 응답당 3~5배 더 많은 토큰을 생성합니다. 빠른 채팅이나 한 줄 답변에는 `llama3.1:8b`를 사용하십시오. 추론 정확도가 속도보다 중요한 작업에는 DeepSeek-R1을 활용하십시오.
다음 단계
- 코딩용 최고 로컬 LLM — 코딩에 최적화된 Ollama 모델 →
- CPU 전용 최고 LLM — GPU 없나요? 여기서 시작 →
- 로컬 LLM 하드웨어 가이드 — 내 PC가 이 모델들을 실행할 수 있는지 확인 →
Ollama 오픈소스 모델에 관한 자주 묻는 질문
최신 Ollama 버전은 무엇입니까?
최신 안정 버전은 v0.40.5이며 2026년 10월 14일에 출시되었습니다. 10월 16일에 v0.40.6 프리릴리스가 뒤이어 나왔지만 아직 안정 버전으로 표시되지 않았습니다. ollama.com/download에서 내려받거나 Linux에서는 `curl https://ollama.ai/install.sh | sh`, macOS에서는 `brew upgrade ollama`로 업데이트하세요.
Ollama 변경 이력과 릴리스 노트는 어디에서 볼 수 있습니까?
모든 버전의 릴리스 노트는 github.com/ollama/ollama/releases에 있으며 태그별 날짜와 변경 이력이 정리되어 있습니다. 가장 최근 안정 버전 항목은 v0.40.5(2026년 10월 14일 -- NVIDIA Nemotron 3.5 Super 지원, 결정 모델 클라우드 액세스), v0.40.4(10월 12일 -- `ollama run --ask`로 결정 모델 사용, 더 빠른 로딩), v0.40.0(9월 25일 -- Apple Silicon에서 기본 MLX)입니다.
설치된 Ollama 버전은 어떻게 확인합니까?
터미널에서 `ollama --version`을 실행하십시오. `ollama version 0.40.5`과 같은 줄이 출력됩니다. 번호가 현재 릴리스보다 낮으면 `curl https://ollama.ai/install.sh | sh`(Linux) 또는 `brew upgrade ollama`(macOS)로 업데이트한 뒤 `ollama --version`을 다시 실행해 확인하십시오.
Ollama는 언제 처음 출시되었나요?
Ollama의 첫 릴리스 v0.0.1은 저장소가 만들어진 2023년 6월 26일 직후인 2023년 7월 8일 GitHub에 공개되었습니다. 2026년 10월 현재 v0.40.5까지 왔습니다. 전체 릴리스 목록은 github.com/ollama/ollama/releases에서 볼 수 있습니다.
Ollama 라이브러리에는 몇 개의 모델이 있습니까?
Ollama 라이브러리에는 공식 지원을 받는 수백 개의 큐레이팅된 모델이 있으며, 새로운 오픈 웨이트 릴리스가 나올 때마다 매주 늘어나고 있습니다. Hugging Face에는 커스텀 Modelfile을 통해 Ollama로 로드할 수 있는 수천 개의 추가 GGUF 모델이 있습니다.
Ollama를 개발한 회사의 공식 명칭은 무엇입니까?
Ollama의 운영 회사는 Ollama Inc.입니다. "Ollama"는 이 회사와 회사가 배포하는 오픈소스 CLI 도구/모델 런타임을 모두 가리키며, 프로젝트의 첫 공개 릴리스인 v0.0.1은 2023년 7월 8일 GitHub에 게시되었습니다.
Hugging Face 모델을 Ollama에서 직접 사용할 수 있습니까?
예. Hugging Face에서 GGUF 파일을 다운로드하고 Modelfile을 생성하십시오: `FROM ./model.gguf`. 그런 다음 `ollama create mymodel -f Modelfile`을 실행합니다. 이는 공식 Ollama 라이브러리에 없는 파인튜닝 모델 및 모델을 포함하여 모든 GGUF 파일에서 작동합니다.
로컬 챗봇 구축에 가장 적합한 Ollama 모델은 무엇입니까?
범용 로컬 챗봇: `qwen3.8:27b`(소비자 하드웨어 전반 최고, Q4에서 24GB에 적합), 또는 8GB RAM에서는 `llama3.2:3b`(가장 쉬운 시작점). 16GB 기기: `gpt-oss:20b`(~o3-mini 수준) 또는 `mistral-small3.1`. 코딩 어시스턴트 챗봇: `qwen3.8:27b`(61.7 SWE-bench Pro), `devstral-small-2`(최전선 MoE), 또는 `laguna-xs-2.1`(에이전틱, 장시간 작업). localhost:11434의 Ollama API에 연결되는 웹 기반 인터페이스인 Open WebUI와 함께 사용하십시오.
모든 Ollama 모델이 진정한 오픈소스입니까?
그렇지 않습니다. Ollama 라이브러리에는 다양한 라이선스의 모델이 포함되어 있습니다. Llama 3.x/4.x는 Meta Llama Community Licence를 사용합니다(OSI 승인 오픈소스 아님 -- 월간 활성 사용자 7억 명 초과 시 상업적 이용 제한). Mistral Small 3.1, Qwen3, Qwen3.8, Devstral Small 2, Gemma 4는 Apache 2.0(완전 오픈소스)이며, Gemma 2와 Gemma 3는 OSI 승인을 받지 않은 Google의 Gemma 이용약관을 사용합니다. Kimi K2.6은 Modified MIT 라이선스(귀속 조항이 있는 상업적 이용 허용)입니다. Laguna XS 2.1은 OpenMDW-1.1을 사용합니다(관대한 라이선스, 상업적 이용 허용, OSI 승인 아님). 상업적 배포 전에 항상 라이선스를 확인하십시오.
Ollama에서 어떤 Dolphin 모델을 사용해야 하나요?
오래된 `dolphin-mistral`(2024년 마지막 업데이트, Mistral 0.2 기반) 대신 Dolphin 3.0(`ollama pull dolphin3`)을 사용하십시오. Cognitive Computations(Eric Hartford)가 유지 관리하는 Dolphin 3.0은 Llama 3.1을 기반으로 하며, 내장 콘텐츠 필터링이 없고, 코딩·수학·에이전틱 작업·콘텐츠 제한이 내장되지 않은 채팅용 범용 로컬 모델로 설계되었습니다. 내장 안전 필터링이 없으므로 출력물의 사용에 대한 책임은 사용자에게 있으며, Llama 3.1 라이선스 조건이 적용됩니다.
RAG를 위해 Ollama에서 사용해야 하는 임베딩 모델은 무엇입니까?
`nomic-embed-text`가 표준 선택입니다 -- 768차원 임베딩을 생성하고, 문서당 밀리초 단위로 실행되며, 검색 작업에 특화된 1억 3,700만 파라미터 모델입니다. `ollama pull nomic-embed-text`로 Pull하십시오. Open WebUI의 내장 RAG, LangChain의 OllamaEmbeddings, 또는 LlamaIndex와 함께 사용하십시오.
Ollama 라이브러리는 얼마나 자주 새 모델로 업데이트됩니까?
Ollama 팀은 주요 릴리스 후 며칠에서 몇 주 내에 새 모델을 추가합니다. Laguna XS 2.1(2026년 7월 2일), Kimi K2.7 Code, Kimi K2.6, Qwen 3.6은 모두 출시 후 며칠 내에 등장했습니다. 현재 Ollama 버전은 v0.40.5 (2026년 10월 14일)입니다. 새 모델 발표를 위해 Ollama GitHub 저장소(github.com/ollama/ollama) 또는 Ollama Twitter/X 계정을 팔로우하십시오.
`ollama pull`과 `ollama run`의 차이는 무엇입니까?
`ollama pull`은 모델 파일을 로컬 스토리지에 다운로드합니다(1회 작업). `ollama run`은 Pull 후 즉시 대화형 세션을 시작하거나, 이미 Pull된 모델이 있으면 재사용합니다. 한 번 Pull하고 여러 번 실행할 수 있으며 재다운로드가 필요하지 않습니다.
같은 기기에서 여러 모델을 동시에 실행할 수 있습니까?
예, 하드웨어에 충분한 VRAM이 있는 경우. 별도의 터미널 창이나 쉘 세션을 사용하십시오 -- 한 창에서 `ollama run llama3.2`를 실행하고 다른 창에서 `ollama run qwen2.5:7b`를 실행합니다. Ollama는 VRAM 공유를 자동으로 관리합니다. 과부하를 방지하기 위해 `nvidia-smi`나 시스템 활동을 모니터링하십시오.
모델을 최신 버전으로 업데이트하는 방법은 무엇입니까?
`ollama pull [model-name]`은 업데이트를 확인하고 가용한 경우 최신 버전을 다운로드합니다. 이전 버전으로 되돌리거나 특정 버전을 사용하려면 버전 태그를 사용하십시오: `ollama pull llama3.1:8b` 또는 `ollama pull llama3.1:8b-instruct-q4_K_M`. `ollama show [model-name]`으로 사용 가능한 버전을 확인하십시오.
Ollama의 오픈소스 모델은 상업적으로 무료로 사용할 수 있습니까?
대부분은 그렇지만 전부는 아닙니다. Llama 3.x(Meta Llama Community Licence)는 월간 활성 사용자 7억 명 초과 시 상업적 이용을 제한합니다. Mistral Small 3.1, Qwen3, Gemma 4는 Apache 2.0(완전 상업적 이용 허용)을 사용하며, Gemma 2와 Gemma 3는 조건부로 상업적 이용을 허용하는 Google의 Gemma 이용약관을 사용합니다. 기업 배포 전에 항상 라이선스를 확인하십시오 -- 모델의 Hugging Face 페이지나 Ollama 라이브러리 항목을 확인하십시오.
2026년 7월 Ollama의 최신 신규 모델은 무엇입니까?
최신 추가 모델은 Laguna XS 2.1(Poolside, OpenMDW-1.1 -- 에이전틱 장시간 코딩, SWE-bench Verified 70.9%, 33B/3B 활성 MoE)과 Kimi K2.7 Code(Moonshot AI -- Kimi K2.6 기반 코딩 특화 에이전틱 모델)입니다. 두 모델 모두 기존 7월 라인업에 합류합니다: Kimi K2.6(Modified MIT, 최전선 MoE 코딩, SWE-Bench Pro 58.6), Qwen3.8-27B(소비자 하드웨어 전반 최고, 61.7 SWE-bench Pro), GLM-5.3(744B/40B 활성 MoE, MIT, SWE-Bench Pro 58.4), gpt-oss:20b(소형 최강 / 16GB, ~o3-mini). Pull 명령: ollama run laguna-xs-2.1, ollama run kimi-k2.7-code:cloud, ollama run qwen3.8:27b, ollama run kimi-k2.6:cloud.
러시아어 작업에 가장 적합한 Ollama 모델은 무엇입니까?
Qwen3 / Qwen3.8(`ollama run qwen3:8b` 또는 `ollama run qwen3.8:27b`)과 Mistral Small 3.1(`ollama run mistral-small3.1`) 모두 네이티브 다국어 학습 데이터에 러시아어를 포함합니다. 이 페이지는 러시아어 성능 순위를 매기지 않습니다. 직접 작성한 프롬프트로 두 모델을 모두 시험해 보십시오. 두 모델 모두 러시아 출신은 아닙니다 -- 러시아에 특화된 규제상 데이터 거주 요건이 있는 경우, 모델 라이선스와 조직의 컴플라이언스 요구 사항을 별도로 확인하십시오. 이 문서는 러시아 데이터 현지화 법률을 다루지 않습니다.
출처
- Meta. "Llama-4-Scout-17B-16E-Instruct model card." huggingface.co -- Llama 4 Scout(17B 활성, 109B 전체, MoE)의 공식 사양.
- DeepSeek AI. (2025). "DeepSeek-R1 Technical Report." arxiv.org/abs/2501.12948 -- DeepSeek-R1의 연쇄 사고 아키텍처와 벤치마크 방법론.
- Ollama. (2026). "qwen3.8." ollama.com/library/qwen3.8 -- 최고 밀집 코딩 모델로서 61.7 SWE-bench Pro.
- Moonshot AI. Kimi K2.6 (Hugging Face 조직 페이지). huggingface.co/moonshotai -- Modified MIT 라이선스 MoE 코딩 모델(32B 활성/1T 전체), SWE-Bench Pro 58.6.
- Mistral AI. "Introducing: Devstral 2 and Mistral Vibe CLI." mistral.ai -- 다중 파일 편집 및 디버깅을 위한 최고 에이전트 코딩 모델.
- Ollama. (2026). "Ollama Model Library." ollama.com/library -- 수백 개의 큐레이팅된 모델, 다운로드 수, 태그, 양자화 옵션이 있는 공식 모델 라이브러리.
- Google AI for Developers. "Gemma documentation." ai.google.dev -- Gemma 4 계열. 2026년 4월 출시된 비전 + 도구 호출 기능.
- Poolside. (2026). "Introducing Laguna XS 2.1." poolside.ai -- 33B/3B 활성 MoE 에이전틱 코딩 모델, SWE-bench Verified 70.9%, OpenMDW-1.1 라이선스.
- Ollama. (2026). "Ollama Releases." github.com/ollama/ollama/releases -- 공식 릴리스 노트, v0.40.5 (2026년 10월 14일).