GPU별 최적 DeepSeek 디스틸 모델 (2026)
GPU와 DeepSeek-R1 디스틸을 한 줄로 매칭하십시오: RTX 3060 12GB는 7B, RTX 4060 Ti 16GB는 14B, RTX 4090은 32B(DeepSeek이 공개한 결과 기준 o1-mini를 능가), 듀얼 GPU는 70B를 실행합니다. 8 GB 카드에서는 출시 당시 가장 강력한 소형 추론 디스틸 중 하나인 DeepSeek-R1-0528-Qwen3-8B를 실행하십시오. 모든 명령어는 기본적으로 Q4_K_M을 사용합니다. 현황: R1은 더 이상 DeepSeek의 현재 세대가 아닙니다(현재 세대는 DeepSeek-V4). 다만 이 증류 모델들은 독립적인 오픈 웨이트 릴리스이며 여전히 로컬에서 실행됩니다. o1-mini와의 비교는 과거 기준입니다. OpenAI는 2025년 10월 27일에 o1-mini를 종료했습니다.
핵심 요점
- ✓R1은 더 이상 DeepSeek의 현재 세대가 아닙니다. 현재 세대는 DeepSeek-V4(Flash 및 Pro, MIT 라이선스 오픈 웨이트)입니다. R1 증류 모델은 독립적인 오픈 웨이트 릴리스이며 여전히 로컬에서 실행됩니다.
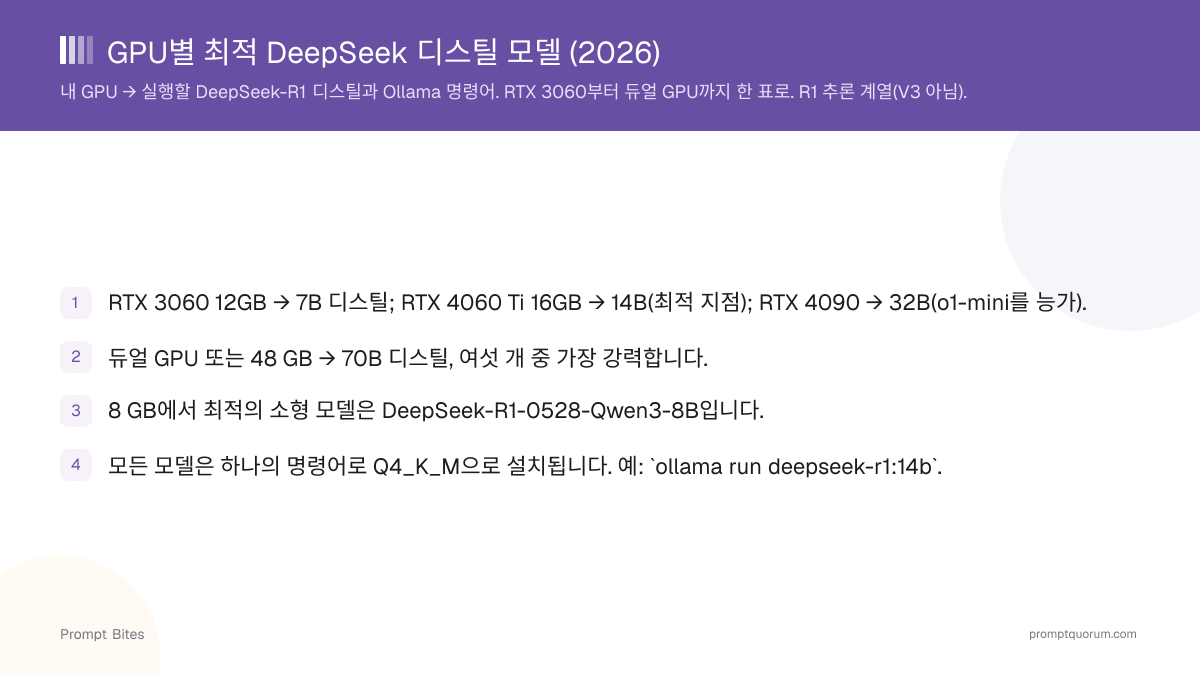
- ✓RTX 3060 12GB → 7B 디스틸; RTX 4060 Ti 16GB → 14B(최적 지점); RTX 4090 → 32B(o1-mini를 능가).
- ✓듀얼 GPU 또는 48 GB → 70B 디스틸, 여섯 개 중 가장 강력합니다.
- ✓8 GB에서 최적의 소형 모델은 DeepSeek-R1-0528-Qwen3-8B입니다.
- ✓모든 모델은 하나의 명령어로 Q4_K_M으로 설치됩니다. 예: `ollama run deepseek-r1:14b`.
- ✓DeepSeek의 권장대로 끝없는 반복을 피하려면 temperature를 0.6으로 설정하고 system prompt를 사용하지 마십시오.
- ✓이것은 R1 추론 계열이며, 채팅 모델인 DeepSeek-V3가 아닙니다.
이 페이지에는 타사 제품에 대한 참조 링크가 포함되어 있습니다. PromptQuorum은 어떤 제휴 프로그램에도 등록되어 있지 않습니다 — 이는 수수료가 발생하지 않는 일반 링크입니다. 링크 클릭 및 이후 단계는 전적으로 귀하의 책임입니다. 이 링크는 PromptQuorum의 어떠한 보증이나 검증을 나타내지 않습니다.
빠른 답변
카드를 확인하십시오: RTX 3060 12GB → 7B, RTX 4070 12GB → 8B(14B는 짧은 컨텍스트에서만), RTX 4060 Ti 16GB / 4070 Ti Super / 4080 → 14B, RTX 4090 → 32B, 듀얼 GPU/48 GB → 70B. 32B는 가중치만으로 약 20 GB가 필요하므로 12 GB나 16 GB 카드에는 들어가지 않습니다. 8 GB에서 최적의 소형 모델은 DeepSeek-R1-0528-Qwen3-8B(`ollama run deepseek-r1:8b`)입니다. 각 모델은 Q4_K_M으로 하나의 Ollama 명령어로 실행됩니다.
- ▸RTX 3060 12GB → deepseek-r1:7b — 약 30–40 tok/s
- ▸RTX 4060 Ti 16GB → deepseek-r1:14b — 약 25–35 tok/s (권장)
- ▸RTX 4070 12GB → deepseek-r1:8b (14B는 짧은 컨텍스트에서만) — 약 30–40 tok/s
- ▸RTX 4070 Ti Super / 4080 16GB → deepseek-r1:14b — 약 40–50 tok/s (32B는 들어가지 않음)
- ▸RTX 4090 24GB → deepseek-r1:32b — 약 30–40 tok/s, o1-mini를 능가
- ▸듀얼 GPU / 48 GB → deepseek-r1:70b — 약 12–18 tok/s
- ▸8 GB 카드, 최적 소형 → DeepSeek-R1-0528-Qwen3-8B
GPU → DeepSeek-R1 디스틸 → Ollama 명령어
첫 번째 열에서 보유한 GPU를 찾아 가로로 읽으십시오. tok/s 수치는 Q4_K_M 추론 워크로드에 대한 대략적인 참고 추정치이며 PromptQuorum의 측정값이 아니고, 컨텍스트 길이, 샘플링 설정, 하드웨어에 따라 달라집니다. 두 모델이 모두 들어갈 때 더 큰 모델이 추론이 더 좋고 더 작은 모델이 더 빠릅니다.
| GPU (VRAM) | 최적 디스틸 | Ollama 명령어 | 예상 tok/s |
|---|---|---|---|
| RTX 3060 12GB (8 GB 등급) | DeepSeek-R1-Distill-Qwen-7B | ollama run deepseek-r1:7b | ~30–40 |
| 8 GB, 최적 소형 | DeepSeek-R1-0528-Qwen3-8B | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4060 Ti 16GB | DeepSeek-R1-Distill-Qwen-14B | ollama run deepseek-r1:14b | ~25–35 |
| RTX 4070 12GB | 8B 또는 14B (짧은 컨텍스트) | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4070 Ti Super / 4080 16GB | 14B (32B는 들어가지 않음) | ollama run deepseek-r1:14b | ~40–50 |
| RTX 4090 24GB | DeepSeek-R1-Distill-Qwen-32B | ollama run deepseek-r1:32b | ~30–40 |
| 듀얼 GPU / 48 GB | DeepSeek-R1-Distill-Llama-70B | ollama run deepseek-r1:70b | ~12–18 |
이 표를 3단계로 사용하는 방법
네 줄: (1) GPU와 VRAM을 확인하고, (2) Ollama를 설치하고 해당 명령어를 실행하고, (3) `ollama ps`로 모델이 전부 GPU에 올라갔는지 확인하고, (4) temperature를 0.6으로 설정하고 system prompt를 비우십시오. 모델이 너무 느리면 한 단계 내리고, VRAM이 남으면 더 나은 추론을 위해 한 단계 올리십시오.
V3 대 R1: 이 표는 R1 전용입니다
**DeepSeek-R1은 이 명령어가 설치하는 추론 계열이며, DeepSeek-V3는 별도의 채팅 모델입니다.** 이 디스틸에서 V3 경험을 기대하지 마십시오 — 이들은 수학과 논리에 대한 단계별 추론을 보여주도록 조정되어 있습니다. 또한 V3는 671B MoE이며 소비자 하드웨어에서 실행할 수 없습니다. [DeepSeek-V3 하드웨어 바이트](/ko/prompt-bites/deepseek-v3-local-hardware-requirements)를 참조하십시오.
**업데이트:** DeepSeek의 현재 세대는 DeepSeek-V4(Flash 및 Pro)이며, MIT 라이선스의 오픈 웨이트로 공개되었습니다(프리뷰: 2026년 4월 24일). DeepSeek API는 이제 V4를 제공합니다. deepseek-chat(V3 세대)과 deepseek-reasoner(R1 세대) 별칭은 2026년 7월 24일 이후 완전히 폐지된다고 공지되었습니다. R1 증류 모델은 독립적인 오픈 웨이트 릴리스로서 해당 공지의 대상이 아니었으며 여전히 로컬에서 실행됩니다. V4 자체는 소비자용 GPU 모델이 아닙니다. V4-Pro는 총 1.6T 파라미터(활성 49B), 최초의 V4-Flash는 284B(활성 13B)이며, 4비트 정밀도(파라미터 수 × 0.5바이트)로도 가중치만 약 140 GB(Flash)에서 800 GB(Pro)가 필요하고, DeepSeek 모델 카드에는 GPU 요구 사항이 명시되어 있지 않습니다. 소비자용 GPU 한 장에서의 추론에는 증류 모델이 여전히 현실적인 선택입니다.
관련 가이드
- ▸DeepSeek-R1 디스틸 VRAM 치트시트 — 양자화별(Q4_K_M, Q8, FP16) 각 디스틸과 VRAM 및 최소 GPU
- ▸2026 최고의 로컬 추론 모델: DeepSeek-R1 순위 — 벤치마크와 등급이 포함된 전체 순위 가이드
- ▸DeepSeek-V3 로컬 하드웨어 요구 사항 — V3 채팅 모델 대응판
자주 묻는 질문
DeepSeek-R1은 아직도 DeepSeek의 현재 모델입니까?▾
RTX 4090에서는 어떤 DeepSeek 디스틸이 실행됩니까?▾
16 GB VRAM에 들어가는 DeepSeek-R1 디스틸은 무엇입니까?▾
RTX 4070에서 deepseek-r1:32b를 실행할 수 있습니까?▾
8 GB GPU에 가장 좋은 DeepSeek 디스틸은 무엇입니까?▾
제 디스틸이 왜 느립니까?▾
양자화를 선택해야 합니까?▾
전체 설명이 필요하십니까?
전체 가이드 읽기 →관련 프롬프트 요점