DeepSeek-R1 Distill VRAM-Spickzettel (2026)
Jeder DeepSeek-R1 Distill nach Quantisierung: 1.5B passt in 4 GB, 7B/8B in 8 GB, 14B in 16 GB, 32B in 24 GB, und 70B benötigt zwei GPUs — alles beim Ollama-Standard Q4_K_M. Q8_0 verdoppelt den VRAM ungefähr; FP16 vervierfacht die Q4_K_M-Dateigröße ungefähr. Dies ist die Tabelle zum Merken, um einen Distill auf eine Grafikkarte abzustimmen. Stand: R1 ist nicht mehr die aktuelle Generation von DeepSeek (das ist DeepSeek-V4), aber diese Distills sind eigenständige Open-Weight-Releases und laufen weiterhin lokal.
Wichtigste Erkenntnisse
- ✓R1 ist nicht mehr die aktuelle Generation von DeepSeek – das ist DeepSeek-V4 (Flash und Pro, Open Weights unter MIT-Lizenz). Die R1-Distills sind eigenständige Open-Weight-Releases und laufen weiterhin lokal.
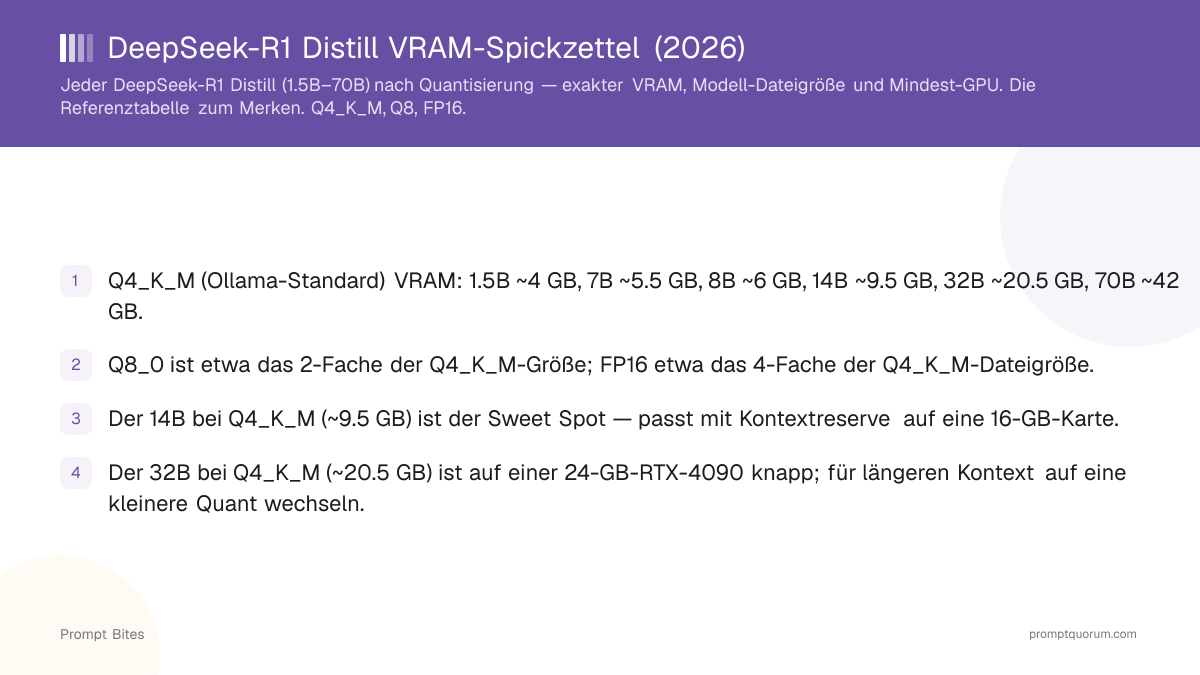
- ✓Q4_K_M (Ollama-Standard) VRAM: 1.5B ~1.6 GB, 7B ~5.5 GB, 8B ~6 GB, 14B ~9.5 GB, 32B ~20.5 GB, 70B ~44 GB.
- ✓Q8_0 ist etwa das 2-Fache der Q4_K_M-Größe; FP16 etwa das 4-Fache der Q4_K_M-Dateigröße.
- ✓Der 14B bei Q4_K_M (~9.5 GB) ist der Sweet Spot — passt mit Kontextreserve auf eine 16-GB-Karte.
- ✓Der 32B bei Q4_K_M (~20.5 GB) ist auf einer 24-GB-RTX-4090 knapp; für längeren Kontext auf eine kleinere Quant wechseln.
- ✓Der volle 671B DeepSeek-R1 steht nicht in dieser Tabelle — er benötigt ~376–404 GB bei Q4 (nur Rechenzentrum).
- ✓Dies sind R1-Reasoning-Distills, nicht DeepSeek-V3 (ein Chat-Modell).
Diese Seite enthält Verweislinks zu Produkten von Drittanbietern. PromptQuorum ist an keinem Partnerprogramm beteiligt — es sind reine Referenzlinks, die keine Provision erzielen. Das Anklicken von Links und Ihre nächsten Schritte liegen in Ihrer eigenen Verantwortung. Diese Links stellen keine Billigung oder Verifizierung durch PromptQuorum dar.
Schnelle Antwort
Bei Q4_K_M (Ollama-Standard): 1.5B ≈ 1.6 GB, 7B ≈ 5.5 GB, 8B ≈ 6 GB, 14B ≈ 9.5 GB, 32B ≈ 20.5 GB, 70B ≈ 44 GB. Q8_0 ist etwa das 2-Fache der Q4_K_M-Größe und FP16 etwa das 4-Fache, sodass der 32B bei FP16 ein 80-GB-Setup benötigt.
- ▸1.5B: ~1.1 GB Datei, ~4 GB VRAM (oder CPU) bei Q4_K_M
- ▸7B: ~4.7 GB Datei, ~5.5 GB VRAM — RTX 3060 12GB
- ▸14B: ~9 GB Datei, ~9.5 GB VRAM — RTX 4060 Ti 16GB
- ▸32B: ~20 GB Datei, ~20.5 GB VRAM — RTX 4090 24GB (knapp)
- ▸70B: ~43 GB Datei, ~44 GB VRAM — zwei GPUs oder 48 GB
- ▸Faustregel: Q8_0 ≈ 2× Q4_K_M; FP16 ≈ 4× Q4_K_M
DeepSeek-R1 Distill VRAM nach Quantisierung
Die VRAM-Werte enthalten einen kleinen Aufschlag für Kontext und KV-Cache zusätzlich zur reinen Dateigröße. Q4_K_M ist der Ollama-Standard und ein weit verbreiteter Kompromiss zwischen Größe und Qualität für Reasoning. Nutzen Sie Q8_0 nur, wenn Sie VRAM übrig haben und einen geringfügigen Qualitätsgewinn wünschen; FP16 lohnt sich lokal selten.
| Distill | Q4_K_M (VRAM) | Q8_0 (VRAM) | FP16 (VRAM) | Mindest-GPU (Q4_K_M) |
|---|---|---|---|---|
| 1.5B | ~1.6 GB | ~2.5 GB | ~4.2 GB | Beliebige 4-GB-GPU / CPU |
| 7B (Qwen2.5) | ~5.5 GB | ~8.7 GB | ~15.6 GB | RTX 3060 12GB |
| 8B (Llama 3) | ~6 GB | ~9 GB | ~16.6 GB | RTX 3060 12GB |
| 14B (Qwen2.5) | ~9.5 GB | ~17 GB | ~31 GB | RTX 4060 Ti 16GB |
| 32B (Qwen2.5) | ~20.5 GB | ~36 GB | ~67 GB | RTX 4090 24GB (knapp) |
| 70B (Llama 3) | ~44 GB | ~76 GB | ~142 GB | Zwei GPUs / 48 GB |
Welche Quantisierung sollten Sie wählen?
**Nutzen Sie Q4_K_M für fast alles** — es ist der Ollama-Standard und hält die Reasoning-Qualität hoch, während es die meisten Modelle pro GB unterbringt. Wählen Sie es, sofern Sie keinen konkreten Grund dagegen haben.
**Nutzen Sie Q8_0 nur mit freiem VRAM** — es verdoppelt den Speicherbedarf ungefähr für einen geringfügigen Qualitätsgewinn, der eine Reasoning-Antwort meist nur wenig verändert. Auf einer 24-GB-Karte mit dem 14B lohnenswert, sonst kaum.
**Überspringen Sie FP16 lokal** — bei etwa dem 4-Fachen der Q4_K_M-Größe treibt es den 32B auf 80-GB-Hardware, mit wenig praktischem Reasoning-Vorteil gegenüber Q8_0 in den meisten lokalen Setups.
Der 14B auf einer 16-GB-Karte: Welche Quant passt
**Auf einer 16-GB-GPU läuft der 14B mit Q4_K_M, Q5_K_M oder Q6_K — nicht mit Q8_0.** Die Ollama-Datei für Q4_K_M ist 9.0 GB groß und lässt ~6 GB für Kontext; Q5_K_M (~10.5 GB) und Q6_K (~12.1 GB) passen mit moderatem Kontextfenster ebenfalls.
**Q8_0 passt nicht komfortabel.** Die Ollama-Datei für Q8_0 ist 16 GB groß — das ist die ganze Karte, noch vor dem KV-Cache; ein Teil des Modells wandert dann in den langsameren System-RAM.
**Ollama liefert für die Distills nur die Tags Q4_K_M, Q8_0 und FP16.** Für Q5_K_M oder Q6_K laden Sie eine GGUF-Datei von Hugging Face: `ollama run hf.co/
**Eine RTX 4070 Laptop hat 8 GB VRAM, nicht 16 GB.** Nutzen Sie den 7B- oder 8B-Distill mit Q4_K_M (Dateien von 4.7–4.9 GB). Der 14B (9 GB) wird teilweise in den System-RAM ausgelagert und deutlich langsamer.
**Das Tag `deepseek-r1:8b` ist nicht der Llama-Distill.** Seine Größe von 5.2 GB in der Ollama-Tag-Liste entspricht dem auf Qwen3-8B basierenden R1-0528-Build, nicht dem 4.9-GB-Llama-Distill; den Llama-3-Distill aus der Tabelle erhalten Sie mit `deepseek-r1:8b-llama-distill-q4_K_M`.
V3 vs. R1: Nicht verwechseln
**DeepSeek-V3 ist ein Chat-Modell; DeepSeek-R1 (und diese Distills) sind Reasoning-Modelle.** Diese Tabelle gilt nur für die R1-Reasoning-Familie. Wenn Sie V3 suchen: Es ist ein 671B-MoE-Chat-Modell, das ebenfalls nicht auf Consumer-Hardware läuft — siehe den [DeepSeek-V3 Hardware-Bite](/de/prompt-bites/deepseek-v3-local-hardware-requirements).
**Update:** Die aktuelle Generation von DeepSeek ist DeepSeek-V4 (Flash und Pro), veröffentlicht als Open Weights unter MIT-Lizenz (Preview: 24. April 2026). Die DeepSeek-API liefert jetzt V4: Die Aliase deepseek-chat (V3-Generation) und deepseek-reasoner (R1-Generation) wurden als nach dem 24. Juli 2026 vollständig abgeschaltet angekündigt. Die R1-Distills sind eigenständige Open-Weight-Releases, waren nicht Teil dieser Ankündigung und laufen weiterhin lokal. V4 selbst ist kein Modell für Consumer-GPUs: V4-Pro hat 1,6T Parameter insgesamt (49B aktiv), das ursprüngliche V4-Flash 284B (13B aktiv). Selbst bei 4-Bit-Präzision (Parameterzahl × 0,5 Byte) benötigen allein die Gewichte grob 140 GB (Flash) bis 800 GB (Pro); die Modellkarten von DeepSeek nennen keine GPU-Anforderung. Für Reasoning auf einer einzelnen Consumer-GPU bleiben die Distills die praktische Wahl.
Verwandte Anleitungen
- ▸Bester DeepSeek Distill für Ihre GPU — passen Sie Ihre Karte an einen Distill an, plus Ollama-Befehl und erwartete tok/s
- ▸Bestes lokales Reasoning-Modell 2026: DeepSeek-R1 im Ranking — der vollständige Ranking-Leitfaden mit Benchmarks
- ▸DeepSeek-V3 lokale Hardware-Anforderungen — das V3-Chat-Modell-Pendant
Häufig gestellte Fragen
Ist DeepSeek-R1 noch das aktuelle Modell von DeepSeek?▾
Wie viel VRAM braucht DeepSeek-R1-Distill-Qwen-32B?▾
Wie viel fügt Q8_0 gegenüber Q4_K_M hinzu?▾
Kann ich den 70B Distill auf einer GPU ausführen?▾
Steht der volle DeepSeek-R1 in dieser Tabelle?▾
Wie viel VRAM braucht DeepSeek-R1 14B quantisiert?▾
Kann ich DeepSeek-R1 14B mit 16 GB VRAM ausführen?▾
Welcher DeepSeek-R1 Distill passt auf eine RTX 4070 Laptop (8 GB)?▾
Den vollständigen Überblick?
Die vollständige Anleitung lesen →Verwandte Prompt Bites